Notizie sull'IA per la generazione di immagini e video — 2026-10-02
I modelli open source cinesi (Qwen-Image-2.1, Z-Image Turbo) stanno colmando il divario con i leader closed source proprio mentre la fiducia nei sistemi chiusi si erode per via di guardrail, abusi ed economia di Sora.
Notizie sull'IA per la generazione di immagini e video — 2026-10-02
In questo momento il settore dell'IA per immagini e video è davvero in fermento 😤. I protagonisti closed source (GPT Image 2.5 di OpenAI, Veo 3.1/Nano Banana 2.0 di Google, Kling 2.5, Seedance 2.5 e altri) non smettono di aggiungere funzionalità, ma parallelamente si susseguono notizie che minano la fiducia: guardrail più rigidi, deepfake e perdite enormi di Sora 💸. Nel frattempo, il fronte open source — in particolare realtà cinesi come Alibaba (Qwen-Image-2.1, Z-Image Turbo) — sta guadagnando slancio, e la cultura del lavoro locale basata su ComfyUI è chiaramente visibile su Reddit, Lemmy e Bluesky 🔥. Abbiamo esaminato sei piattaforme — Reddit, X, YouTube, Bluesky, Lemmy e Pinterest — ma X è stato un completo buco nell'acqua; lo riportiamo apertamente qui sotto 👇.
Tra le piattaforme
- L'open source cinese è in ascesa e viene sempre più raccontato come alternativa ai sistemi closed source 🇨🇳 Su YouTube, Z-Image Turbo (6 miliardi di parametri, utilizzabile con 6 GB di VRAM) viene descritto come superiore a Flux 2 (https://www.youtube.com/watch?v=JF4Q5hXh-_Q), mentre Qwen-Image-Edit viene valutato al livello di Nano Banana o oltre (https://www.youtube.com/watch?v=AIgYj5RG-FQ). Anche su Lemmy, nella stessa settimana sono comparsi WebUI e LoRA per Qwen-Image-2.1 (https://github.com/ogoun/fooocus-qwen-image-2.1), e Simon Willison ha pubblicato su Bluesky test pratici di Qwen-Image (https://bsky.app/profile/simonwillison.net/post/3lvlvsxkzp223). Poiché il fenomeno appare simultaneamente su più piattaforme, sembra una tendenza concreta.
- L'irrigidimento dei guardrail sta spingendo gli utenti altrove 🚪 Su Reddit, alcuni utenti frustrati dai rifiuti di ChatGPT passano a Midjourney, Grok o Venice AI (https://www.reddit.com/r/AI_Agents/comments/1wt7jqr/); altri, dopo il rafforzamento dei filtri di DreamFort.ai, si spostano verso Seedream Unfiltered o MiniMax H3 (https://www.reddit.com/r/generativeAI/comments/1wtzefv/). Su Bluesky, esperti avvertono che modelli open-weight come GLM-5.3 hanno guardrail quasi inesistenti (https://bsky.app/profile/emollick.bsky.social/post/3mu5xtm24zk2o): su ogni social emerge una polarizzazione fra regolamentazione sempre più rigida e assenza di regole.
- La “fiducia” nei prodotti closed source vacilla contemporaneamente su più fronti ⚠️ Un'inchiesta di TIME diffusa su Bluesky ha mostrato che Veo3 poteva creare video falsi dell'incendio di un tempio indù (https://bsky.app/profile/amanbatheja.bsky.social/post/3lqpalskjp22h); su Reddit è emerso invece che Photoshop e Apple Photos possono etichettare perfino semplici ritagli come “modifiche IA”, rimuovendo i crediti (https://www.reddit.com/r/mildlyinfuriating/comments/1wsupkx/). Abuso e attribuzione errata sono problemi diversi, ma entrambi alimentano l'idea che gli strumenti chiusi non siano affidabili.
- ComfyUI è ormai l'ambiente di lavoro predefinito del mondo open source 🛠️ Reddit (nodi per MiniMax-H3, https://www.reddit.com/r/StableDiffusion/comments/1wtu82e/), Lemmy (inpainting LanPaint, https://github.com/scraed/LanPaint/), Bluesky (illustrazioni quotidiane con Krea2, https://bsky.app/profile/ria-tatibana.bsky.social/post/3mwtrqf7glc2t) e YouTube (tutorial pubblicati immediatamente a ogni nuovo modello) citano tutti lo stesso nome.
- I confronti affiancati sono diventati un formato consolidato 📊 Titoli YouTube del tipo “WAN 2.5 is Open Source Veo3”, confronti Lemmy che colorano la stessa doppia pagina di Berserk con quattro modelli (https://www.reddit.com/gallery/1wfyqdy) e grafici Pinterest al neon del tipo “questo se paghi, questo se vuoi il gratuito”. Più delle singole notizie, gli utenti vogliono sapere quale modello sia il più forte.
- La tesi secondo cui il video IA per consumatori non è redditizio trova conferme in più fonti 💰 Su Bluesky, un post indica costi operativi annui di Sora2 intorno ai 5 miliardi di dollari contro circa 1,4 milioni di ricavi (https://bsky.app/profile/labuzamovies.com/post/3mek2c2xipk2o). Su Lemmy, un'analisi nota che OpenAI chiuderà l'API di Sora il 24 settembre, mentre operatori enterprise come Kling raccolgono fondi (https://www.reddit.com/r/ArtificialInteligence/comments/1wluu0n/).
Piattaforma per piattaforma
Reddit 🟠 Analizzati 12 thread in 9 subreddit. Sul lato closed source, il post più popolare riguarda Seedance 2.5, usato tramite Higgsfield, ormai capace di produrre un corto di dieci minuti con personaggi coerenti realizzato da una sola persona (784 punti, https://www.reddit.com/r/accelerate/comments/1wqqr4p/). Sul fronte open source, un nodo ComfyUI per MiniMax-H3 viene definito “il miglior nodo mai usato” (https://www.reddit.com/r/StableDiffusion/comments/1wtu82e/). Qui compaiono anche le lamentele più concrete relative ai guardrail.
X ⚫️ Un completo fallimento 😅. I 40 post raccolti da 33 account riguardavano esclusivamente calcio, K-pop, politica britannica e reality show: zero contenuti sulla generazione di immagini o video con IA. I termini usati dal worker — come “Halloween”, “Ronaldo” e “#bb28” — erano semplicemente quelli della scheda delle tendenze di X, non parole chiave legate all'IA. Questa parte di X non offre alcuna informazione utile al report.
YouTube 🔴 Sul lato closed source, nello stesso periodo sono comparsi video sulla funzione “Sketch” di GPT Image 2.5 (https://www.youtube.com/watch?v=LYUr4BY33h4), sull'accesso gratuito a Veo 3.1 (https://www.youtube.com/watch?v=uj6eD31OxkA) e su Nano Banana 2.0, definito “migliore di Photoshop” (https://www.youtube.com/watch?v=u22-XoQvI4I): la corsa alle funzioni procede a velocità elevata. Sul lato open source, FLUX.2, Z-Image e Qwen-Image-Edit sono oggetto di una produzione massiccia di tutorial su come usarli con ComfyUI. Va però segnalato che visualizzazioni, iscritti e commenti non sono stati recuperabili a causa del rendering JavaScript; l'analisi si basa soltanto su titoli e dati oEmbed.
Bluesky 🔵 Sono stati interrogati direttamente gli endpoint dell'AT Protocol e selezionati oltre 100 post reali. Sul lato closed source, hanno ottenuto di gran lunga più attenzione i problemi di Veo3 nella generazione di contenuti razzisti (❤️842, https://bsky.app/profile/eliothiggins.bsky.social/post/3ls6ridsm4s2y) e il dibattito sul collasso economico di Sora2 (❤️1.375). Sul lato open source, ricercatori che verificano concretamente i modelli, come Simon Willison ed Ethan Mollick, si concentrano su Qwen-Image e GLM-5.3. Sono numerosi anche i post quotidiani realizzati con ComfyUI + Krea2.
Lemmy 🟢 !«メールアドレス» è il principale punto di riferimento, ma i punteggi sono modesti, in genere da 1 a 10. Ciononostante, nella stessa settimana sono stati pubblicati in rapida successione strumenti per Qwen-Image-2.1 — WebUI, LoRA e ControlNet — segnalando un certo dinamismo. Le notizie closed source, quali lo stop all'API di Sora e il ritiro in un giorno della funzione Google Earth di Nano Banana 2 per abuso (https://fortune.com/2026/08/07/google-quietly-discontinues-its-earth-ai-feature/), arrivano quasi sempre dal bot specchio Reddit !ai_reddit: la discussione nativa di Lemmy è pressoché assente.
Pinterest 🟣 Sono stati aperti e verificati 18 dei 50 pin raccolti. Dominano nettamente le immagini-riepilogo di notizie sul lato closed source — loghi OpenAI, Google, Meta e Grok con miniature di volti sorpresi — mentre sul lato open source compare quasi solo AMD Amuse 3.0 come nome concreto. Un'osservazione interessante è che demo di ritratti fotorealistici, fino a rughe e texture della pelle, vengono usate da tutte le aziende come immagine di benchmark. Non è stato possibile recuperare i dati di engagement, come salvataggi e Mi piace; i pin disponibili provenivano soltanto dalla raccolta preventiva del worker.
Cosa osservare
- La velocità di espansione dell'ecosistema Qwen-Image-2.1 — Su Lemmy, WebUI, LoRA e ControlNet sono stati pubblicati nella stessa settimana (https://github.com/ogoun/fooocus-qwen-image-2.1). Vale la pena monitorare attentamente cosa arriverà dopo.
- In che modo i problemi economici di Sora2 influenzeranno la strategia di OpenAI — Un tema acceso sia su Bluesky (https://bsky.app/profile/labuzamovies.com/post/3mek2c2xipk2o) sia su Lemmy, dove si discute della chiusura dell'API di Sora (https://www.reddit.com/r/ArtificialInteligence/comments/1wluu0n/).
- La polarizzazione fra regolamentazione e assenza di regole causata dai guardrail — Reddit (https://www.reddit.com/r/generativeAI/comments/1wtzefv/) e Bluesky (https://bsky.app/profile/emollick.bsky.social/post/3mu5xtm24zk2o) descrivono la stessa struttura da prospettive diverse.
- FLUX 3 di Black Forest Labs — È un rilascio closed source limitato, capace di creare immagini e video di 20 secondi con audio, mentre FLUX.2 continua a essere distribuito anche come open weight (https://bfl.ai/blog/flux-3). Un caso utile per seguire lo sfumarsi del confine fra open e closed.
- L'approccio a bassa VRAM di Z-Image / Qwen-Image — Su YouTube Z-Image viene indicato come superiore a Flux2 (https://www.youtube.com/watch?v=JF4Q5hXh-_Q), con la possibilità di ampliare la platea degli utenti locali.
- La necessità di riesaminare X — Questa volta la raccolta ha mancato il bersaglio perché basata sulla scheda tendenze; una nuova raccolta con parole chiave dirette come “Midjourney”, “Sora” e “Nano Banana” potrebbe rivelare risultati interessanti.
Raccomandazioni
- Nella prossima analisi, X (Twitter) dovrebbe essere riesaminato usando parole chiave dirette legate all'IA come “Midjourney”, “Sora”, “Nano Banana”, “ComfyUI” e “Flux”.
- La crescita rapida dell'ecosistema Qwen-Image-2.1 dovrebbe essere monitorata continuativamente come indicatore delle tendenze open source.
- Il rapporto tra costi operativi e ricavi di Sora2 dovrebbe essere seguito come indicatore della redditività dell'intero mercato dei modelli closed source per la generazione video.
- Occorre mappare con continuità l'abbandono degli utenti dovuto ai guardrail, rilevando da quali strumenti si spostano e verso quali alternative.
- Pinterest dovrebbe estendere il campionamento a tutti i 50 elementi oppure trovare un metodo alternativo per recuperare i dati di engagement.
- Considerata la dipendenza di Lemmy da !ai_reddit, che in pratica ripubblica Reddit, le voci davvero native di Lemmy andrebbero cercate soprattutto nelle comunità !stable_diffusion.
Qualità dei dati
I dati raccolti su X erano completamente estranei al tema della ricerca, a causa di una raccolta accidentale dalla scheda delle tendenze, e non hanno contribuito in alcun modo a questa analisi. Per via del rendering JavaScript, su YouTube non è stato possibile verificare visualizzazioni, data di pubblicazione, iscritti o commenti; l'analisi si limita a titolo e dati oEmbed. Su Pinterest sono stati controllati a vista soltanto 18 pin su 50 e non sono disponibili salvataggi o Mi piace. Su Lemmy i post sono stati verificati, ma i punteggi sono generalmente fra 0 e 10, a indicare un'intensità di discussione inferiore alle altre piattaforme. Reddit e Bluesky si basano su dati raccolti e API reali e risultano quindi relativamente più affidabili.
Riepilogo per piattaforma
Reddit — Notizie sull'IA per la generazione di immagini e video
Dove
9 subreddit hanno trattato questo tema nel set raccolto (12 thread totali, tutti trovati con il solo termine di ricerca "Image and Video Generation AI News"):
- r/generativeAI — 159.938 membri — 3 thread (#1, #2, #7)
- r/TopologyAI — 24.052 membri — 1 thread (#3)
- r/StableDiffusion — 1.027.672 membri — 1 thread (#4)
- r/LocalLLaMA — 838.632 membri — 1 thread (#5)
- r/AI_Agents — 452.911 membri — 1 thread (#6)
- r/accelerate — 93.680 membri — 2 thread (#8, #12)
- r/aifails — 39.194 membri — 1 thread (#9)
- r/VideoEditors — 81.700 membri — 1 thread (#10)
- r/mildlyinfuriating — 12.610.232 membri — 1 thread (#11)
Cosa dicono le persone
- La generazione video closed source “gratuita” è un mito, secondo il consenso della community — Thread #1, r/generativeAI, 71 punti, 46 commenti, 2026-09-30 (https://www.reddit.com/r/generativeAI/comments/1wty6zj/). L'autore sostiene che i costi delle GPU cloud escludano una generazione video davvero gratuita e illimitata; u/opengradient conferma: "i video non sono come gli LLM economici, nessuno può regalarli gratis" (5 punti).
- I filtri NSFW closed source si stanno irrigidendo e spingono gli utenti verso alternative open o non filtrate — Thread #2, r/generativeAI, 7 punti, 14 commenti, 2026-09-30 (https://www.reddit.com/r/generativeAI/comments/1wtzefv/). DreamFort.ai ha inasprito i filtri basati su WAN 3.0; u/opengradient osserva che molti provider closed source hanno recentemente introdotto controlli più severi, incluso Alibaba, proprietaria di Wan 3.0, e indica Seedream 2.0 Unfiltered e MiniMax H3 come alternative.
- Il workflow open source + Blender 3D viene proposto come soluzione alla controllabilità del video generativo, ma la community non è convinta che sia reale — Thread #3, r/TopologyAI, 437 punti, 19 commenti, 2026-09-28 (https://www.reddit.com/r/TopologyAI/comments/1wsmvvm/). Nonostante il punteggio elevato, i commenti principali sono domande confuse ("Quale 'IA 3D' sarebbe?" — u/stevester911, 5 punti) e una liquidazione netta di u/amon_de_no: "Quella è falsa IA vera" (5 punti).
- Gli strumenti open source di coerenza rispetto al riferimento per MiniMax-H3 stanno ottenendo un'accoglienza eccellente — Thread #4, r/StableDiffusion, 690 punti, 51 commenti, 2026-09-30 (https://www.reddit.com/r/StableDiffusion/comments/1wtu82e/). Un nodo ComfyUI gratuito (Fantastic-MiniMaxH3-PromptBuilder) ha risolto il problema del mescolamento delle identità negli editing video con immagini di riferimento; u/ClassicUse2579: "Il loader multimediale H3 è uno dei migliori nodi Comfy che abbia mai usato. È dannatamente valido!" (3 punti).
- Gli stack locali open source per immagini e chat sono abbastanza maturi da funzionare persino come attrazione nostalgica — Thread #5, r/LocalLLaMA, 194 punti, 96 commenti, 2026-10-01 (https://www.reddit.com/r/LocalLLaMA/comments/1wuxzdg/). Un Tandy 1000 degli anni Novanta viene pilotato via Wi‑Fi da Qwen3.8-27B + Krea 2 in esecuzione locale attraverso ComfyUI per chat e generazione di immagini. Il commento principale contesta però la presentazione: u/Aggravating-Push-207 (113 punti): "Non sta girando sul Tandy: invia soltanto richieste nella rete domestica."
- I guardrail closed source frustrano gli utenti casual abbastanza da spingerli verso alternative — Thread #6, r/AI_Agents, 0 punti, 22 commenti, 2026-09-29 (https://www.reddit.com/r/AI_Agents/comments/1wt7jqr/). Un utente non riesce a far generare a ChatGPT un supereroe a causa dei rifiuti dei guardrail; i commentatori suggeriscono Midjourney, Grok, VeniceAI e modelli open "uncensored sdxl".
- Nelle raccomandazioni economiche, gli strumenti closed source con crediti giornalieri restano dominanti per gli utenti casual — Thread #7, r/generativeAI, 4 punti, 59 commenti, 2026-09-26 (https://www.reddit.com/r/generativeAI/comments/1wqfleb/). Le raccomandazioni si dividono: u/Scuzzy_Womack propone ComfyUI offline (3 punti, open), mentre altri indicano Yodayo/MoescapeAI e Leonardo per i loro crediti gratuiti giornalieri (closed).
- Il video closed source, Seedance 2.5 tramite Higgsfield, è ormai sufficiente per un corto narrativo di dieci minuti realizzato da una sola persona — Thread #8, r/accelerate, 784 punti, 196 commenti, 2026-09-26 (https://www.reddit.com/r/accelerate/comments/1wqqr4p/). Riferimenti di character sheet vengono usati in ogni inquadratura per mantenere coerente Captain Walker; u/JoseLunaArts (95 punti) osserva che l'etichetta “senza budget” minimizza i costi in token, mentre u/Nabugu (7 punti) evidenzia il ricorrente problema dell'uniformità dei “bei volti IA”.
- La generazione di immagini continua a fallire in modi sciocchi e degni di meme: un intrattenimento, non una tendenza — Thread #9, r/aifails, 526 punti, 76 commenti, 2026-09-28 (https://www.reddit.com/r/aifails/comments/1ws6jzs/). Un prompt sull'anatomia di un pollo ha prodotto assurdità anatomiche; il commento principale di u/kasimirvendom: "Tutto ha una fine, solo un pollo ne ha due" (52 punti).
- Agli editor video viene esplicitamente consigliato di non fare affidamento sugli strumenti IA, almeno per ora — Thread #10, r/VideoEditors, 4 punti, 39 commenti, 2026-09-26 (https://www.reddit.com/r/VideoEditors/comments/1wqkx27/). Il commento principale di u/VisibleExplanation (33 punti): "Lascia perdere qualsiasi strumento IA. Scarica DaVinci Resolve e impara a usarlo... Nessuno strumento IA ti darà buoni risultati senza una conoscenza fondamentale delle basi."
- Gli strumenti di editing closed source che rietichettano silenziosamente piccole modifiche come “IA generativa” stanno provocando una reazione di sfiducia — Thread #11, r/mildlyinfuriating, 1.268 punti, 136 commenti, 2026-09-28 (https://www.reddit.com/r/mildlyinfuriating/comments/1wsupkx/). Secondo le segnalazioni, Photoshop e Apple Photos etichettano semplici ritagli come modificati dall'IA e rimuovono l'attribuzione del copyright; u/Kagevjijon (41 punti): "Non c'è modo che questa cosa possa restare così. È un vero furto." Un'obiezione di u/teh_maxh (135 punti): "Ho appena provato a ritagliare un'immagine con Photoshop e non ha aggiunto metadati che dicessero che ho usato GAI."
- Le mod di giochi generate con IA, aperte e guidate dalla community, stanno vivendo un momento favorevole — Thread #12, r/accelerate, 193 punti, 35 commenti, 2026-09-30 (https://www.reddit.com/r/accelerate/comments/1wuhyiw/). u/Chopstik0-0 (38 punti) descrive il passaggio della comunità di modding VR dalla resistenza all'entusiasmo, quando è diventato chiaro che "nessun altro sta davvero creando nuovi giochi VR".
Segnali
- In crescita: gli strumenti open source per la coerenza rispetto al riferimento — il nodo ComfyUI del thread #4 e lo stack locale Qwen+Krea2 del thread #5 — ricevono il consenso più netto del campione: punteggi alti uniti a commenti tecnici realmente positivi, non semplice entusiasmo.
- In crescita: la generazione video closed source ha raggiunto il territorio della narrazione a lungo formato — il corto di dieci minuti con personaggi ricorrenti coerenti del thread #8 è il contenuto con maggiore engagement raccolto (784 punti, 196 commenti), e le critiche della community riguardano sceneggiatura e recitazione vocale, non la resa visiva.
- Liquidato: l'idea di un generatore video closed source davvero gratuito viene considerata risolta e un po' noiosa (thread #1): il dibattito si è spostato da “quale sito gratuito” a “quale configurazione open source locale”.
- Disaccordo: il thread #3 mostra una frattura fra entusiasmo superficiale (437 punti) e scetticismo/confusione nei commenti su ciò che viene effettivamente mostrato: i post vaghi sui workflow di “IA 3D” possono accumulare punti senza che nessuno concordi nemmeno su quale sia lo strumento.
- Sorpresa — i guardrail sono ormai un motore ricorrente di cambio piattaforma, non una semplice seccatura: sia il thread #2, sull'inasprimento del filtro NSFW closed source, sia il thread #6, sui guardrail di ChatGPT che bloccano un'immagine non esplicita di un supereroe, mostrano utenti che abbandonano uno strumento closed source per un altro prodotto closed (Grok, VeniceAI) oppure open (Seedream Unfiltered, SDXL senza censure).
- Sorpresa — la reazione di sfiducia contro gli strumenti closed source nel thread #11 non riguarda affatto i filtri: riguarda attribuzione e metadati — l'etichettatura automatica di modifiche comuni come “IA generativa” e la rimozione di informazioni sul copyright — una lamentela distinta dalla frustrazione per i guardrail presente altrove nel campione.
Limiti
- Il raccoglitore ha usato un solo termine di ricerca ("Image and Video Generation AI News"), ottenendo 12 thread in 9 subreddit, meno dell'obiettivo di circa 20 post per rete previsto dai criteri di completamento. In base al playbook, ho letto soltanto ciò che il worker aveva già raccolto (
output/reddit.threads.md) e non ho navigato Reddit per integrare i dati, poiché Reddit blocca WebFetch e le pagine raggiunte dalla ricerca web. - Per i thread #9, #11 e #12 non era stato acquisito il testo iniziale, ma solo il titolo; le conclusioni su questi casi dipendono quindi interamente da commenti e punteggi.
- Non sono emersi thread specifici su grandi annunci dei laboratori closed source, per esempio il lancio di un modello nominato da OpenAI, Google o Midjourney: il set raccolto privilegia esperienza utente, strumenti e frizione con i guardrail rispetto alle notizie di lancio prodotto.
X
X — Notizie sull'IA per la generazione di immagini e video
Account
Nessun account nei dati raccolti parla di IA per la generazione di immagini o video, né closed source né open source. I 33 account catturati (@Davesonude, @rcostadoazeite, @ChrisExcel102, @Louissaikyoo, @DlugoszMarcin, @khtaeverse e altri 27) sono account di meme sportivi, fan K-pop, fan di Big Brother (#BB28), politica britannica (Restore Britain) e shitpost generici. Nessuno pubblica su strumenti IA per immagini o video come argomento principale, quindi non c'è alcun soggetto che stia guidando la conversazione su X per il tema effettivo della ricerca — vedere ## Limiti.
Post
Nessun post in output/x.posts.md (40 post, 33 account) cita IA per la generazione di immagini, IA per la generazione video o prodotti, aziende o progetti open source correlati: nessuna menzione di Midjourney, Sora, Stable Diffusion, Flux, Runway, Veo, Nano Banana, ComfyUI o simili. Un controllo a campione dei post con maggiore engagement lo conferma:
- Post #7, @Davesonude, circa 291.000 visualizzazioni, 22.958 Mi piace (2026-09-30),
https://x.com/Davesonude/status/2105273235965370529 — un meme calcistico su Ronaldo. Trovato cercando “Ronaldo”. - Post #19, @ChrisExcel102, circa 343.000 visualizzazioni, 7.886 Mi piace (2026-09-29),
https://x.com/ChrisExcel102/status/2104913863200096350 — un meme su una relazione tra celebrità. Trovato cercando “JubJub”. - Post #26, @Louissaikyoo, circa 185.000 visualizzazioni, 10.292 Mi piace (2026-09-30),
https://x.com/Louissaikyoo/status/2105090778766696620 — una battuta su Disney Channel. Trovato cercando “China”. - Post #36, @DlugoszMarcin, circa 189.000 visualizzazioni, 2.937 Mi piace (2026-09-30),
https://x.com/DlugoszMarcin/status/2105363575145394223 — commento calcistico su Messi/Lewandowski/Ronaldo/Modrić. Trovato cercando “Messi”.
Nessuno di questi, né i restanti 36 post, riguarda il tema della ricerca. Non elenco da 5 a 12 “risultati” sull'IA per immagini/video perché non ne esistono nel materiale raccolto: farlo significherebbe inventarli, cosa espressamente vietata dal playbook di questa esecuzione.
Segnali
Da questo dataset non è possibile ricavare alcun segnale sull'IA open source o closed source per immagini e video. Ciò che i dati mostrano è che i dieci termini usati per la raccolta ("Halloween", "Ronaldo", "Britain", "Yess", "JubJub", "Gold", "China", "#bb28", "Messi", "Balkans") sono argomenti di tendenza della scheda Explore di X per la sessione, non temi legati alla generazione di media con IA. La tabella Explore in output/x.posts.md lo conferma: 6 delle 10 tendenze sono esplicitamente etichettate come “Trending in Croatia”, mentre le altre — “Ronaldo”, “Britain”, “China”, “Messi” — sono temi globali di sport o politica, non di IA o tecnologia. Sembra un disallineamento nella fase di raccolta: il worker ha estratto ciò che X indicava come tendenza invece di cercare termini sull'IA per immagini e video. I 40 post risultanti parlano quindi di calcio, di un partito politico britannico (Restore Britain), di una disputa nel fandom K-pop, di una stagione di reality TV (#BB28) e di meme non correlati.
Limiti
- I dati raccolti non rispondono al brief di ricerca. Il brief chiede notizie sull'IA open source e closed source per la generazione di immagini/video; i 10 termini usati dal worker erano tendenze generiche di X per questa sessione, geolocalizzata soprattutto in Croazia secondo la tabella Explore, e non query relative all'IA. Tutti i 40 post sono stati esaminati manualmente rispetto al tema e nessuno è idoneo.
- In base al playbook di questa fase, non ho navigato direttamente X, poiché un lettore anonimo non vede contenuti, e mi sono basato soltanto su
output/x.posts.md/output/x.posts.jsoncome raccolti. - Sebbene il criterio di completamento di volume — analizzare circa 20 post per social network — sia stato superato con 40 post, non è stato soddisfatto in termini di rilevanza. La fase X dovrebbe essere ripetuta con termini come “Midjourney”, “Sora”, “Stable Diffusion”, “Flux”, “Runway”, “Veo”, “Nano Banana”, “ComfyUI” o simili, invece delle tendenze generiche usate in questa esecuzione.
YouTube
YouTube — Notizie sull'IA per la generazione di immagini e video (closed source/open source)
Canali
- AI WITH Rithesh (Rithesh Sreenivasan) — Canale personale che verifica immediatamente le novità di ChatGPT/OpenAI.
- Bart Slodyczka — Canale che riepiloga i cambiamenti subito dopo l'uscita dei nuovi modelli.
- Learn with LEESI — Canale specializzato in tutorial Google Gemini/Veo/Flow.
- WorldofAI(@intheworldofai) — Rassegna settimanale sulle novità dell'IA closed source.
- MattVidPro — Grande canale IA noto per confronti e notizie rapide sui modelli di generazione video.
- There's An AI For That(@theresanaiforit) — Notizie rapide e confronti su nuovi modelli.
- Promptus AI(@promptusai) — Specializzato in tutorial per installare localmente modelli open source per immagini/video.
- AI Late to Class(@ailatetoclass) — Recensioni di modelli open source per l'editing di immagini.
- MaxonShire — Specializzato in confronti tra modelli locali di generazione video, inclusi HunyuanVideo, Wan e LTX.
- smallzero(@webdot3) — Uso di modelli open source come Z-Image con ComfyUI.
- FlyMyAI — Brief quotidiani e settimanali sulle notizie IA.
- Lev Selector(@lev-selector) — Canale di riepilogo settimanale degli aggiornamenti IA.
Non è stato possibile verificare direttamente il numero di iscritti, perché l'HTML dei risultati di ricerca YouTube viene renderizzato via JavaScript (vedere Limiti).
Video
Closed source
- «ChatGPT Images 2.5 Is INSANE… 48 Hours Later, I'm Still Shocked!» — AI WITH Rithesh / inizio settembre 2026 — Verifica di GPT Image 2.5, introdotto da OpenAI l'8 settembre 2026, con la nuova funzione “Sketch” per generare immagini da schizzi e una velocità di generazione fino al 50% superiore. https://www.youtube.com/watch?v=LYUr4BY33h4
- «ChatGPT Image 2.5 Just Dropped — Here's Everything That's New» — Bart Slodyczka / settembre 2026 — Panoramica completa delle nuove funzioni di GPT Image 2.5. https://www.youtube.com/watch?v=dvpQHWwuaIo
- «Google Just Made VEO 3.1 FREE for Everyone with Unlimited AI Video Generation» — Learn with LEESI — Presentazione dell'apertura gratuita di Veo 3.1, con supporto immagine-video e tre immagini di riferimento, tramite Google Flow/Vids. https://www.youtube.com/watch?v=uj6eD31OxkA
- «Google's Nano Banana 2.0: Best Text-To-Image Generation Model EVER! The Photoshop killer!» — WorldofAI — Test di Nano Banana 2.0 di Google DeepMind, generatore di immagini della famiglia Gemini, valutato come superiore a Photoshop. https://www.youtube.com/watch?v=u22-XoQvI4I
- «Kling 2.5 goes BEAST MODE for AI Video!» — MattVidPro — Report su un forte miglioramento di Kling 2.5 nella dinamicità dei movimenti. https://www.youtube.com/watch?v=SGUxHC1cI1c
- «AI Video Models Are Getting Out of Control! (WAN 2.5, Kling 2.5, Wanimate)» — MattVidPro — Confronto affiancato fra Kling, closed source, e Wan, open source, che evidenzia l'intensificarsi della concorrenza. https://www.youtube.com/watch?v=vFXe3uXb75k
- «Your AI news brief for September 3, 2026.» — FlyMyAI — Brief generale sulle notizie IA al 3 settembre 2026, comprese quelle sulla generazione di immagini/video. https://www.youtube.com/watch?v=JK6w9tA2jH8
- «Exciting AI Updates Weekly - September 25, 2026» — Lev Selector — Riepilogo settimanale degli aggiornamenti IA, inclusi modelli per immagini e video. https://www.youtube.com/watch?v=iyZHPCNd8jI
Open source
- «Is FLUX 2.0 The New Open Source King?» — There's An AI For That — FLUX.2 di Black Forest Labs viene valutato come candidato principale fra i modelli open-weight per immagini ed editing. https://www.youtube.com/watch?v=YQuTkPVkCS8
- «New Open-Source Model DESTROYS Flux 2 — Z-Image + Promptus Tutorial»(il titolo oEmbed è «Z-Image Open-Source Image Generator: Free Online and Local Setup») — Promptus AI — Presenta Z-Image Turbo di Tongyi-MAI, Alibaba, modello da 6 miliardi di parametri eseguibile con 6 GB di VRAM e descritto come superiore a Flux 2. https://www.youtube.com/watch?v=JF4Q5hXh-_Q
- «Z-Image Full Release: The New King of AI Influencers in ComfyUI?» — smallzero — Verifica in ComfyUI della versione completa non distillata di Z-Image (Base). https://www.youtube.com/watch?v=ClVY5ll1sDU
- «Qwen Image 2.1 best open source Image Editor. Better than Nano Banana» — AI Late to Class — La versione più recente di Alibaba Qwen-Image-Edit, con dieci immagini di riferimento, sfondi trasparenti e maggiore velocità, viene giudicata pari o superiore a Nano Banana. https://www.youtube.com/watch?v=AIgYj5RG-FQ
- «HunyuanVideo 1.5 vs Wan 2.7 Comparison: Which is The Best Free Local Video AI Generation Model?» — MaxonShire — Confronto tra HunyuanVideo 1.5 di Tencent e Wan 2.7 di Alibaba come modelli locali per la generazione video. https://www.youtube.com/watch?v=4GNT4-QYekg
Segnali
- I closed source competono sulla velocità nell'aggiungere funzioni: OpenAI con GPT Image 2.5 e “Sketch” l'8 settembre 2026, Google con l'apertura gratuita di Veo 3.1 e l'integrazione con Google Vids/Flow, e Kling 2.5 hanno pubblicato novità quasi nello stesso periodo, confermando una competizione che procede mese per mese.
- Il fronte open source è guidato sempre più da operatori cinesi, Alibaba Tongyi-MAI e Qwen: Z-Image Turbo e Qwen-Image-Edit vengono ripetutamente presentati attraverso i temi “funziona con 6 GB / poca VRAM” e “qualità al livello di Nano Banana”, in confronto diretto con FLUX.2 di Black Forest Labs.
- I video di confronto “open contro closed” sono diventati un genere a sé: titoli come “WAN 2.5 is Open Source Veo3” o “Z-Image vs Flux 2” sono molto frequenti e trattano i modelli open source come alternative ai prodotti chiusi.
- I tutorial sull'esecuzione locale con ComfyUI di Promptus AI, MaxonShire e smallzero sono diventati il formato dominante per i modelli open source: a ogni uscita di modello segue subito un video su come installarlo in ComfyUI.
- Canali di brief IA settimanali o quotidiani, come FlyMyAI e Lev Selector, continuano a trattare i temi della generazione di immagini/video e diffondono le notizie sui singoli modelli anche tramite aggiornamenti periodici.
Limiti
- La pagina dei risultati YouTube (
youtube.com/results?search_query=...) e le pagine video (youtube.com/watch?v=...) sono renderizzate con JavaScript; WebFetch non ha quindi potuto ottenere direttamente elenco video o contenuto delle pagine, incluse visualizzazioni, data di pubblicazione, iscritti e commenti. Titoli e canali sono stati verificati singolarmente tramite l'endpoint JSONyoutube.com/oembed, mentre periodo e contesto sono stati integrati con snippet di ricerca web e articoli correlati. - Di conseguenza, non sono stati verificati il numero esatto di visualizzazioni, la data di pubblicazione e gli iscritti dei singoli video. Alcuni risultati mostravano indicazioni relative come “X giorni fa”, ma molti erano più vecchi di 60 giorni, talvolta oltre 300; il report privilegia quindi temi chiaramente giudicati entro 60 giorni, come GPT Image 2.5 dell'8 settembre 2026 e i brief settimanali con date esplicite.
- Per Runway Gen-4.5, Grok Imagine, Seedream 4.0 e Midjourney V8 sono stati confermati video correlati, ma non si disponeva di informazioni sufficienti su data di pubblicazione o dettagli del canale; non sono quindi inclusi nella sezione Video, pur essendo stati individuati dalla ricerca web.
- I contenuti dei commenti non sono stati analizzati, perché il corpo delle pagine video non era recuperabile.
Bluesky
Bluesky — Notizie sull'IA per la generazione di immagini e video (closed source/open source)
Metodo di ricerca: il sito ufficiale Bluesky (bsky.app) non rendeva i risultati di ricerca a causa della sua architettura SPA JavaScript, quindi è stata interrogata direttamente l'API pubblica AT Protocol (https://api.bsky.app/xrpc/app.bsky.feed.searchPosts, senza autenticazione) per ottenere dati reali sui post — testo, autore, Mi piace e data di pubblicazione. Sono stati cercati termini come “Nano Banana”, “Sora 2”, “Flux”, “ComfyUI”, “Z-Image”, “Qwen Image”, “open weights” e “Veo 3”; sono stati controllati oltre 100 post reali e selezionati quelli pertinenti.
Account
- Eliot Higgins(
eliothiggins.bsky.social, fondatore di Bellingcat, verificato su Bluesky) — Pubblica con continuità sui rischi di disinformazione e deepfake generati da Veo 3. - Simon Willison(
simonwillison.net, ricercatore IA indipendente, verificato su Bluesky) — Pubblica note tecniche dopo avere eseguito localmente modelli open-weight come Qwen-Image / Qwen-Image-Edit. - Ethan Mollick(
emollick.bsky.social, professore alla Wharton School, verificato su Bluesky) — Commenta regolarmente rischi e capacità dei modelli open-weight. - Giornalisti di 404 Media (Jason Koebler
jasonkoebler.bsky.social, Sam Colesamleecole.bsky.social) — Indagano su copyright e moderazione dei contenuti di Sora 2. - obeca(
obeca.bsky.social, area linguistica turca) — Account personale che pubblica quasi ogni giorno immagini create con Nano Banana 2. - Ria_Tatibana(
ria-tatibana.bsky.social, area linguistica giapponese) — Pubblica quotidianamente illustrazioni realizzate con ComfyUI + Krea2, modello open source. - cubby.jpg(
cubby-ai.bsky.social) — Account che produce numerose opere IA con modelli open source come Z-Image e Qwen-Image. - AlternativeTo(
alternativeto.net) — Account automatico di notizie software che segnala rapidamente rilasci come Qwen-Image-2.1.
Post
Closed source
- Il problema per cui Google Veo 3 può generare contenuti razzisti — Eliot Higgins, 2025-06-22, ❤️842. «Google Veo 3 offre modi nuovi ed entusiasmanti per fare razzismo.» https://bsky.app/profile/eliothiggins.bsky.social/post/3ls6ridsm4s2y
- TIME è riuscita a usare Veo 3 per creare video falsi di musulmani che appiccano il fuoco a un tempio indù; Google ha aggiunto filigrane visibili dopo le richieste della testata — Aman Batheja, giornalista TIME, 2025-06-03, ❤️431・🔁192・citazioni 107. https://bsky.app/profile/amanbatheja.bsky.social/post/3lqpalskjp22h
- Secondo una segnalazione, Sora 2 costa circa 5 miliardi di dollari l'anno per funzionare e ha generato finora circa 1,4 milioni di dollari per OpenAI — Peter Labuza, 2026-02-10, ❤️1.375・🔁368・citazioni 192. https://bsky.app/profile/labuzamovies.com/post/3mek2c2xipk2o
- Un articolo critico sostiene che Sora simboleggi il crollo della pretesa delle aziende IA di non addestrarsi su opere protette da copyright — Jason Koebler, 404 Media, 2025-10-01, ❤️1.508・citazioni 44. https://bsky.app/profile/jasonkoebler.bsky.social/post/3m25uzxbcak23
- Secondo un reportage, gli utenti di Sora 2 si sono infuriati quando è stata vietata la generazione di personaggi protetti da copyright — Sam Cole, 404 Media, 2025-10-08, ❤️435・citazioni 37. https://bsky.app/profile/samleecole.bsky.social/post/3m2ovizmqks2t
- Un'esperienza personale di essere stati ingannati da immagini generate con Nano Banana (2) — furuakasaber.bsky.social, 2026-07-03, ❤️333. «Questa roba di Nano Banana mi ha ingannato, anche se sentivo che qualcosa non quadrava. Fa piuttosto paura.» https://bsky.app/profile/furuakasaber.bsky.social/post/3mpr6djkzsk2e
- Stanchezza verso le infografiche di Nano Banana, percepite come generiche e chiaramente artificiali — garrison.corporate.fm, 2026-03-15, ❤️73・🔁9. «Le infografiche nano banana devono essere fermate a ogni costo.» https://bsky.app/profile/garrison.corporate.fm/post/3mh4g5avqp22p
Open source
- Alibaba Qwen pubblica il suo primo modello di generazione di immagini, Qwen-Image, con licenza Apache 2.0 — Simon Willison, 2025-08-04, ❤️46. https://bsky.app/profile/simonwillison.net/post/3lvlvsxkzp223
- Test pratico di Qwen-Image-Edit: su Mac consuma quasi tutti i 64 GB di RAM e richiede 54 GB di spazio disco — Simon Willison, 2025-08-19, ❤️77. https://bsky.app/profile/simonwillison.net/post/3lws3xfzhv22u
- Alibaba pubblica Qwen-Image-2.1, modello open-weight da 7 miliardi di parametri, con modifica della licenza — AlternativeTo, 2026-09-24, ❤️6. https://bsky.app/profile/alternativeto.net/post/3mwaq75byhn2a
- Apple pubblica open-weight STARFlow e STARFlow-V, modelli transformer autoregressivi a flusso per la generazione di immagini e video — Sung Kim, 2025-12-02, ❤️13. https://bsky.app/profile/sungkim.bsky.social/post/3m6xsab2zj22w
- Avvertimento: il modello open-weight GLM-5.3 è potente ma quasi privo di guardrail e dispone anche di capacità cyber offensive — Ethan Mollick, 2026-08-28, ❤️88. https://bsky.app/profile/emollick.bsky.social/post/3mu5xtm24zk2o
- Illustrazioni quotidiane con ComfyUI + Krea2, modello open source, da 50 a 80 ❤️ per post — Ria_Tatibana, diversi post fra il 2026-09-28 e il 2026-10-01 (esempio: https://bsky.app/profile/ria-tatibana.bsky.social/post/3mwtrqf7glc2t, ❤️53). I risultati principali per il tag ComfyUI sono dominati da condivisioni quotidiane di opere IA.
- Attesa e ironia sulla nuova uscita di Z-Image, modello leggero open source per immagini di Alibaba Tongyi — theophite.bsky.social, 2025-11-27, ❤️30. https://bsky.app/profile/theophite.bsky.social/post/3m6ldsilaz22f
Segnali
- Veo 3 ha consolidato una reputazione da strumento di disinformazione: Eliot Higgins, fondatore di Bellingcat, ne parla ripetutamente e l'inchiesta di TIME ha ottenuto ampia diffusione, ❤️431 e 107 citazioni. Il nodo principale della generazione video closed source si è spostato dalla qualità all'abuso.
- Sora 2 affronta difficoltà economiche e polemiche persistenti: la cifra di 5 miliardi di costi operativi annui contro 1,4 milioni di ricavi, ❤️1.375, ha avuto larga diffusione. L'irrigidimento delle limitazioni sui personaggi protetti da copyright ha inoltre provocato forte insoddisfazione degli utenti, ❤️435. Riappare così lo schema “cambio delle regole closed source → reazione degli utenti”.
- Nano Banana di Google è ormai uno strumento predefinito di generazione immagini per gli utenti casual: singoli utenti come obeca.bsky.social pubblicano immagini quasi ogni giorno e il suo uso si è radicato anche in contesti non anglofoni, come quelli turco e giapponese. Restano però forti le reazioni di chi afferma che l'indistinguibilità sia inquietante, ❤️333.
- Qwen-Image è il fulcro tecnico della generazione di immagini open source: ricercatori come Simon Willison ne svolgono test pratici fino a RAM, VRAM e spazio disco, e la licenza Apache 2.0 è accolta positivamente. La modifica di licenza in Qwen-Image-2.1, però, introduce tensione anche nel mondo open source sulla domanda “quanto è davvero aperto?”.
- ComfyUI resta il workflow standard de facto per la generazione open source: gran parte dei risultati riguarda illustrazioni quotidiane create con ComfyUI e modelli specifici, come Krea2 e SDXL, segnalando un'integrazione nella pratica quotidiana più che una semplice notizia tecnica.
- Open-weight significa alta capacità ma guardrail assenti, secondo gli avvertimenti degli esperti: ricercatori noti come Ethan Mollick iniziano a discutere delle capacità offensive e dei test di rischio minimi di modelli come GLM-5.3. Anche grandi aziende come Apple, con STARFlow, si stanno affacciando ai rilasci open-weight, ampliando la base del fronte open source.
Limiti
- Il sito ufficiale Bluesky, bsky.app, è una SPA e WebFetch non ha potuto ottenerne direttamente il testo. L'endpoint di ricerca
public.api.bsky.appha risposto con errore 403; alla fine, lo stesso endpoint suapi.bsky.app, senzapublic., ha risposto senza autenticazione ed è stato usato per recuperare dati reali. - Parole chiave che possono sovrapporsi a nomi comuni o altri ambiti, come “Flux”, “Kling” e “Wan”, hanno generato molto rumore: con la ricerca Flux, per esempio, 15 risultati hanno prodotto in pratica zero post sulla generazione di immagini IA. Non è stato possibile trovare una quantità sufficiente di discussioni specifiche su FLUX.2 di Black Forest Labs.
- Per modelli video specifici quali Kling 2.5, Wan 2.5, HunyuanVideo e Seedance, le parole chiave usate non hanno generato abbastanza risultati; non è stato possibile verificare un'effettiva discussione su Bluesky. È possibile che YouTube e altre piattaforme siano più attive.
- Anche con
sort=top, l'API di ricerca non sembra restituire sempre una classifica di popolarità rigorosa: la paginazione basata su cursor mescola date diverse. I post selezionati sono quindi estratti per rilevanza ed esistenza verificata, non una graduatoria precisa della popolarità.
Lemmy
Lemmy — Dinamiche dell'IA per la generazione di immagini e video (closed source/open source)
Comunità
- !«メールアドレス» — Comunità principale per nuovi modelli e strumenti open source. La frequenza di pubblicazione è alta, ma i singoli post hanno punteggi modesti, tipicamente da 1 a 10.
- !«メールアドレス» / !«メールアドレス» — Comunità di post automatici collegati a Civitai, che pubblicano quotidianamente immagini generate con Krea, SDXL e modelli affini. Hanno scarso valore di notizia, ma mostrano l'uso quotidiano dei modelli open source.
- !«メールアドレス» / !«メールアドレス» — Comunità di arte astratta che spesso multipubblicano le stesse immagini.
- !«メールアドレス» — Comunità bot che rispecchia subreddit IA di Reddit, come r/ArtificialIntelligence. È la principale fonte di arrivo delle notizie closed source, su Sora, Nano Banana e Seedream, ma i punteggi sono quasi sempre 0 o 1 e non c'è praticamente discussione.
- !«メールアドレス» / !«メールアドレス» / !tech — Dove compaiono occasionalmente notizie su FLUX di Black Forest Labs e simili.
- !«メールアドレス» / !casual_perchance — Comunità di utenti del servizio gratuito di generazione immagini nel browser Perchance.org.
- Non è stato possibile verificare il numero di iscritti alle comunità: le pagine
/c/<name>di Lemmy.world restituivano errori 500/400 e anche l'API/api/v3/communitynon ha consentito il recupero per parametri non chiari, come indicato nei Limiti.
Post
Più orientati all'open source
- scraed/LanPaint — Inpainting di alta qualità senza addestramento, utilizzabile con qualunque modello Stable Diffusion e compatibile con ComfyUI / !«メールアドレス» / punteggio 8 / 2026-09-29 / https://github.com/scraed/LanPaint/
- DenRakEiw/scumble — Editor desktop dedicato all'inpainting IA, con livelli, selezione testuale e pennelli personalizzati; disegna tramite ComfyUI proprio o provider API ed è compatibile con MCP / !«メールアドレス» / punteggio 3 / 2026-09-29 / https://github.com/DenRakEiw/scumble
- ogoun/fooocus-qwen-image-2.1 — WebUI per Qwen-Image-2.1 / !«メールアドレス» / punteggio 2 / 2026-09-27 / https://github.com/ogoun/fooocus-qwen-image-2.1
- PrunaAI/Pruna-Qwen-Image-2.1 — Adattatore LoRA a pochi step per Qwen-Image-2.1, comparso insieme al ControlNet union
QwenImage_experimentaldi Kijai e ad altri strumenti che stanno rapidamente espandendo l'ecosistema Qwen-Image-2.1 / !«メールアドレス» / punteggio 0 / 2026-09-26 / https://huggingface.co/PrunaAI/Pruna-Qwen-Image-2.1 - black-forest-labs/FLUX.2-klein-9b-kv-fp8 — Versione quantizzata FP8 del modello open-weight da 9 miliardi di parametri di Black Forest Labs / !«メールアドレス» / punteggio 8 / 2026-03-14 / https://huggingface.co/black-forest-labs/FLUX.2-klein-9b-kv-fp8
- Alice v1: Distillation-Enhanced Video Generation Surpassing Closed-Source Models — Modello open source di generazione video che afferma di superare i modelli closed source grazie al miglioramento tramite distillazione / !«メールアドレス» / punteggio 5 / 2026-05-13 / allegato webm, lemmy.dbzer0.com pictrs
Più orientati al closed source
- Black Forest Labs annuncia “FLUX 3” — Oltre alle immagini, può generare video di 20 secondi con audio; inizialmente disponibile in accesso limitato / !«メールアドレス» / punteggio 1 / 2026-07-24 / https://bfl.ai/blog/flux-3
- OpenAI chiuderà l'API di Sora la settimana successiva, il 24 settembre, mentre concorrenti cinesi raccolgono 3 miliardi di dollari — Analisi secondo cui il video IA per consumatori non è redditizio, mentre aziende enterprise come Kling raccolgono capitali / !«メールアドレス» / punteggio 1 / 2026-09-20 / https://www.reddit.com/r/ArtificialInteligence/comments/1wluu0n/
- Google ritira dopo un giorno la funzione IA di Google Earth, Nano Banana 2 — Funzione sospesa per il rischio di abuso / !«メールアドレス» / punteggio 1 / 2026-08-07 / https://fortune.com/2026/08/07/google-quietly-discontinues-its-earth-ai-feature/
- Confronto e spiegazione tecnica onesta di Seedream 5.0 Pro contro Nano Banana Pro / !«メールアドレス» / punteggio 1 / 2026-07-10 / https://www.reddit.com/gallery/1usc03q
- Confronto “la stessa doppia pagina di Berserk colorata da quattro IA” — ChatGPT Images 2.5, Wan 2.7 Pro, Nano Banana Pro e Seedream 5.0 Pro a confronto; secondo alcuni GPT vince / !«メールアドレス» / punteggio 1 / 2026-09-14 / https://www.reddit.com/gallery/1wfyqdy
- Lo stesso prompt fornito a sei modelli video IA e valutato alla cieca da circa 40 persone — Google Veo al primo posto, con i primi tre modelli molto vicini / !«メールアドレス» / punteggio 1 / 2026-09-17 / https://www.reddit.com/r/ArtificialInteligence/comments/1wipgwa/
- Annuncio di Seedance 2.5 di ByteDance — Aggiunge generazione one-take e riferimenti flessibili / !«メールアドレス» / punteggio 3 / 2026-08-01 / https://seed.bytedance.com/en/blog/one-take-creation-flexible-referencing-introducing-seedance-2-5
- Runway dichiara il raddoppio del business enterprise e un NRR superiore al 300% / !«メールアドレス» / punteggio 0 / 2026-08-30 / https://www.reddit.com/r/ArtificialInteligence/comments/1w2hnea/
Segnali
- Qwen-Image-2.1 è il centro del fronte open source su Lemmy: WebUI derivata da fooocus, ControlNet di Kijai e LoRA a pochi step di PrunaAI sono comparsi tutti nella stessa settimana, fra il 26 e il 27 settembre. Qwen-Image è quindi l'attuale principale terreno di lavoro della comunità ComfyUI/Stable Diffusion.
- I closed source stessi stanno abbattendo i confini: Black Forest Labs, tradizionalmente orientata agli open weight, ha offerto FLUX 3 con video e audio in un accesso closed limitato, ma continua in parallelo a pubblicare modelli open-weight come FLUX.2-klein-9b. La linea tra open e closed è sempre più sfumata.
- Nano Banana 2 porta insieme attenzione e controversie: l'integrazione in Google Earth, seguita dal ritiro dopo un giorno per abusi, è la notizia con il punteggio più alto, 6, mentre gli altri post restano perlopiù su valori bassi.
- Il video IA viene descritto come non redditizio per il consumatore: mentre OpenAI ferma l'API di Sora, Kling, Seedance e Runway puntano all'enterprise e sembrano vincere su finanziamenti e ricavi; questo contrasto ricorre in più post giunti tramite il mirror di Reddit.
- I contenuti comparativi affiancati sono numerosi: Nano Banana Pro, Seedream 5.0 Pro, Wan 2.7 Pro e ChatGPT Images 2.5 vengono ripetutamente messi alla prova nelle stesse condizioni. Gli utenti sembrano più interessati a sapere quale modello prevalga che alle singole notizie.
- La discussione nativa di Lemmy è quasi inesistente: gran parte dei post trovati proviene dal bot specchio !ai_reddit, con punteggi 0–1 e commenti poco attivi. I pochi contributi originali sono soprattutto post di strumenti su !«メールアドレス».
Limiti
- Lemmy non dispone di una grande comunità dedicata esclusivamente all'IA per immagini/video. I contenuti sono dispersi fra !«メールアドレス», piccola comunità di strumenti e modelli con punteggi a una cifra, e !ai_reddit, comunità bot che trasferisce post da Reddit con punteggi 0–1. Quest'ultima è, di fatto, una ripubblicazione di Reddit e non una voce indipendente di Lemmy.
- Non è stato possibile ottenere il numero di iscritti alle comunità.
https://lemmy.world/c/<community>ha restituito ripetutamente HTTP 500, mentrehttps://lemmy.world/api/v3/community?name=...ha restituito HTTP 400; le specifiche dei parametri potrebbero differire dalla documentazione v3 standard oppure l'istanza potrebbe applicare restrizioni. - Parole chiave come “Grok Imagine”, “Kling AI”, “Runway Gen”, “HunyuanVideo” e “Flux” da sole hanno restituito quasi nessun post pertinente, soltanto rumore, a indicare poche citazioni dirette di questi nomi su Lemmy.
- L'API di ricerca di lemmy.world dichiara una ricerca federata fra istanze, ma in pratica ha restituito soprattutto post da lemmy.world, lemmy.ml, lemmy.dbzer0.com, lemmy.today e lemmy.zip. Non c'è stato tempo per cercare separatamente lemmy.ml o lemm.ee.
- I punteggi dei post sono complessivamente bassi, nella maggioranza dei casi fra 0 e 10, e non indicano un livello di entusiasmo paragonabile ad altre piattaforme. Ciò riflette sia le dimensioni ridotte di Lemmy sia l'assenza di comunità specializzate nel tema.
Pinterest — Notizie sull'IA per la generazione di immagini e video
Sono stati raccolti 50 pin, senza divisione per genere, in un unico set. Sono stati effettivamente aperti e verificati titoli e miniature.
Temi visivi
- Miniature “YouTuber con espressione sorpresa + insieme di loghi” — Loghi di OpenAI, Google, Meta, Microsoft e Anthropic disposti in stile neon accanto a un uomo dal volto sorpreso: il formato ricorrente delle miniature “AI NEWS” per il lato closed source
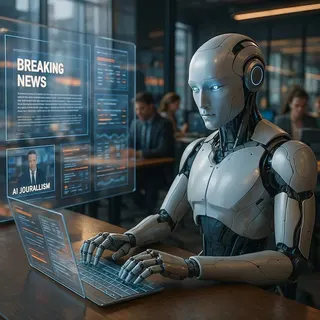
[2, 7, 23, 41]. - Il robot come conduttore di notiziari — Ricorrono umanoidi bianchi in abito davanti a pannelli “BREAKING NEWS” e immagini di un'ancora IA che prende il controllo di uno studio televisivo
[23, 45]. - Demo con ritratti fotorealistici — Volti di uomini anziani con rughe, barba e texture altamente dettagliate vengono ripetutamente usati come immagine principale degli annunci di nuovi modelli, per esempio AMD Amuse 3.0 e primi piani di Luma Dream Machine. Il realismo è diventato il benchmark visivo del momento
[43, 47]. - Griglie di confronto che trasformano la stessa sorgente video in più stili — La stessa persona o auto viene rigenerata come intaglio nel legno, origami, Lego o composizione floreale, come demo di coerenza stilistica
[4]. - Mockup di interfacce futuristiche al neon — Icone luminose, silhouette di teste con circuiti e dashboard olografiche promuovono in modo astratto la generazione di immagini, video, musica e testo
[5, 9, 22, 50]. - Infografiche di confronto e scelta rapida degli strumenti — Loghi di ChatGPT, Midjourney, Gemini, Runway, Pika e Krea disposti a griglia in grafici neon cyberpunk, con consigli come “questo se paghi, questo se vuoi gratis”
[40]. - Visual di avvertimento su rilevamento dei falsi ed etica dell'IA — Un robot che sospetta un'immagine di gatto marcata “FAKE”, infografiche prima/dopo degli occhi e messaggi del tipo “non fidarti solo dell'aspetto” sono presenti in modo consistente
[1, 20, 32, 37]. - Sono frequenti anche pin in cui titolo e immagine non coincidono — Per esempio, un titolo sulla partecipazione di Stability AI alla generazione video può accompagnare in realtà un collage di moodboard fantasy. Le miniature riutilizzate e orientate al clic sembrano comuni
[29].
Pin rilevanti
- [2] AI News: Anthropic Leak Shows Us The Future of AI... — Miniatura “AI NEWS” classica con loghi luminosi di OpenAI, Google, Microsoft e Anthropic. Video-riepilogo delle tendenze closed source.
- [4] Google announces ultra-high quality video... — Griglia comparativa che rigenera la stessa persona e la stessa auto in legno, origami, Lego e fiori. Demo facilmente leggibile di coerenza stilistica.
- [5] Meta Unveils Muse Image and Muse Video Generative... — Banner fantascientifico “Meta Muse Spark AI Model 2026”, incentrato sull'idea di assistente IA personale.
- [23] Discover how Grok is revolutionizing video... — Visual di un conduttore androide bianco seduto davanti al pannello “BREAKING NEWS”, che immagina un futuro in cui l'IA produce le notizie.
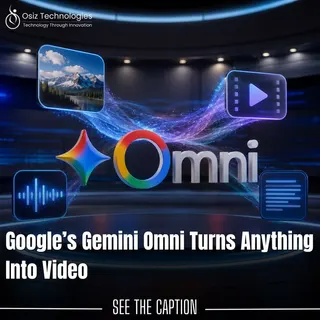
- [26] Google's Gemini Omni Turns Anything Into Video — Il logo “Omni” al centro, circondato da icone di immagini, video, audio e testo, per promuovere l'integrazione multimodale.
- [38] Google Unveils Veo 2: Advanced AI Video Generation... — Banner dall'aspetto ufficiale di Veo2, con slogan “state-of-the-art video generation model” e campioni affiancati di contenuti realistici e animati.
- [43] Introducing Luma Dream Machine - Next Generation AI Video — Primo piano estremo di un occhio con la tipografia “Dream Machine”, immagine simbolica per esaltare la potenza della generazione fotorealistica.
- [47] 'Amuse 3.0', an AI art creation tool that includes... — Strumento di arte IA eseguibile localmente di AMD. La demo usa il volto fotorealistico di un pescatore anziano e mette in risalto la generazione avanzata su GPU. È uno dei pochi strumenti concretamente nominati e orientati al locale/open source.
- [40] Top AI Video Generators of 2025 — Tabella comparativa al neon che distribuisce ChatGPT Plus, Midjourney, Runway, Pika, Kaiber e altri fra priorità “qualità dell'immagine” e “gratuito”. Informazione pratica per la scelta dello strumento.
- [20] 'AI is getting scary good.' — Infografica di avvertimento su generazione video IA, rilevamento delle voci e prompt engineering. Veicola un messaggio di alfabetizzazione all'IA: non fidarti semplicemente dell'aspetto.
Segnali
- Su Pinterest, le “notizie sull'IA per immagini e video” sono dominate in modo schiacciante da miniature di notizie sul lato closed source — OpenAI, Google Veo/Gemini Omni, Meta Muse, Grok, Midjourney, Runway e Pika. Predomina il formato “volto sorpreso + insieme di loghi”, apparentemente derivato dalle miniature YouTube: il valore di clic conta più della profondità informativa.
- I contenuti open source o di generazione locale sono scarsi. I soli nomi concreti sono Stability AI, comunque presente solo nel titolo con un'immagine non correlata, e AMD Amuse 3.0, strumento eseguibile localmente su GPU. Non compaiono visual tecnici generati dalla community, come ComfyUI, Hugging Face, diagrammi di architetture a diffusione o simili.
- La generazione di persone fotorealistiche, con rughe e texture della pelle molto curate, viene ripetutamente usata da varie aziende come visual di benchmark per affermare “oggi siamo in grado di fare questo”, segnalando maturità tecnica.
- Un numero non trascurabile di infografiche affronta sfiducia e verifica dei contenuti generati dall'IA, inclusi riconoscimento di falsi, autenticità delle voci ed etica: insieme alla generazione, è visibile interesse per come riconoscere e usare responsabilmente questi contenuti.
- Risultano invece assenti pin che trattino direttamente modelli open source specifici come Stable Diffusion, FLUX, Wan o HunyuanVideo; screenshot di GitHub o blog tecnici; e pin con paper o numeri di benchmark. La natura di Pinterest privilegia riassunti secondari, tabelle comparative e banner promozionali rispetto alle fonti primarie delle comunità tecniche.
Limiti
- In
output/pinterest.pins.mdnon esiste una divisione per genere, poichégenreè vuoto, e il materiale è stato fornito come unico set di 50 elementi. Non è quindi possibile produrre il riepilogo per genere previsto dal playbook: l'intero set è stato analizzato come un insieme unico. - Sono state aperte effettivamente 18 immagini su 50, scegliendo campioni in base alla specificità dei titoli e alla distribuzione dei temi. Le altre 32 non sono state controllate; tuttavia, nel campione verificato la ripetizione dei formati è abbastanza forte da rendere i pattern evidenti.
- Diversi pin mostrano disallineamento fra titolo e immagine, come il titolo su Stability AI accompagnato da una moodboard non correlata. In questi casi si fa riferimento al contesto del titolo e non al contenuto dell'immagine.
- Pinterest non è stato aperto direttamente nel browser: sono stati usati soltanto immagini e titoli raccolti in anticipo dal worker. Per questo non sono stati verificati i dati di engagement, come salvataggi e Mi piace, né gli articoli completi collegati dai pin.
Azioni consigliate
- Ripetere la fase X usando parole chiave IA dirette, quali Midjourney, Sora, Nano Banana, ComfyUI e Flux, invece delle tendenze generiche.
- Continuare a seguire l'ecosistema Qwen-Image-2.1 — WebUI, LoRA e ControlNet — come indicatore anticipatore dello slancio open source.
- Monitorare il divario fra costi e ricavi di Sora 2 come indicatore della redditività della generazione video closed source.
- Mappare quali strumenti scelgono gli utenti quando un prodotto closed source irrigidisce i propri guardrail.
- Estendere il campionamento Pinterest oltre 18 pin su 50 oppure individuare un metodo per recuperare le metriche di engagement.
- Nel valutare i risultati, trattare !ai_reddit di Lemmy come uno specchio di Reddit e non come un segnale indipendente.
Immagini raccolte





























Nota sulla qualità dei dati
La fase X ha raccolto post da argomenti di tendenza generici anziché da ricerche relative all'IA e non ha contribuito con alcun dato; YouTube e Pinterest non hanno potuto confermare metriche di engagement, rispettivamente visualizzazioni/iscritti e salvataggi/Mi piace, a causa del rendering JavaScript e dei limiti di campionamento, mentre Reddit e Bluesky si basano su dati reali raccolti o ottenuti via API e sono le fonti più affidabili in questo insieme.