Ho creato da zero un LLM per RAG in croato da 300 milioni di parametri. Funziona su CPU
Dopo il precedente GPT-2, stavolta ho creato da zero un LLM in croato usando una sola RTX 4090. L’obiettivo era il RAG: un modello che trova la risposta nei testi forniti e risponde citando una frase che ne costituisce la prova. Inoltre, doveva poter funzionare in produzione su CPU.
Prima, le conclusioni.
- Circa 68 ore di GPU dall’inizio al completamento (tentativi inclusi). Di queste, 51 ore per il preaddestramento
- 320 milioni di parametri. 71% di risposte corrette sulle domande relative a un paragrafo e 44% sui testi lunghi da circa 3.000 token
- Risponde a una domanda in 3–16 secondi usando solo la CPU. I caratteri compaiono a una velocità che si riesce a seguire con gli occhi
Tempo necessario per l’addestramento
| Fase | Tempo | Contenuto |
|---|---|---|
| Generazione dei dati di addestramento | Circa 4,5 ore | 45.000 QA da Wikipedia e 50.000 traduzioni di conversazioni con EuroLLM-9B (vLLM) |
| Tokenizer e tokenizzazione | Circa 2,5 ore (CPU) | Vocabolario croato da 32.000 token creato internamente |
| Preaddestramento | 50 ore e 46 minuti | 7 miliardi di token. Nell’ultimo 10% il contesto viene esteso a 4.096 |
| SFT | Circa 35 minuti | Insegna a rispondere con citazioni e a rifiutare quando la risposta non c’è |
| Apprendimento per rinforzo (GRPO) | Circa 11 ore | 400 step, poi 300 step dopo le regolazioni |
Il tokenizer creato internamente riesce a rappresentare il croato con circa la metà dei token del tokenizer GPT-2. Con 4.096 token può leggere circa 17.000 caratteri.
Il modello ottenuto
| Voce | Contenuto |
|---|---|
| Parametri | 320 milioni (24 livelli, 1024 dimensioni) |
| Architettura | Famiglia Llama / Qwen3 (GQA, SwiGLU, RoPE, RMSNorm + QK-Norm) |
| Lunghezza del contesto | 4.096 token |
| Formato dell’output | Risposta + Izvor: „una frase estratta direttamente dal contesto“. Se non c’è risposta: “U tekstu nema odgovora na ovo pitanje.(Nel testo non c’è risposta a questa domanda)” |
| Esecuzione | Pensato per la CPU (circa 1,3 GB in fp32) |
Inoltre, all’esterno del modello ho aggiunto un meccanismo che verifica via programma se la citazione generata esiste davvero nel contesto e, in caso contrario, la sostituisce con «nessuna risposta». Il punto è non fidarsi ciecamente del modello, ma rendere verificabili le prove.
Problemi emersi durante lo sviluppo
1. Inventa una risposta ogni volta, anche quando non c’è. All’inizio gli ho insegnato semplicemente a rispondere alle domande. L’accuratezza è salita, ma quando riceveva un testo che non conteneva la risposta, inventava una risposta plausibile nel 100% dei casi. La cosa peggiore possibile per il RAG. Insegnandogli invece a citare e a «rifiutare», le invenzioni sono scese a pochi punti percentuali.
2. Rifiuta troppo spesso. Ho impostato la valutazione dell’apprendimento per rinforzo così: «−0,5 se sbaglia, 0 se rifiuta». Sui testi lunghi e difficili ha quindi imparato che conviene cavarsela rifiutando, arrivando a rifiutare il 70% delle volte. Individua perfettamente le falle nelle regole di valutazione. Portando la penalità per il rifiuto a −0,3, si è spostato all’estremo opposto: non rifiutava quasi mai e inventava risposte nel 40% dei casi. Un continuo effetto altalena.
3. Errori nella copia delle citazioni. Nei testi lunghi la risposta può essere corretta, ma il modello inverte l’ordine delle parole nella citazione o cita la prima frase dell’articolo. Nei contesti lunghi, citazione e risposta erano entrambe corrette solo circa la metà delle volte.
4. Errori che aggirano la verifica. Ha citato correttamente una frase «nato a XX» tratta da un altro articolo inserito nel contesto e ha dato il luogo di nascita della persona sbagliata. La citazione era autentica, quindi la verifica non poteva bloccarla.
5. Lacune nei dati di valutazione. In alcuni casi, un contesto che avrebbe dovuto essere «senza risposta» conteneva ancora una parte della risposta; il modello aveva ragione, ma veniva classificato come se avesse inventato tutto.
Prestazioni finali
300 domande per ciascuna valutazione. Ho usato il modello al 100º step dell’apprendimento per rinforzo regolato, quello con il miglior equilibrio tra rifiutare e rispondere.
| Contesto | Corrette | Errate | Rifiutate |
|---|---|---|---|
| Paragrafo (circa 100–400 token) | 71,3% | 16,7% | 12,0% |
| Contesto lungo (1.500–3.500 token) | 44,0% | 20,3% | 35,7% |
| Contesto senza risposta | Rifiuto corretto | Risposta inventata |
|---|---|---|
| Paragrafo | 97,7% | 2,3% |
| Contesto lungo | 92,3% | 7,7% |
Dopo il passaggio attraverso la verifica, la «percentuale corretta tra le risposte fornite» è 73,8%. È ancora lontana dall’obiettivo del 90%.
Tra l’altro, facendo risolvere ogni domanda 8 volte e considerando sufficiente almeno una risposta corretta, si arrivava al 91% per i paragrafi e al 74% per i testi lunghi (misurazione sull’ultimo checkpoint). Questo valore cambiava appena prima e dopo l’apprendimento per rinforzo: ciò che cambiava era la capacità di risolvere il problema ogni volta. I numeri hanno mostrato chiaramente che l’apprendimento per rinforzo, più che aggiungere nuove capacità, serve a rendere risolvibili ogni volta problemi che il modello sa risolvere solo occasionalmente.
Prova su CPU
Ho creato una Web UI di test e l’ho eseguita usando solo la CPU (i7-13700K). La velocità con cui appaiono i caratteri corrisponde direttamente alla velocità di generazione.
Paragrafo (263 token): 0,3 secondi fino al primo carattere, circa 11 token/s, 7 secondi complessivi
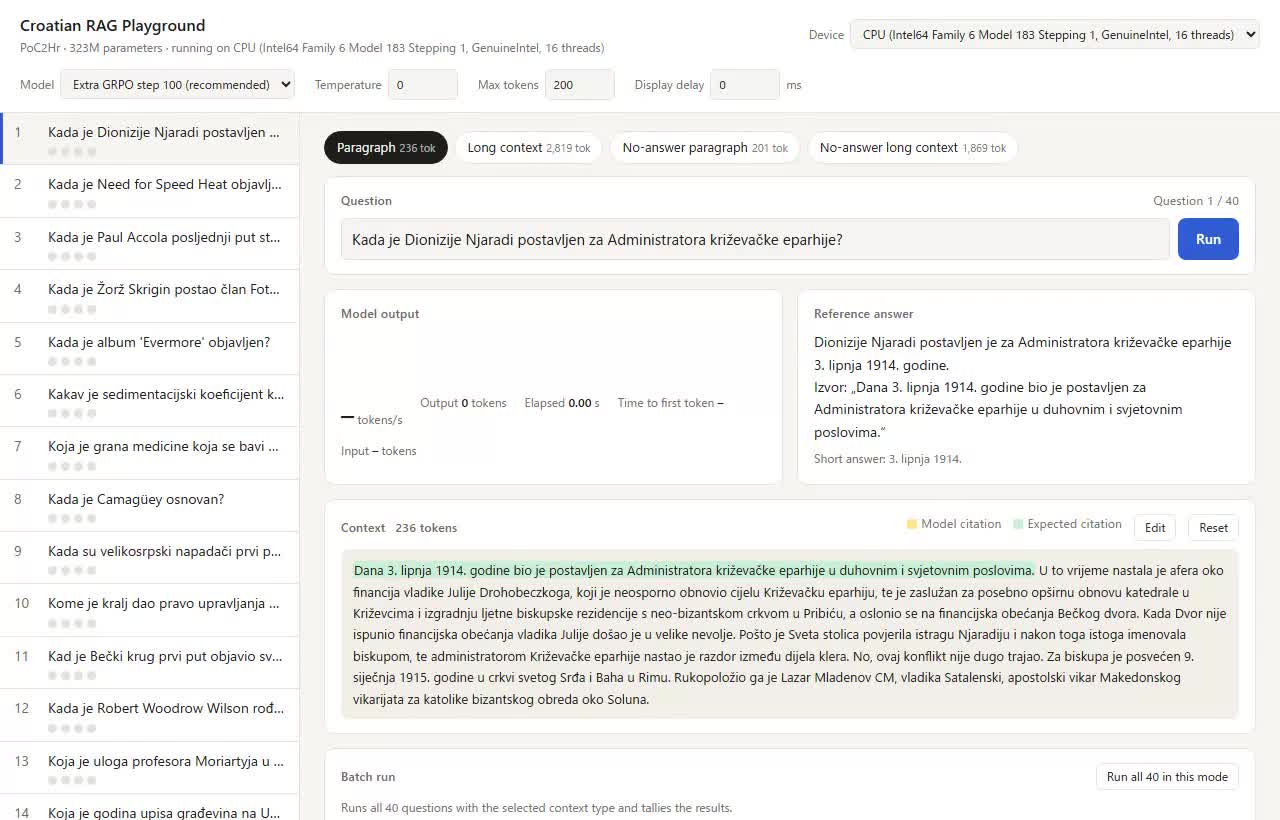
Contesto lungo (3.215 token): circa 5 secondi per leggere il testo, circa 5 token/s, 19 secondi complessivi. In giallo è evidenziata la frase citata: il modello trova correttamente una frase giusta tra 3.000 token
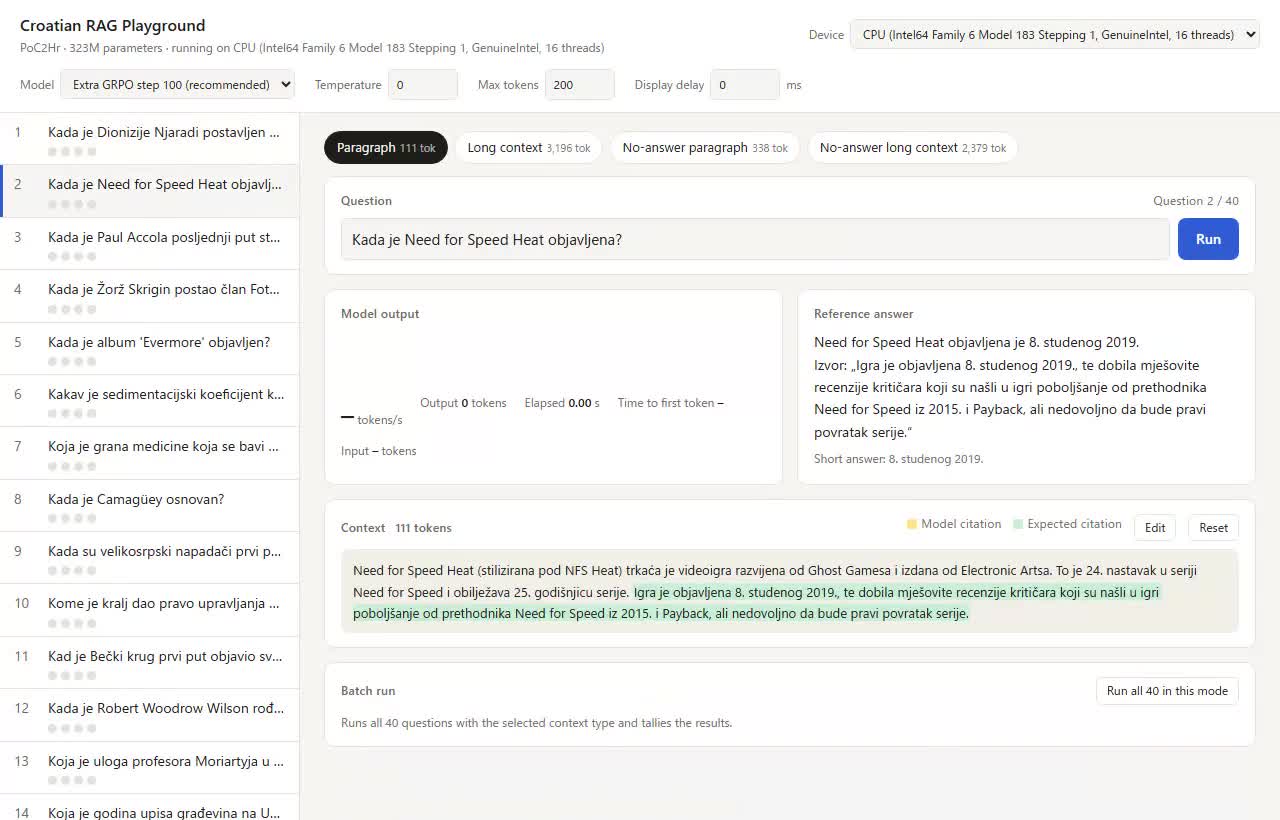
Il video è leggermente più lento perché veniva registrato. Misurando 20 domande alla volta senza registrazione, si ottenevano 15 token/s e 3,4 secondi per domanda sui paragrafi, e 7 token/s e 16 secondi per domanda sui contesti lunghi. Le risposte sono brevi, intorno ai 50 token, quindi anche su CPU la velocità sembra pratica.
Considerazioni
- Con i modelli piccoli, la cosa più importante è insegnare loro a dire «non so ciò che non so». Nel RAG, ridurre le invenzioni conta più dell’accuratezza. La combinazione di citazioni, rifiuto e verifica esterna si è rivelata molto efficace
- 300 milioni sono il limite per i testi lunghi. Anche con 8 tentativi, i testi lunghi arrivano solo al 74%. Per puntare al 90% sui testi lunghi, servirebbe probabilmente un modello da circa 1 miliardo di parametri
- Non basta verificare soltanto che la citazione esista davvero. Bisogna anche controllare che contenga il numero o il nome che risponde alla domanda e che il soggetto sia la stessa persona menzionata nella domanda
- Un modello da 300 milioni di parametri che funziona su CPU è ideale per domande e risposte su documenti che non possono essere messi online. Può rispondere basandosi solo sui documenti locali, su un portatile o un server senza GPU. La velocità è di alcuni secondi fino a una decina di secondi per domanda e, con la quantizzazione, dovrebbe poter migliorare ulteriormente (non ancora verificato)
Il prossimo passo sarà provare una versione da 1 miliardo di parametri, puntando al 90% sui contesti lunghi.