Ho quantizzato il mio LLM da 300 milioni di parametri e ne ho confrontato velocità e accuratezza su CPU
Il modello da 320 milioni di parametri per RAG in croato creato nel precedente articolo. Dato che deve girare su CPU, questa volta l'ho quantizzato per vedere quanto potevo ridurne dimensioni e aumentare la velocità, e fino a che punto sarebbe calata l'accuratezza.
Prima la conclusione.
- Q6_K è il punto giusto. Occupa un quinto dello spazio (254 MB), genera circa 4 volte più velocemente e mantiene la stessa accuratezza del modello originale
- Q2_K si rompe. È veloce, ma inizia a rispondere «non ci sono risposte» anche a domande per cui una risposta esiste
- Sorprendentemente, Q3_K_M è stato più accurato di Q4_K_M
Cosa ho fatto
Ho convertito il modello creato in PyTorch in un formato eseguibile con llama.cpp (GGUF), molto usato per l'inferenza su CPU, e l'ho salvato in otto diversi livelli di precisione.
- Ho esportato il modello nello stesso formato di Qwen3 e l'ho convertito in GGUF
- Poiché il tokenizer è fatto da me, llama.cpp rifiutava la conversione perché lo considerava «sconosciuto». Confrontando le regole di segmentazione delle parole, erano identiche a Qwen2 carattere per carattere, quindi l'ho registrato come Qwen2 e ho completato la conversione
- Ho verificato che la conversione fosse corretta. La tokenizzazione di tutti i 160 testi corrispondeva alla versione PyTorch. Su 20 domande, generando ogni volta la parola con la probabilità più alta, anche l'output coincideva perfettamente in tutti e 20 i casi
- Ho creato versioni da F16 a Q2_K con
llama-quantize
Quindi l'F32 nella tabella contiene gli stessi dati della versione PyTorch. È il riferimento per il confronto.
Come ho misurato
- La CPU è un i7-13700K. Non ho usato la GPU
- Le impostazioni di llama.cpp erano 8 thread per la generazione e 16 thread per la lettura del testo (dopo le prove, questa era la combinazione più veloce)
- Ho fatto rispondere ogni modello 400 volte: 100 domande × 4 tipi di contesto
- Paragrafo: un paragrafo di circa 100 token che contiene la risposta
- Testo lungo: un testo di circa 3.000 token che contiene la risposta, con anche articoli irrilevanti mescolati dentro
- Nessuna risposta (paragrafo/testo lungo): testi che non contengono la risposta. Rifiutare la risposta conta come corretto
- L'articolo precedente misurava 300 domande, quindi i numeri differiscono leggermente
Risultati: accuratezza
| Formato | Dimensione | Paragrafo corretto | Testo lungo corretto | Testo lungo rifiutato | Allucinazioni (nessuna risposta, paragrafo/testo lungo) | Accuratezza dopo verifica |
|---|---|---|---|---|---|---|
| F32 (riferimento) | 1.233 MB | 77% | 53% | 30% | 1% / 9% | 80,9% |
| F16 | 617 MB | 77% | 53% | 30% | 1% / 9% | 80,9% |
| Q8_0 | 329 MB | 76% | 53% | 30% | 1% / 8% | 81,9% |
| Q6_K | 254 MB | 79% | 54% | 30% | 2% / 9% | 81,3% |
| Q5_K_M | 223 MB | 72% | 45% | 41% | 1% / 6% | 84,4% |
| Q4_K_M | 193 MB | 68% | 37% | 46% | 1% / 7% | 75,9% |
| Q3_K_M | 160 MB | 72% | 48% | 38% | 1% / 8% | 80,4% |
| Q2_K | 129 MB | 39% | 11% | 78% | 4% / 7% | 72,2% |
L'«accuratezza dopo verifica» è la percentuale di risposte corrette dopo aver controllato via programma che la citazione del modello fosse davvero presente nel testo e, in caso contrario, averla sostituita con «nessuna risposta».
- F16, Q8_0 e Q6_K sono quasi identici al riferimento. La differenza è di appena una o due domande
- Da Q5_K_M in giù, aumentano più i rifiuti che gli errori. Sembra emergere 그대로 il comportamento insegnato nell'articolo precedente: quando non è sicuro, rifiuta. Le allucinazioni non sono aumentate
- Q4_K_M va peggio di Q3_K_M. 37% contro 48% sui testi lunghi. Con 100 domande può esserci una certa variabilità, ma 11 punti sono tanti. Non ne ho ancora investigato il motivo
- Q2_K rifiuta il 78% dei testi lunghi. Ormai è un altro modello
Risultati: velocità
| Formato | Velocità di generazione | Tempo medio per esecuzione |
|---|---|---|
| PyTorch fp32 (riferimento) | Paragrafo 14,6 · testo lungo 6,7 tok/s | — |
| F32 | 18,7 tok/s | 2,76 secondi |
| F16 | 35,9 tok/s | 2,08 secondi |
| Q8_0 | 59,0 tok/s | 1,93 secondi |
| Q6_K | 73,1 tok/s | 1,33 secondi |
| Q5_K_M | 81,2 tok/s | 1,26 secondi |
| Q4_K_M | 89,1 tok/s | 1,10 secondi |
| Q3_K_M | 103,4 tok/s | 1,12 secondi |
| Q2_K | 119,9 tok/s | 1,07 secondi |
I numeri di llama.cpp sono la media di 400 esecuzioni, aggregando paragrafi, testi lunghi e casi senza risposta. I numeri di PyTorch sono quelli misurati nell'articolo precedente.
- La velocità di generazione è quasi inversamente proporzionale alle dimensioni. Su CPU dipende più dalla velocità di lettura dei pesi dalla memoria che dal calcolo, quindi più piccolo è il modello, più è veloce
- Anche a parità di F32, llama.cpp è più veloce di PyTorch
- Tuttavia, sotto Q6_K il tempo per esecuzione diminuisce poco. A questa lunghezza, diventa più rilevante il tempo iniziale per leggere il testo
Video: ho fatto risolvere la stessa domanda su un testo lungo usando la CPU
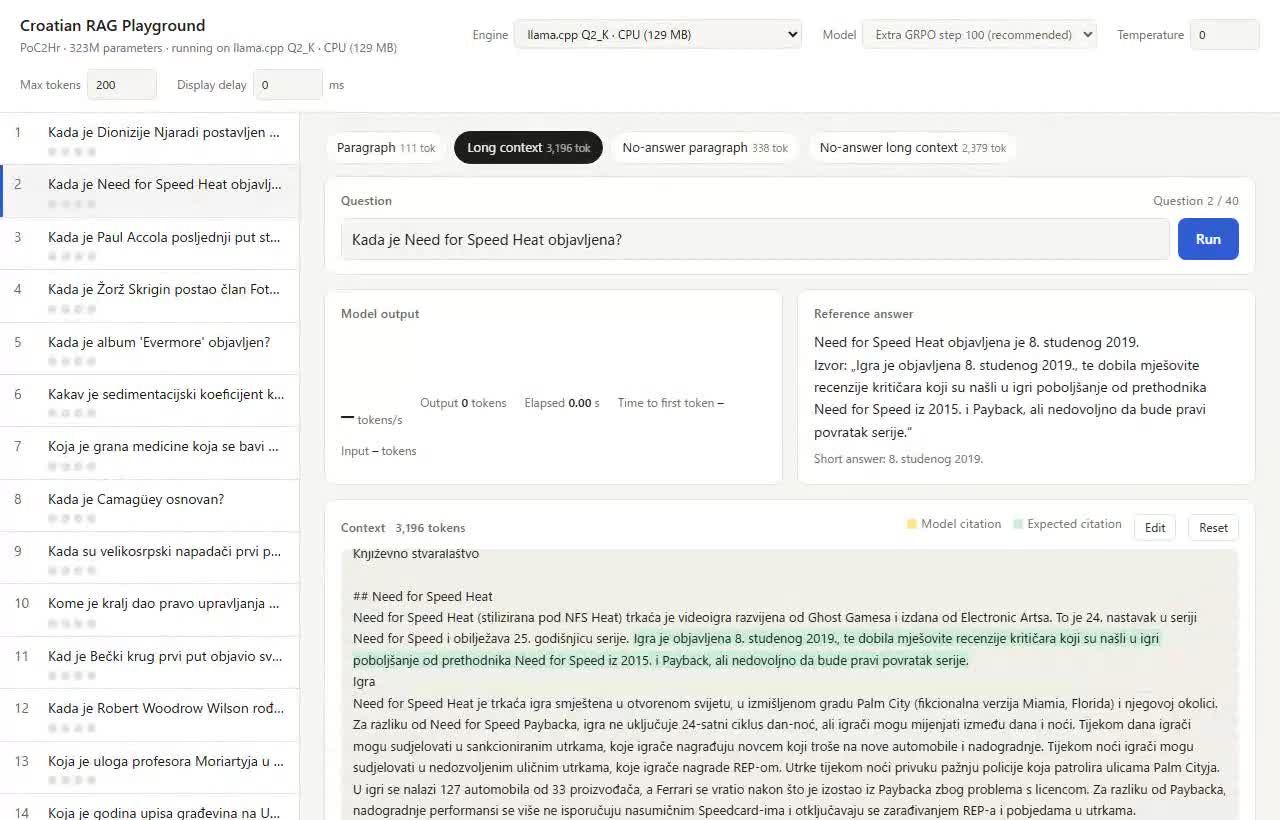
Ho fornito un testo di circa 3.200 token e chiesto: «Quando è stato pubblicato Need for Speed Heat?». La risposta corretta è l'8 novembre 2019.
Poiché stavo registrando e allo stesso tempo disegnando lo schermo nel browser, le velocità nel video sono inferiori a quelle della tabella sopra. Consideratelo un confronto affiancato.
| Formato | Velocità di generazione nel video | Tempo fino al primo carattere | Totale | Risultato |
|---|---|---|---|---|
| PyTorch fp32 | 5,5 tok/s | 4,8 secondi | 18,5 secondi | Corretto |
| F32 | 14,2 tok/s | 2,8 secondi | 8,1 secondi | Corretto |
| F16 | 25,9 tok/s | 3,5 secondi | 6,4 secondi | Corretto |
| Q8_0 | 38,2 tok/s | 4,0 secondi | 5,9 secondi | Corretto |
| Q6_K | 41,6 tok/s | 2,6 secondi | 4,4 secondi | Corretto |
| Q5_K_M | 46,3 tok/s | 2,6 secondi | 4,3 secondi | Corretto |
| Q4_K_M | 47,2 tok/s | 2,3 secondi | 4,7 secondi | Corretto (risposta più lunga) |
| Q3_K_M | 56,7 tok/s | 2,5 secondi | 4,5 secondi | Corretto (risposta più lunga) |
| Q2_K | 61,3 tok/s | 2,7 secondi | 2,8 secondi | Ha rifiutato |
Da F32 a Q5_K_M, sia la risposta sia la citazione sono identiche alla versione PyTorch carattere per carattere. Con Q4_K_M e Q3_K_M la risposta è diventata più lunga, ma la citazione era corretta. Q2_K ha risposto «nel testo non c'è la risposta» anche se una risposta era presente.
PyTorch fp32 (il modello originale)
llama.cpp F32 (1.233 MB)
llama.cpp F16 (617 MB)
llama.cpp Q8_0 (329 MB)
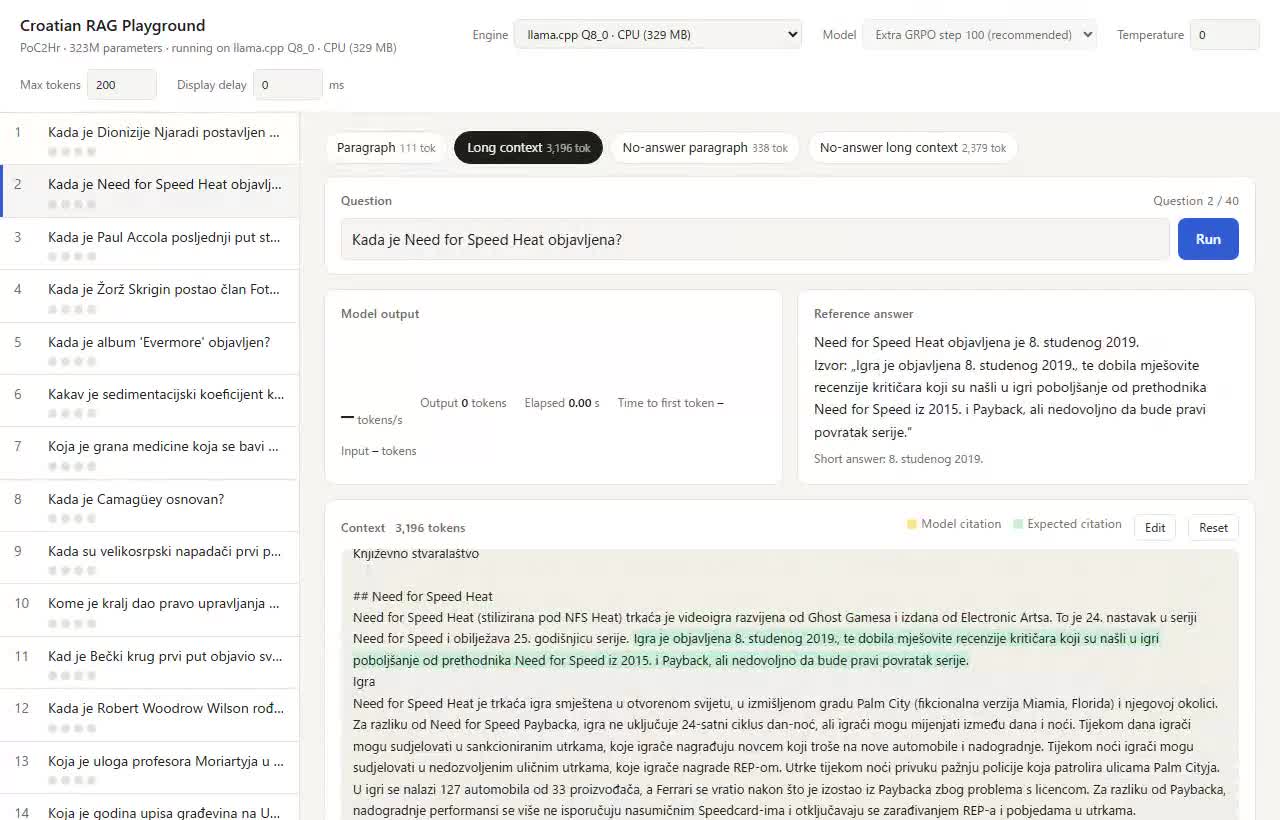
llama.cpp Q6_K (254 MB)
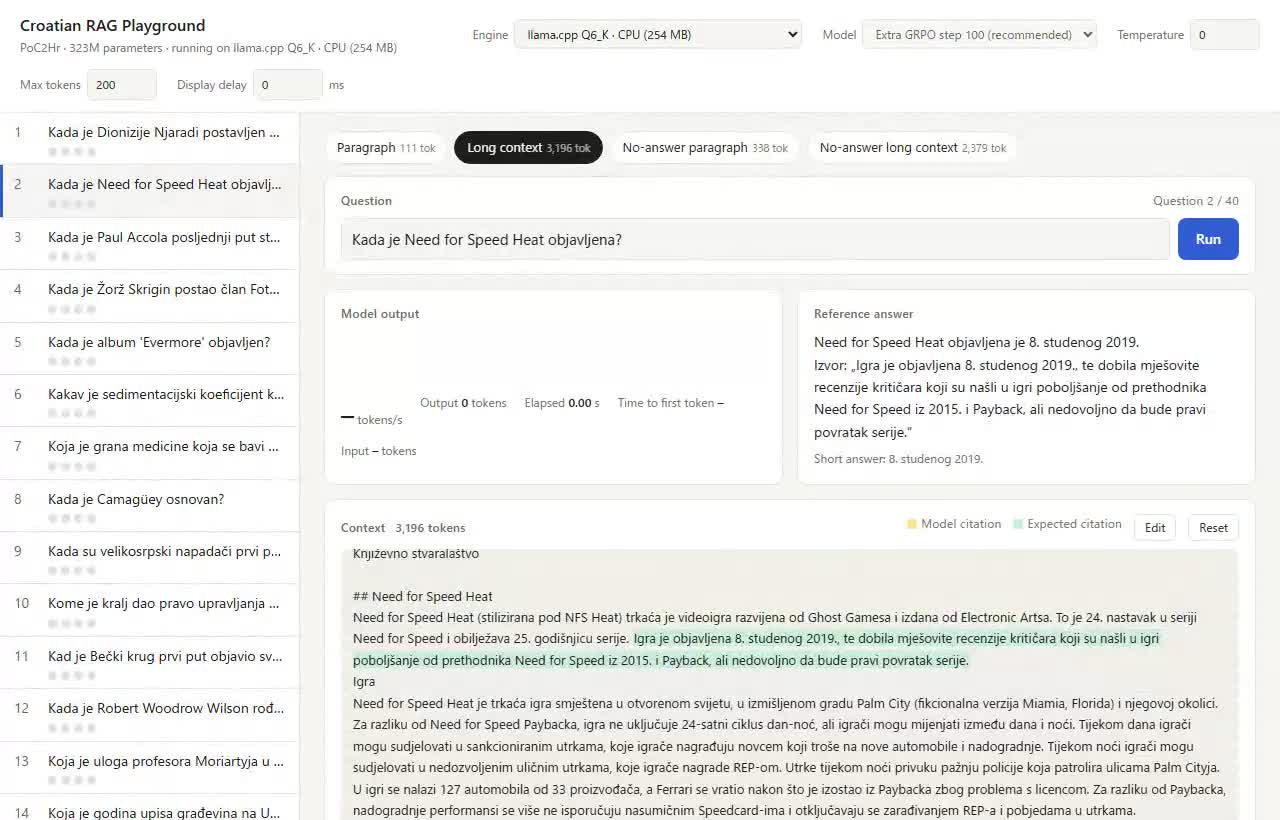
llama.cpp Q5_K_M (223 MB)
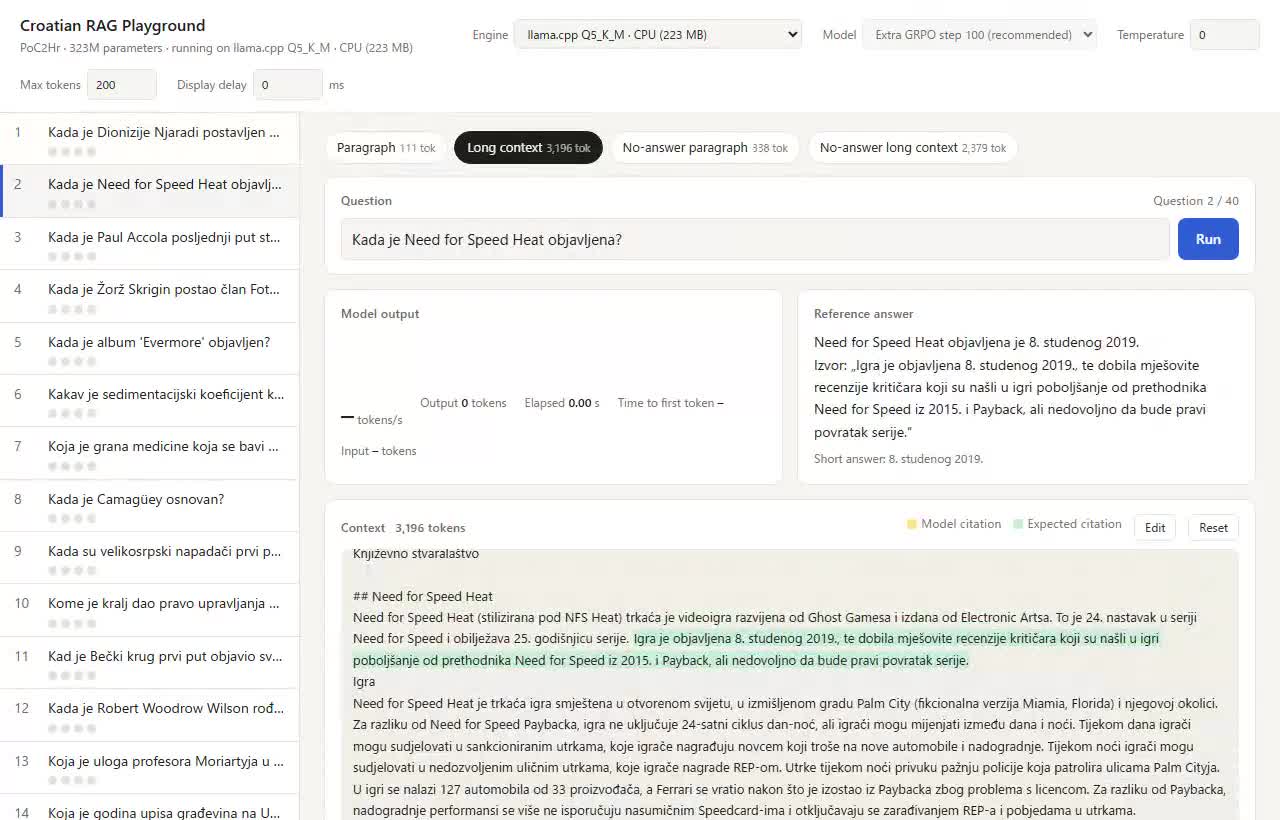
llama.cpp Q4_K_M (193 MB)
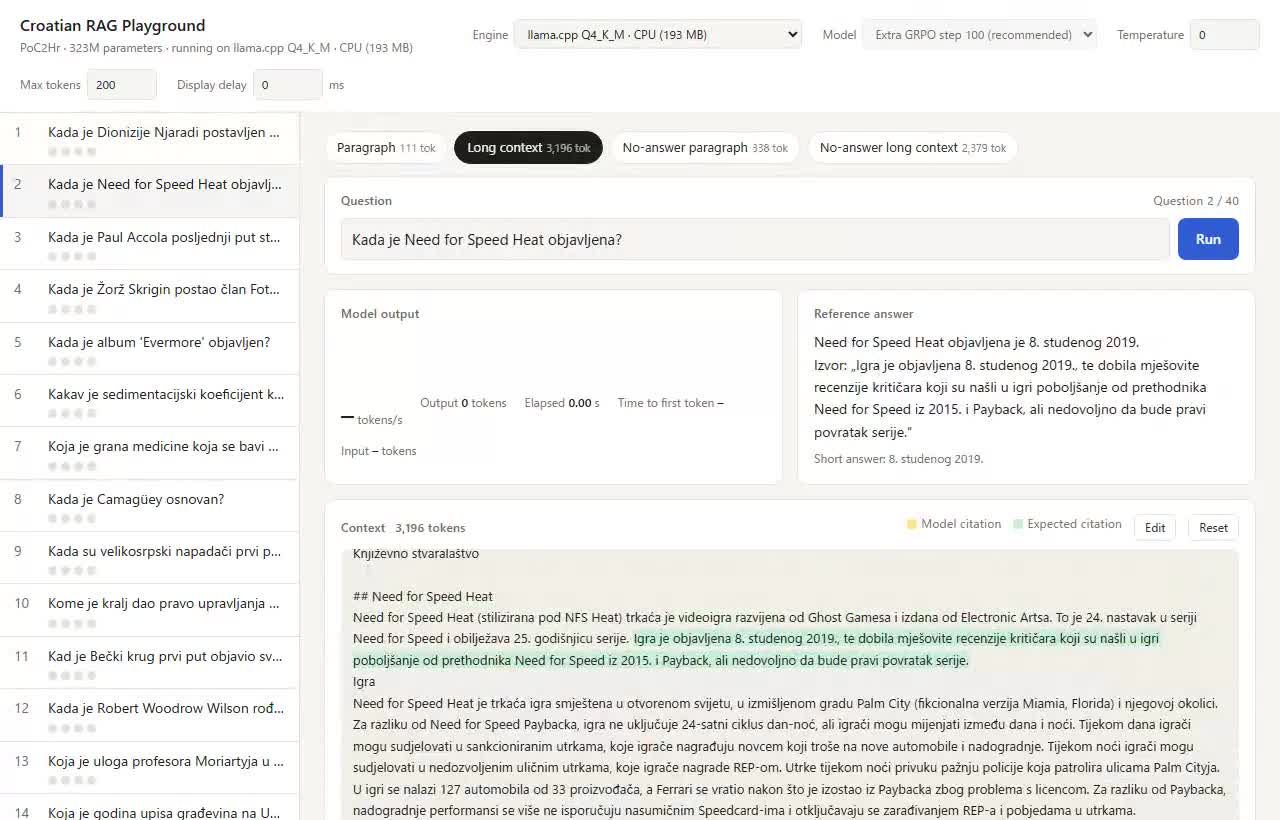
llama.cpp Q3_K_M (160 MB)
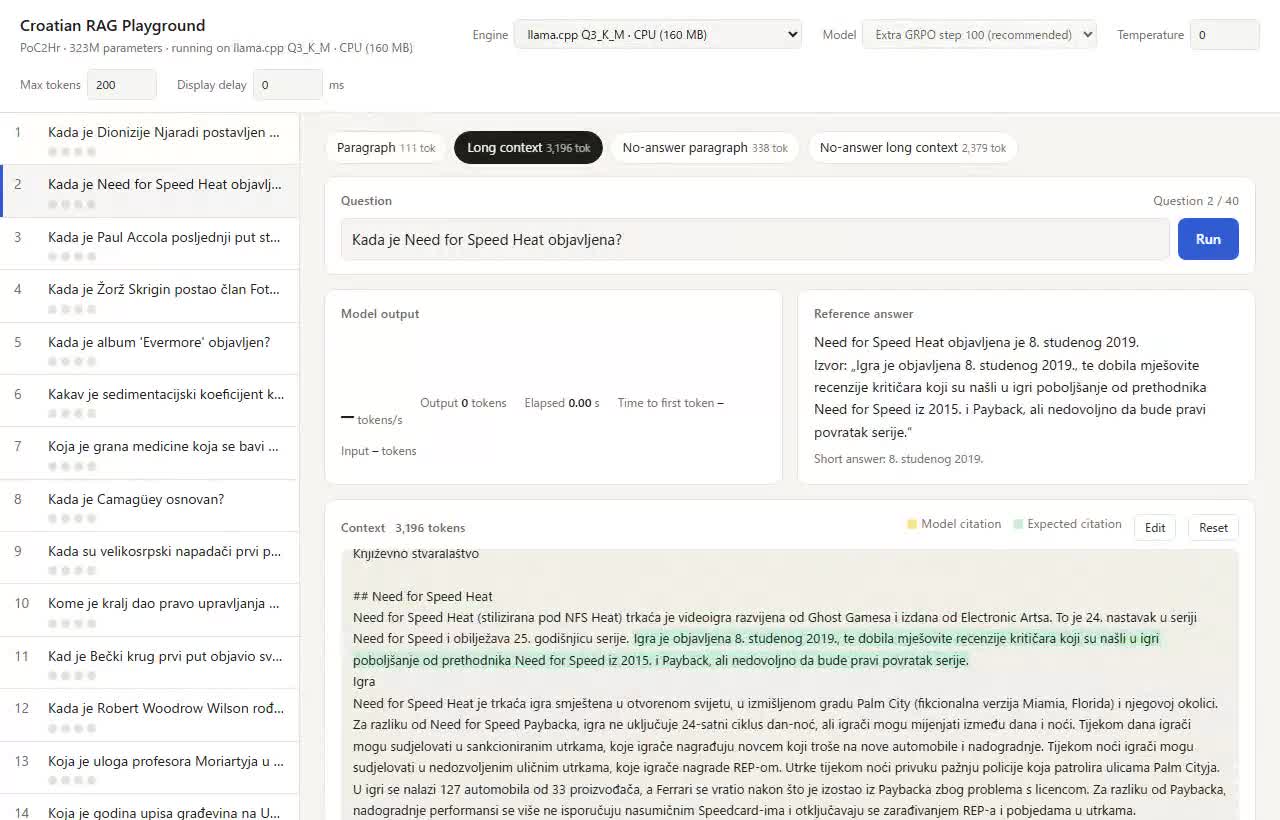
llama.cpp Q2_K (129 MB)
Considerazioni
- Se volete eseguire questo modello su CPU, scegliete Q6_K. Mantiene l'accuratezza dell'originale, occupa un quinto dello spazio e genera circa 5 volte più velocemente di PyTorch. Non c'è motivo di esitare
- Per maggiore sicurezza, Q8_0. È quasi identico all'originale e pesa 329 MB. Rimane comunque molto piccolo
- I modelli piccoli da 300 milioni di parametri sono vulnerabili alla quantizzazione. Si dice che anche Q4 degradi appena i modelli grandi, ma qui il calo è diventato visibile a partire da Q5. Il modello aveva già poco margine, quindi ogni riduzione pesa
- È positivo che il guasto si manifesti come rifiuto. Per il RAG, rifiutare è più sicuro che aumentare le allucinazioni. L'effetto dell'addestramento con rinforzo usato nell'articolo precedente per insegnargli a rifiutare emerge anche qui
- Nei modelli piccoli, le differenze di velocità si riducono. Sotto Q6_K, anche se la generazione accelera, resta il tempo di lettura del testo, quindi la differenza percepita è minima. Anche nel video Q6_K–Q3_K_M sono tutti attorno ai 4 secondi
- Il motivo per cui Q4_K_M perde contro Q3_K_M resta sconosciuto. Vorrei indagare aumentando il numero di domande e osservando quali livelli vengono quantizzati e in che modo