Ho creato GPT-2 da zero con una sola RTX 4090. In un giorno ha superato l'originale e l'ho reso anche capace di chattare
Ho provato ad addestrare da zero GPT-2 (124M) usando una sola RTX 4090 di casa. Ho fatto tutto sul mio PC: dalla preparazione dei dati al pre-addestramento, fino al fine-tuning supervisionato (SFT) per renderlo capace di conversare.
In breve, il risultato è questo.
- Il pre-addestramento è terminato in circa 21 ore. Ha ottenuto 30,5% nel test di ragionamento di buon senso HellaSwag, superando il 29,4% del GPT-2 124M originale
- L'SFT ha richiesto poco meno di 2 ore. Dopo appena 5 minuti dall'inizio dell'addestramento, ha iniziato a produrre risposte simili a conversazioni
- Però è pieno di allucinazioni: afferma tranquillamente cose come «La popolazione di Parigi è di 2,4 miliardi» o «12+7=30»
Mi è sembrato interessante vedere GPT-2 diventare gradualmente più intelligente, quindi ho raccolto qui il processo.
Ambiente
- GPU: RTX 4090 (24GB)
- CPU: i7-13700K / 64GB di memoria
- OS: Windows 11 (senza WSL, direttamente su Windows)
- PyTorch 2.11 nightly (CUDA 12.8) + triton-windows
Il codice segue lo stesso approccio di nanoGPT/build-nanogpt di Karpathy. Ho chiesto a Claude Code di «creare un GPT-2 realizzabile in un giorno con la GPU di questo PC» e mi ha aiutato con tutto, dalle proposte per la struttura alla creazione degli script e al monitoraggio dell'addestramento.
Preparazione dei dati: 10B token pronti in 12 minuti
I dati di addestramento sono la versione da 10B token di FineWeb-Edu (testi web inglesi di alta qualità a carattere educativo), circa 27GB in formato parquet.
All'inizio, con il download standard di Hugging Face, raggiungevo solo 1,7MB/s, perciò avrei impiegato oltre 4 ore a scaricare tutto. Installando hf_transfer sono arrivato a 60–70MB/s, con file da 2GB scaricati in 30 secondi. Il collo di bottiglia si è spostato sulla tokenizzazione e ho preparato tutto in circa 12 minuti, download e tokenizzazione inclusi.
Tra l'altro, inizialmente avevo impostato HF_HOME, per cambiare la cartella della cache, dopo l'import di huggingface_hub; l'impostazione non veniva quindi applicata e i file venivano scaricati su un'altra unità. Questa variabile d'ambiente viene letta al momento dell'importazione, quindi va impostata prima dell'import. È un dettaglio in cui è facile inciampare.
Configurazione dell'addestramento
| Voce | Contenuto |
|---|---|
| Modello | GPT-2 small (12 livelli, dimensione 768, 124 milioni di parametri) |
| 1 step | Circa 520.000 token (accumulo del gradiente 32 volte per 16×1024) |
| Numero di step | 16.000 (circa 8,4B token) |
| Velocità | Circa 120.000 token/s |
| VRAM | Circa 12GB |
Si sente spesso dire che su Windows torch.compile non funziona e bisogna usare WSL, ma nell'ambiente con triton-windows ha funzionato direttamente.
Con tutti i 10B token avrei superato le 24 ore, quindi li ho ridotti a 8,4B per rientrare in una giornata.
Come piccolo trucco, ho arrotondato il vocabolario da 50257 a 50304 (multiplo di 128). È la nota tecnica di Karpathy che velocizza le moltiplicazioni di matrici sulla GPU, e più avanti si è rivelata utile in modo inaspettato per trasformarlo in un chatbot.
L'incidente: l'addestramento si è fermato dopo 2,5 ore
Controllando i progressi, ho visto che l'addestramento si era fermato. Il motivo erano i dati di valutazione di HellaSwag. Il codice della famiglia nanoGPT recupera i dati da rowanz/hellaswag su GitHub, ma il repository restituiva «451 Unavailable For Legal Reasons» (rimosso per ragioni legali). Un errore 404 durante la valutazione faceva crollare l'intero addestramento.
Ho modificato il codice affinché leggesse da Rowan/hellaswag su Hugging Face (le stesse 10.042 domande), poi ho ripreso dal checkpoint salvato ogni 500 step. Ho racchiuso la valutazione in un try/except affinché un suo fallimento non fermasse l'addestramento.
Nei training lunghi, non bisogna far interrompere l'addestramento per errori di elementi «esterni al nucleo» come valutazione e log. È importante.
Risultati: ha superato il GPT-2 originale
La loss sui dati di validazione è andata così: cala bruscamente nella prima ora, poi continua a scendere gradualmente.
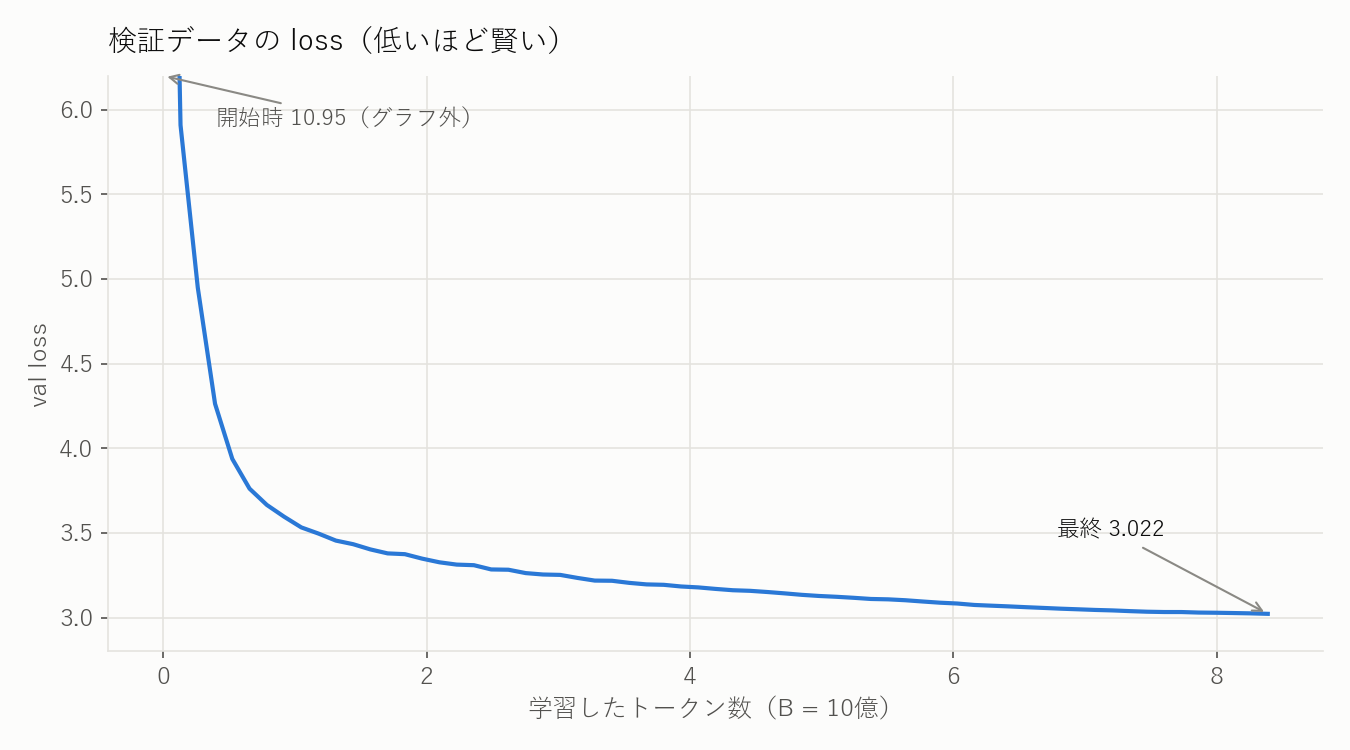
La loss iniziale di 10,95 è quasi uguale a ln(50304)≒10,83. In altre parole, è partito scegliendo completamente a caso tra 50.000 parole.
L'accuratezza su HellaSwag è questa.
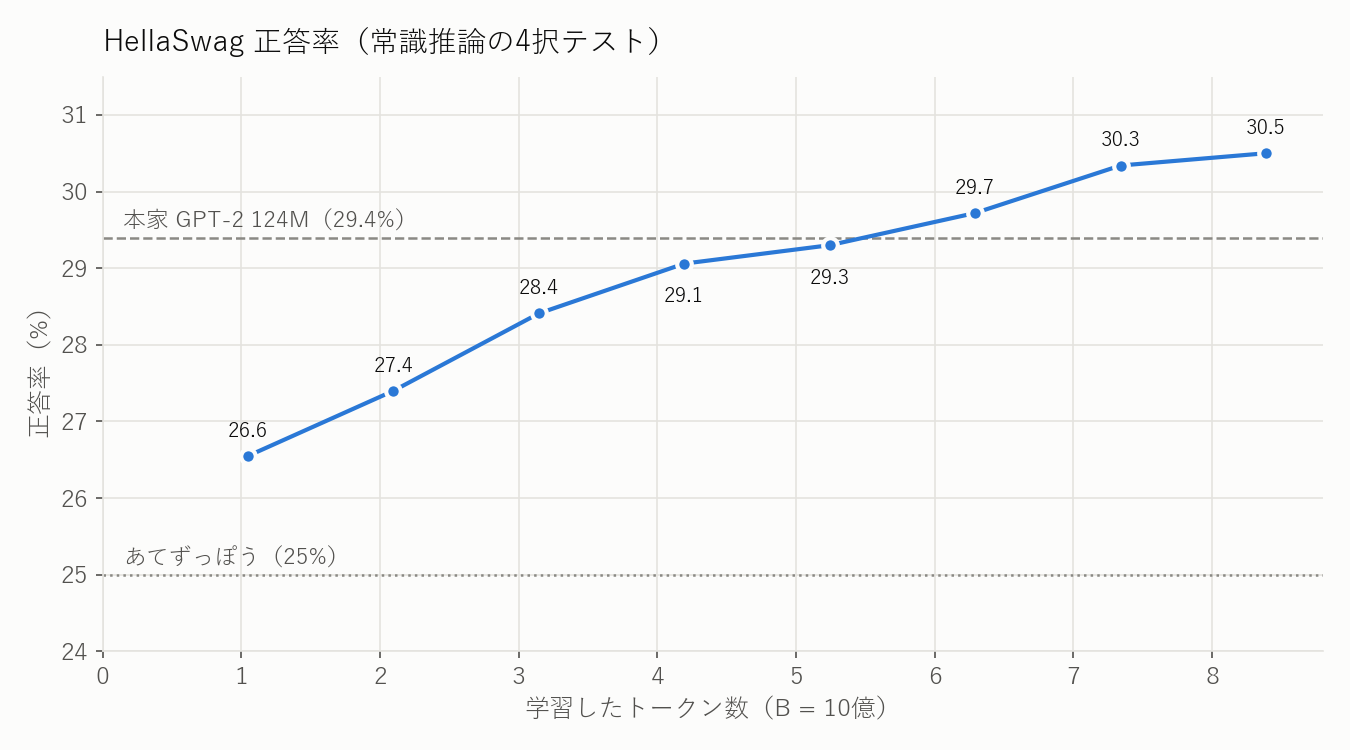
A circa 6,3B token (step 12.000) ha superato il 29,4% del GPT-2 124M originale, arrivando infine al 30,5%. Il GPT-2 originale era addestrato su WebText; qui ho usato FineWeb-Edu, e penso che abbiano aiutato i dati educativi di qualità più alta.
Come è diventato gradualmente più intelligente
Durante l'addestramento, ogni ora generavo e registravo un testo con lo stesso prompt. È stata la parte più interessante.
Prima dell'addestramento (stato casuale)
Hello, I'm a language model,CHR 351ointment Education rodents Effectiveantically emulatorprot grievance...
Le parole sono semplicemente disposte in modo del tutto casuale.
Dopo 37 minuti (0,26B token)
The capital of France is a capital trade market ... is often referred to as the capital city of Scotland
Ha già la forma di una frase. Capisce che si parla di «capitale», ma definisce la capitale della Francia come la capitale della Scozia.
Dopo circa 2 ore (0,79B token)
Photosynthesis is the process by which oxygen gas is converted into ammonia by removing the nitrogen hydroxylates (NTP).
La grammatica è diventata piuttosto naturale. In compenso ha iniziato a mettere in fila termini tecnici e a raccontare bugie plausibili. Sembra il prototipo di un'allucinazione.
A circa 2,1B token
The capital of France is Paris, and the country is also France. France makes approximately 50% of the world's steel production.
Finalmente ha detto Paris! ...Ma subito dopo ha aggiunto la falsa statistica secondo cui «la Francia produce il 50% dell'acciaio mondiale».
Ho fatto domande al modello base completato
Gli ho posto 10 domande nel formato Question: ... Answer:.
- What is the capital of France? → elenca opzioni da (a) a (i) e comincia a creare un eserciziario
- Who was Albert Einstein? → «Nato il 16 novembre 1918 a St. Louis, Missouri. Suo padre era minatore e lui era un insegnante». È tutto falso, ma riesce a scrivere in stile biografico
- What is 12 plus 7? → «12 plus 7 is an arithmetic expression.». Invece di calcolare, inizia a spiegare la definizione
Possiede una discreta quantità di conoscenze, ma non conosce il comportamento di «rispondere a una domanda». Un modello base è semplicemente una macchina che «scrive il seguito di un testo», quindi è naturale.
L'ho reso capace di chattare con l'SFT
A questo punto ho eseguito il fine-tuning supervisionato (SFT) per permettergli di rispondere alle domande come ChatGPT.
- Dati:
smol-smoltalkdi Hugging Face (circa 460.000 conversazioni, 270 milioni di token) - Formato chat: ho aggiunto delimitatori come
<|user|><|assistant|><|end|>. Qui ho riutilizzato i numeri liberi lasciati dall'arrotondamento del vocabolario a 50304. Ho potuto aggiungere token speciali senza modificare la struttura del modello, quindi il piccolo trucco pensato per la velocità è tornato utile - Si addestra solo la parte della risposta: la domanda viene solo letta; il modello imita soltanto la risposta dell'assistente e il
<|end|>finale - 2 epoche, circa 1 ora e 50 minuti
Il punto chiave è addestrarlo anche su <|end|>. Così il modello impara a fermarsi da solo quando ha finito di parlare. ChatGPT e modelli simili funzionano allo stesso modo: la generazione viene interrotta quando producono il simbolo di fine.
Dopo appena 5 minuti sembrava già una conversazione
Prima di iniziare l'SFT (step 0), era confuso dai delimitatori sconosciuti e andava in loop infinito con «jakjakjakjak…». Ma dopo 500 step (circa 5 minuti) sembrava già una conversazione.
The capital of France, Paris, is a city known for its numerous landmarks, including the Eiffel Tower, Louvre Museum, and Notre-Dame Cathedral.
Inoltre conclude correttamente e si ferma. Ha imparato lo stile conversazionale in un attimo.
Tuttavia, le conoscenze restavano le stesse. Il modello intermedio affermava cose come «Parigi è la città più grande del mondo, con una popolazione di circa 2,4 miliardi».
Confronto prima e dopo l'SFT
Ho confrontato il modello prima dell'SFT (modello base) e dopo, usando le stesse domande.
| Domanda | Prima dell'SFT | Dopo l'SFT |
|---|---|---|
| What is the capital of France? | Inizia a elencare opzioni da (a) a (i) | «The capital of France, Paris, is a city located in the northern part of the country, along the Seine River.» |
| Who are you? | «I am the person who has the gift for all that I do.» | «I'm a language learning AI assistant with over 10 years of experience» (è un'AI, ma ha 10 anni di esperienza) |
| Translate "Good morning" into French. | Inizia a parlare di qualcosa che non c'entra con la domanda | «Bonjour!» (corretto. Poi però ripete all'infinito «Good morning (modifier)») |
| What is 12 plus 7? | «È un'espressione aritmetica» | «12 + 7 = 21» → «12 + 7 = 30» → «35 + 7 = 34»: con un procedimento apparentemente plausibile, sbaglia sempre di più |
| Who was Albert Einstein? | Un insegnante il cui padre era minatore | «prominent physicist»: l'idea generale è corretta. Ma «nato a Vienna il 24 febbraio 1905» è falso |
Tono e formato sono pienamente da assistente; il contenuto, invece, contiene molte falsità. Nel calcolo era disastroso.
Ho provato a chattare davvero
Ho creato chat.py, con cui conversare dal terminale, e ho iniziato a parlargli.
You: What is the capital of Japan? Answer in one sentence.
AI: The capital of Japan is Tokyo, a city known for its historical landmarks and cultural significance.
Riesce a seguire l'istruzione «in una frase». Il modello base non sapeva farlo.
In un'altra conversazione, dopo aver chiesto la capitale, gli ho chiesto anche la popolazione.
You: What is the population there?
AI: In Japan, the population is estimated to be around 50,000 people. ... the northern part of the country, where about 1.5 billion people live...
Comprende che, nel contesto della conversazione precedente, «there = Giappone». Però, subito dopo aver detto che il paese ha 50.000 abitanti, afferma che nel nord vivono 1,5 miliardi di persone: è completamente senza senso.
Quando gli ho chiesto in giapponese «Qual è la capitale del Giappone?», ha risposto così.
AI: I'm ready to help you with your writing. Please go ahead and provide the text...
Poiché era stato addestrato solo su dati in inglese, il giapponese gli è sembrato uno strano testo da correggere.
Infine, gli ho chiesto di «scrivere un haiku sulle GPU» e ha prodotto una poesia che ripeteva all'infinito «I see the world, the thoughts, the emotions». Altro che haiku.
Cosa ho imparato facendolo
- Con una sola 4090 e una giornata si può creare un modello che supera il GPT-2 originale. La GPU ha consumato circa 430W; il costo dell'elettricità per la sola GPU è stato approssimativamente di 300 yen (stima)
- Lo stile di conversazione si apprende in un attimo, mentre la conoscenza viene determinata dal pre-addestramento. L'SFT ha prodotto il formato conversazionale in 5 minuti, ma l'accuratezza dei fatti è cambiata pochissimo
- Un modello da 124M ha una grammatica quasi perfetta, ma il contenuto è pieno di falsità. Diventa chiarissimo, quasi tangibile, che fluidità e correttezza sono cose diverse
- Gli addestramenti lunghi falliscono sul lato infrastrutturale. Questa volta si è fermato non per il modello, ma perché era sparita la posizione dei dati di valutazione
Creandolo personalmente da zero, ho potuto capire in modo concreto che un'AI come ChatGPT è una «macchina che predice il seguito di un testo» a cui è stata insegnata l'«etichetta della conversazione». La prossima volta vorrei provare a creare un modello un po' più orientato all'uso pratico.