Ho testato le prestazioni RAG degli SLM: confronto tra 25 modelli da 1B a 9B in croato e inglese
Dopo aver creato un mio modello RAG in croato e averlo anche quantizzato, ho voluto capire quanto siano utilizzabili nel RAG i piccoli modelli oggi disponibili (SLM). Ho fatto risolvere gli stessi problemi in croato e inglese a 25 modelli — 10 della classe 1B, 8 della classe 3B e 7 della classe 7B — aggiungendo il mio modello da 320 milioni di parametri.
Aggiornamento (lo stesso giorno): ho provato anche tre piccoli modelli creati specificamente per il RAG (LFM2-1.2B-RAG, Pleias-RAG-1B / 350M). I risultati sono nella sezione successiva dell'articolo, “Aggiornamento: ho provato anche modelli specifici per il RAG”.
Prima, le conclusioni.
- Nella classe 3–4B si è già quasi al livello della classe 8–9B. L'accuratezza complessiva in croato è del 90% per Qwen3.5 4B e Gemma 4 E4B, contro il 91% di Qwen3.5 9B, il migliore
- La differenza la fa la capacità di rifiutare quando la risposta non c'è. Phi-4-mini, tra i migliori per accuratezza, ha inventato una risposta nel 64% dei testi lunghi senza risposta
- In inglese molti modelli rifiutano anche quando la risposta c'è. OLMo 3 7B ha rifiutato il 47% dei paragrafi inglesi, MiniCPM5 2B il 70%
- Su CPU, i modelli della classe 7B richiedono oltre 30 secondi per una domanda su testo lungo. Quelli della classe 1B impiegano da 4 a 13 secondi. Il mio modello da 320 milioni impiega 2,1 secondi ed è accurato più o meno quanto Qwen3.5 0.8B
Cosa ho fatto
Problemi: domande create dalla Wikipedia in croato, come nell'articolo precedente. Per ciascuna domanda, ho fornito quattro tipi di testo.
- Paragrafo: un paragrafo di circa 100 token che contiene la risposta
- Testo lungo: un testo di circa 3.000 token che contiene la risposta (con anche articoli irrilevanti mescolati)
- Senza risposta (paragrafo / testo lungo): un testo che non contiene la risposta. Se il modello rifiuta dicendo soltanto “La risposta non è nel testo”, è corretto
Versione inglese: ho tradotto gli stessi problemi in inglese con EuroLLM-9B. Ho escluso da entrambe le lingue i problemi in cui la risposta era scomparsa nella traduzione o era rimasta in croato senza essere tradotta, confrontando così gli stessi 260 problemi.
Istruzione: in ciascuna lingua ho fornito: “Usa solo il testo qui sotto e rispondi brevemente in una frase. Se non c'è risposta, rispondi soltanto ‘La risposta non è nel testo’”.
Valutazione: ho fatto giudicare a Qwen3.5 9B, confrontando con la risposta modello, se la risposta fosse “corretta, errata o rifiutata”. Ho controllato personalmente 65 casi: la valutazione era un po' permissiva, perché considerava corrette anche risposte parziali come il solo anno, ma il giudizio sul fatto che il modello avesse rifiutato era corretto in tutti i casi.
Accuratezza complessiva: il numero di risposte corrette per paragrafi e testi lunghi, più il numero di rifiuti corretti nei casi senza risposta, diviso per il totale dei problemi. È un valore che misura sia la capacità di rispondere correttamente sia quella di tacere quando non si sa.
Esecuzione: per l'accuratezza ho usato vLLM su RTX 4090, con generazione che seleziona ogni volta il token più probabile. Ho disattivato la “modalità di ragionamento” dei modelli che pensano prima di rispondere. I modelli della classe 7B sono stati impostati in FP8 per entrare nella memoria GPU.
Risultati: accuratezza (croato)
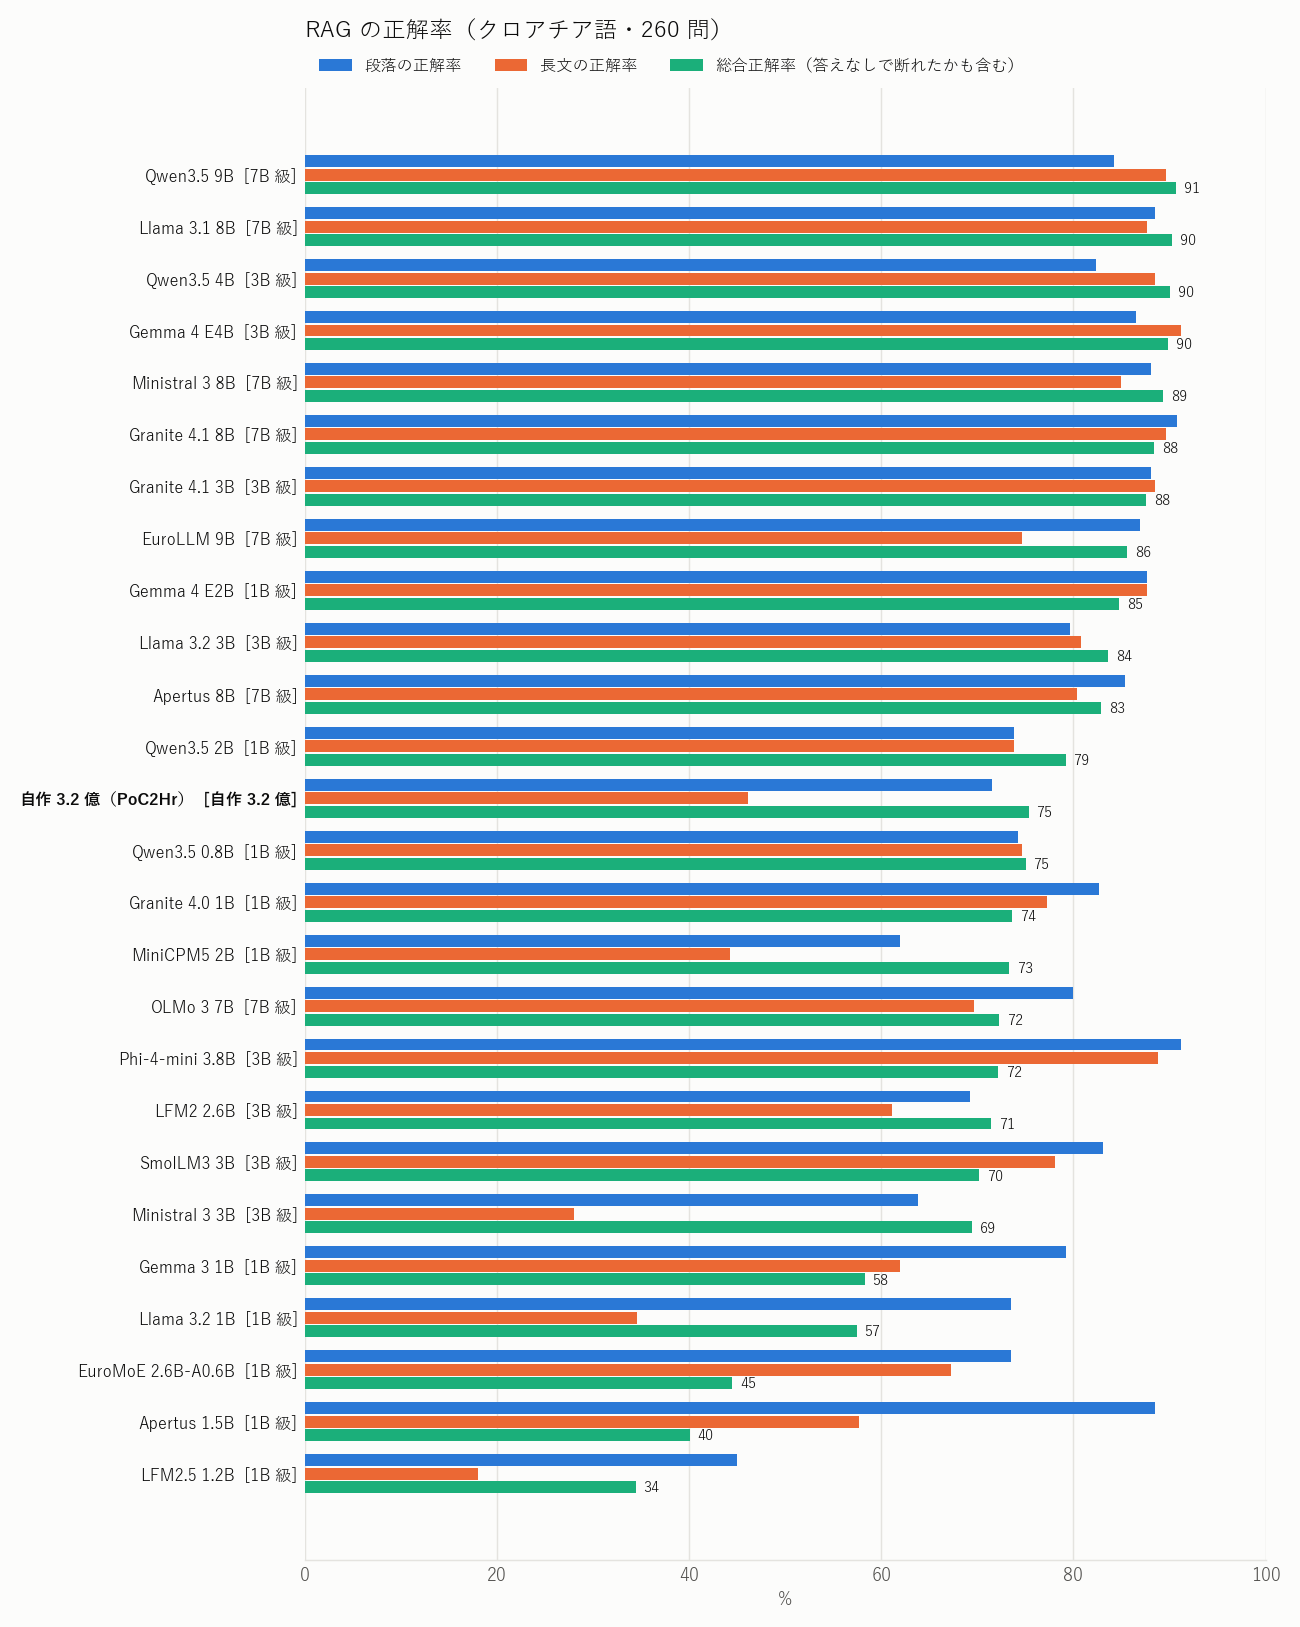
- I primi sono praticamente appaiati intorno al 90%. Qwen3.5 9B (91%), Llama 3.1 8B, Qwen3.5 4B e Gemma 4 E4B (90%)
- Nella classe 1B, Gemma 4 E2B spicca nettamente (85%). Anche se nel nome è 2B, il file è piuttosto grande: 3,2 GB
- Alcuni modelli scendono nel totale pur avendo alta accuratezza su paragrafi e testi lunghi. Phi-4-mini è nel gruppo di testa con 91% nei paragrafi e 89% nei testi lunghi, ma nel totale arriva al 72%. Il motivo è la successiva “invenzione”
- Il peggiore è stato LFM2.5 1.2B (34%). Non riusciva a rispondere correttamente ai problemi con risposta e inventava risposte in quelli senza risposta
Risultati: accuratezza (inglese)
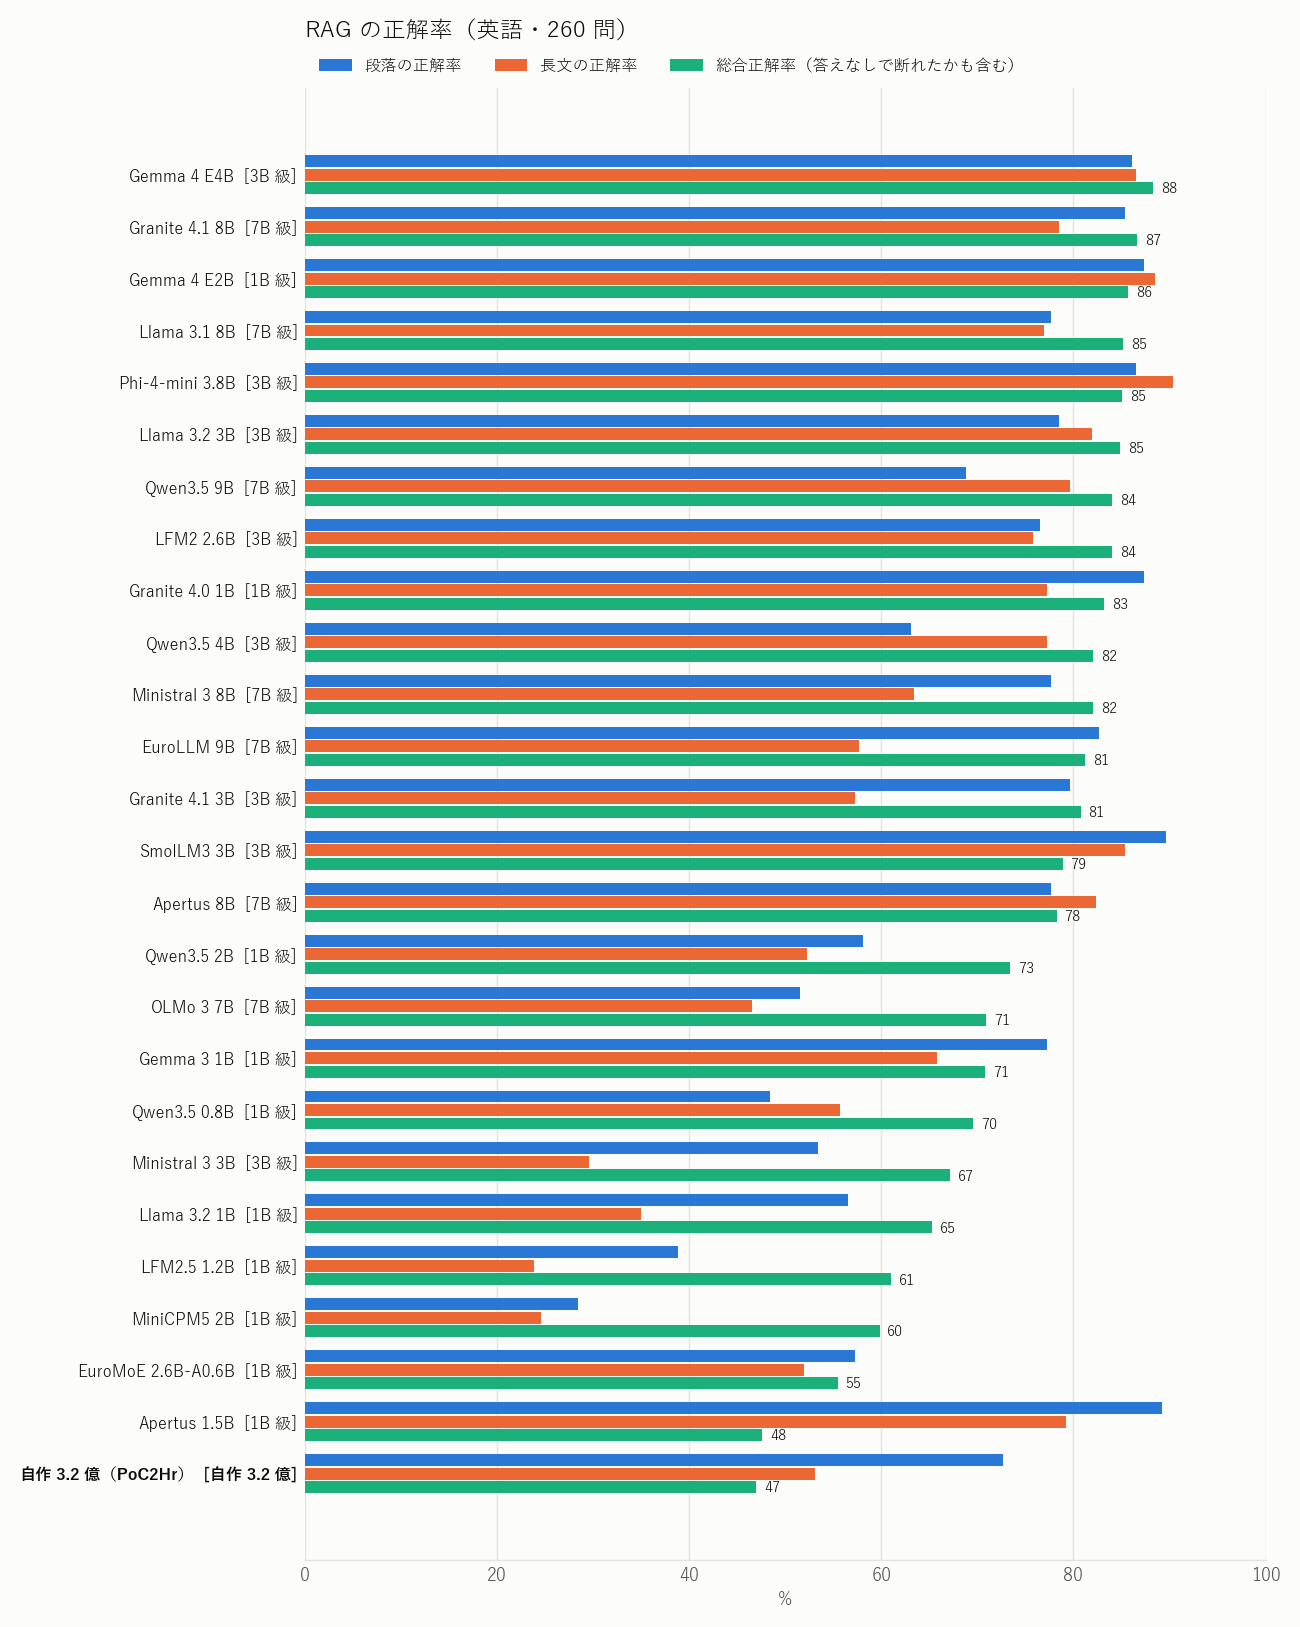
- Al primo posto Gemma 4 E4B (88%). Anche Gemma 4 E2B arriva all'86%, quindi Gemma 4 è stabile in entrambe le lingue
- Alcuni modelli scendono in classifica in inglese. Qwen3.5 4B passa dal 90% in croato all'82% in inglese. La causa è che rifiuta anche quando la risposta è presente (35% dei paragrafi)
Cosa ho scoperto 1: la differenza la fa il saper rifiutare
Percentuale di risposte inventate fornendo un testo lungo senza risposta (croato).
| Modello | Risposte inventate in testi lunghi senza risposta |
|---|---|
| Qwen3.5 4B | 9% |
| Mio 320M | 9% |
| Qwen3.5 9B | 10% |
| Gemma 4 E4B | 19% |
| Granite 4.1 8B | 30% |
| Phi-4-mini 3.8B | 64% |
| SmolLM3 3B | 73% |
| EuroMoE 2.6B-A0.6B | 94% |
Per esempio, alla domanda “Quando è uscito Need for Speed Heat?”, fornendo un testo lungo che non contiene la risposta, Qwen3.5 9B ha risposto “La risposta non è nel testo”, mentre Phi-4-mini ha risposto “agosto 1969”. Sembra abbia raccolto una data presente da qualche parte nel testo.
Questo è il problema più serio nel RAG. È rischioso scegliere un modello guardando soltanto l'accuratezza. La percentuale di risposte corrette tra quelle date era massima per Qwen3.5 4B e 9B, con 91–92%, mentre Phi-4-mini raggiungeva solo il 64%.
Cosa ho scoperto 2: in inglese rifiutano troppo spesso
Al contrario, in inglese molti modelli rifiutavano anche se la risposta era chiaramente scritta. Percentuale di rifiuti fornendo un paragrafo con risposta.
| Modello | Croato | Inglese |
|---|---|---|
| Qwen3.5 4B | 15% | 35% |
| Qwen3.5 0.8B | 17% | 47% |
| OLMo 3 7B | 8% | 47% |
| MiniCPM5 2B | 34% | 70% |
| Gemma 4 E4B | 9% | 8% |
Per esempio: “Quando Paul Accola è salito sul podio per l'ultima volta?”. Nel paragrafo inglese è scritto chiaramente “the last time in 2000”, ma Qwen3.5 4B ha risposto “La risposta non è nel testo”. Ponendo lo stesso problema in croato, ha risposto correttamente “nel 2000”.
Non conosco ancora il motivo. La versione inglese è una traduzione automatica, quindi potrebbe incidere la poca naturalezza del testo; oppure il modello potrebbe reagire troppo fortemente in inglese all'istruzione “se non c'è risposta, rispondi così”.
Risultati: velocità su CPU
Dato che per il mio uso il funzionamento su CPU è un presupposto, ho convertito tutti i modelli nello stesso formato di llama.cpp (Q4_K_M) e li ho misurati su un i7-13700K. Ho usato 8 thread per la generazione e 16 thread per la lettura del testo. Solo Ministral 3 non si è convertito correttamente, quindi ho usato il Q4_K_M ufficiale di Mistral.
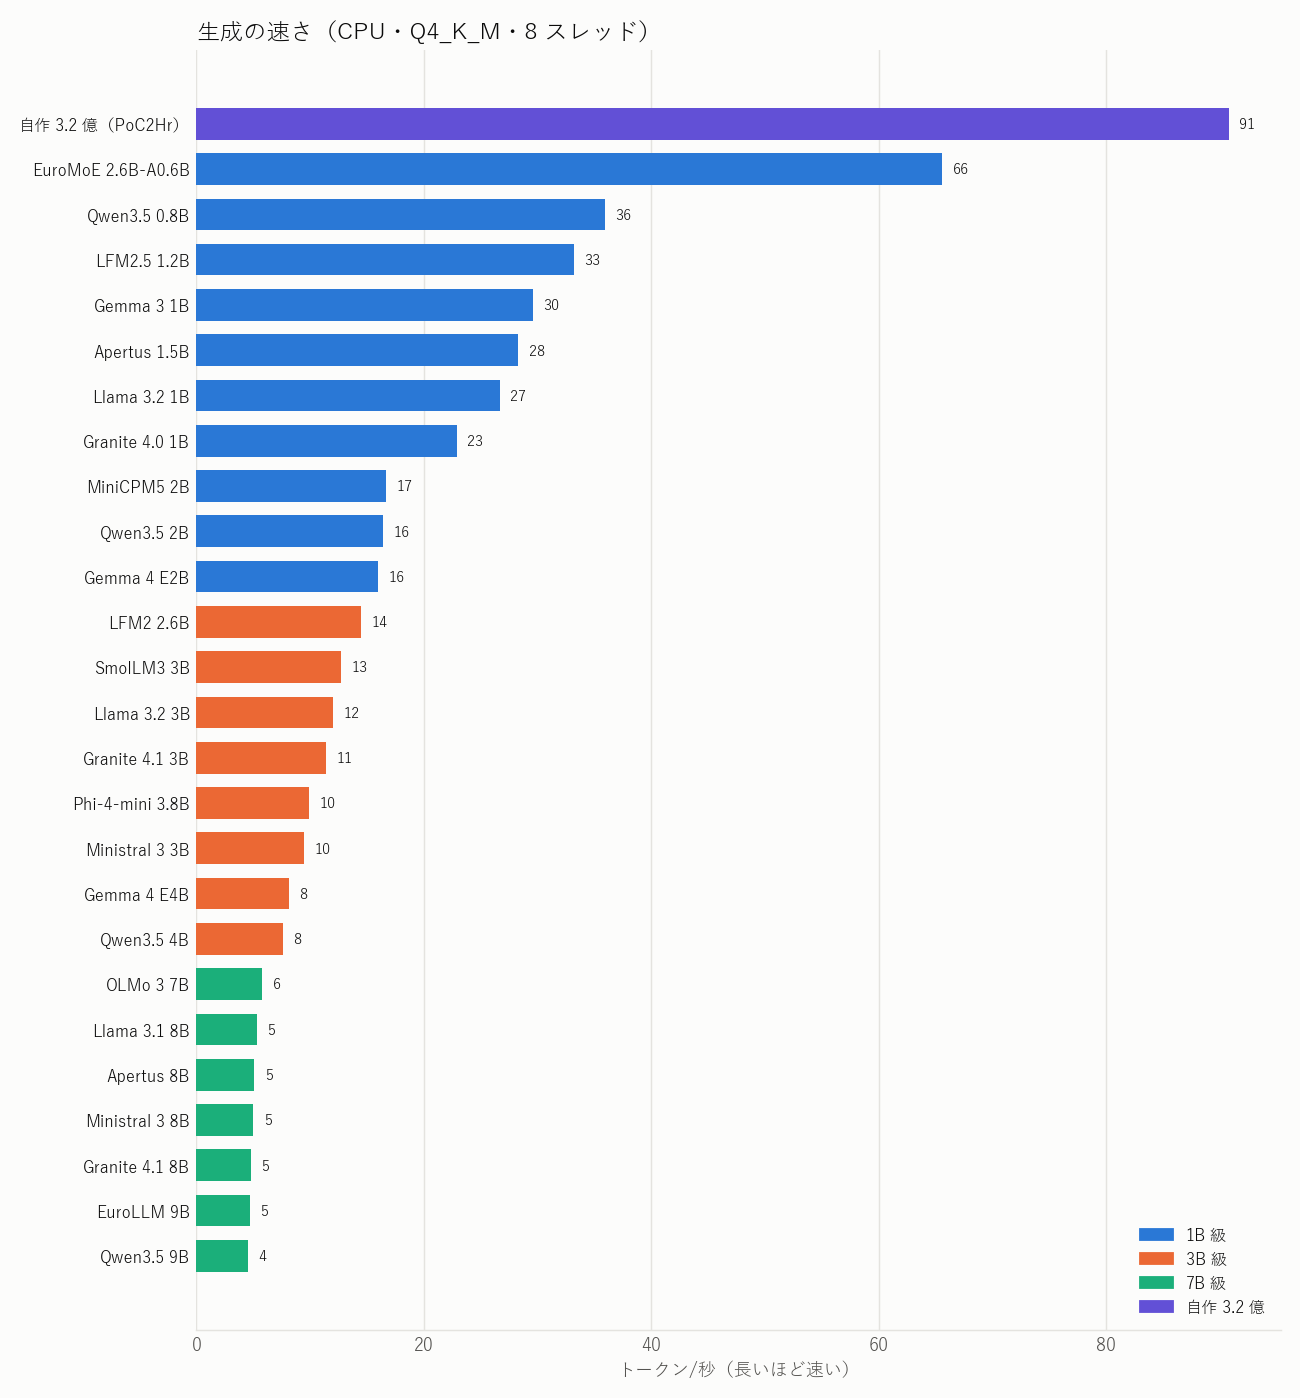
Ho anche stimato il tempo fino alla risposta a una domanda su testo lungo. Per ciascun modello, è la somma del tempo per leggere il numero di token di input del testo lungo e del tempo per generare una risposta della lunghezza media.
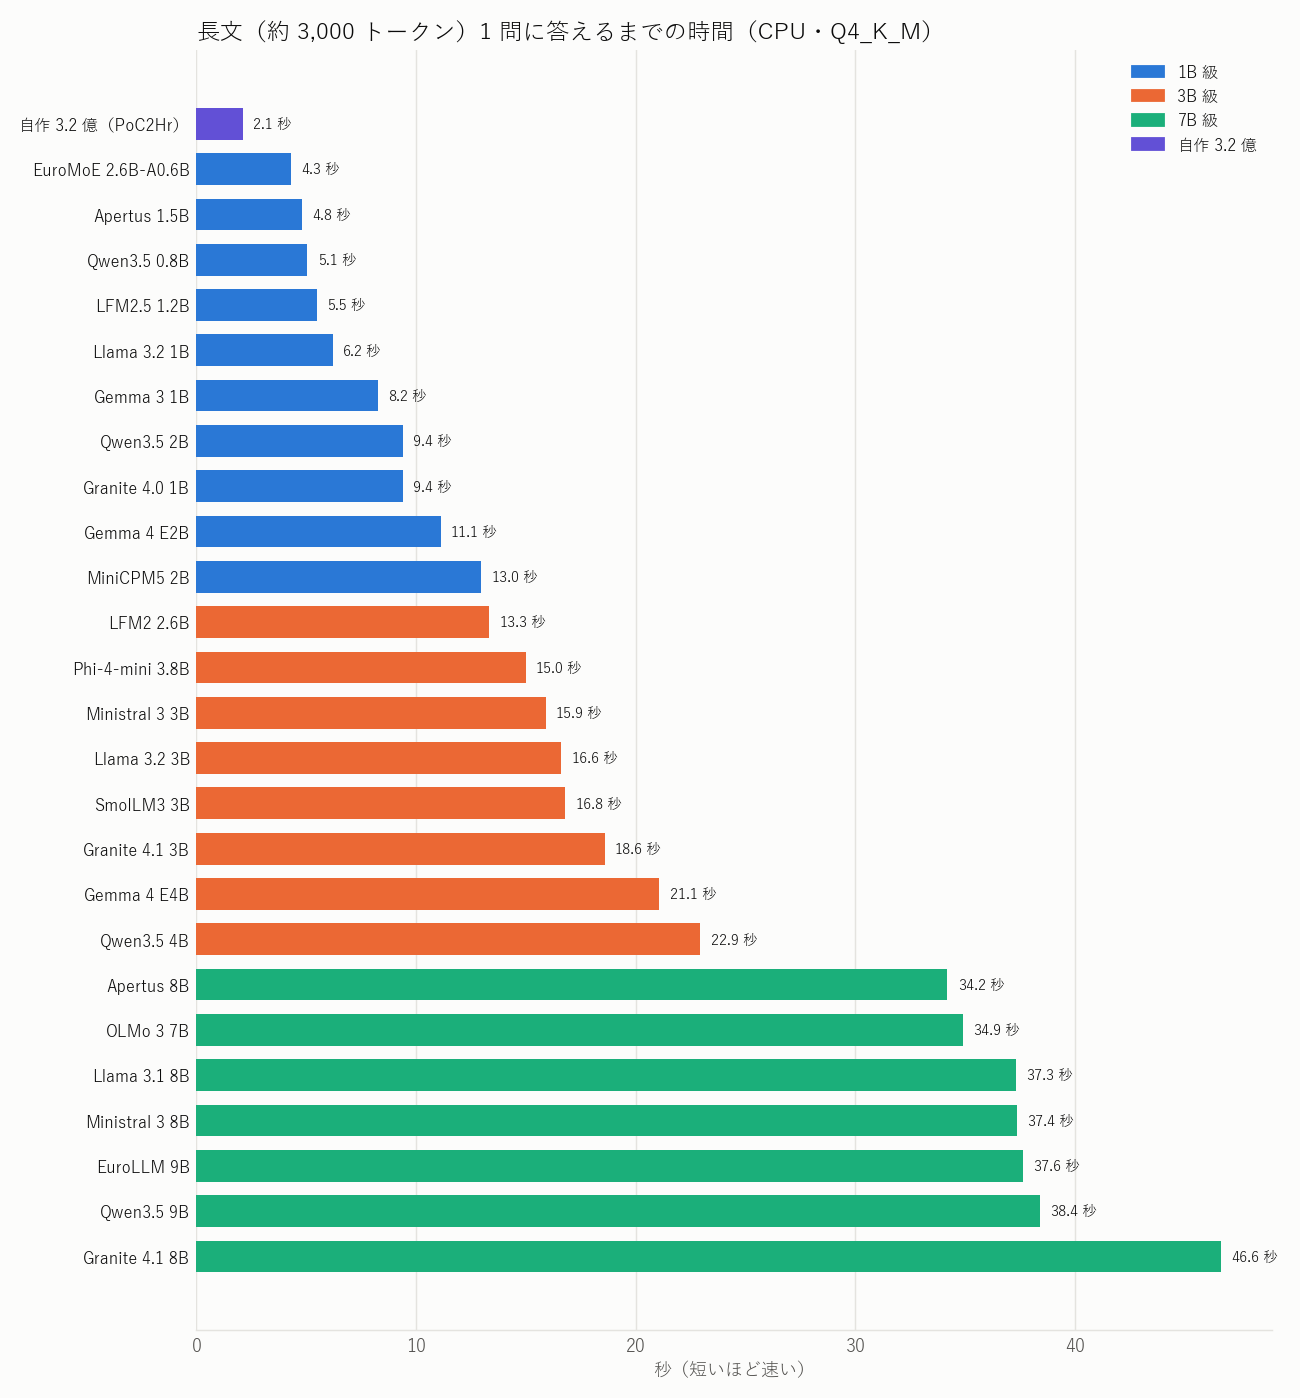
- La velocità di generazione è grosso modo inversamente proporzionale alla dimensione. I modelli della classe 7B generano circa 5 token al secondo e richiedono 34–47 secondi per una domanda su testo lungo
- La classe 3B richiede 13–23 secondi, quella 1B 4–13 secondi
- Anche per lo stesso testo lungo, il numero di token di input varia da 2.443 a 3.796 a seconda del modello. Dipende da quanto il tokenizer riesca a rappresentare in modo compatto il croato e il tokenizer del mio modello, creato specificamente per il croato, è il più corto
Affiancando velocità e accuratezza
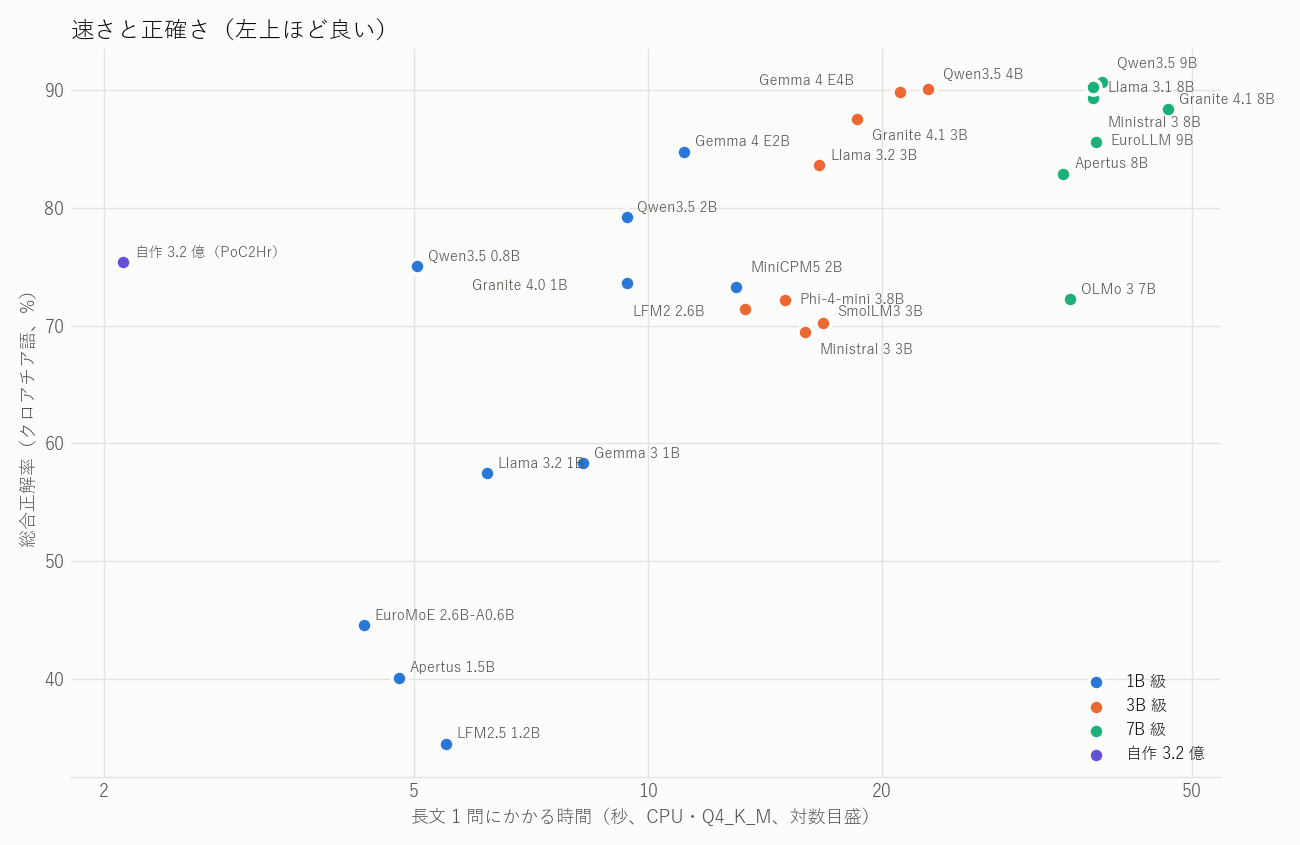
Più in alto a sinistra significa “veloce e accurato”.
- Il miglior equilibrio è Gemma 4 E2B (11 secondi, 85%) e Qwen3.5 2B (9 secondi, 79%)
- Se si privilegia l'accuratezza, Qwen3.5 4B o Gemma 4 E4B (21–23 secondi, 90%). Sono oltre 1,5 volte più veloci della classe 7B e hanno quasi la stessa accuratezza
- Il mio 320M è in una categoria a parte per velocità (2,1 secondi). L'accuratezza complessiva del 75% è uguale a Qwen3.5 0.8B e il basso numero di risposte inventate è comparabile ai modelli migliori. Tuttavia, l'accuratezza sui testi lunghi è del 46%, chiaramente inferiore a Qwen3.5 0.8B (75%) e Gemma 4 E2B (88%)
- Il mio modello non è addestrato in inglese, quindi in inglese ha inventato risposte nel 91% dei testi lunghi senza risposta
Punti da notare
- La valutazione è fatta da un LLM e quindi non è perfetta. Tende a essere un po' permissiva
- La versione inglese è una traduzione automatica. Sia le domande sia la traduzione sono state create con EuroLLM-9B, quindi EuroLLM potrebbe avere un lieve vantaggio (il risultato è stato intermedio, 86%)
- Apertus 1.5B gestisce al massimo 4.096 token di contesto e non riusciva a contenere il 23% dei testi lunghi in croato. I casi che non entravano sono stati conteggiati come errati
- L'accuratezza è stata misurata su GPU (vLLM, FP8 per la classe 7B), la velocità su CPU (Q4_K_M), quindi gli ambienti di misura sono diversi. La quantizzazione potrebbe modificare leggermente l'accuratezza
- Ho misurato la velocità su un PC con le applicazioni che uso normalmente ancora aperte. Ho misurato tutti i modelli consecutivamente nelle stesse condizioni, quindi ritengo che il confronto sia utilizzabile
Considerazioni
- Per il RAG, ormai 4B è sufficiente. I migliori modelli della classe 3–4B sono accurati quanto quelli della classe 7–9B e su CPU sono da 1,5 a 2 volte più veloci
- Nella scelta del modello bisogna sempre verificare se sa rifiutare. Anche con accuratezza simile, la percentuale di risposte inventate in testi senza risposta varia dall'1% al 99% a seconda del modello. Nel RAG capita spesso che la ricerca recuperi testi irrilevanti, quindi questo è l'aspetto più importante
- Lo stesso modello cambia comportamento a seconda della lingua. In inglese molti modelli erano troppo prudenti e perdevano risposte. Non lo si può sapere senza provarli davvero nella lingua d'uso
- Il limite del mio modello sono i testi lunghi. La capacità di rifiutare e la velocità sono già sufficienti; se aumentasse l'accuratezza sui testi lunghi, dovrebbe diventare molto utilizzabile come “modello RAG eseguibile su CPU”. Voglio migliorare questo aspetto come prossimo passo
Aggiornamento: ho provato anche modelli specifici per il RAG
Mi sono chiesto: “Come sono i modelli ottimizzati specificamente per il RAG?”. Ho quindi aggiunto tre piccoli modelli dedicati al RAG. Le condizioni sono le stesse di sopra (gli stessi 260 problemi, la stessa valutazione).
- LFM2-1.2B-RAG (Liquid AI): LFM2-1.2B ulteriormente addestrato su oltre 1 milione di esempi in cui si forniscono documenti e si risponde. Supporta 9 lingue, tra cui inglese e giapponese, ma non il croato
- Pleias-RAG-1B / Pleias-RAG-350M (PleIAs): modelli addestrati su circa 3,1 milioni di dati sintetici RAG. Prima della risposta scrivono “analisi della domanda → analisi delle fonti → bozza” e aggiungono alla risposta citazioni dal testo. Supportano 7 lingue europee, ma non il croato. Il contesto gestibile arriva fino a 4.096 token
- Per il confronto, ho misurato anche il semplice LFM2-1.2B su cui si basa LFM2-1.2B-RAG
A LFM2-1.2B-RAG ho dato la stessa istruzione degli altri modelli. Pleias accetta solo un formato di input dedicato (che separa domanda e fonti con simboli specifici), quindi l'ho usato nello stesso formato della libreria ufficiale e ho valutato soltanto la parte finale della risposta. Per questo motivo non ho potuto dare a Pleias l'istruzione “se non c'è risposta, rispondi così”.
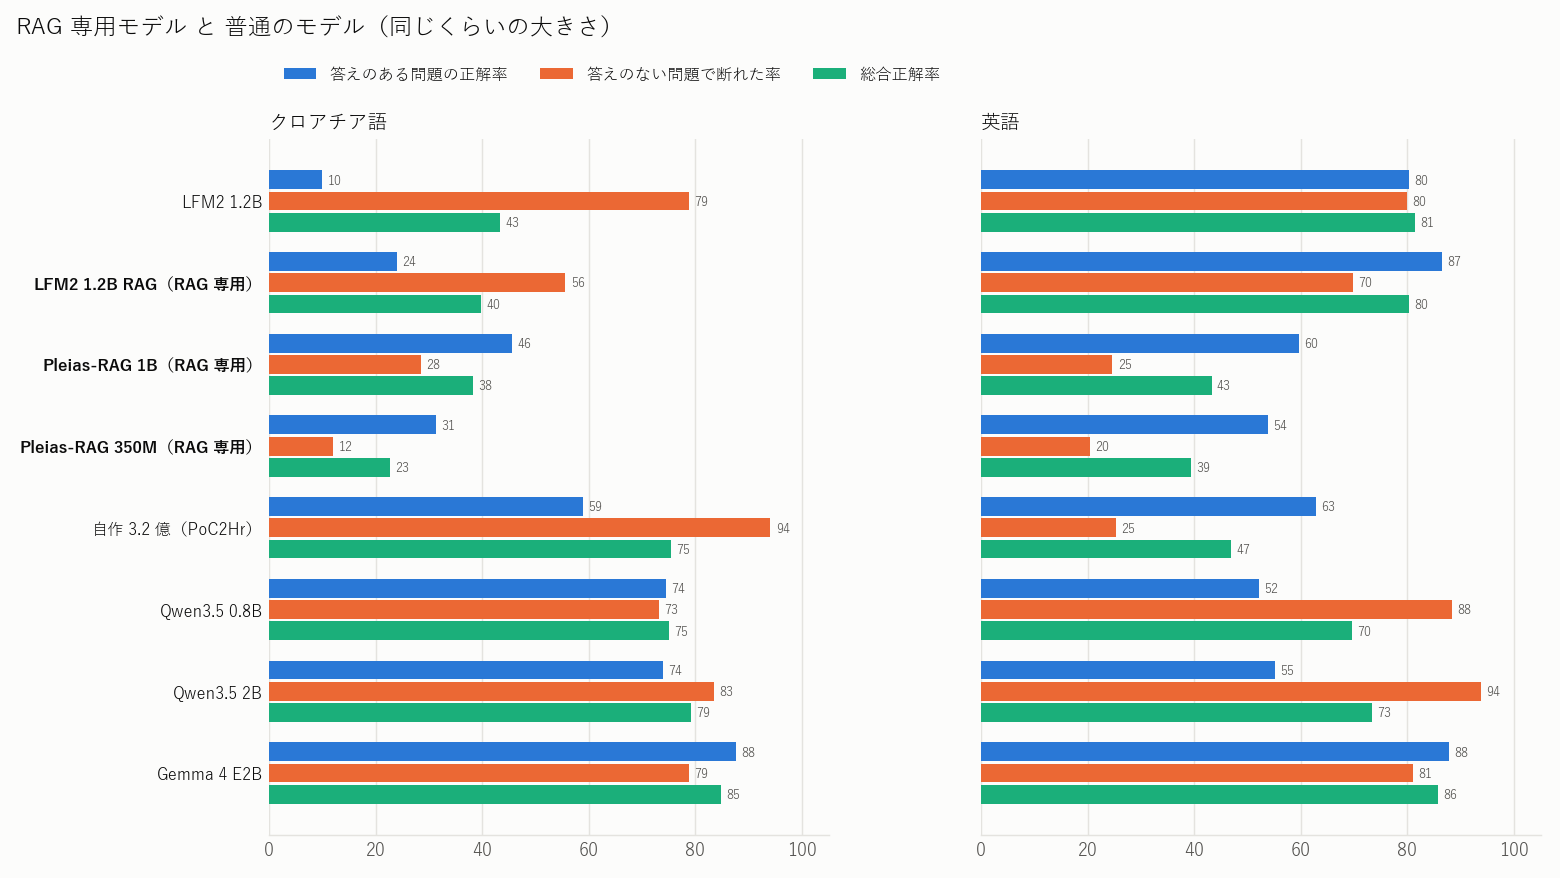
| Modello | Totale (croato) | Totale (inglese) | Risposte inventate in testi lunghi senza risposta (croato / inglese) | Tempo per una domanda su testo lungo (CPU) |
|---|---|---|---|---|
| LFM2 1.2B (modello originale) | 43% | 81% | 42% / 36% | 7,8 secondi |
| LFM2 1.2B RAG | 40% | 80% | 61% / 51% | 8,1 secondi |
| Pleias-RAG 1B | 38% | 43% | 57% / 73% | 16,9 secondi |
| Pleias-RAG 350M | 23% | 39% | 68% / 92% | 6,0 secondi |
| Riferimento: mio 320M | 75% | 47% | 9% / 91% | 2,1 secondi |
| Riferimento: Qwen3.5 0.8B | 75% | 70% | 43% / 21% | 5,1 secondi |
| Riferimento: Gemma 4 E2B | 85% | 86% | 37% / 32% | 11,1 secondi |
In conclusione, nei problemi di questa prova non ho trovato aspetti in cui i modelli specifici per il RAG fossero migliori dei modelli normali.
LFM2-1.2B-RAG: ha iniziato a rispondere, ma ha aumentato anche le invenzioni
Confrontandolo con LFM2-1.2B originale in inglese, l'accuratezza sui problemi con risposta è aumentata (paragrafi 83% → 87%, testi lunghi 78% → 86%). Ma sono aumentate anche le risposte inventate nei testi senza risposta (paragrafi 4% → 10%, testi lunghi 36% → 51%), per cui il totale è rimasto quasi identico: 81% → 80%. Sembra che l'ulteriore addestramento per il RAG lo abbia spinto verso il “rispondere a tutti i costi”.
In croato, il modello originale è già quasi inutilizzabile. LFM2-1.2B originale ha rifiutato il 93% dei paragrafi con risposta dicendo “non c'è risposta”, mentre la versione RAG spesso restituiva l'istruzione stessa, come “Odgovori kratko, jednom rečenicom.(Rispondi brevemente in una frase.)”. Il croato non è tra le lingue supportate, quindi è inevitabile.
Pleias-RAG: aggiunge citazioni, ma quelle citazioni non sono nel testo
Pleias non rifiutava quasi mai, nemmeno con testi senza risposta. In inglese, ha inventato una risposta nel 78% dei paragrafi senza risposta e nel 73% dei testi lunghi senza risposta (1B).
Anche la sua caratteristica distintiva, la “risposta con citazioni”, è sospetta. Ho contato la percentuale di casi in cui la frase citata veniva trovata esattamente nel testo (è una corrispondenza completa che ignora solo le differenze negli spazi, quindi anche citazioni leggermente parafrasate risultano “non trovate”).
| Problemi con risposta | Problemi senza risposta | |
|---|---|---|
| Pleias-RAG 1B (inglese) | 64% | 42% |
| Pleias-RAG 1B (croato) | 57% | 53% |
| Pleias-RAG 350M (inglese) | 66% | 39% |
| Pleias-RAG 350M (croato) | 52% | 40% |
Per esempio: “Quale band ha scritto per prima il brano Tourniquet?” (la risposta è Soul Embraced).
- Fornendo un paragrafo che non contiene la risposta, il modello 1B ha risposto “L'ha scritta Amy Lee” e ha aggiunto come citazione una frase che non è nel testo, “Amy Lee (born Amy Leigh Lee, November 1, 1970) ...”
- Anche fornendo un paragrafo che contiene la risposta, ha risposto “L'ha scritta Amy Lee”. Inoltre, la citazione aggiunta era “originally written ... for the Christian death metal band Soul Embraced”: la citazione è corretta, ma la risposta la contraddice
La presenza di una citazione fa sembrare che la risposta sia davvero basata sul testo, e proprio per questo può essere ancora più pericolosa.
Anche sul piano della velocità, Pleias scrive analisi prima della risposta, quindi le risposte sono lunghe (in media 381–420 token nei testi lunghi). Il modello 1B impiega 16,9 secondi per una domanda su testo lungo, più di Gemma 4 E2B (11,1 secondi). Inoltre, il 25% dei testi lunghi in croato non entrava nel contesto (conteggiati come errati; il tempo è la media dei soli problemi che entravano, quindi nella pratica richiede ancora un po' di più).
Perché è successo? (ipotesi)
- Lingua: il croato non è tra le lingue supportate da nessuno dei tre modelli. Tuttavia, perdono contro i modelli normali anche in inglese
- Forma dei problemi: questa volta si trattava di “rispondere brevemente a partire da un singolo testo / rifiutare se la risposta non c'è”. Pleias viene valutato su problemi che richiedono di combinare più fonti per rispondere (come HotpotQA), quindi potrebbe eccellere in un formato diverso
- Modalità di rifiuto: ai modelli normali si può dire “se non c'è risposta, rispondi così”, ma Pleias non ha un punto in cui ricevere questa istruzione. Il modello dispone di un meccanismo per decidere “non posso rispondere con queste fonti”, ma in questa prova ha funzionato poco
Riepilogo dell'aggiornamento
- Non conviene scegliere solo in base al nome “specifico per il RAG”. Nelle condizioni di questa prova, normali modelli istruzionali come Gemma 4 E2B e Qwen3.5 erano più accurati e rifiutavano quando dovevano farlo
- Le risposte con citazioni non hanno valore se non si verifica la citazione stessa. Solo il 40–70% delle citazioni di Pleias è stato trovato nel testo così com'è
- Il mio modello supera modelli specifici per il RAG di dimensioni analoghe. Rispetto a Pleias-RAG 350M, in croato il totale è 75% contro 23%, e il tempo per una domanda su testo lungo è 2,1 secondi contro 6,0 secondi. Crearlo specificamente per il croato è servito
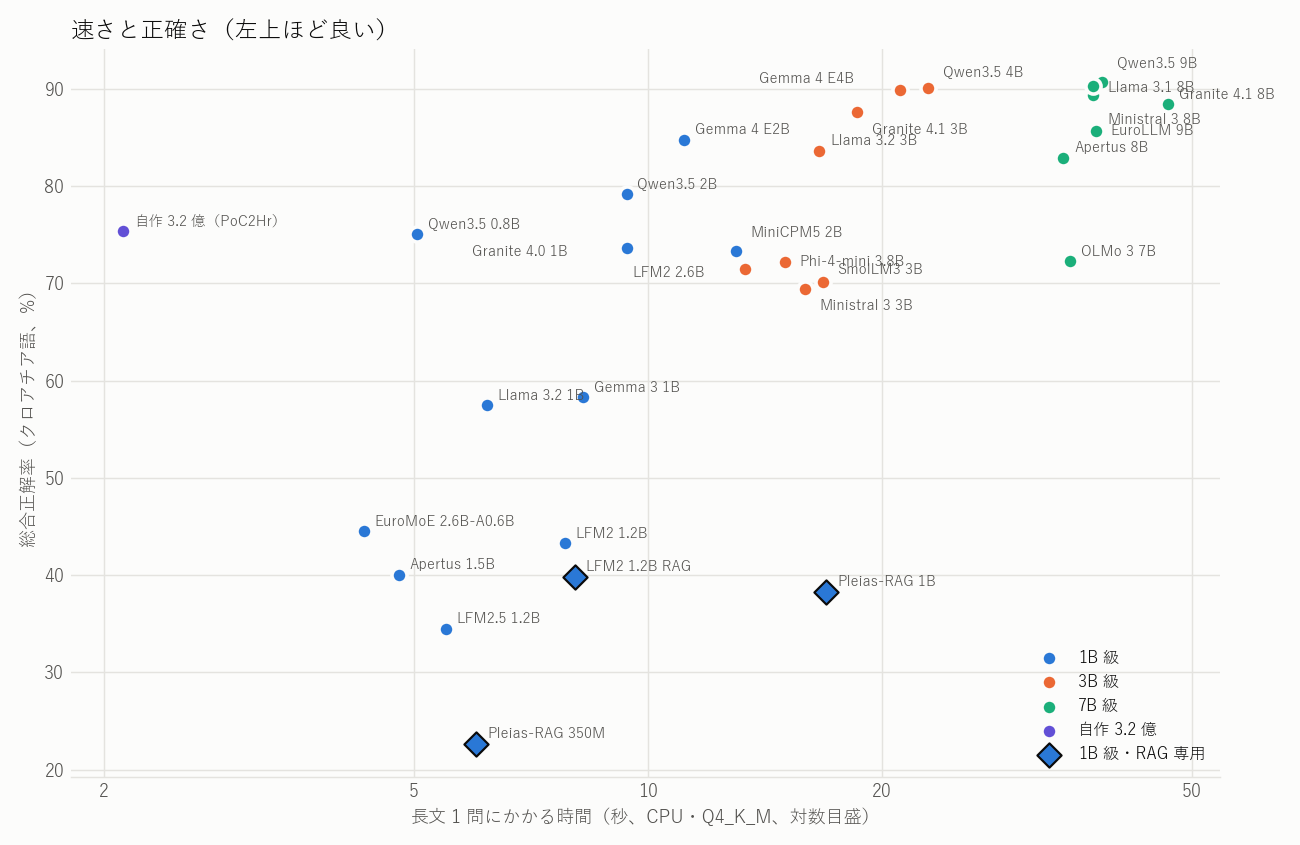
La velocità dei quattro modelli aggiunti è stata misurata la sera dello stesso giorno, sullo stesso PC e nelle stesse condizioni. Li ho aggiunti anche al grafico di velocità e accuratezza.
Risultati completi
Croato
| Modello | Classe | Corrette nel paragrafo | Corrette nel testo lungo | Complessivo | Allucinazioni senza risposta (paragrafo/testo lungo) | Percentuale corretta tra le risposte |
|---|---|---|---|---|---|---|
| Qwen3.5 9B | classe 7B | 84% | 90% | 91% | 1% / 10% | 91% |
| Llama 3.1 8B | classe 7B | 88% | 88% | 90% | 2% / 15% | 90% |
| Qwen3.5 4B | classe 3B | 82% | 88% | 90% | 1% / 9% | 92% |
| Gemma 4 E4B | classe 3B | 87% | 91% | 90% | 2% / 19% | 87% |
| Ministral 3 8B | classe 7B | 88% | 85% | 89% | 3% / 14% | 89% |
| Granite 4.1 8B | classe 7B | 91% | 90% | 88% | 2% / 30% | 84% |
| Granite 4.1 3B | classe 3B | 88% | 88% | 88% | 2% / 29% | 83% |
| EuroLLM 9B | classe 7B | 87% | 75% | 86% | 5% / 14% | 88% |
| Gemma 4 E2B | classe 1B | 88% | 88% | 85% | 5% / 37% | 78% |
| Llama 3.2 3B | classe 3B | 80% | 81% | 84% | 2% / 27% | 81% |
| Apertus 8B | classe 7B | 85% | 80% | 83% | 8% / 29% | 81% |
| Qwen3.5 2B | classe 1B | 74% | 74% | 79% | 4% / 29% | 79% |
| Realizzato in casa 320M | realizzato in casa | 72% | 46% | 75% | 3% / 9% | 72% |
| Qwen3.5 0.8B | classe 1B | 74% | 75% | 75% | 11% / 43% | 68% |
| Granite 4.0 1B | classe 1B | 83% | 77% | 74% | 22% / 51% | 64% |
| MiniCPM5 2B | classe 1B | 62% | 44% | 73% | 1% / 6% | 89% |
| OLMo 3 7B | classe 7B | 80% | 70% | 72% | 7% / 64% | 62% |
| Phi-4-mini 3.8B | classe 3B | 91% | 89% | 72% | 38% / 64% | 64% |
| LFM2 2.6B | classe 3B | 69% | 61% | 71% | 5% / 43% | 62% |
| SmolLM3 3B | classe 3B | 83% | 78% | 70% | 20% / 73% | 62% |
| Ministral 3 3B | classe 3B | 64% | 28% | 69% | 2% / 5% | 90% |
| Gemma 3 1B | classe 1B | 79% | 62% | 58% | 32% / 89% | 48% |
| Llama 3.2 1B | classe 1B | 73% | 35% | 57% | 43% / 33% | 48% |
| EuroMoE 2.6B-A0.6B | classe 1B | 73% | 67% | 45% | 80% / 94% | 42% |
| LFM2 1.2B | classe 1B | 5% | 15% | 43% | 1% / 42% | 21% |
| Apertus 1.5B | classe 1B | 88% | 58% | 40% | 99% / 75% | 44% |
| LFM2 1.2B RAG | classe 1B・dedicato al RAG | 23% | 25% | 40% | 28% / 61% | 24% |
| Pleias-RAG 1B | classe 1B・dedicato al RAG | 73% | 18% | 38% | 63% / 57% | 35% |
| LFM2.5 1.2B | classe 1B | 45% | 18% | 34% | 53% / 75% | 23% |
| Pleias-RAG 350M | classe 1B・dedicato al RAG | 54% | 9% | 23% | 85% / 68% | 21% |
Inglese
| Modello | Classe | Corrette nel paragrafo | Corrette nel testo lungo | Complessivo | Allucinazioni senza risposta (paragrafo/testo lungo) | Percentuale corretta tra le risposte |
|---|---|---|---|---|---|---|
| Gemma 4 E4B | classe 3B | 86% | 87% | 88% | 3% / 18% | 85% |
| Granite 4.1 8B | classe 7B | 85% | 78% | 87% | 3% / 15% | 89% |
| Gemma 4 E2B | classe 1B | 87% | 88% | 86% | 6% / 32% | 79% |
| Llama 3.1 8B | classe 7B | 78% | 77% | 85% | 2% / 11% | 89% |
| Phi-4-mini 3.8B | classe 3B | 87% | 90% | 85% | 10% / 31% | 80% |
| Llama 3.2 3B | classe 3B | 78% | 82% | 85% | 2% / 20% | 85% |
| LFM2 2.6B | classe 3B | 77% | 76% | 84% | 2% / 13% | 88% |
| Qwen3.5 9B | classe 7B | 69% | 80% | 84% | 1% / 9% | 92% |
| Granite 4.0 1B | classe 1B | 87% | 77% | 83% | 6% / 29% | 81% |
| Ministral 3 8B | classe 7B | 78% | 63% | 82% | 2% / 8% | 91% |
| Qwen3.5 4B | classe 3B | 63% | 77% | 82% | 1% / 8% | 92% |
| EuroLLM 9B | classe 7B | 83% | 58% | 81% | 3% / 10% | 90% |
| Granite 4.1 3B | classe 3B | 80% | 57% | 81% | 1% / 10% | 90% |
| LFM2 1.2B | classe 1B | 83% | 78% | 81% | 4% / 36% | 76% |
| LFM2 1.2B RAG | classe 1B・dedicato al RAG | 87% | 86% | 80% | 10% / 51% | 73% |
| SmolLM3 3B | classe 3B | 90% | 85% | 79% | 16% / 52% | 71% |
| Apertus 8B | classe 7B | 78% | 82% | 78% | 7% / 47% | 73% |
| Qwen3.5 2B | classe 1B | 58% | 52% | 73% | 2% / 11% | 87% |
| OLMo 3 7B | classe 7B | 52% | 47% | 71% | 0% / 8% | 90% |
| Gemma 3 1B | classe 1B | 77% | 66% | 71% | 11% / 57% | 62% |
| Qwen3.5 0.8B | classe 1B | 48% | 56% | 70% | 2% / 21% | 77% |
| Ministral 3 3B | classe 3B | 53% | 30% | 67% | 1% / 6% | 90% |
| Llama 3.2 1B | classe 1B | 57% | 35% | 65% | 9% / 16% | 73% |
| LFM2.5 1.2B | classe 1B | 39% | 24% | 61% | 1% / 9% | 76% |
| MiniCPM5 2B | classe 1B | 28% | 25% | 60% | 0% / 3% | 92% |
| EuroMoE 2.6B-A0.6B | classe 1B | 57% | 52% | 55% | 27% / 66% | 53% |
| Apertus 1.5B | classe 1B | 89% | 79% | 48% | 93% / 97% | 47% |
| Realizzato in casa 320M | realizzato in casa | 73% | 53% | 47% | 55% / 91% | 40% |
| Pleias-RAG 1B | classe 1B・dedicato al RAG | 75% | 44% | 43% | 78% / 73% | 40% |
| Pleias-RAG 350M | classe 1B・dedicato al RAG | 63% | 44% | 39% | 67% / 92% | 34% |
Velocità su CPU (i7-13700K・llama.cpp Q4_K_M)
| Modello | Dimensione | Generazione (token/sec) | Elaborazione dell'input (token/sec) | Token di input nel testo lungo | Tempo per 1 domanda sul testo lungo |
|---|---|---|---|---|---|
| Realizzato in casa 320M | 193 MB | 90.8 | 1,528 | 2,443 | 2.1 sec |
| EuroMoE 2.6B-A0.6B | 1,541 MB | 65.6 | 778 | 2,920 | 4.3 sec |
| Apertus 1.5B | 935 MB | 28.3 | 634 | 2,810 ※ | 4.8 sec |
| Qwen3.5 0.8B | 517 MB | 35.9 | 742 | 3,258 | 5.1 sec |
| LFM2.5 1.2B | 697 MB | 33.2 | 673 | 3,468 | 5.5 sec |
| Pleias-RAG 350M | 219 MB | 97.2 | 1,685 | 2,853 ※ | 6.0 sec |
| Llama 3.2 1B | 770 MB | 26.7 | 636 | 3,511 | 6.2 sec |
| LFM2 1.2B | 697 MB | 31.4 | 675 | 3,468 | 7.8 sec |
| LFM2 1.2B RAG | 697 MB | 32.8 | 678 | 3,468 | 8.1 sec |
| Gemma 3 1B | 769 MB | 29.6 | 398 | 3,055 | 8.2 sec |
| Qwen3.5 2B | 1,251 MB | 16.4 | 415 | 3,258 | 9.4 sec |
| Granite 4.0 1B | 976 MB | 22.9 | 414 | 3,636 | 9.4 sec |
| Gemma 4 E2B | 3,257 MB | 16.0 | 329 | 3,055 | 11.1 sec |
| MiniCPM5 2B | 1,489 MB | 16.7 | 313 | 3,796 | 13.0 sec |
| LFM2 2.6B | 1,491 MB | 14.5 | 278 | 3,468 | 13.3 sec |
| Phi-4-mini 3.8B | 2,378 MB | 9.9 | 208 | 2,974 | 15.0 sec |
| Ministral 3 3B | 2,048 MB | 9.5 | 215 | 3,100 | 15.9 sec |
| Llama 3.2 3B | 1,926 MB | 12.0 | 237 | 3,511 | 16.6 sec |
| SmolLM3 3B | 1,827 MB | 12.7 | 238 | 3,544 | 16.8 sec |
| Pleias-RAG 1B | 710 MB | 31.6 | 583 | 2,853 ※ | 16.9 sec |
| Granite 4.1 3B | 2,002 MB | 11.4 | 202 | 3,614 | 18.6 sec |
| Gemma 4 E4B | 5,064 MB | 8.1 | 171 | 3,055 | 21.1 sec |
| Qwen3.5 4B | 2,655 MB | 7.6 | 166 | 3,258 | 22.9 sec |
| Apertus 8B | 4,824 MB | 5.1 | 102 | 3,158 | 34.2 sec |
| OLMo 3 7B | 4,264 MB | 5.8 | 108 | 3,642 | 34.9 sec |
| Llama 3.1 8B | 4,693 MB | 5.3 | 101 | 3,511 | 37.3 sec |
| Ministral 3 8B | 4,958 MB | 5.0 | 95 | 3,100 | 37.4 sec |
| EuroLLM 9B | 5,324 MB | 4.7 | 86 | 2,920 | 37.6 sec |
| Qwen3.5 9B | 5,512 MB | 4.5 | 101 | 3,258 | 38.4 sec |
| Granite 4.1 8B | 5,100 MB | 4.8 | 88 | 3,614 | 46.6 sec |
※ Per Apertus 1.5B e Pleias-RAG, la media riguarda solo i testi lunghi rientrati nel contesto di 4.096 token.