Guida completa a Qwen-Image 2.1: generazione, editing e PNG trasparenti con 7B parametri, 100 esempi discussi su Reddit
Il 20 settembre 2026, il team Qwen ha rilasciato il modello di generazione immagini "Qwen-Image 2.1". La sua caratteristica principale è riunire in un unico modello la generazione da testo, l'editing con immagini di riferimento, la composizione di più immagini, l'editing locale e la generazione e modifica di sfondi trasparenti (RGBA). Il componente generativo ha 7 miliardi di parametri. Invece di puntare esclusivamente a modelli sempre più grandi, mira a dimensioni e a un'efficienza di elaborazione gestibili anche in locale.
In sintesi, Qwen-Image 2.1 è particolarmente interessante non tanto come modello che crea da zero l'immagine migliore possibile, quanto come modello creativo capace di preservare le immagini esistenti, combinare più materiali e modificare precisamente le parti desiderate. Su Reddit, i giudizi più positivi si concentrano su editing, coerenza dei personaggi, compositing di prodotti, outpainting e asset trasparenti. Al tempo stesso, sono stati segnalati limiti evidenti su mani e dita, visi sullo sfondo, rumore nei dettagli, neri troppo chiusi, restauro di foto antiche e stili anime.
Questo articolo organizza tutte le funzioni sulla base delle informazioni ufficiali e raccoglie, attraverso i principali thread di Reddit, i test di generazione e modifica più discussi in una selezione di 100 esempi. Le 100 voci non corrispondono a 100 post indipendenti: contano invece singoli temi di generazione e operazioni di editing verificati in più post, gallerie e workflow popolari.
Che cos'è Qwen-Image 2.1
Qwen-Image 2.1 è un modello integrato per la generazione e l'editing di immagini della famiglia Qwen. Secondo la descrizione ufficiale, il componente generativo utilizza un Single-Stream DiT a 32 livelli con 7 miliardi di parametri. Qwen3-VL 8B converte le istruzioni testuali e le immagini condizionali in una rappresentazione comune, mentre una VAE RGBA a 64 canali gestisce una compressione spaziale 16× e la trasparenza nativa.
I quattro miglioramenti dichiarati ufficialmente sono i seguenti.
- Compatto ed efficiente: l'attenzione a granularità mista e il riutilizzo della prefix KV cache migliorano il rapporto tra qualità e costo computazionale.
- Generazione e editing unificati: immagini normali e trasparenti possono essere generate e modificate con lo stesso modello.
- Editing versatile: supporta fino a 10 immagini di riferimento, indicazioni locali tramite maschere o disegni, e la preservazione dell'identità di persone e prodotti.
- Texture ed estetica: migliora tipografia, illuminazione dei ritratti e texture fini.
Fonti: blog ufficiale Qwen, GitHub ufficiale, documentazione Diffusers
Panoramica delle funzioni
1. Generazione di immagini dal testo
Supporta il normale Text-to-Image. Oltre a istruzioni brevi, può gestire descrizioni naturali lunghe, composizione, luce, materiali, primo piano e sfondo, nonché elementi testuali complessi attraverso Qwen3-VL. Gli esempi ufficiali usano 40 passaggi come base, mentre la community ha sperimentato LoRA accelerate da 8–16 passaggi e impostazioni da 30–40 passaggi orientate alla qualità.
2. Editing delle immagini
Fornendo insieme un'immagine in input e un'istruzione, è possibile cambiare colori, meteo, sfondo, abiti, pose, materiali, illuminazione e angolo di ripresa. Su Reddit molti ritengono che l'editing sia più forte del puro T2I.
3. Fino a 10 immagini di riferimento
Persone, vestiti, scarpe, borse, cappelli, mobili e prodotti possono essere presi da immagini separate e integrati in un'unica scena. Gli esempi ufficiali includono una foto di gruppo che riunisce i volti di sei persone, una prova virtuale con cinque elementi e un progetto di interni con dieci mobili. Tuttavia, la community segnala anche che, aumentando i riferimenti, diventano più probabili istruzioni in conflitto e mescolanze di attributi.
4. RGBA nativo e sfondi trasparenti
Invece di rimuovere lo sfondo in post-produzione, può generare direttamente immagini contenenti un canale di trasparenza. È adatto a estrarre soggetti da foto, modificare la forma di asset trasparenti e creare elementi trasparenti composti da più oggetti.
5. Editing locale e con maschere
Le aree da modificare possono essere indicate con cerchi, annotazioni colorate o maschere indipendenti. In ComfyUI sono stati sperimentati workflow in cui si dipinge direttamente sull'immagine e si impartiscono istruzioni come "cambia solo l'abito nell'area rossa". In combinazione con LanPaint, è possibile fare inpainting non solo del colore, ma anche del canale alfa stesso.
6. Outpainting
Può estendere la tela in alto, in basso, a destra e a sinistra, completando le aree vuote secondo il contesto dell'immagine originale. Su Reddit ha attirato attenzione una dimostrazione secondo cui può estendere più direzioni contemporaneamente ed è più veloce dei workflow specializzati tradizionali.
7. Preservazione dell'identità
L'uso principale consiste nel modificare soltanto sfondo o attributi specifici preservando volto, abiti e posa di una persona, oppure forma e caratteristiche di marca di un prodotto. È particolarmente discusso per character sheet e sequenze di scene, ma angolazioni estreme, espressioni marcate e sequenze molto lunghe richiedono verifiche contro la deriva dell'identità.
8. Rendering del testo e design
Supporta immagini con poster, packaging, insegne e tipografia. È diffuso il workflow che organizza composizione, gerarchia informativa, dimensione dei testi e spazi bianchi con un LLM esterno prima di passare tutto al modello. Sono però emerse segnalazioni di caratteri cinesi indesiderati nelle infografiche inglesi.
9. Riscrittura dei prompt
Il repository ufficiale include prompt rewriter per T2I e I2I. Espandono una richiesta breve in una composizione dettagliata e, durante l'editing, la riscrivono come istruzione che conserva tutto ciò che è fuori dalla modifica. La community segnala anche che, in alcuni casi, template specifici per l'uso sono migliori della riscrittura standard.
10. Accelerazione, memoria ridotta e quantizzazione
Sono supportati CPU offload di Diffusers, prefix KV cache di vLLM-Omni, CUDA Graph, FP8, parallelismo tensoriale, memory offload e kernel ottimizzati di SGLang. Per ComfyUI sono apparse anche varianti BF16, INT8 ConvRot, GGUF e a 4 bit. Alcuni utenti riportano un editing circa due volte più veloce con una LoRA da 4 passaggi e nodi personalizzati che eseguono l'espansione del prompt con 8 GB di VRAM, ma è essenziale verificare il compromesso tra velocità e qualità.
11. Ambienti supportati
Sono indicati l'implementazione ufficiale, Hugging Face Diffusers, ComfyUI, vLLM-Omni, SGLang-Diffusion, LightX2V e ModelScope. Vengono inoltre presentati esempi ROCm per AMD Radeon e compatibilità multi-chip tramite FlagOS.
12. Note sulla licenza
I pesi del modello sono pubblici, ma non vengono distribuiti con Apache 2.0: la licenza è la "Qwen Research License Agreement". La licenza ufficiale dichiara esplicitamente che per l'uso commerciale è necessaria una licenza commerciale separata. Include inoltre obblighi di notifica in caso di ridistribuzione e diciture come "Built with Qwen" o "Improved using Qwen" nella documentazione dei modelli AI derivati. Prima dell'adozione in ambito professionale, verifica sempre il testo originale.
Fonte: licenza ufficiale
50 prospettive attraverso gli esempi ufficiali
Qui presentiamo 50 esempi, soprattutto campioni ufficiali di Qwen-Image 2.1 pubblicati dal team Qwen, collegandoli ai punti più discussi su Reddit. Non si tratta solo di immagini gradevoli: includono input, risultati di editing, maschere, riferimenti multipli, cambi di inquadratura e generazione di materiali, così da mostrare in quale punto del processo creativo il modello possa essere utile.
Asset trasparenti e generazione di illustrazioni
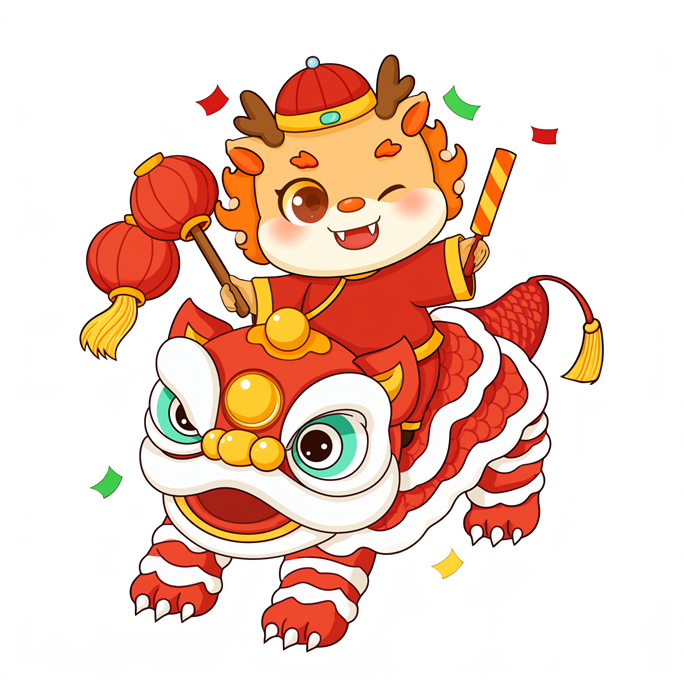
Esempio 1: illustrazione trasparente a tema danza del leone. Un esempio che tratta simultaneamente ornamenti di contorno dettagliati e uno sfondo alfa.
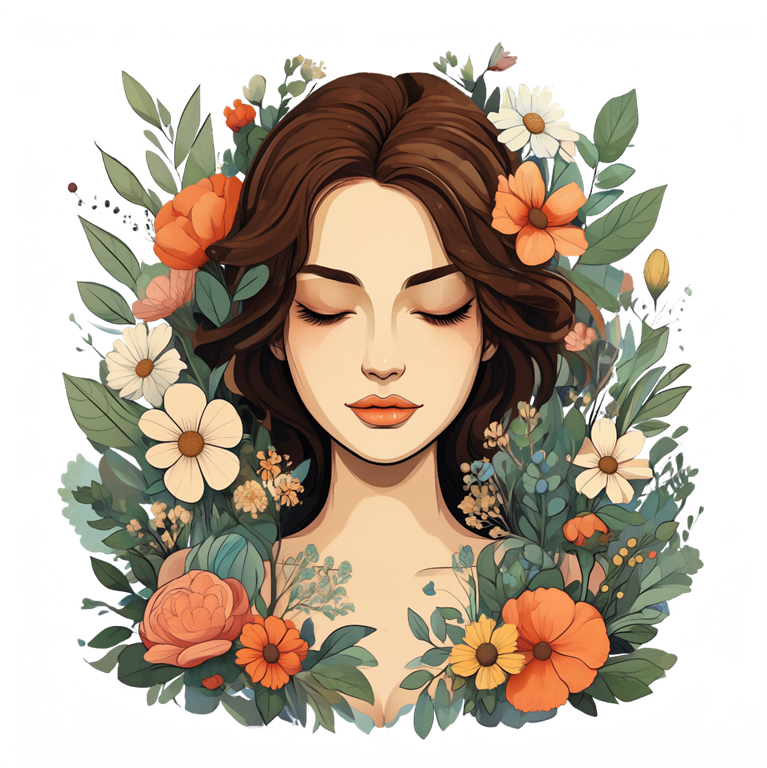
Esempio 2: illustrazione decorativa di una donna circondata da fiori. Include confini complessi tra capelli, petali e foglie.
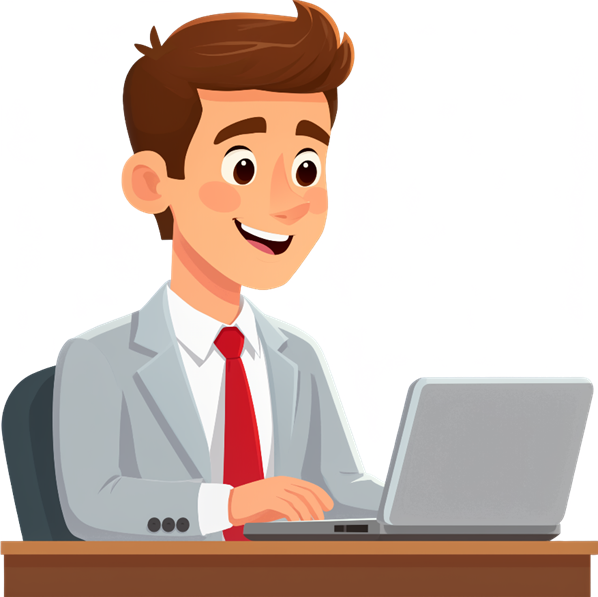
Esempio 3: professionista al computer portatile. Un'illustrazione ritagliata per Web e presentazioni.
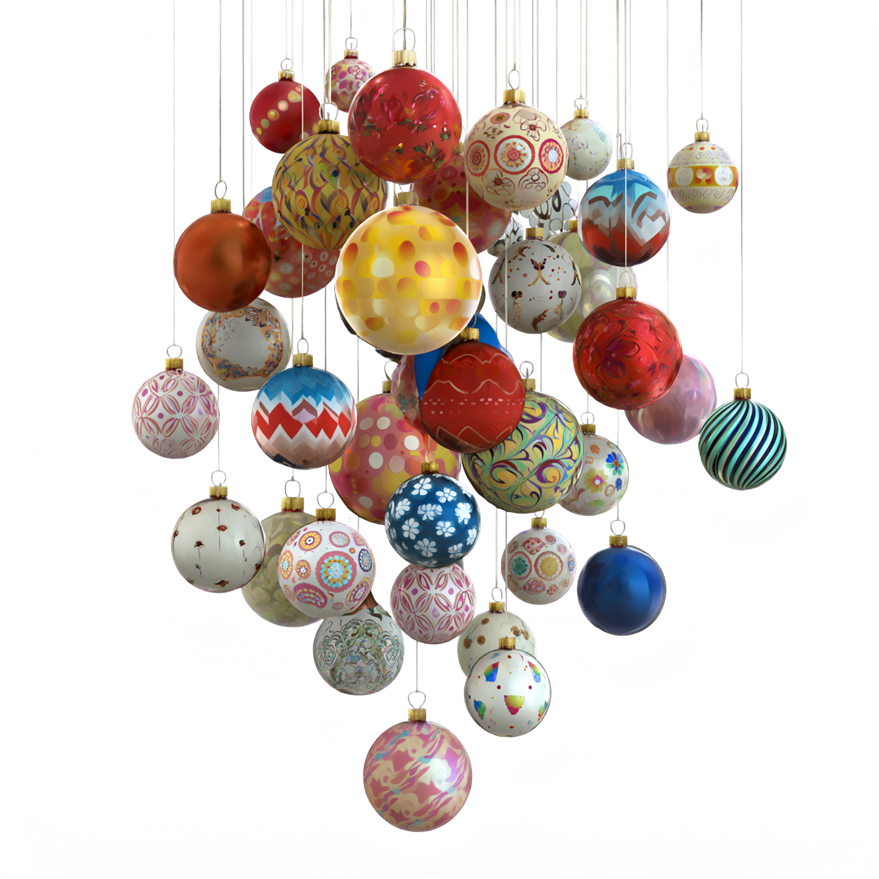
Esempio 4: più decorazioni sospese. Integra in una sola immagine traslucenza, fili sottili e materiali diversi.
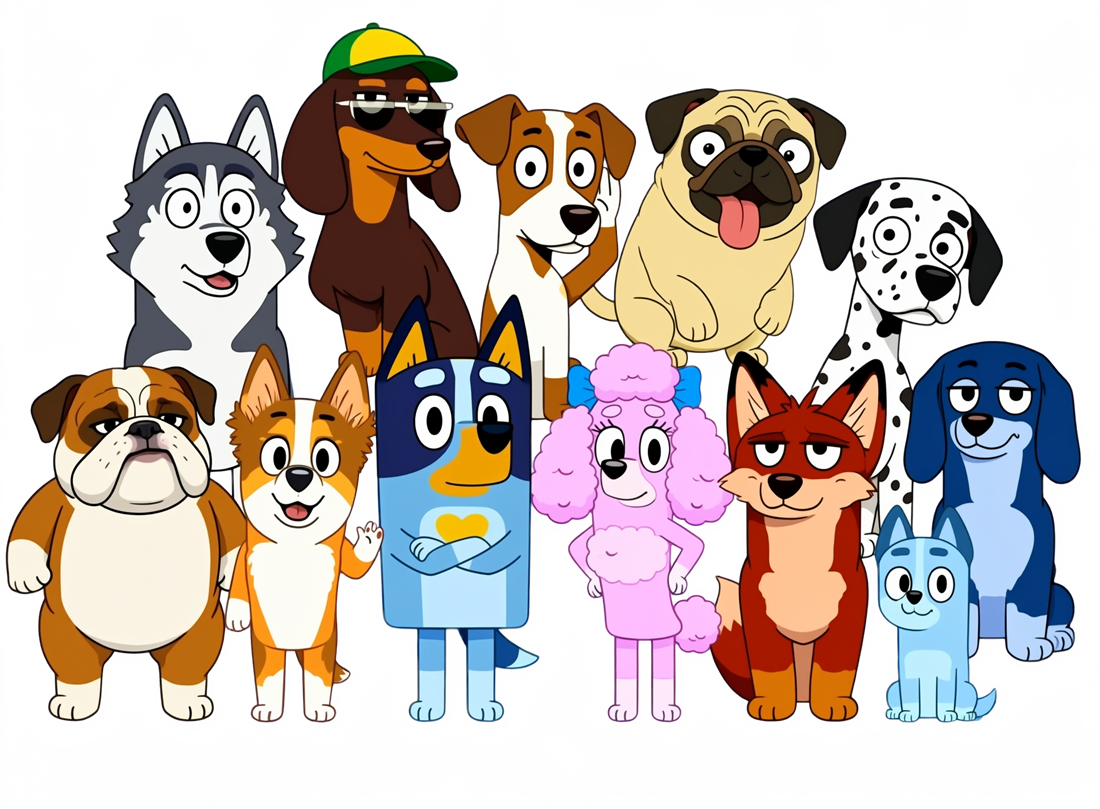
Esempio 5: molti personaggi canini. Un esempio di differenziazione di più soggetti e composizione di gruppo.
Editing delle immagini e sostituzione del testo
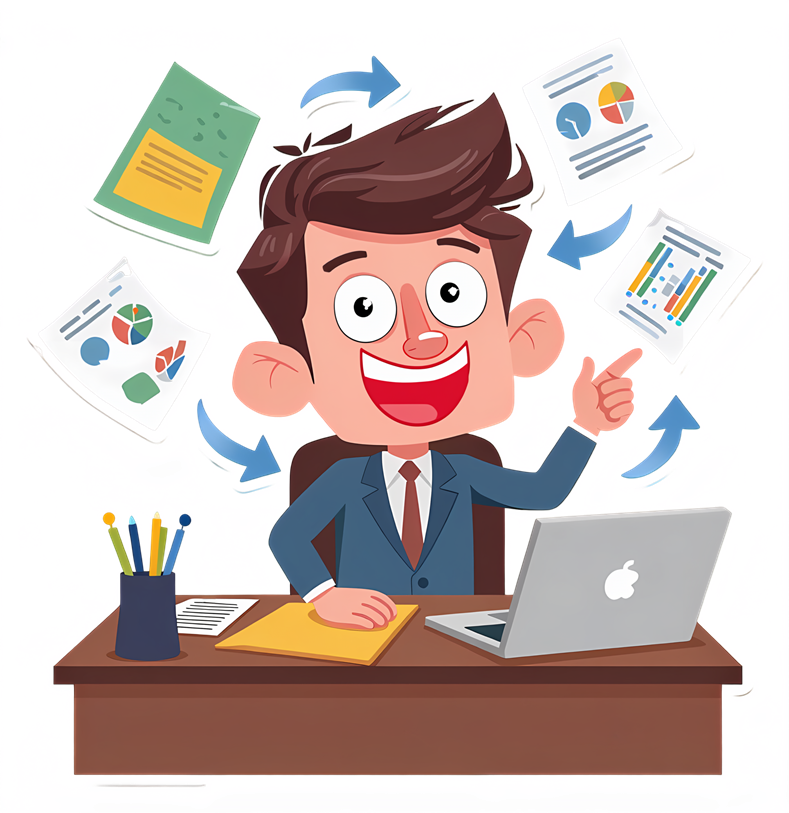
Esempio 6: immagine originale di un impiegato esausto. Immagine condizionale per il confronto con il successivo risultato di editing.
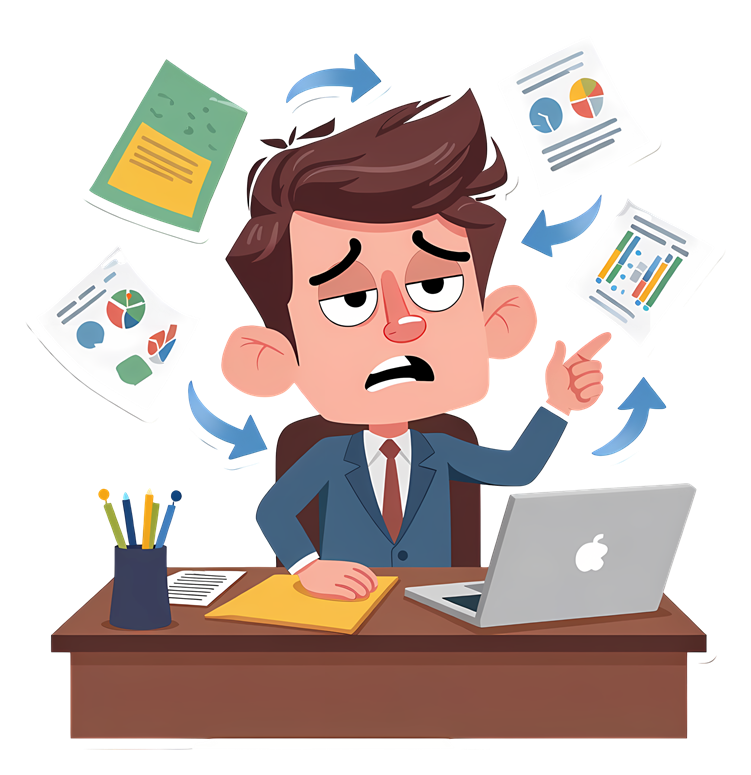
Esempio 7: impiegato con espressione e atmosfera modificate. Cambia l'emozione del soggetto mantenendo il layout.
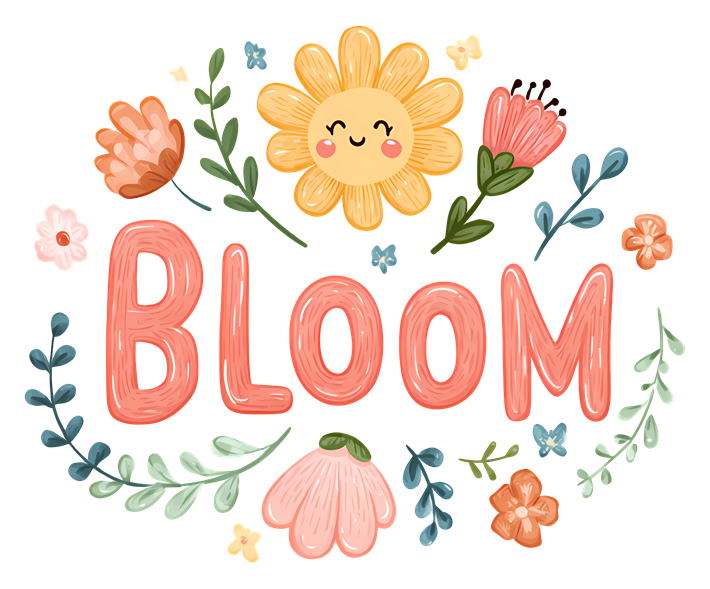
Esempio 8: testo floreale "BLOOM". Esempio di riferimento per testo, decorazione e disposizione centrale.
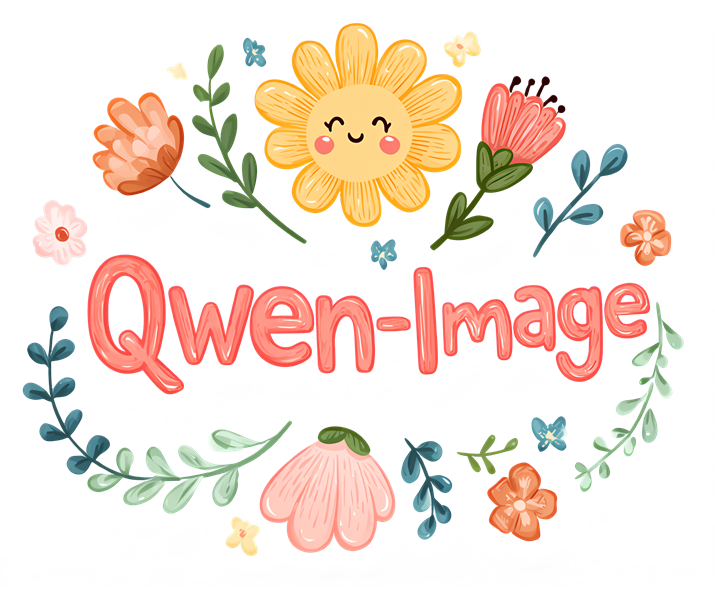
Esempio 9: sostituzione del testo con "Qwen-Image". Editing tipografico che conserva lo stile floreale.
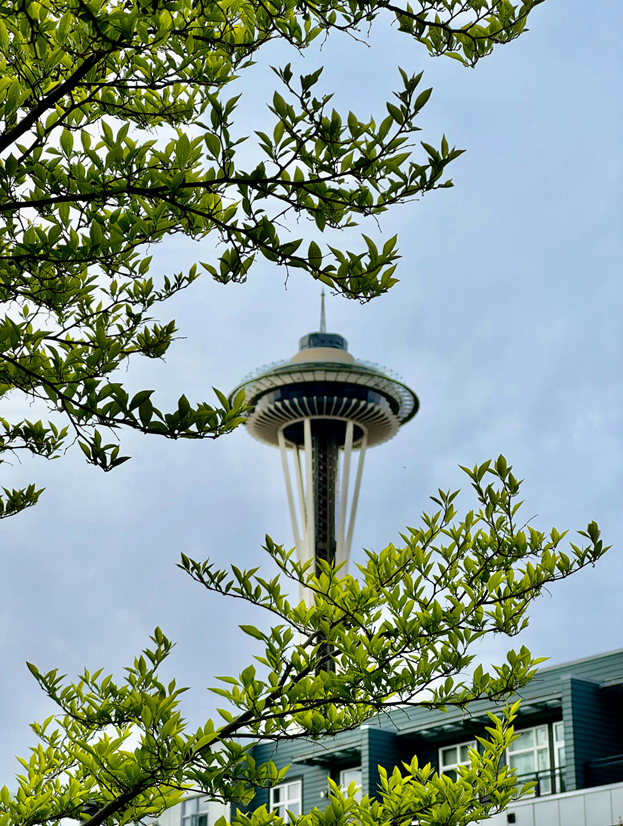
Esempio 10: foto diurna di una torre. Input per l'editing dell'orario e dello sfondo.
Sfondo, orario e più persone
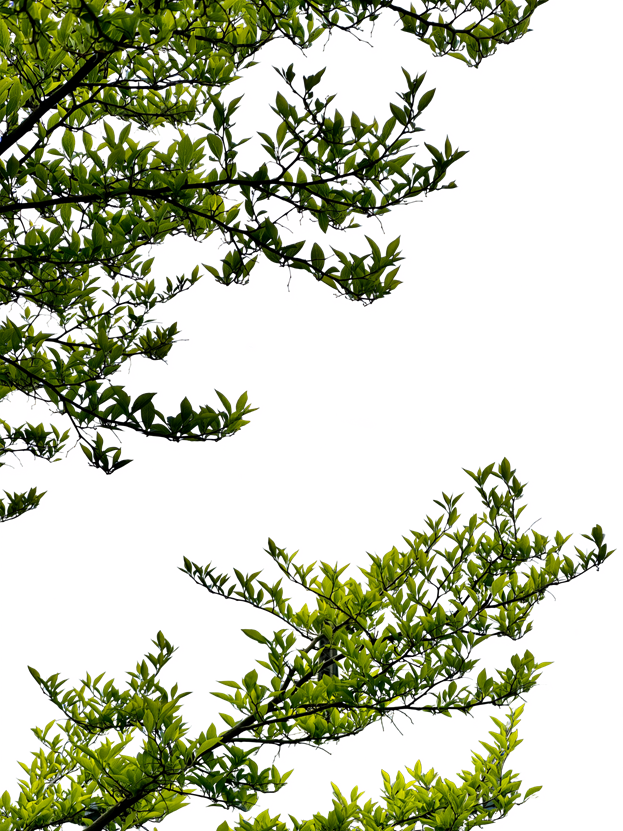
Esempio 11: albero fiorito notturno. Mostra la capacità di convertire una foto diurna in una scena notturna e cambiarne l'atmosfera.
Esempio 12: foto di gruppo generata da più riferimenti di persone. Mostra una funzione centrale del limite di 10 riferimenti.
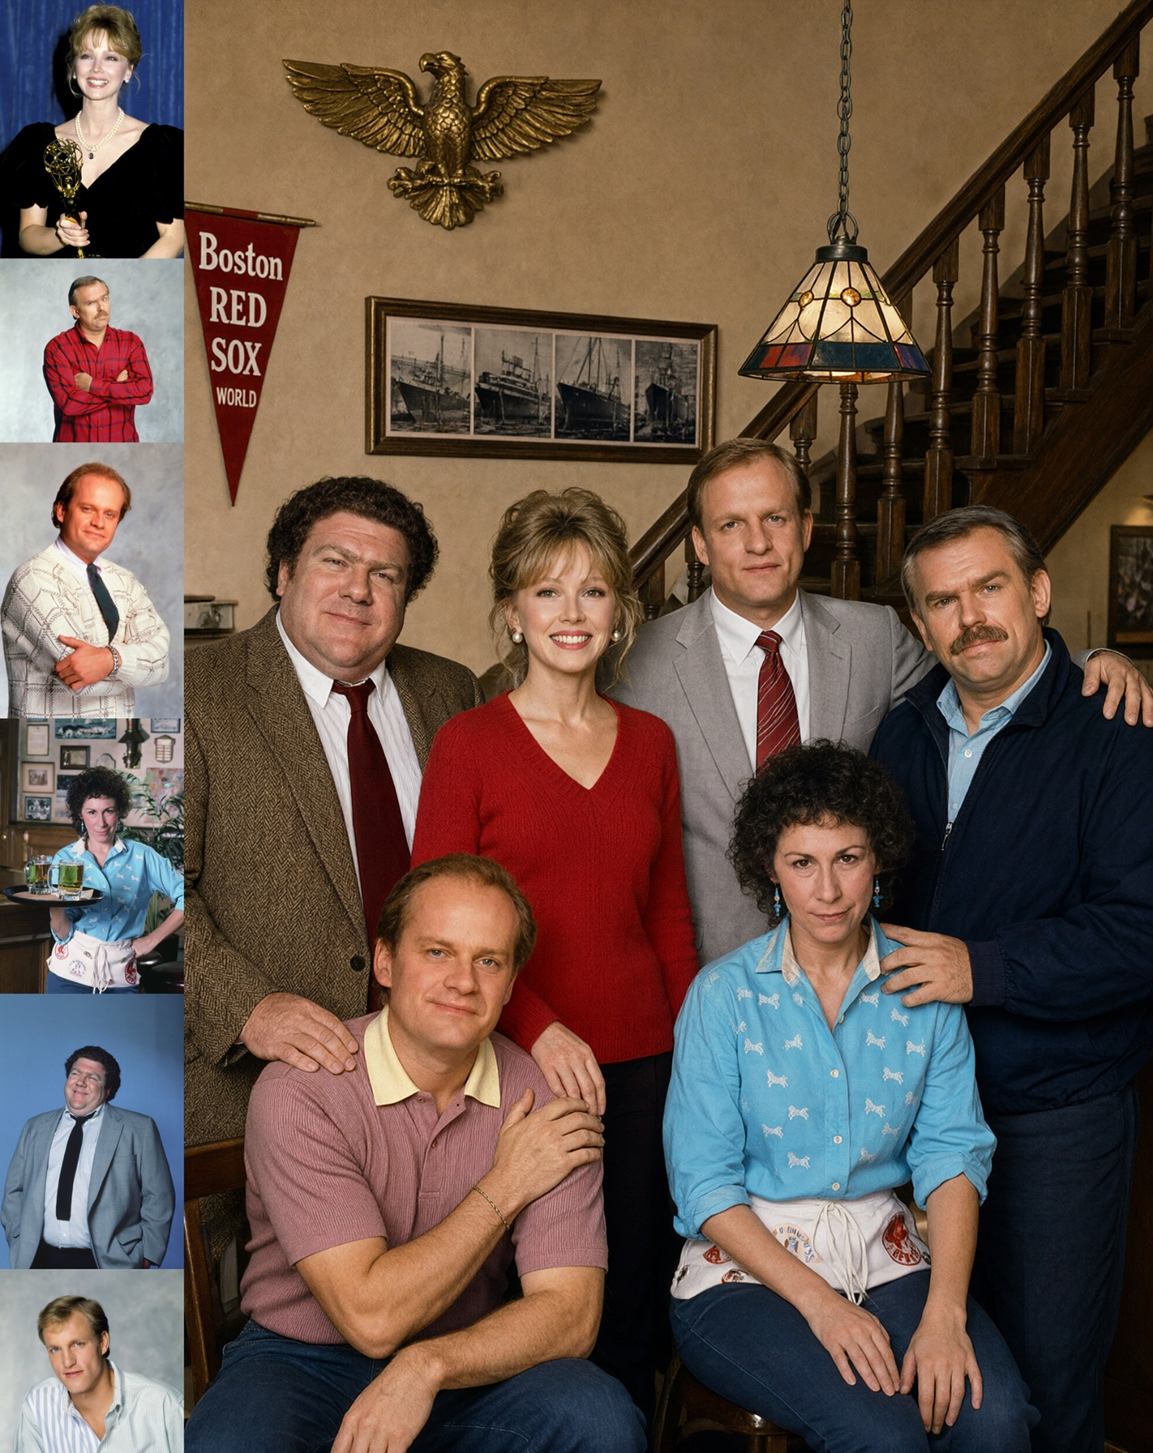
Esempio 13: outfit creato con più riferimenti di persone e abiti. Vicino al concetto di prova virtuale.
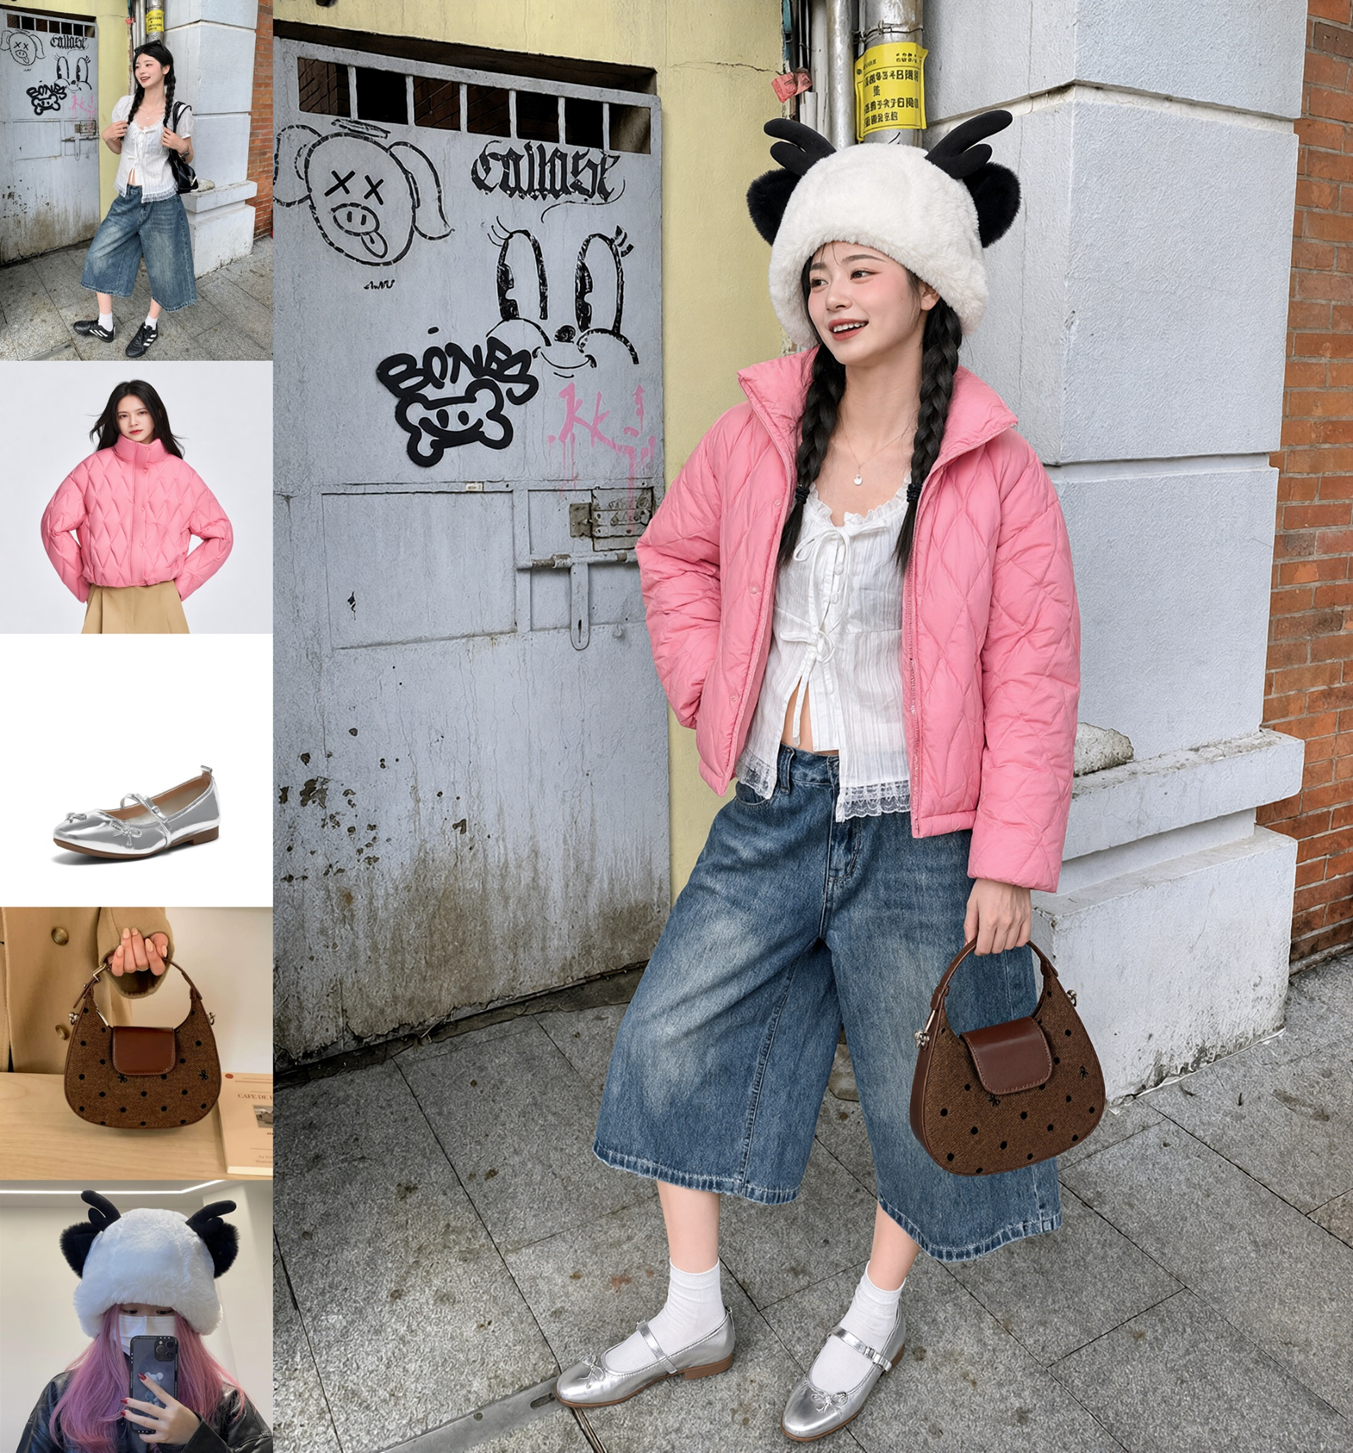
Esempio 14: interno composto da molte immagini di mobili. Un caso d'uso per collocare cataloghi di prodotti in una stanza.
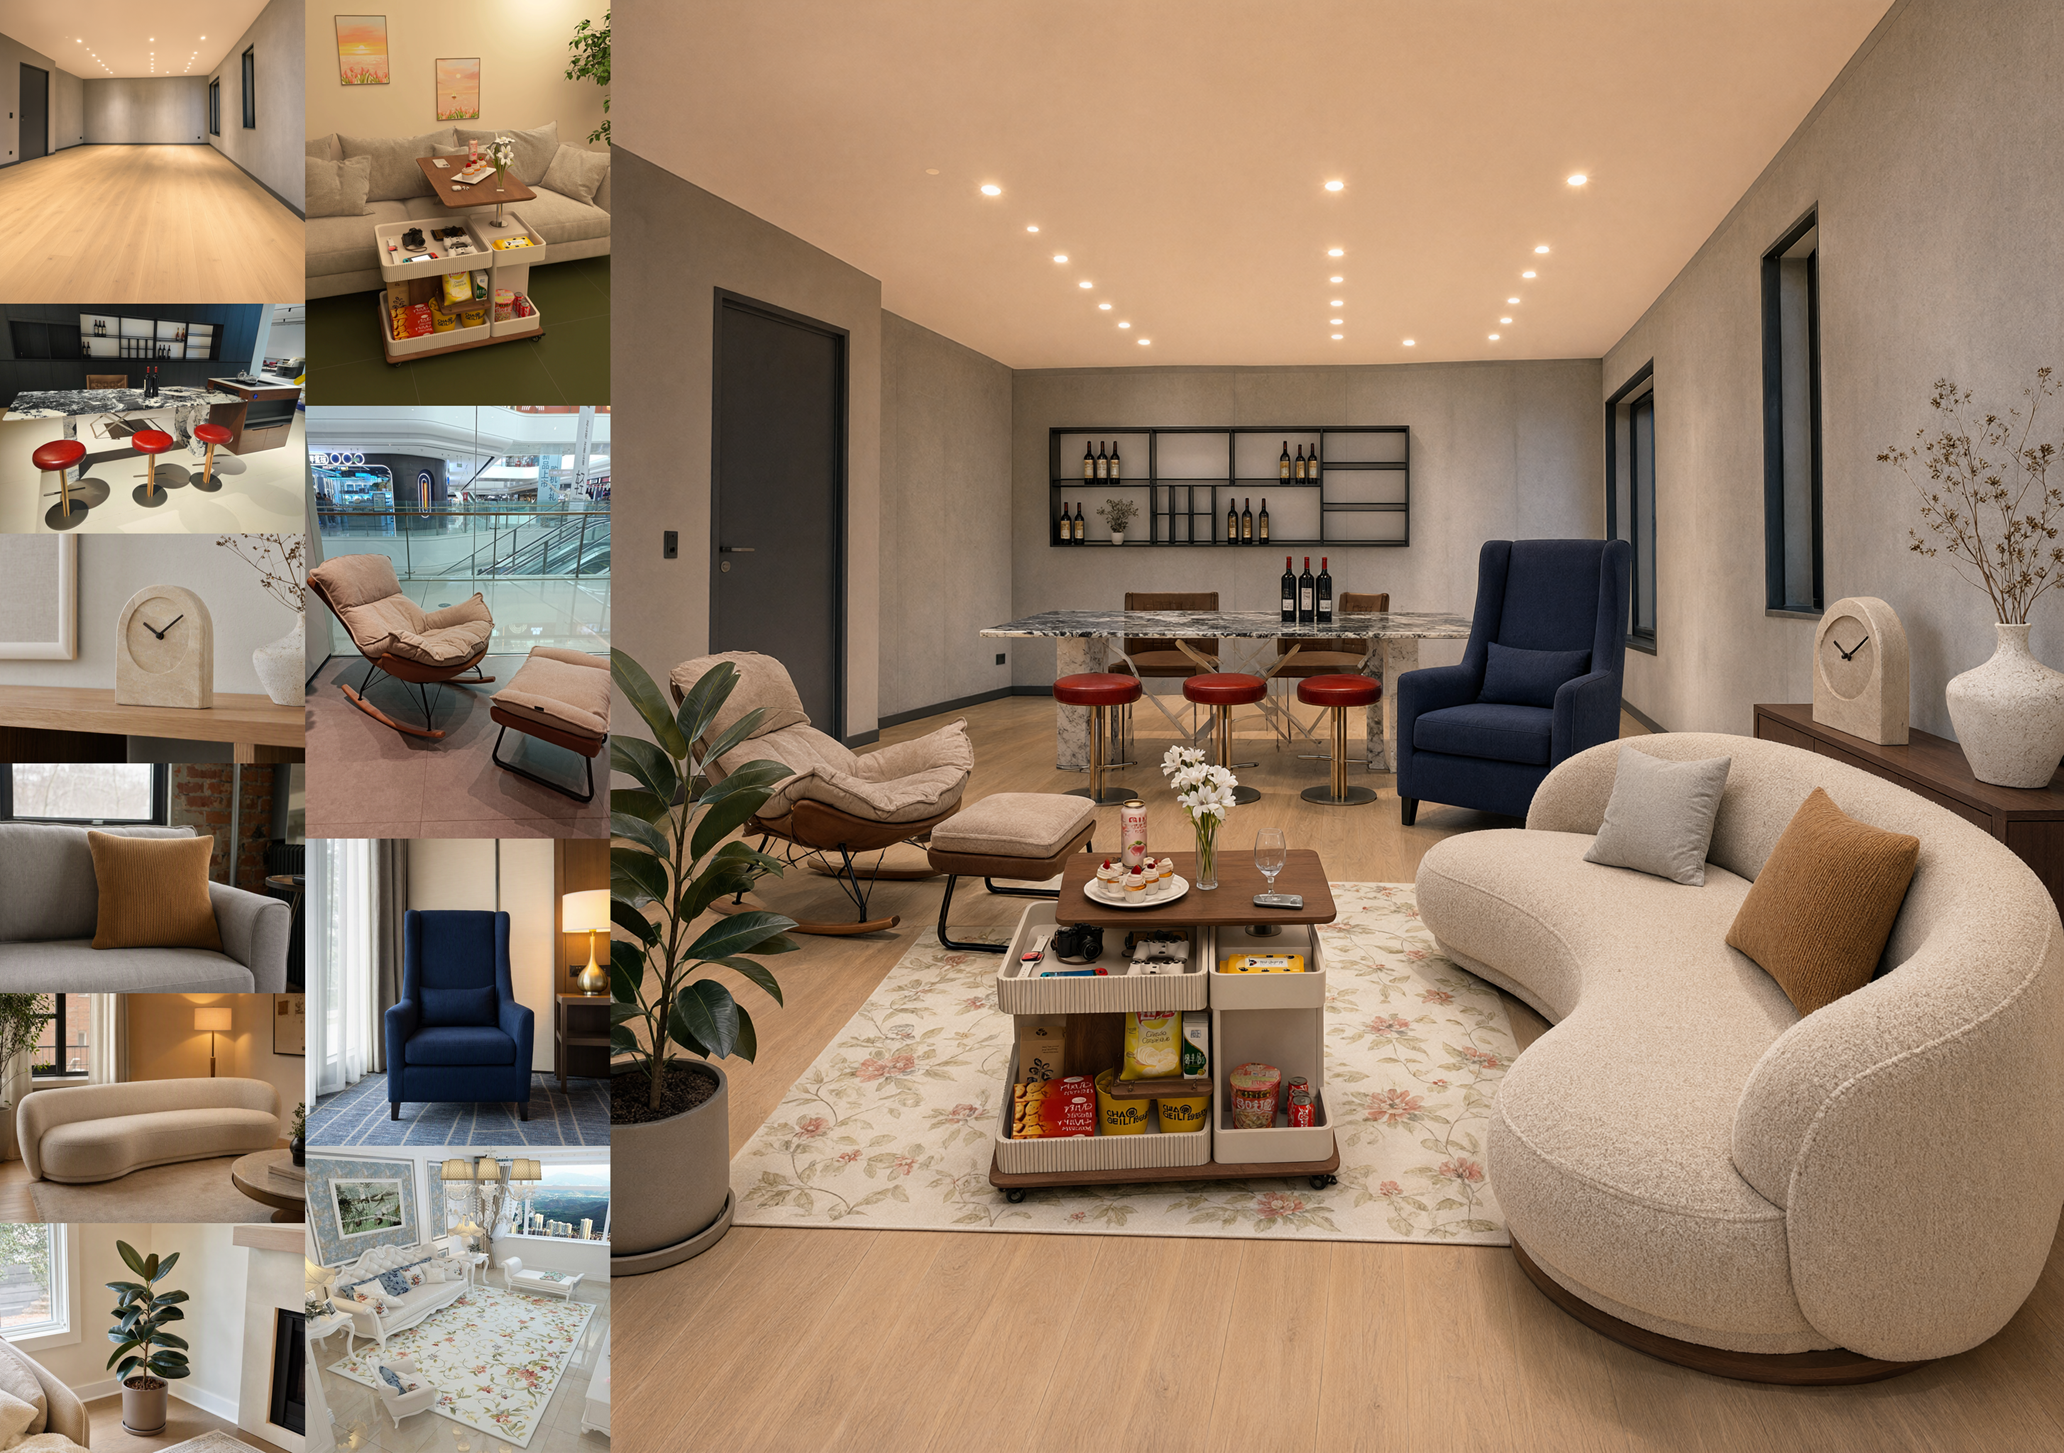
Esempio 15: istruzioni a colori disegnate attorno a un gatto. Input per indicazioni locali tramite annotazioni disegnate.
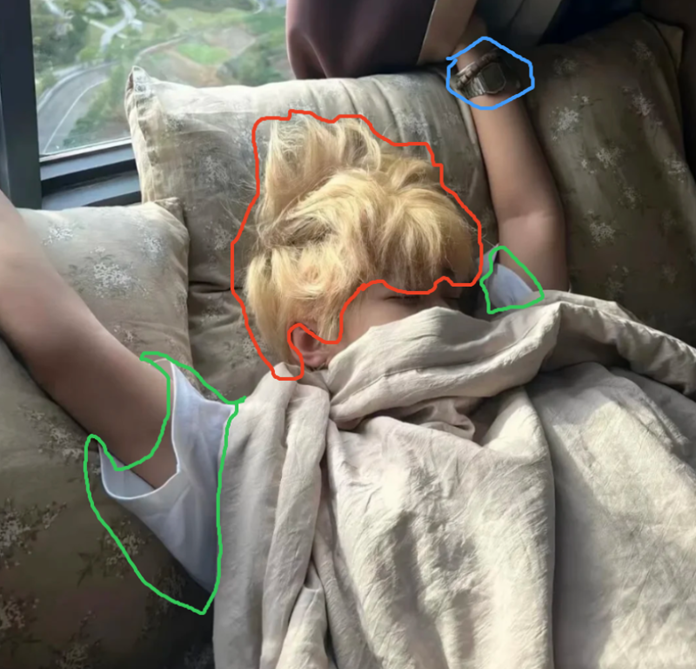
Editing locale, maschere e compositing
Esempio 16: modifica del solo gatto nell'area indicata. Sostituisce il soggetto mantenendo letto e persona.
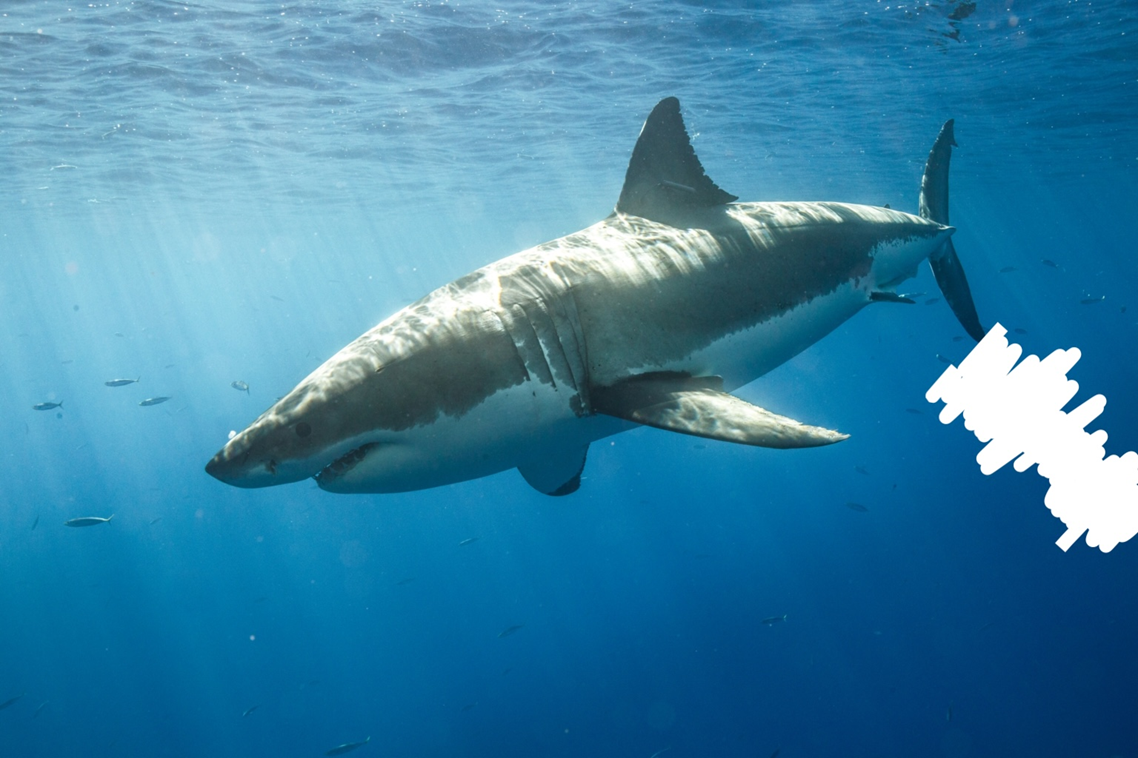
Esempio 17: squalo sott'acqua con istruzioni locali. Input di editing con indicazioni disegnate direttamente sul soggetto.
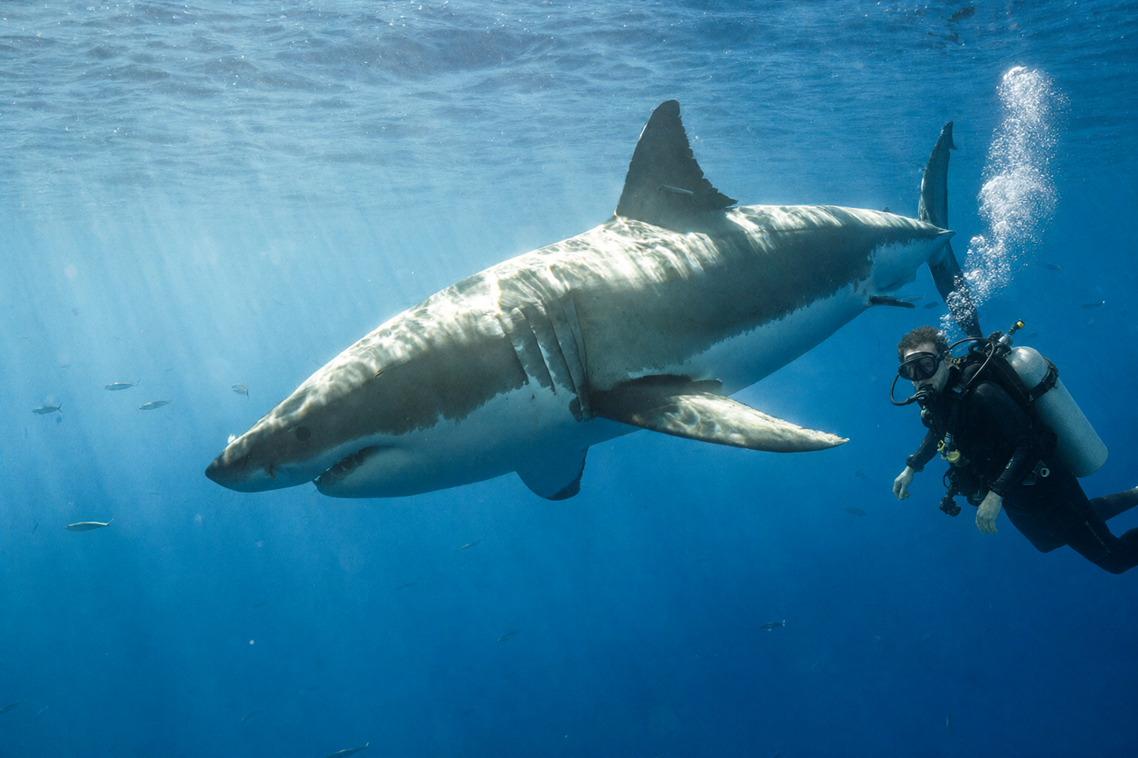
Esempio 18: scena subacquea con sub aggiunto. Compositing che armonizza luce e scala sott'acqua.
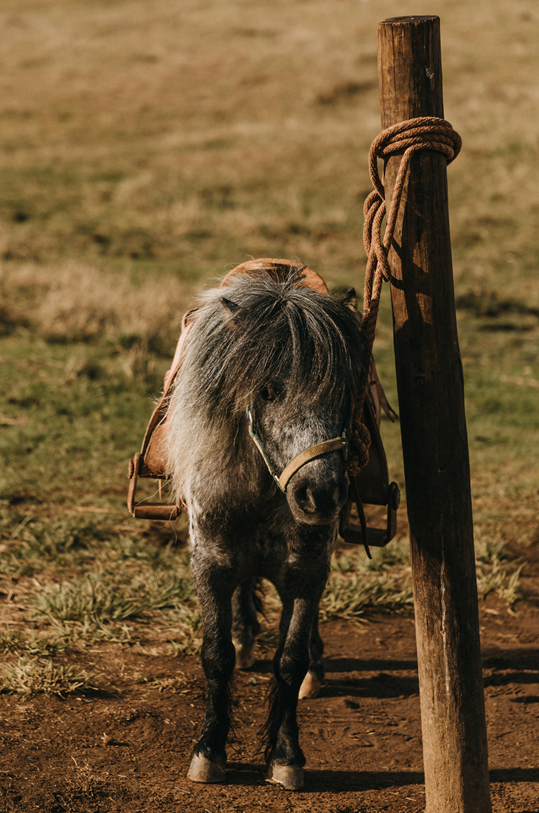
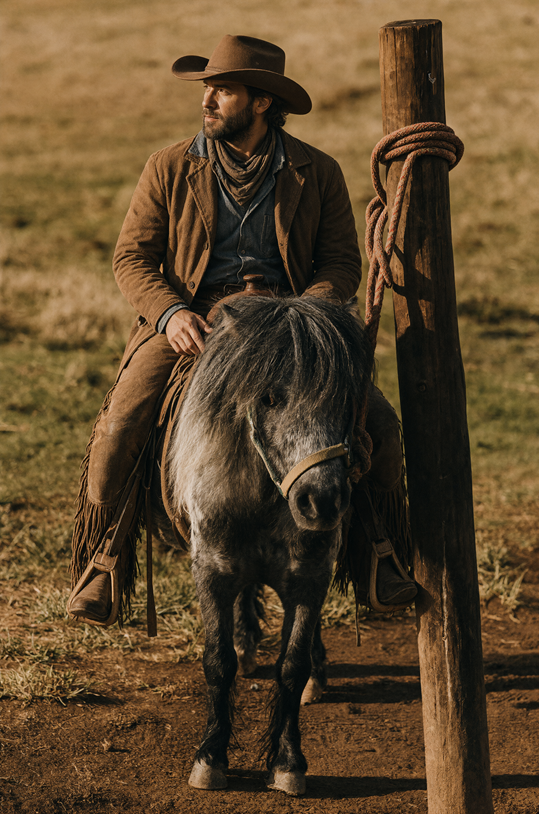
Esempio 19: immagine originale di una persona su un asino. Foto di riferimento per l'editing con maschera.
Esempio 20: maschera che indica la persona e l'asino. Un metodo alternativo che mostra in bianco e nero l'area da modificare.
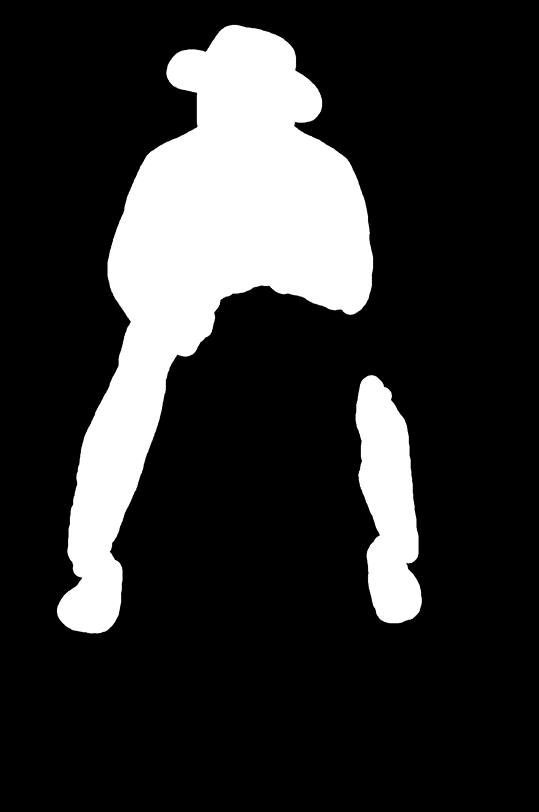
Riposizionamento delle persone e preservazione del volto
Esempio 21: risultato dell'editing di una persona con maschera. Permette di confrontare anche l'integrazione con lo sfondo erboso.
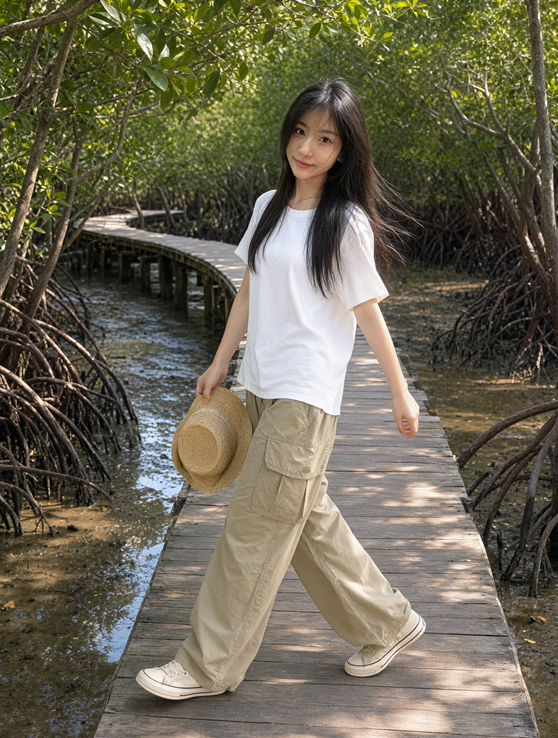
Esempio 22: ritratto per riferimento del volto. Immagine base per la successiva generazione a figura intera in un nuovo ambiente.
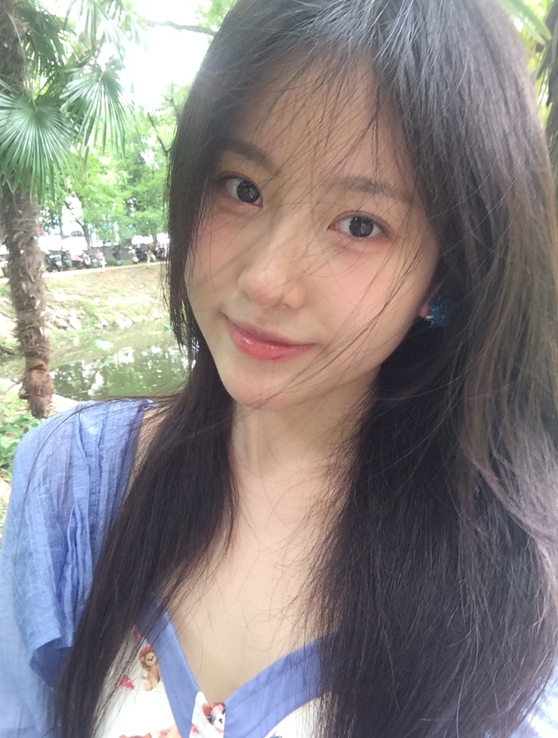
Esempio 23: sviluppo della persona di riferimento in una foto a figura intera all'aperto. Trasferisce volto e abiti in una nuova composizione.
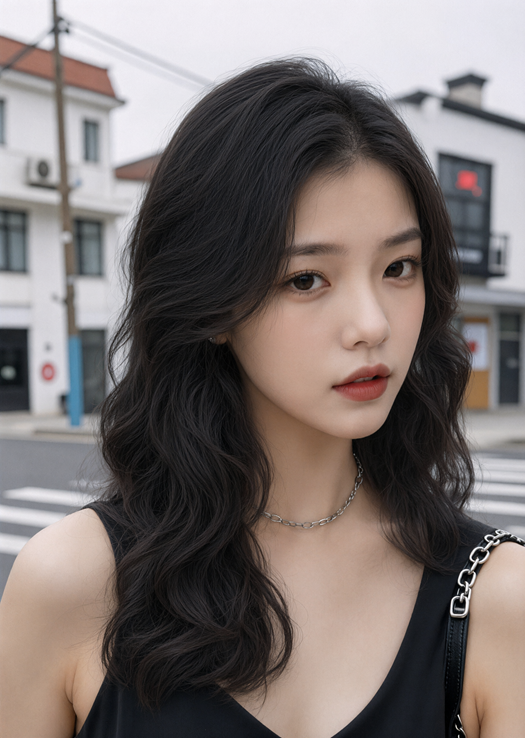
Esempio 24: foto del viso quasi frontale. Input per l'editing dell'acconciatura.
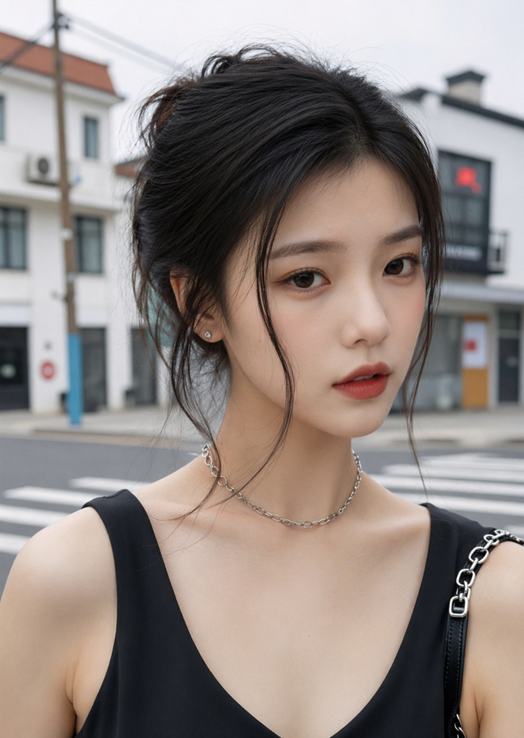
Esempio 25: foto del viso con acconciatura modificata. Mantiene lineamenti e sfondo, allungando solo i capelli.
Pose, scene e fotografie di prodotto
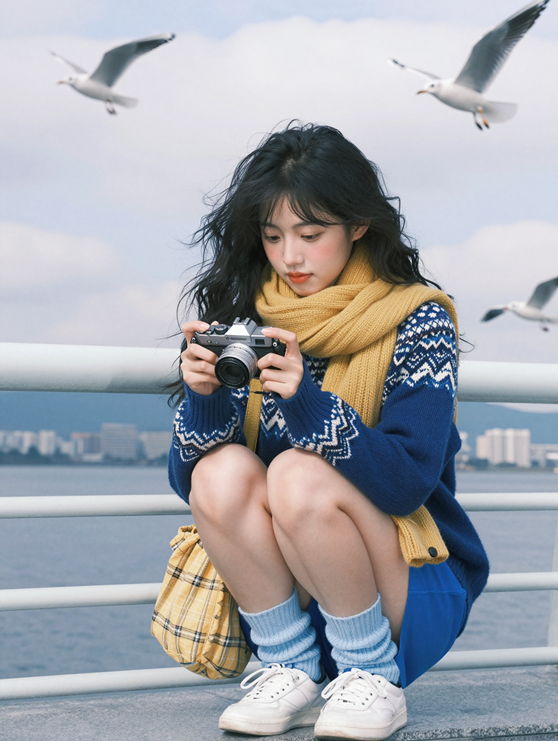
Esempio 26: persona accovacciata in un porto. Include una posa complessa, oggetti di scena e sfondo lontano.
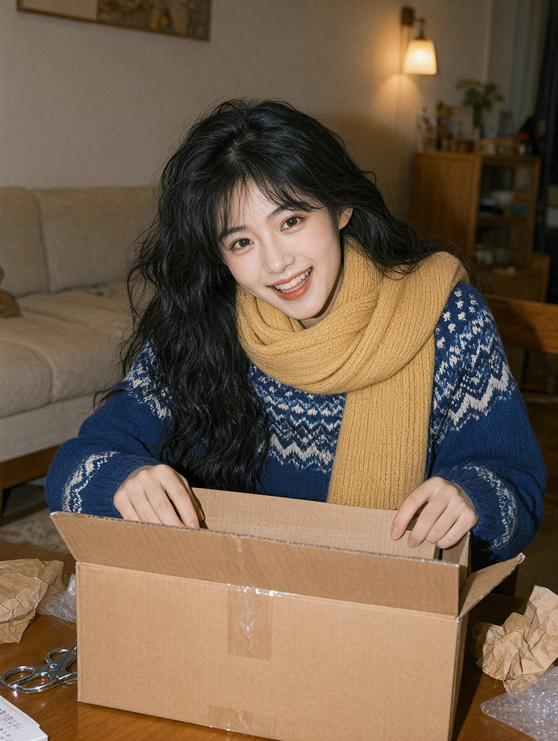
Esempio 27: persona che apre una scatola al chiuso. Composizione utile per osservare dita, scatola e sovrapposizione del corpo.
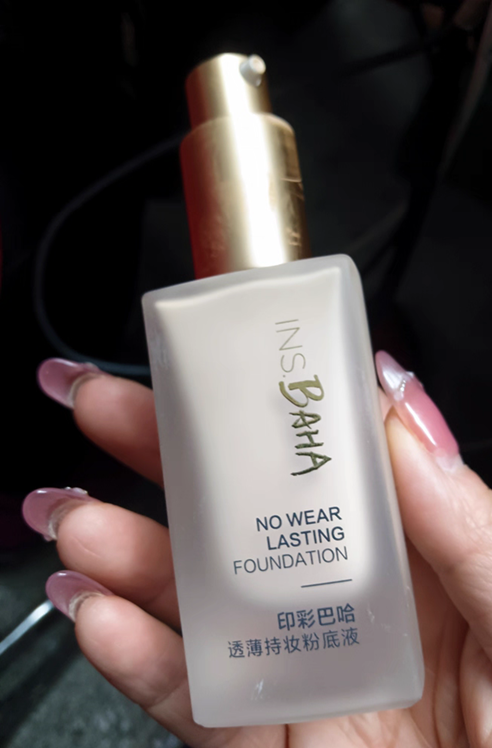
Esempio 28: cosmetico tenuto in mano. Fotografia di prodotto con testo dell'etichetta e contatto con le dita.
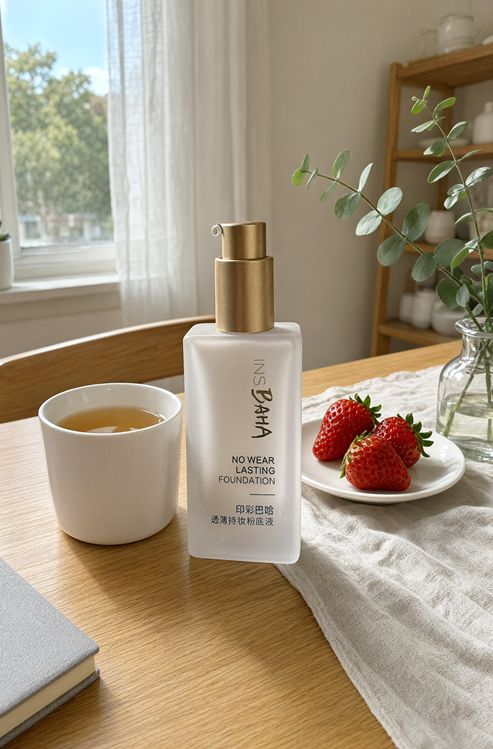
Esempio 29: cosmetico trasformato in una foto prodotto d'interni. Aggiunge luce naturale, tavolo e piccoli elementi alimentari.
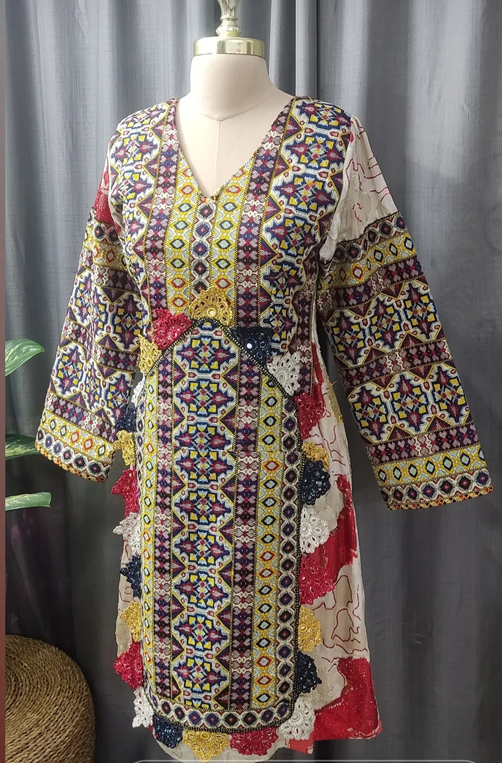
Esempio 30: indumento su un manichino. Riferimento di prodotto per la successiva generazione di prova su persona.
Prova virtuale e compositing di prodotti indossati
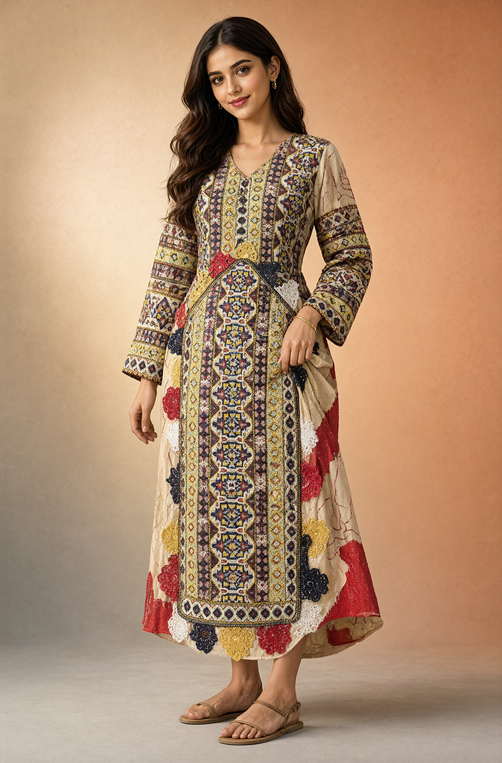
Esempio 31: indossare un capo di riferimento su una persona. Adatta motivo, lunghezza e silhouette al corpo umano.
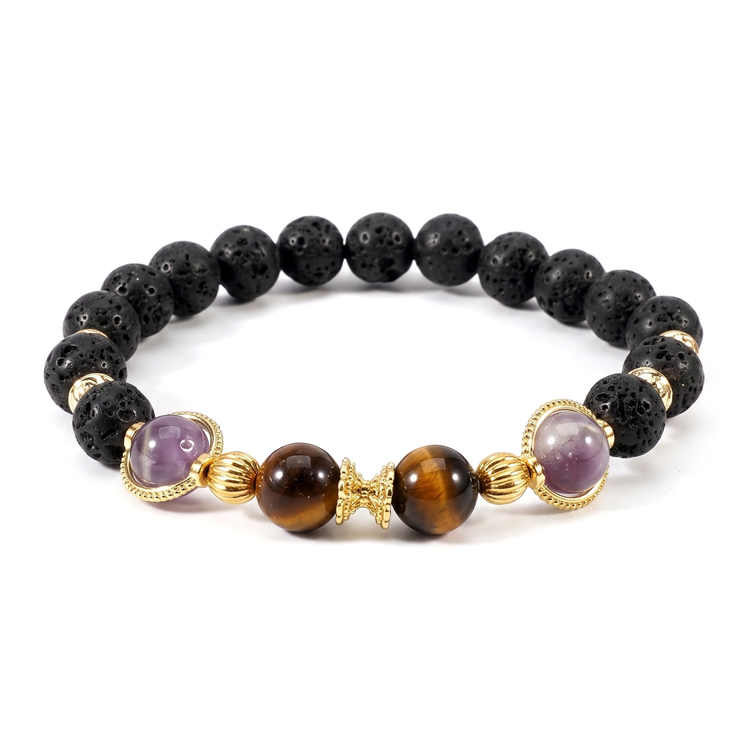
Esempio 32: fotografia di prodotto di un braccialetto singolo. Immagine condizionale per il compositing indossato.
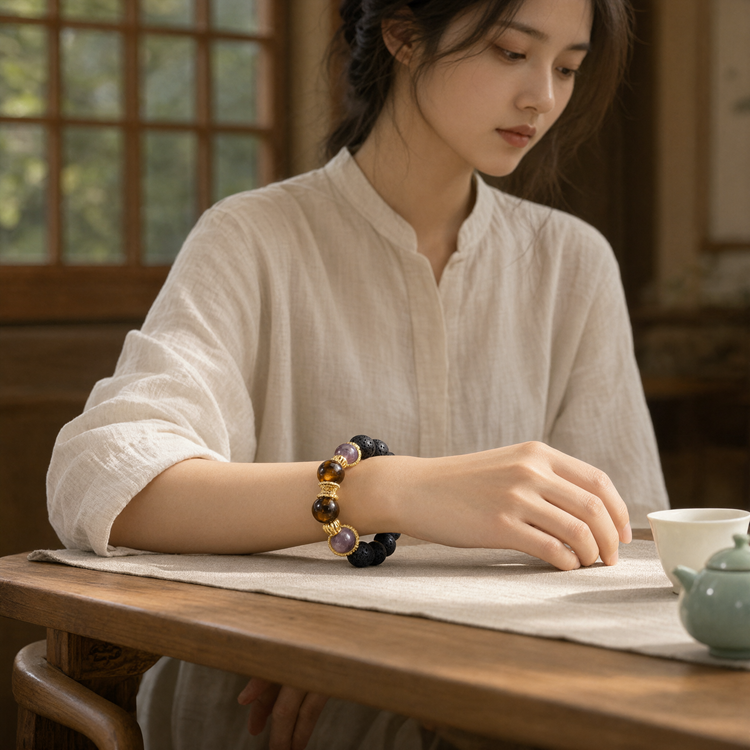
Esempio 33: braccialetto applicato al polso di una persona. Armonizza naturalmente contatto con la pelle e ombre.
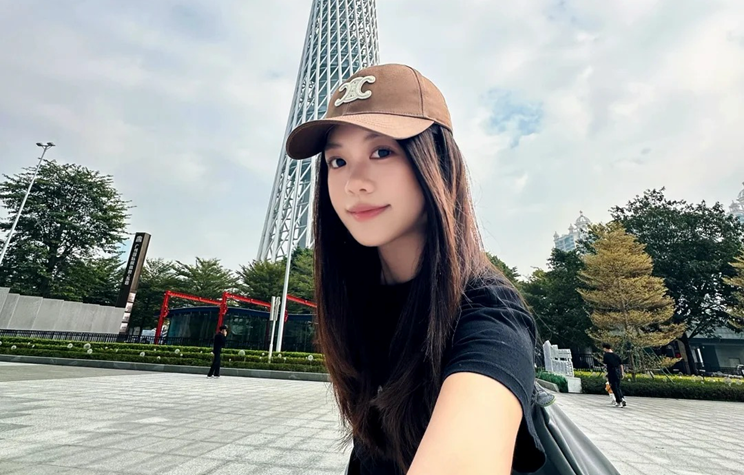
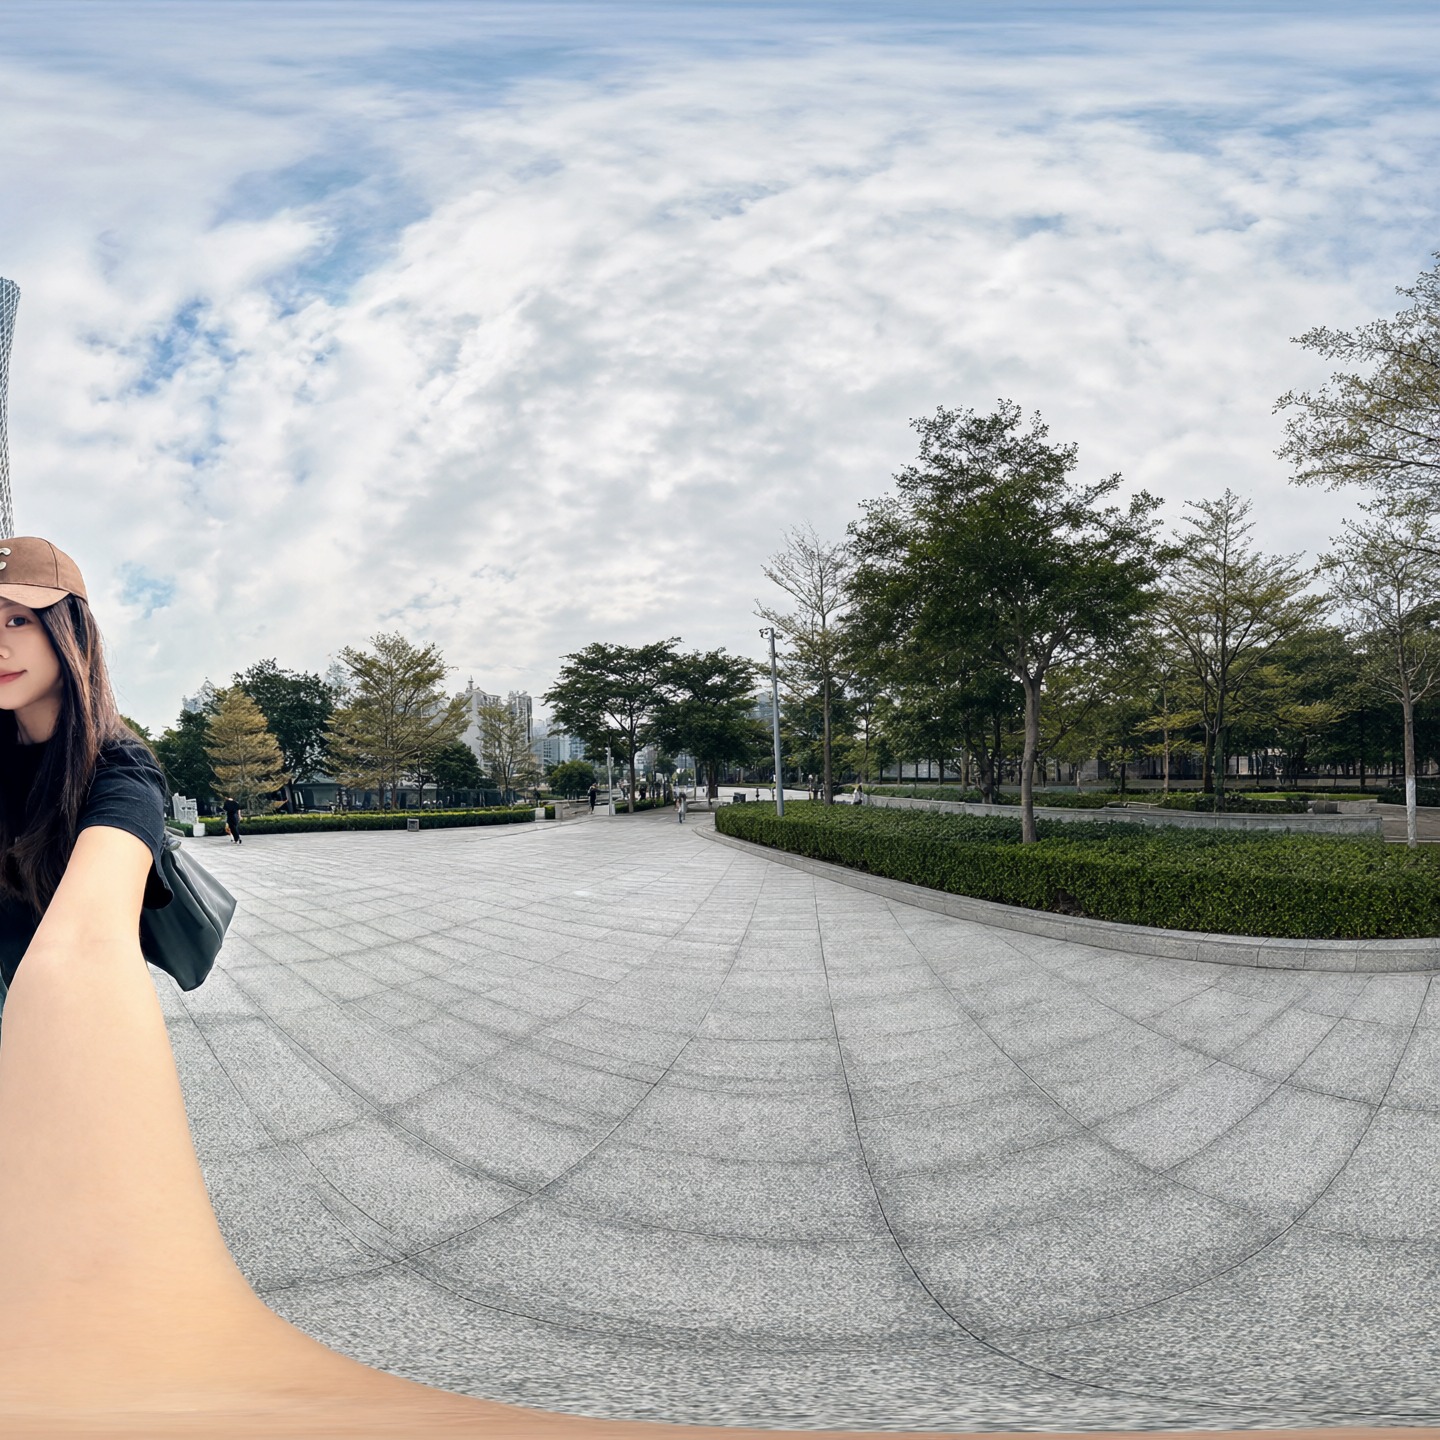
Esempio 34: selfie davanti a una torre. Foto di input per il cambio di punto di vista.
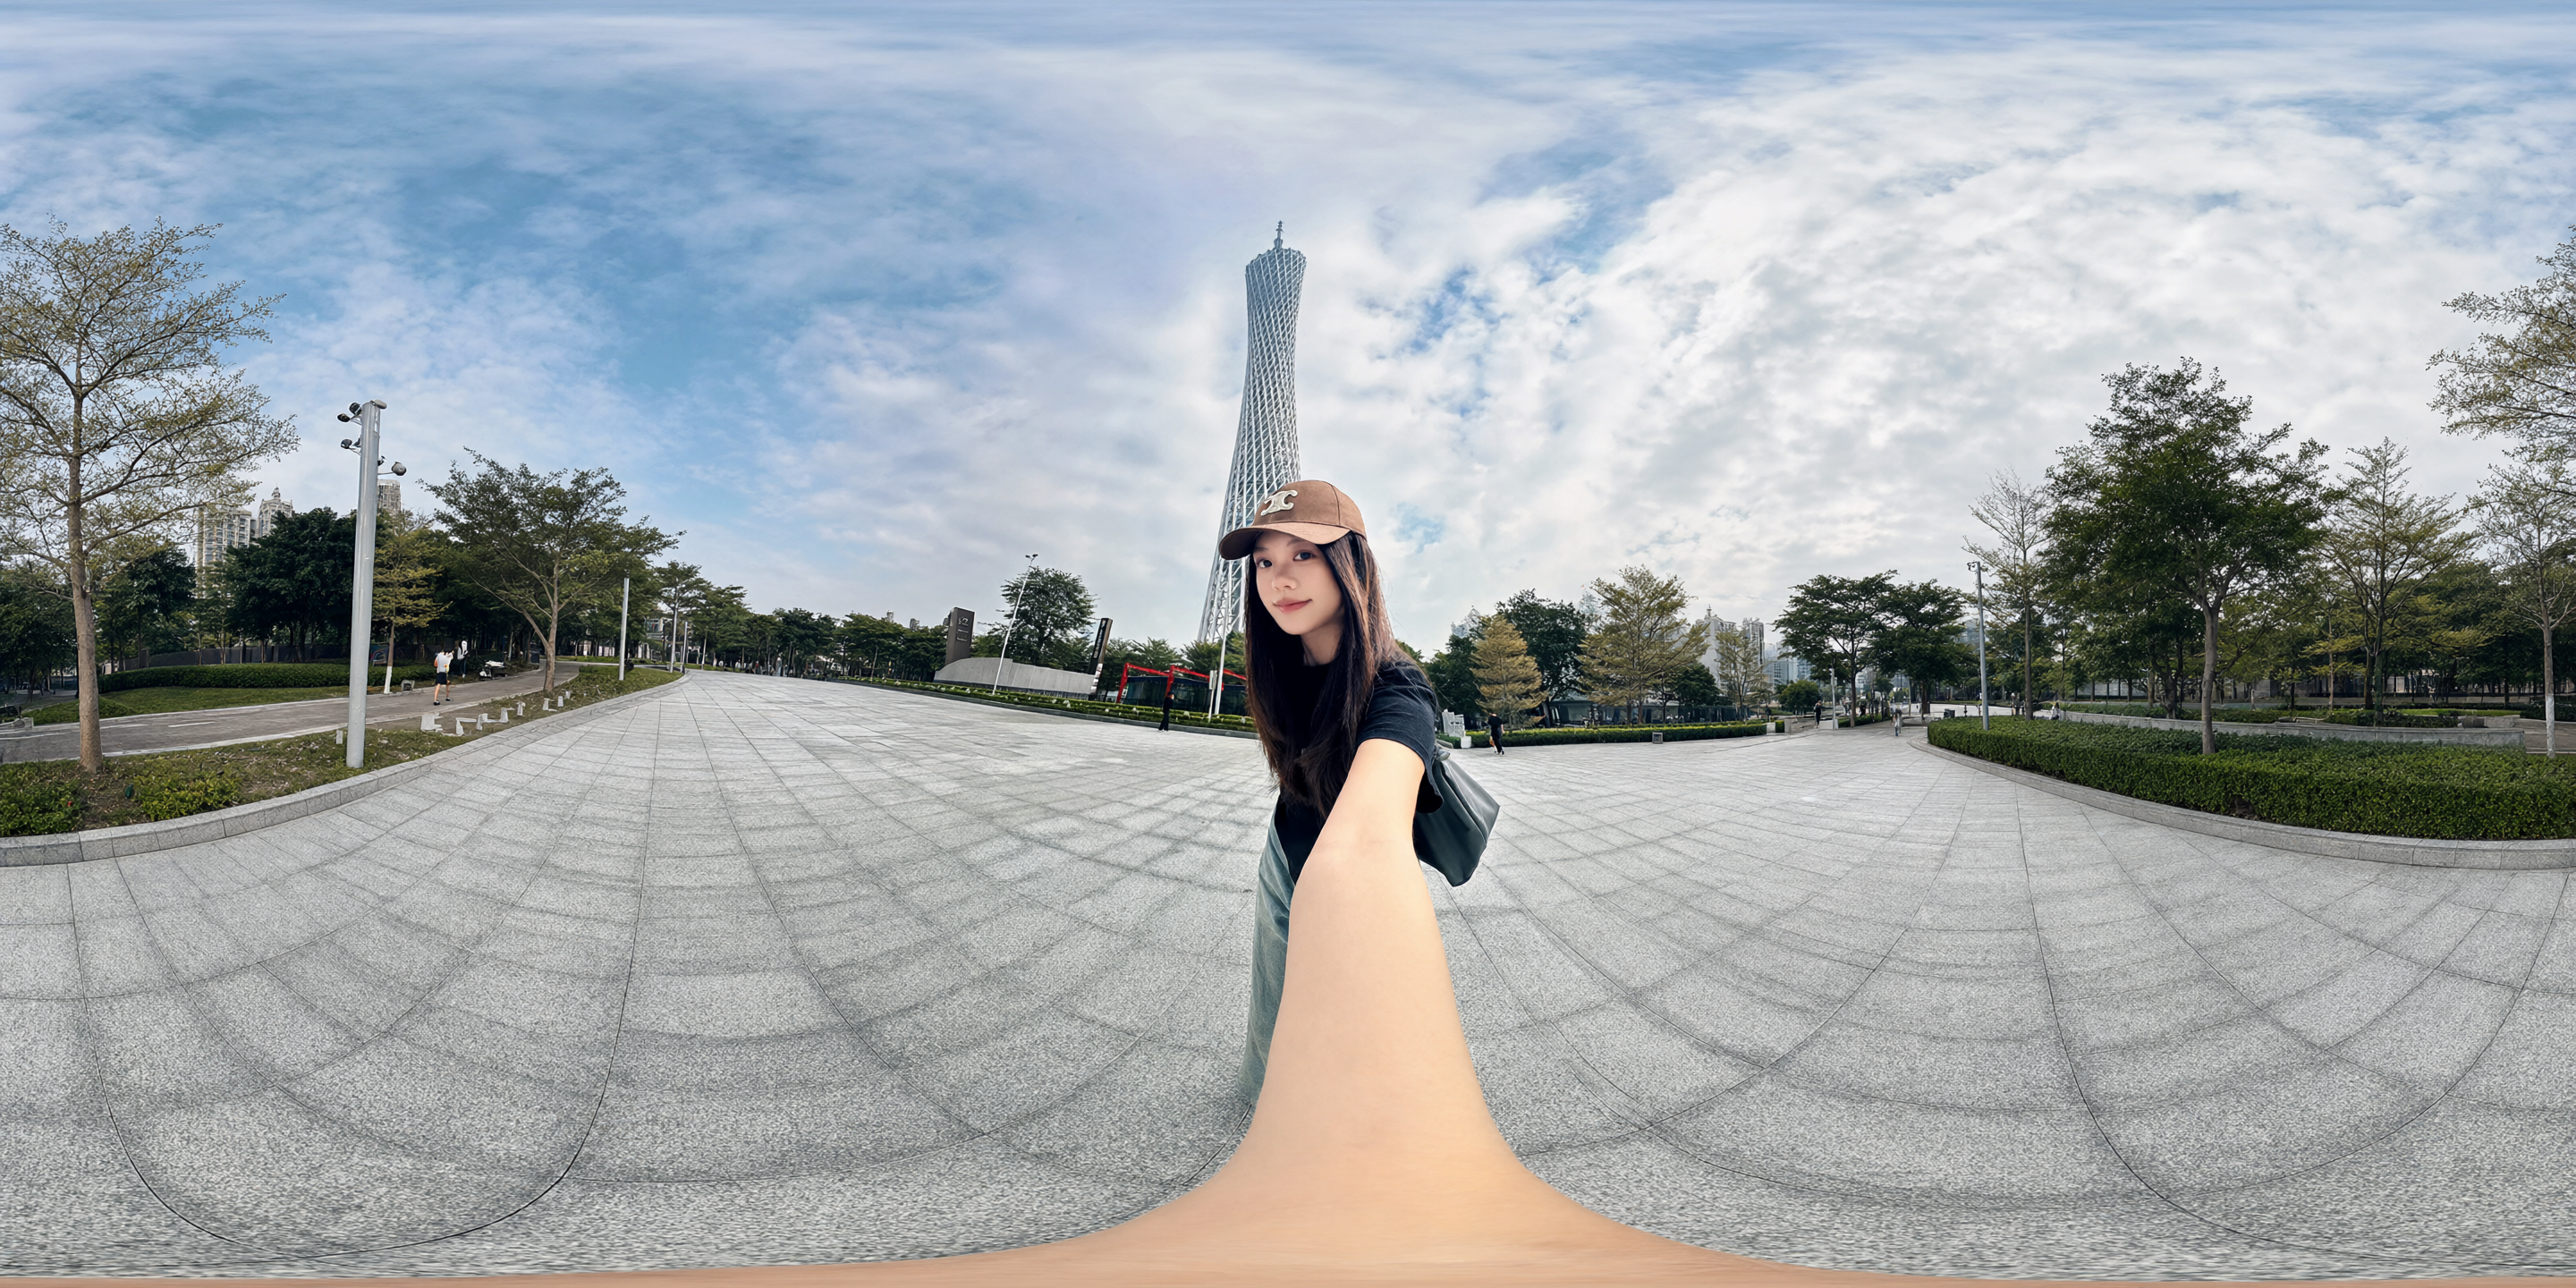
Esempio 35: dal selfie a una prospettiva in terza persona. Ricostruisce la stessa persona e lo stesso luogo con un'inquadratura più ampia.
Character sheet e continuità
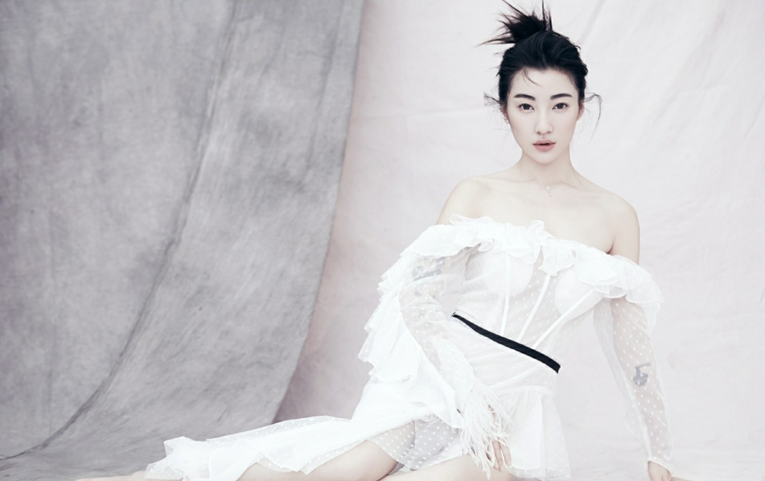
Esempio 36: ritratto di una persona in abito bianco. Input per materiale di riferimento del personaggio.
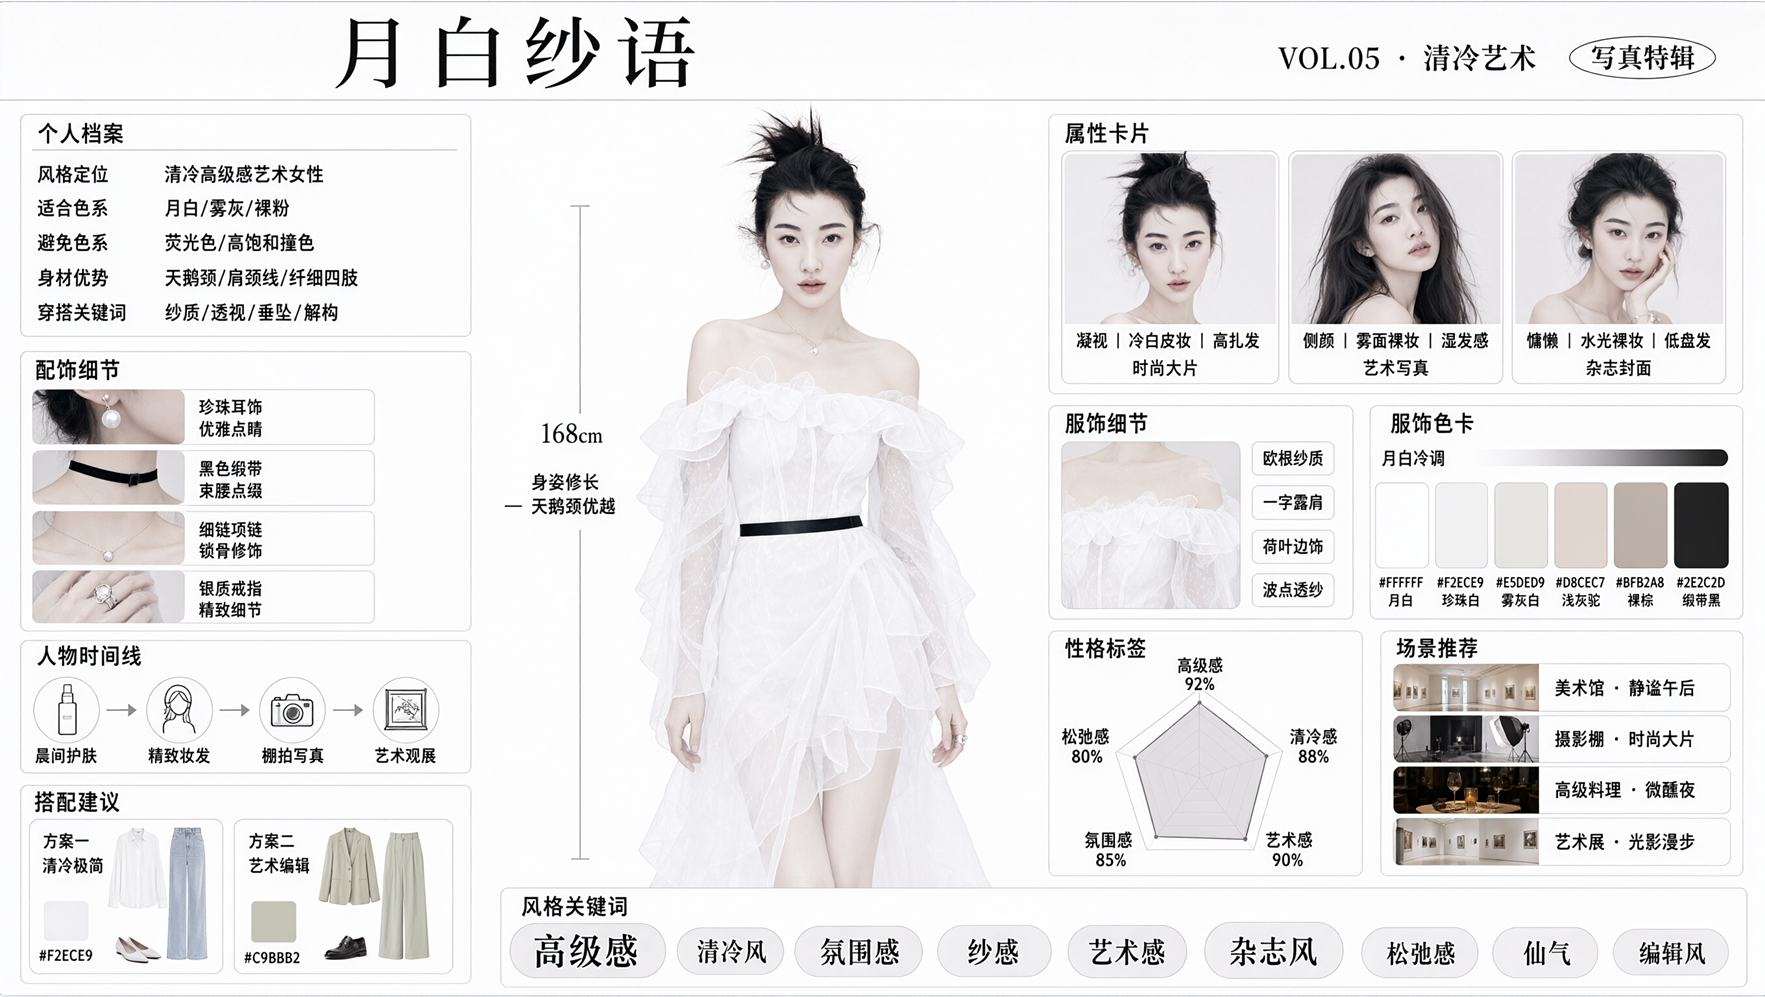
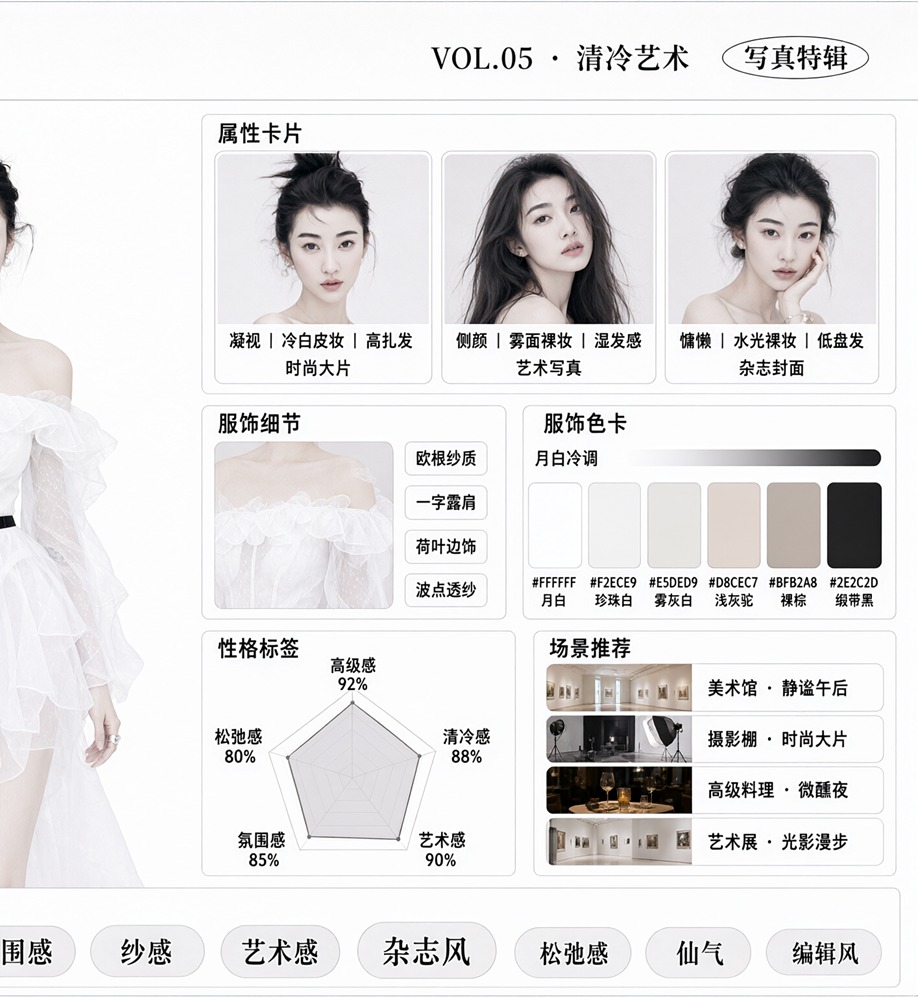
Esempio 37: design sheet che riunisce le informazioni sul personaggio. Integra volto, abiti, accessori e informazioni testuali.
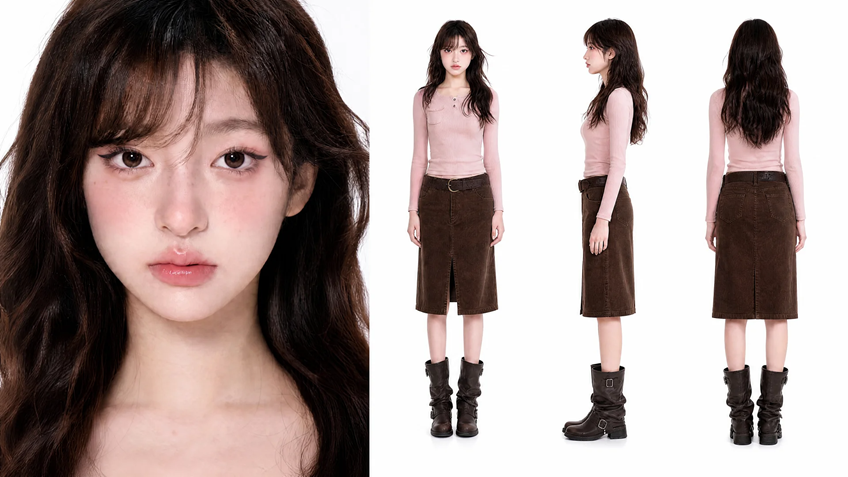
Esempio 38: character sheet con fronte, profilo e retro. Adatto come materiale di riferimento per video e fumetti.
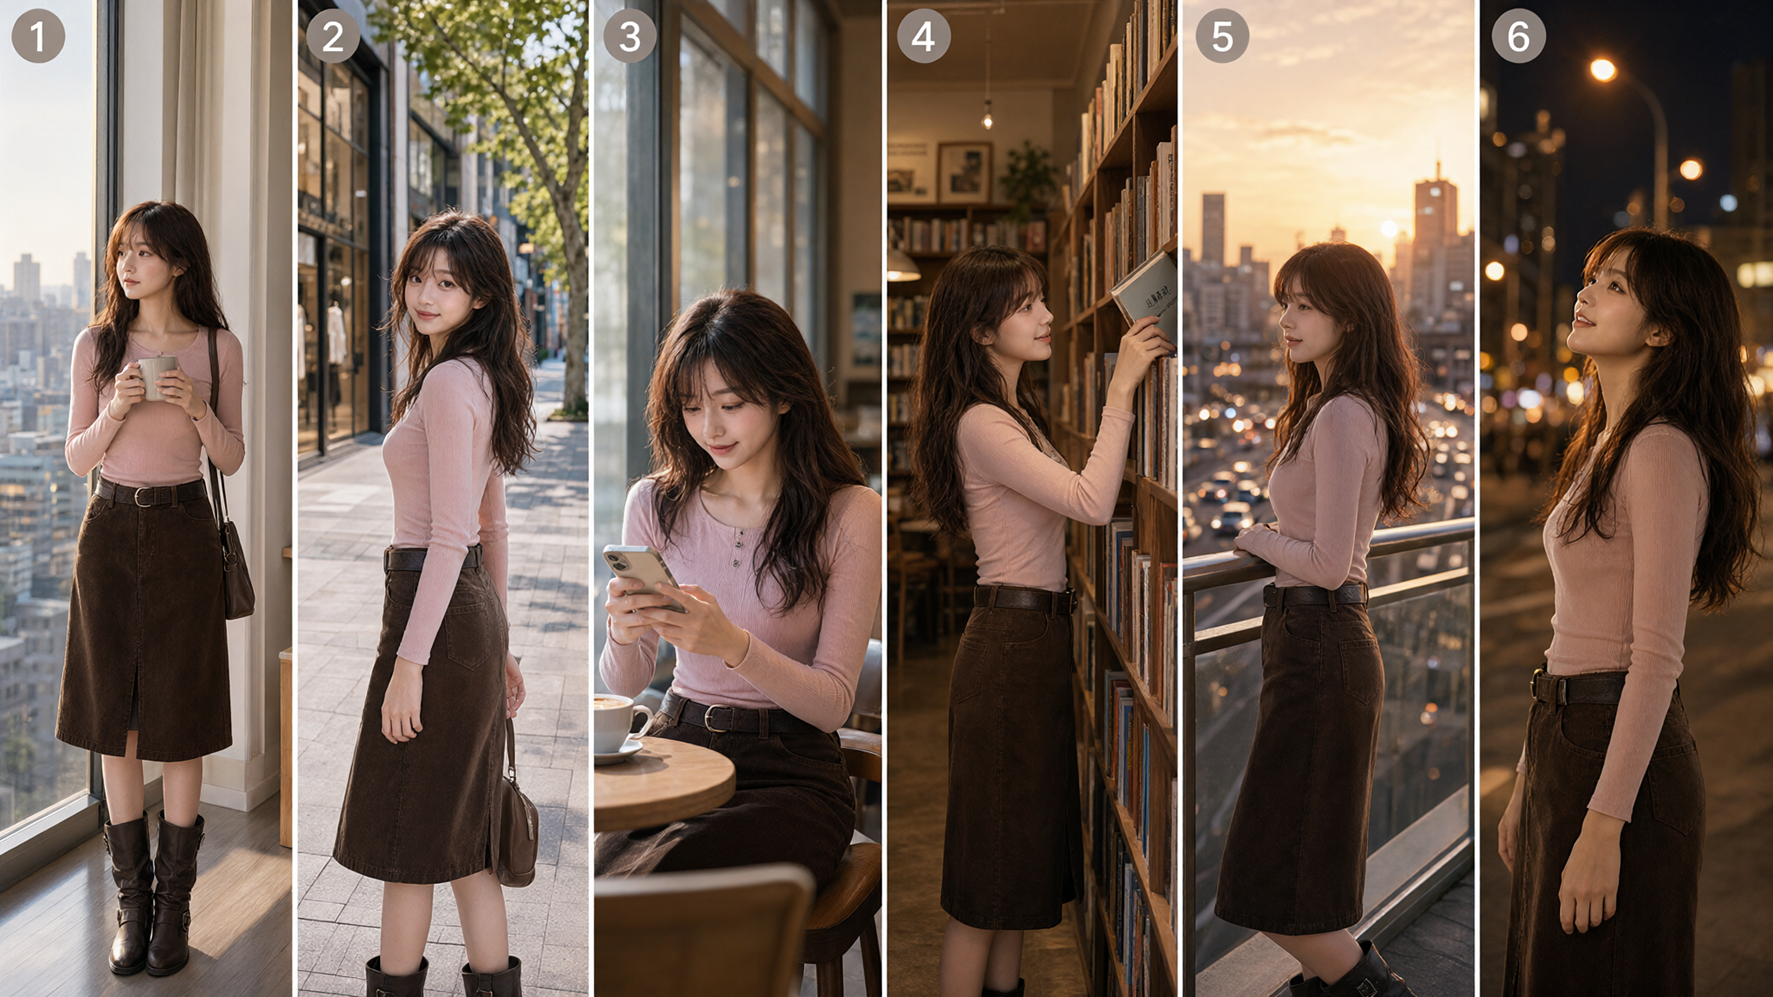
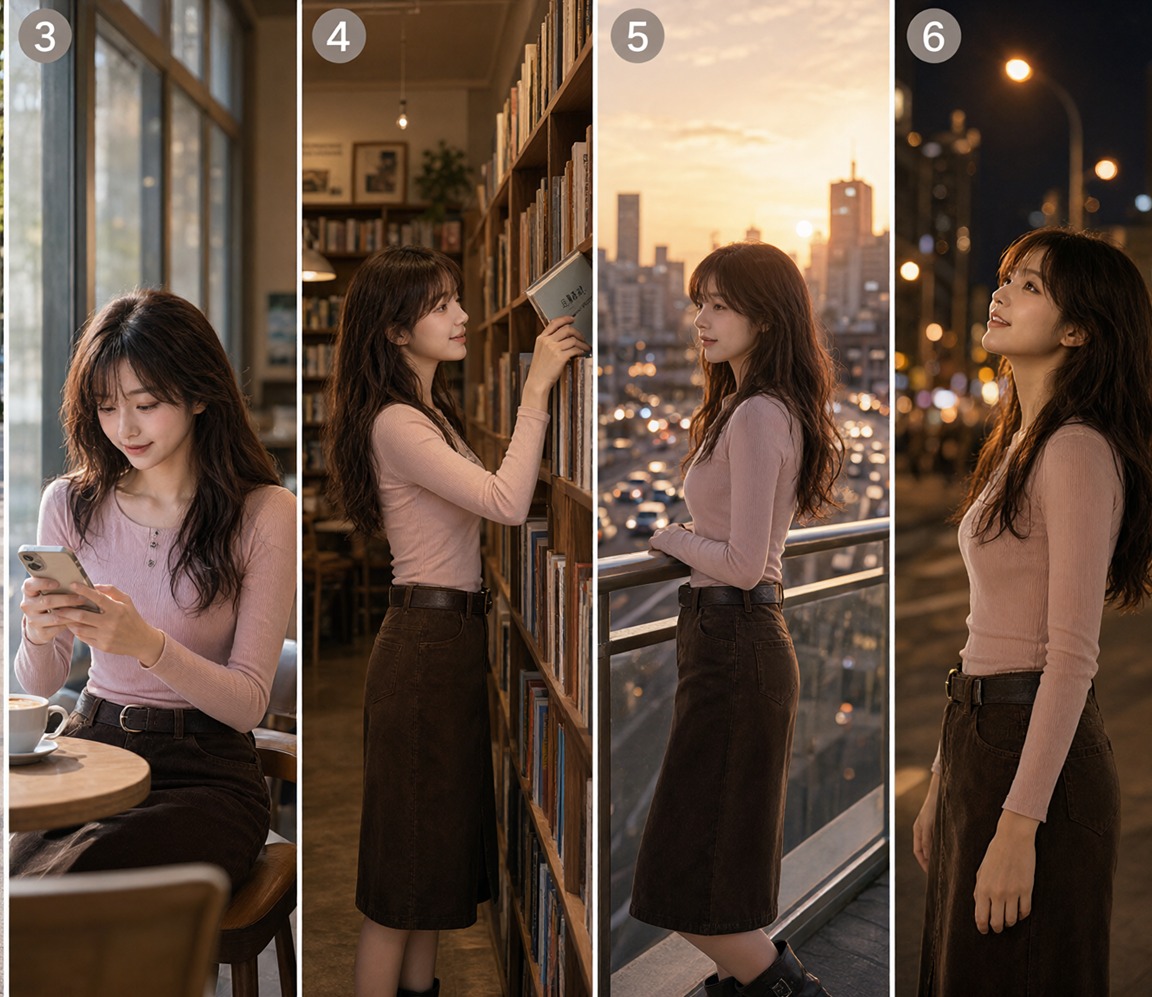
Esempio 39: stessa persona collocata in più scene. Mostra la preservazione di volto e abiti al variare di posa e luogo.
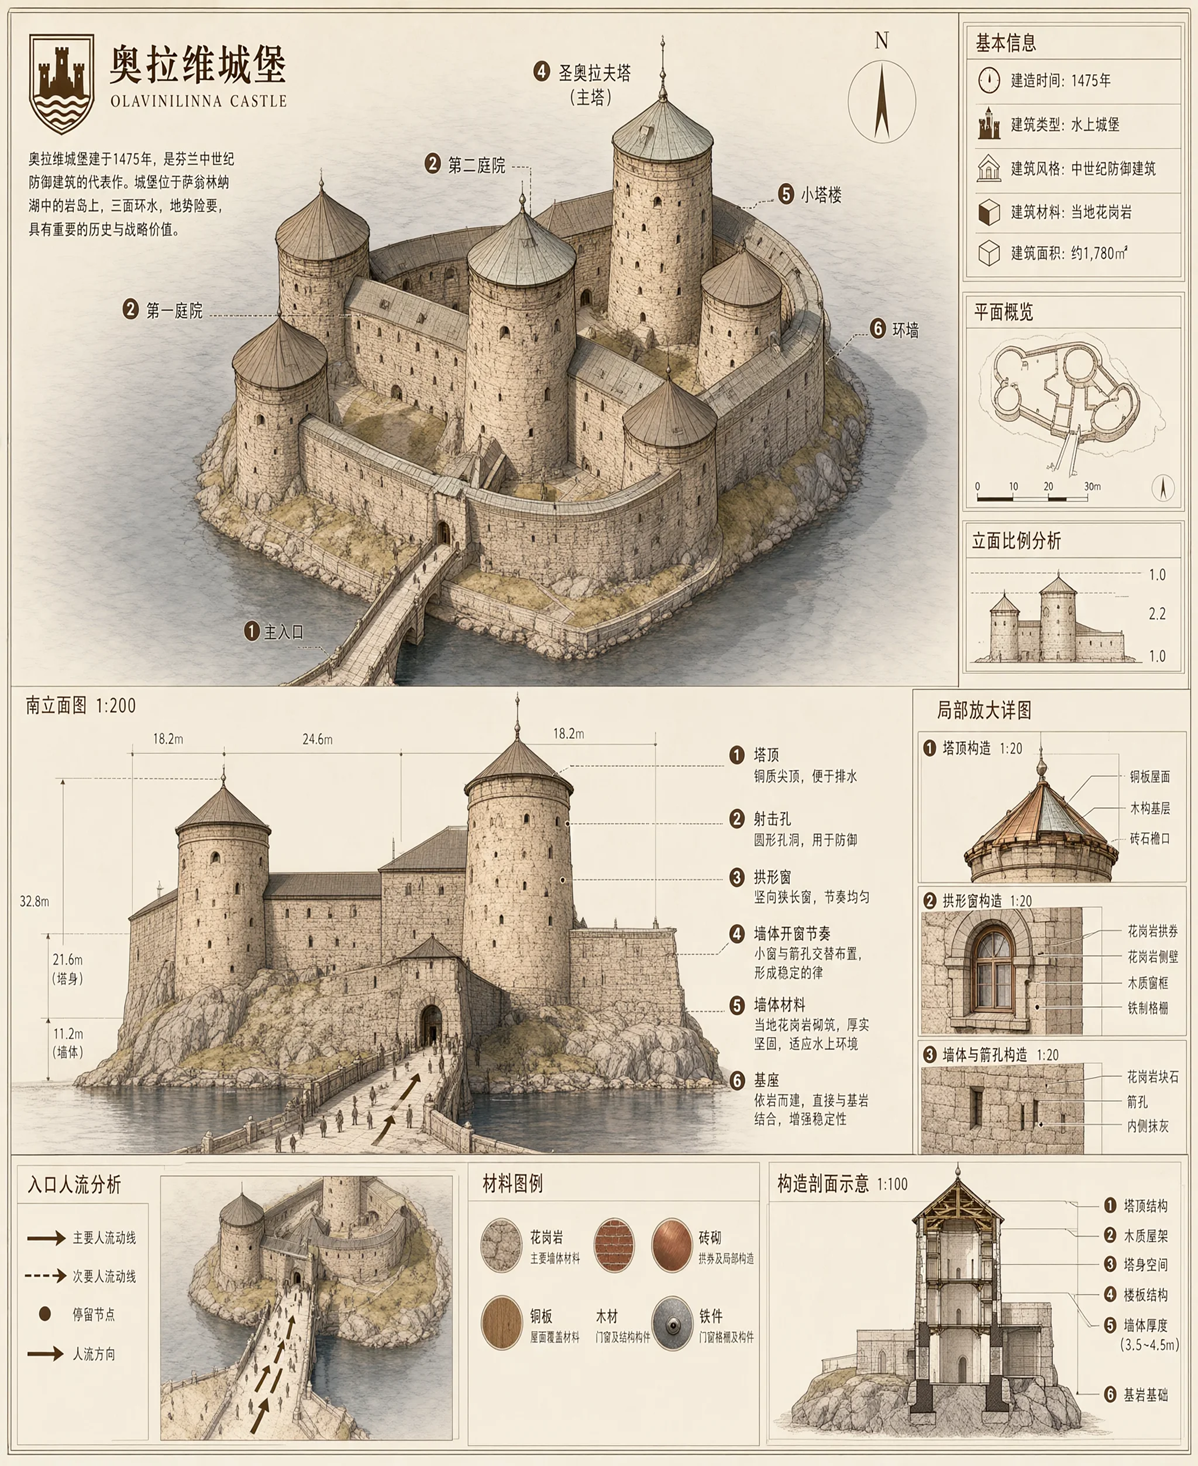
Esempio 40: diagramma esplicativo di un edificio. Generazione di un documento che integra testo, disegno tecnico, campioni di materiali e annotazioni.
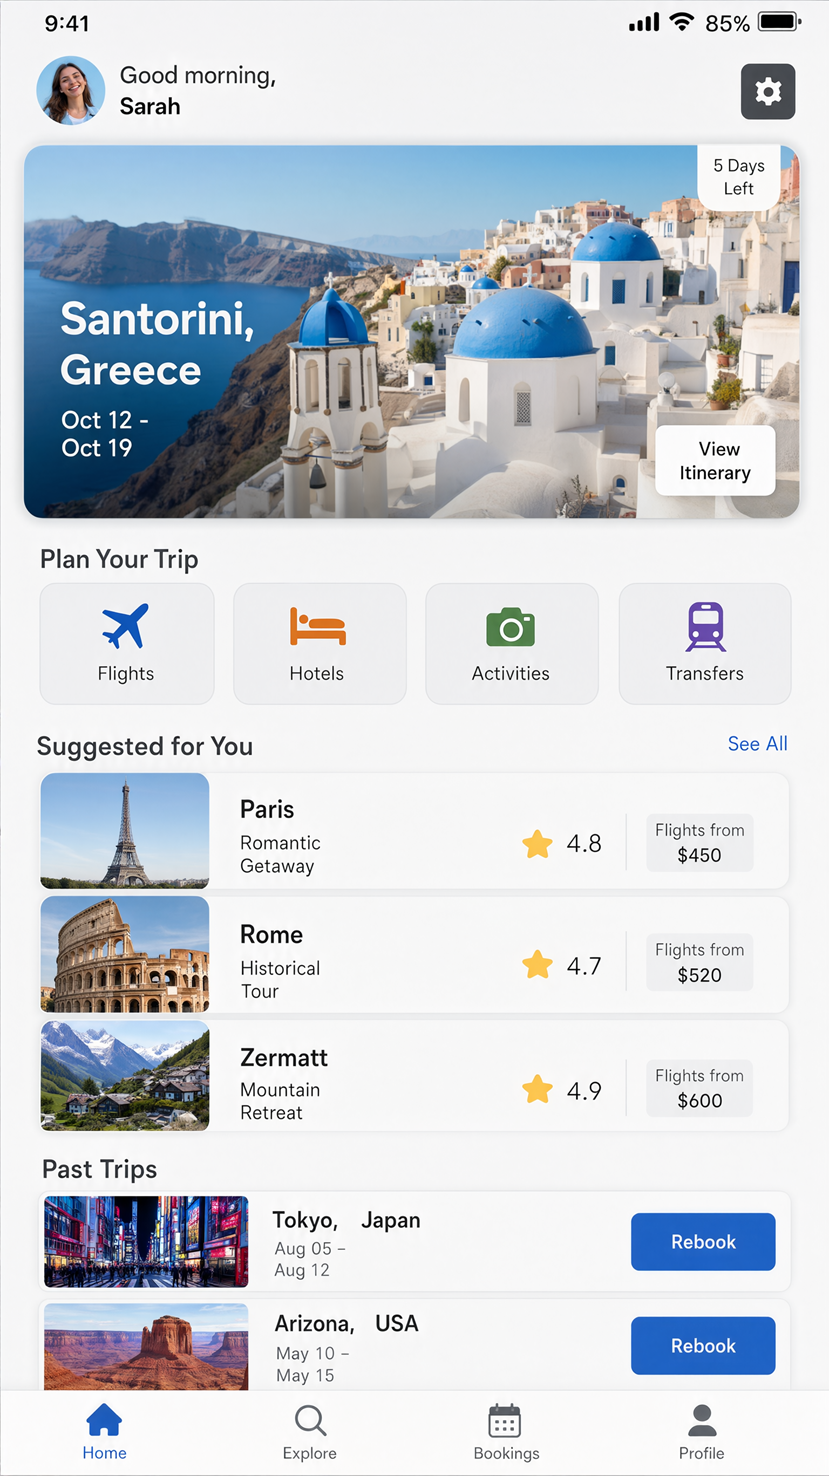
UI, documenti e ritratti naturali
Esempio 41: UI di un'app per prenotazioni di viaggio. Progettazione di schermata con testo piccolo, schede, foto e pulsanti.
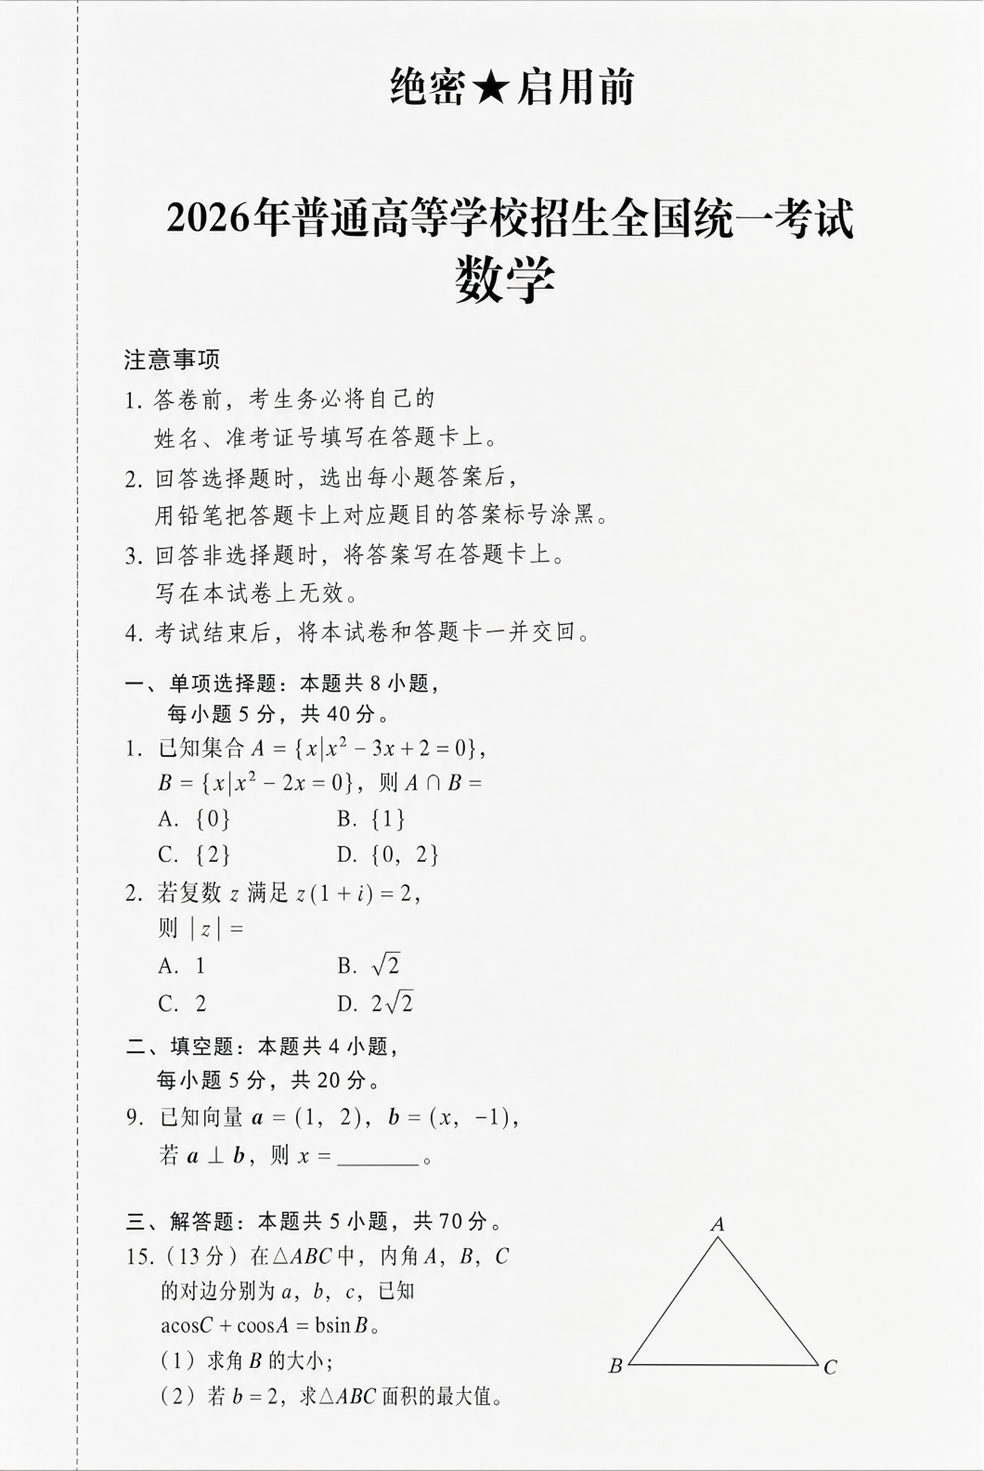
Esempio 42: documento con problema di geometria. Mostra la difficoltà di generare una pagina con testo lungo e forme geometriche.
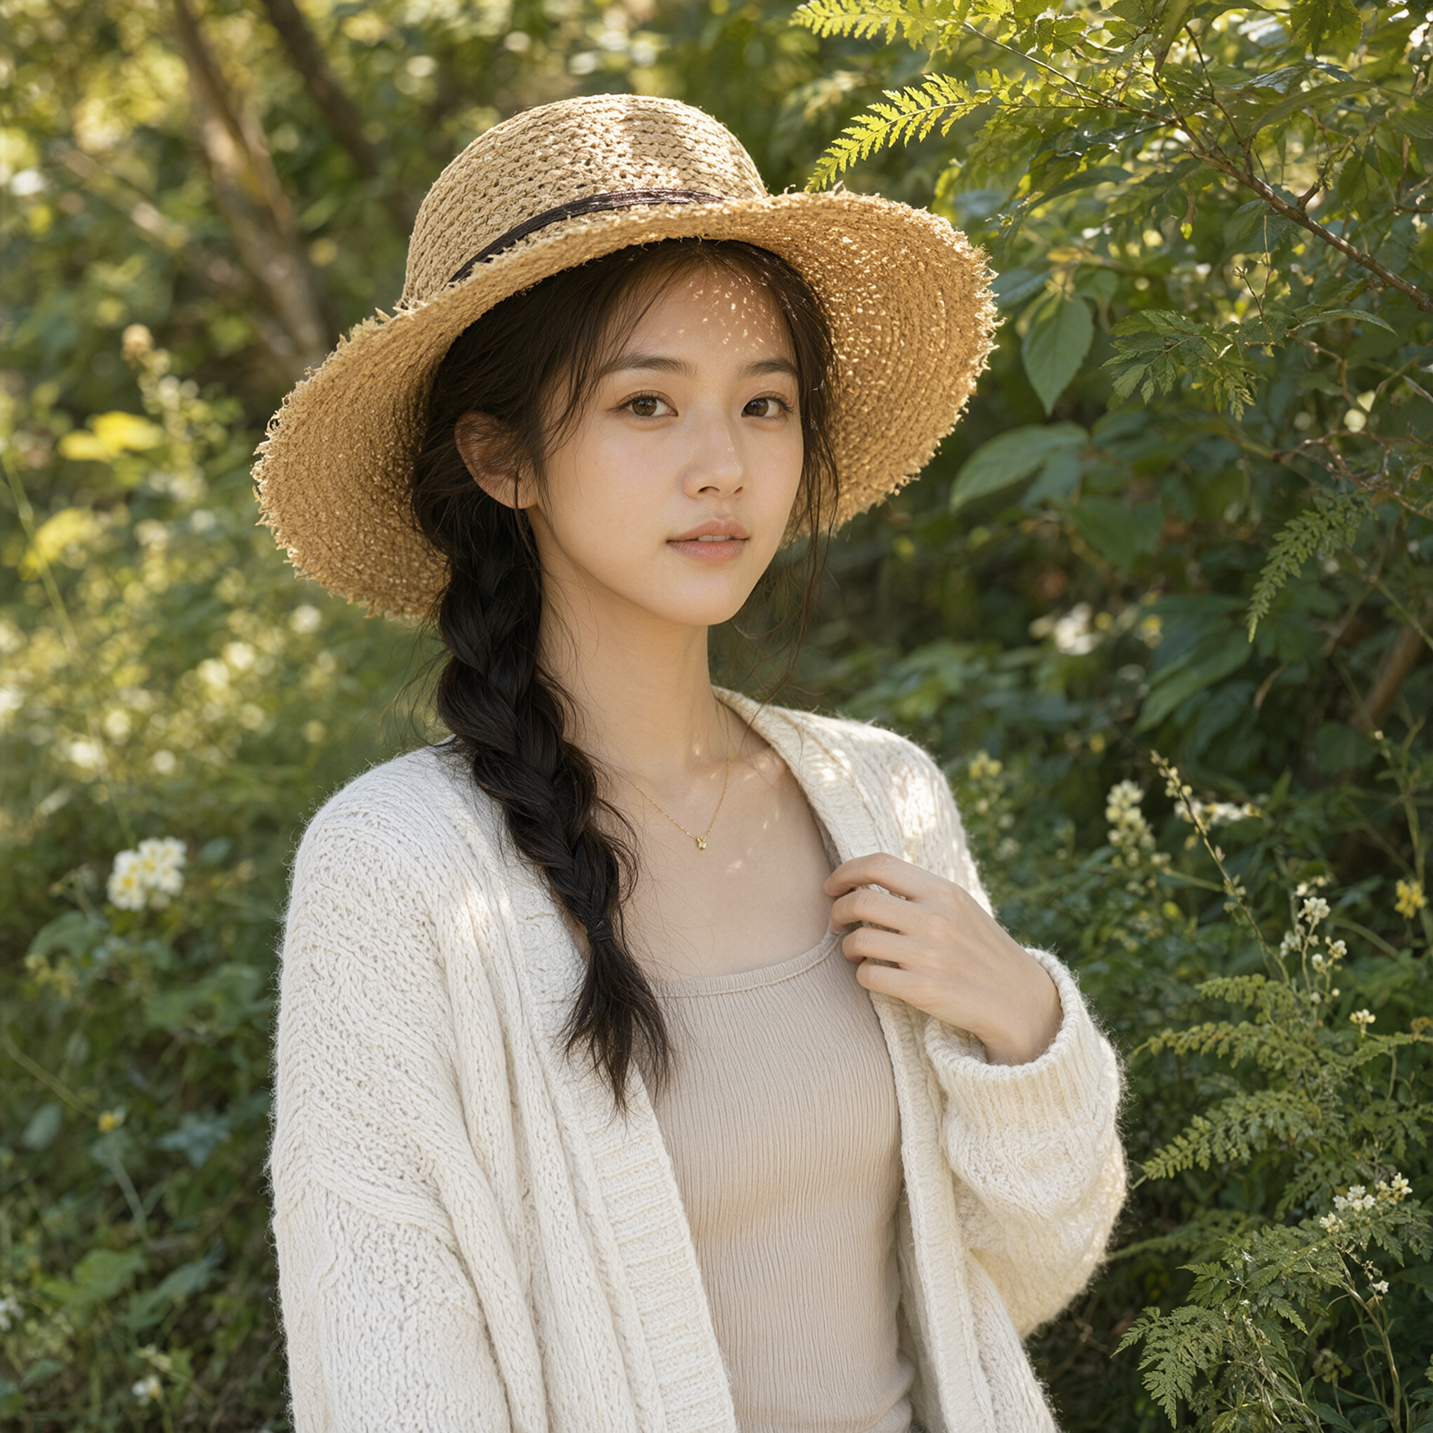
Esempio 43: ritratto all'aperto in luce naturale. Rappresentazione di cappello, capelli e luce filtrata dagli alberi.
Esempio 44: foto di una persona in una marina. Esempio realistico con dettagli di sfondo quali corde, barche e utensili.
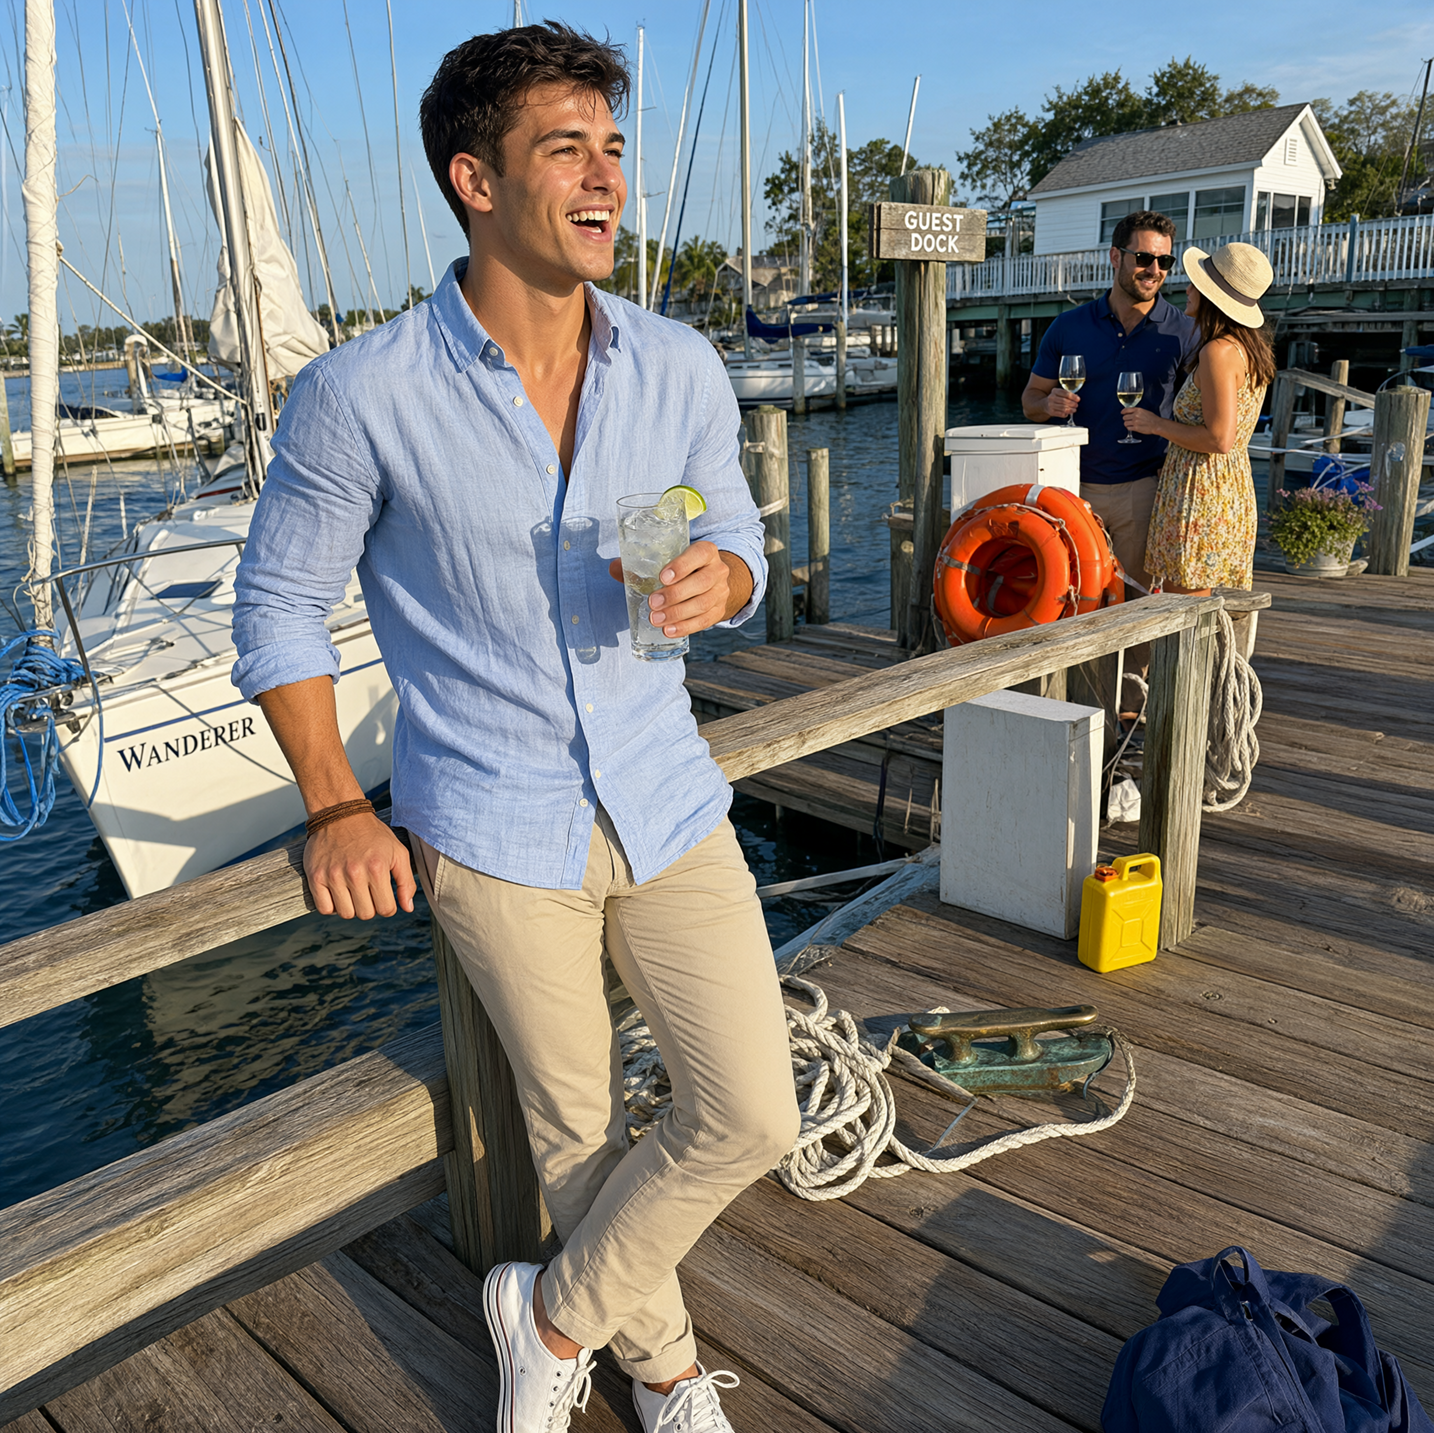
Ingrandimenti e punti di vista alternativi per facilitare il confronto
Esempio 45: ingrandimento di una parte della foto di gruppo. Permette di verificare volti, pose e illuminazione quando più riferimenti vengono riuniti in uno spazio.
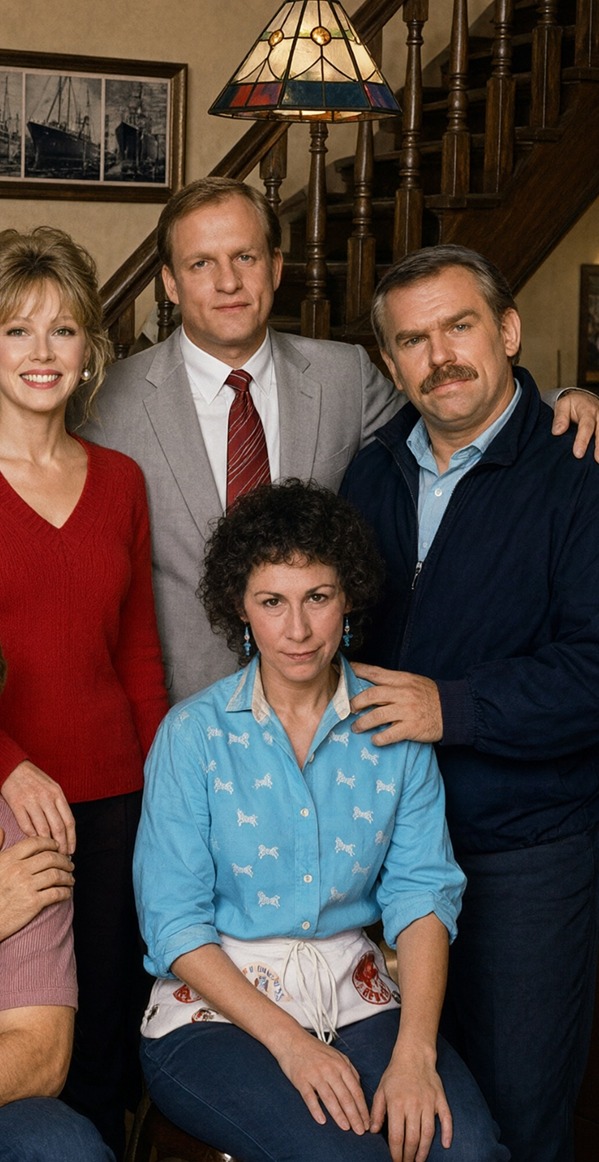
Esempio 46: ingrandimento dell'interno dopo l'integrazione dei mobili. Crea prospettiva e luce dell'intera stanza da riferimenti di prodotti singoli.
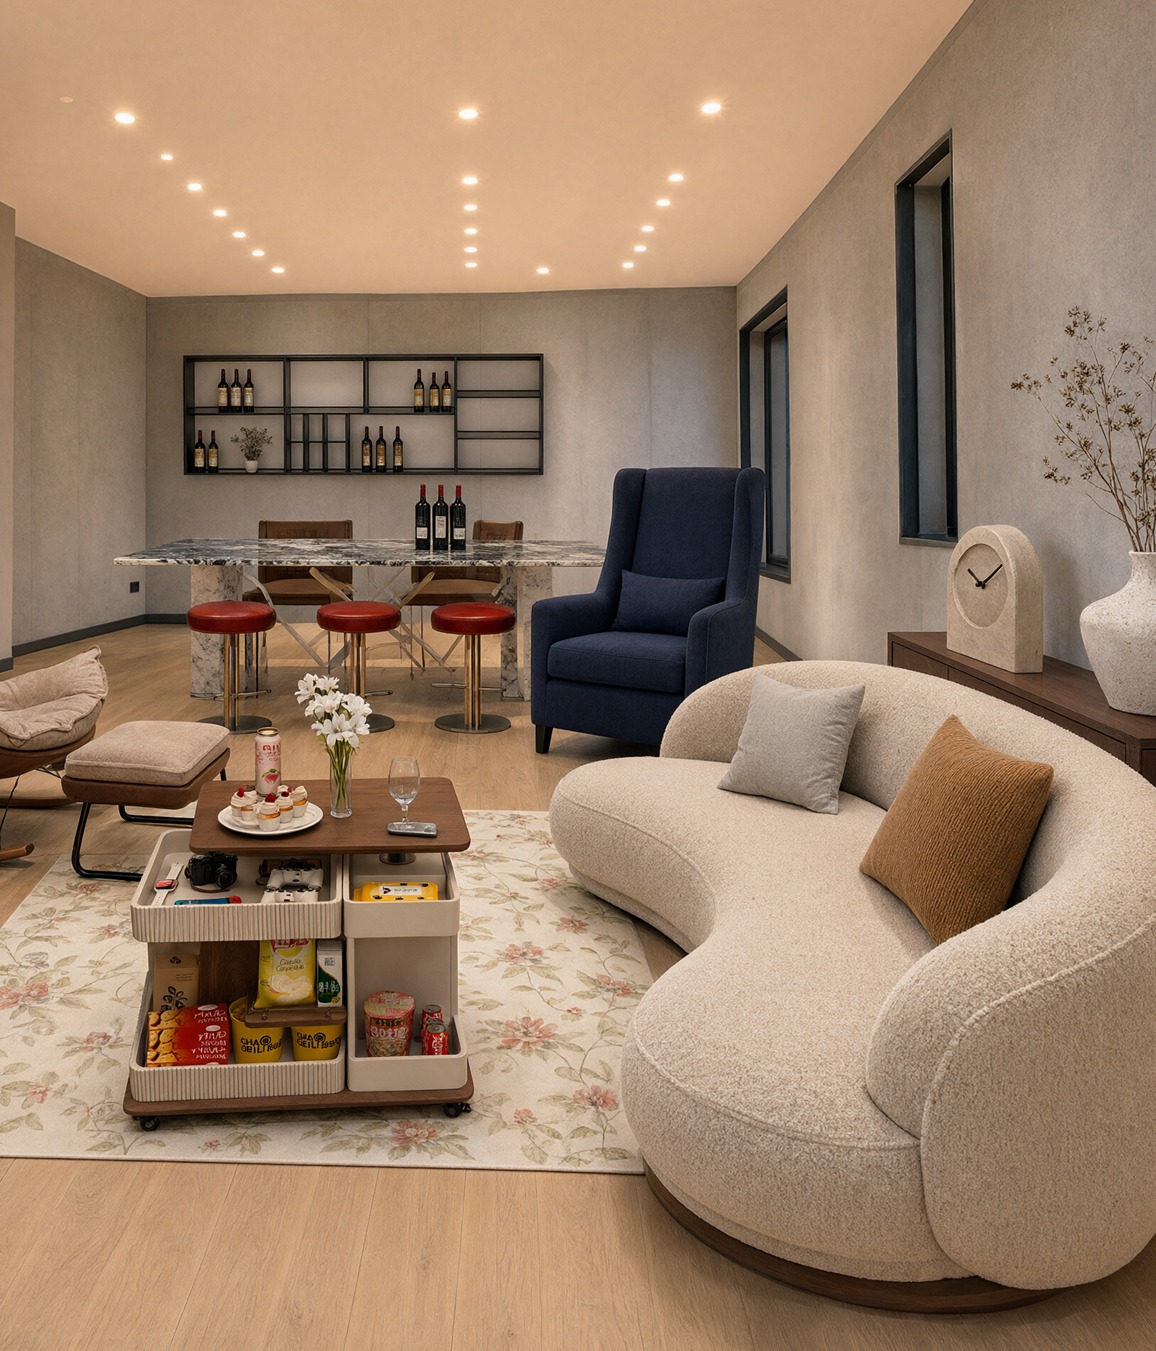
Esempio 47: crop quadrato dopo il cambio di punto di vista. Rende più leggibile la relazione di scala tra la torre sullo sfondo e la persona.
Esempio 48: ingrandimento del character design sheet. Consente di verificare la qualità locale di varianti del volto, testo e accessori.
Esempio 49: ingrandimento di una parte della sequenza della stessa persona in più scene. Mostra la coerenza di abiti e volto, cruciale nei lavori lunghi.
Esempio 50: ingrandimento di un'infografica architettonica. Mostra il problema composito di line art, materiali, annotazioni e gestione degli spazi bianchi.
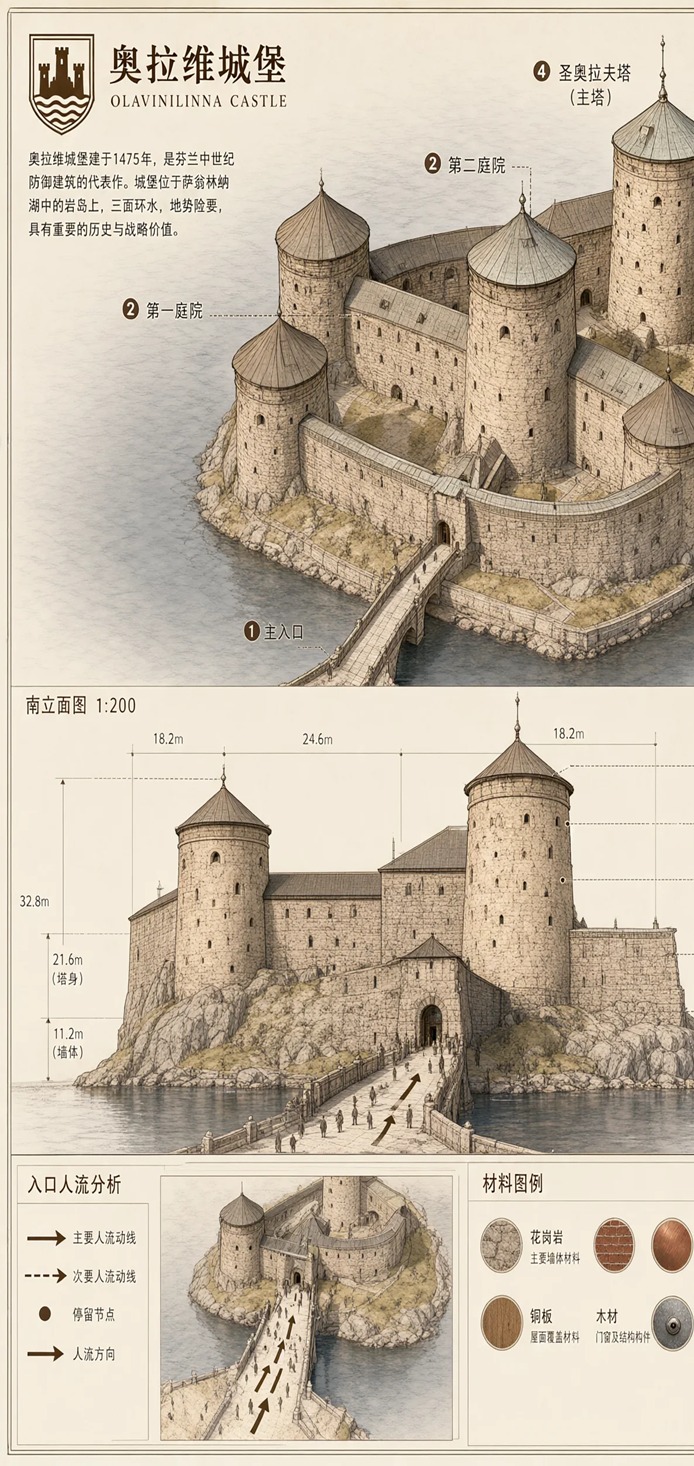
Fonte delle immagini: campioni ufficiali di Qwen Team, "Qwen-Image-2.1". I sei ingrandimenti sono crop editati a scopo comparativo.
100 esempi e verifiche discussi su Reddit
Di seguito sono raccolti in 100 voci i tipi di generazione e editing realmente discussi nei principali post Reddit su Qwen-Image 2.1. Poiché includono soggettività degli autori e differenze tra ambienti, non vanno letti come benchmark, ma come un catalogo pratico di test utili a comprendere il carattere del modello.
A. Fotografia di persone e ritratti (1–10)
- Foto amatoriale di una donna, come scattata con uno smartphone.
- Ritratto quotidiano scattato nel reparto vendita di un supermercato.
- Fotografia di persona con controluce cinematografico.
- Nuova illuminazione di una persona davanti a un panorama notturno.
- Cambio simultaneo di meteo e orario a una notte piovosa.
- Fotografia fashion che conserva la texture della pelle.
- Scatto di profilo destro da un'angolazione bassa.
- Cambio di fotocamera da foto frontale a tre quarti.
- Rigenerazione del volto con grande variazione dell'espressione.
- Generazione di un "volto di riferimento" integrato da più condizioni di luce.
Fonte di attenzione: test di oltre 200 immagini 1girl (circa 1.483 voti), recensione iniziale
B. Coerenza dei personaggi (11–20)
- Sheet con fronte, profilo e retro dello stesso personaggio.
- Materiale di riferimento che riunisce primo piano del volto e figura intera.
- Generazione di un singolo volto coerente da riferimenti facciali 2×2.
- Spostamento della stessa persona in un altro luogo preservandone il volto.
- Cambio del solo abito della stessa persona.
- Cambio della sola acconciatura della stessa persona.
- Sostituzione della sola posa della stessa persona.
- Rappresentazione della stessa persona in versione realistica e a fumetti.
- Creazione di più pose per una sequenza continua.
- Uso del character sheet come riferimento per la generazione video.
Fonte di attenzione: character design sheet, riferimenti facciali da quattro direzioni (circa 157 voti), Qwen contro FLUX.2 Krea (circa 116 voti)
C. Trasferimento di pose, camera e composizione (21–30)
- Trasferimento della posa del riferimento 2 alla persona del riferimento 1.
- Posizionamento di una persona seduta sulla sedia gialla di un'altra immagine.
- Trasformazione di una posa in piedi in una seduta preservando l'abito.
- Cambio di una composizione frontale in un'inquadratura media dal basso.
- Espansione della sola inquadratura mantenendo la dimensione del soggetto.
- Trasferimento di una posa da un'immagine da studio a una persona realistica.
- Conversione di una persona realistica in stile Simpsons mantenendo la posa.
- Conservazione della posizione di un prodotto indossato anche cambiando l'angolo di ripresa.
- Applicazione di una profonda profondità di campo a primo piano e sfondo.
- Creazione di una foto di gruppo senza alterare la disposizione di più persone.
Fonte di attenzione: consigli per l'editing (circa 513 voti), Editing Beast (circa 840 voti)
D. Prodotti, pubblicità e prova virtuale (31–40)
- Sostituzione in blocco di una lattina di cola schiacciata con la lattina di un altro prodotto.
- Cambio di colori e design mantenendo la deformazione della lattina.
- Riflesso del colore del prodotto sulla superficie bianca circostante.
- Applicazione naturale al polso di un orologio preso da un'altra immagine.
- Pubblicità dell'orologio che conserva posa, corporatura e illuminazione originali.
- Prova con cinque riferimenti: modella, abito, scarpe, borsa e cappello.
- Posizionamento del logo di un'altra immagine su una foto prodotto.
- Sostituzione del solo packaging mantenendo il set fotografico.
- Scontorno di prodotti su sfondo trasparente per e-commerce.
- Sviluppo dello stesso prodotto con più sfondi e illuminazioni.
Fonte di attenzione: Editing Beast (circa 840 voti), esempi ufficiali a riferimenti multipli nel blog
E. Editing di sfondo, luce e materiali (41–50)
- Trasformazione di uno sfondo diurno in una notte piovosa.
- Sostituzione del solo sfondo mantenendo la persona.
- Trasferimento simultaneo di illuminazione e sfondo dall'immagine di riferimento.
- Sostituzione di una parete con una texture verde da un'altra immagine.
- Cambio di un interno in luce calda del tramonto.
- Cambio in un'illuminazione nitida da servizio high fashion.
- Ricalcolo delle ombre della persona in base alla luce dello sfondo.
- Confronto di realismo tra rumore normale e Brownian noise.
- Confronto della texture tra Euler e sampler personalizzato eta 0,50.
- Bilanciamento tra nitidezza e naturalezza con un sampler a due fasi.
Fonte di attenzione: consigli per l'editing, thread di verifica delle impostazioni (circa 80 voti)
F. PNG trasparenti, scontorno ed editing locale (51–60)
- PNG su sfondo trasparente di un singolo personaggio.
- Asset di prodotto su sfondo trasparente.
- Materiale grafico trasparente composto da più elementi.
- Estrazione della sola persona da una foto.
- Editing di un soggetto su un livello trasparente.
- Inpainting di una forma che include i bordi alfa.
- Modifica simultanea della forma delle cuffie e dell'area trasparente.
- Sostituzione del solo abito dipinto in rosso.
- Editing del solo piccolo oggetto cerchiato.
- Editing locale che ripristina completamente l'esterno della maschera.
Fonte di attenzione: editing alfa con LanPaint (circa 77 voti), recensione iniziale
G. Outpainting e restauro (61–70)
- Estensione della tela solo a sinistra.
- Estensione della tela solo a destra.
- Estensione della tela solo in alto.
- Estensione della tela solo in basso.
- Estensione simultanea a sinistra, destra e in basso.
- Completamento delle aree vuote di una foto inclinata.
- Recupero dello sfondo mancante a causa di un crop errato.
- Completamento attorno a un soggetto parzialmente tagliato.
- Conversione a grandangolo mantenendo lo sfondo originale.
- Confronto tra grana e contrasto nel restauro di foto antiche.
Fonte di attenzione: verifica dell'outpainting (circa 62 voti), valutazione critica del restauro fotografico
H. Poster, testo e graphic design (71–80)
- Poster di un evento con un grande titolo.
- Design pubblicitario con composizione e gerarchia informativa definite in anticipo.
- Confronto per stabilizzare testi grandi a 2–2,5 MP.
- Confronto per aumentare il dettaglio di visual senza testo intorno a 4 MP.
- Design di packaging con nome del prodotto.
- Grafica di una TV vintage con la scritta "Qwen".
- Compositing naturale di insegne o loghi in un'altra immagine.
- Layout complesso generato da un prompt lungo.
- Test di testo deteriorato e intrusioni di cinese in un'infografica inglese.
- Poster che confronta la qualità di design con modelli di immagini della famiglia GPT.
Fonte di attenzione: template di prompt per design, breve recensione ed esempio TV vintage
I. Trasferimento di stile, illustrazioni e narrazione (81–90)
- Conversione di una foto realistica in stile fumetto.
- Conversione di una persona realistica in stile Simpsons.
- Trasferimento del solo stile visivo di un riferimento a un'altra immagine.
- Cambio della colorimetria mantenendo personaggio e sfondo.
- Generazione di un'immagine in stile Polaroid.
- Generazione di uno storyboard in formato a quattro vignette.
- Sviluppo della stessa persona in più scene.
- Inquadrature di una storia continua che conservano animali, auto e persone.
- Illustrazione simile a uno screenshot di anime contemporaneo.
- Confronto con fallimenti dello stile anime spinto verso il realismo.
Fonte di attenzione: esperimento Polaroid, confronto con Krea 2 per uso anime, recensione iniziale
J. Workflow, velocità e confronti di qualità (91–100)
- Confronto tra CFG 1–5 per composizione, texture e contrasto.
- Confronto tra CFG sotto 2 e CFG 4 eccessivamente elaborato.
- Generazione rapida con 16 passaggi, 1 MP e INT8.
- Verifica della qualità di editing a 25 passaggi e 2K.
- Upscaling da 2K a 4K dopo 30 passaggi.
- Editing che mira a circa il doppio della velocità con una LoRA da 4 passaggi.
- Generazione di persona in circa 45 secondi con 8 passaggi, 1024×1280 e RTX 3060.
- Confronto di velocità tra Qwen e FLUX.2 Krea per character sheet.
- Test di precisione dei pixel a 2K e integrazione di 10 immagini di riferimento.
- Confronto per ridurre il rumore nei dettagli con Fix v2.0 e sampler dedicato.
Fonte di attenzione: thread di rilascio dei modelli ComfyUI (circa 106 voti), LoRA da 4 passaggi e poca VRAM (circa 44 voti), risultati sperimentali, Fix v2.0
In sintesi, le valutazioni di Reddit
Aspetti più apprezzati
- Prestazioni di editing: conserva relativamente bene l'immagine originale anche cambiando colore, sfondo, materiale, posa o prodotto.
- Riferimenti multipli: efficace nella creazione che combina persone e prodotti, moda e accessori.
- Coerenza dei personaggi: promettente come punto di partenza per materiali di riferimento e sequenze di scene.
- Immagini trasparenti: può generare e modificare non solo scontorni, ma il canale alfa stesso.
- Outpainting: pratico per estendere più direzioni in una volta.
- Dimensioni e velocità: pratico per un componente generativo da 7B, con molte opzioni di quantizzazione e accelerazione.
Debolezze segnalate ripetutamente
- Mani, dita, braccia e anatomia umana complessa sono instabili.
- Volti lontani e linee sottili tendono a deteriorarsi.
- L'output predefinito può mostrare rumore e irregolarità nei dettagli.
- Il contrasto può essere forte e i neri troppo chiusi.
- Nel restauro fotografico può alterare arbitrariamente grana originale e forme minute.
- Alcuni criticano fisici tozzi nei character sheet.
- Con più immagini di riferimento aumentano interferenze tra attributi e allucinazioni.
- Alcuni stili anime vengono trascinati verso una direzione realistica o cinematografica.
- Pur con esempi forti, testo piccolo e infografiche inglesi restano instabili.
- Impostazioni, prompt rewriter e sampler incidono molto sui risultati.
Da questi giudizi emerge che Qwen-Image 2.1 non è un "modello universale perfetto al primo tentativo", ma un modello creativo centrato sull'editing che migliora quanto più si affinano impostazioni e workflow.
Come iniziare in pratica
Con ComfyUI, aggiorna all'ultima versione e scegli Text-to-Image o Image Edit dai template integrati. I workflow supportati ufficialmente sono disponibili anche su GitHub. Conviene iniziare con 40 passaggi vicini alle impostazioni ufficiali per creare un'immagine di riferimento, quindi scendere a 16, 8 e 4 passaggi confrontando velocità e qualità.
Nell'editing, invece di scrivere vagamente "rendila migliore", è più facile verificare i risultati seguendo questo ordine.
- Che cosa modificare.
- Da quale immagine di riferimento prenderlo.
- Che cosa non deve assolutamente cambiare.
- Come mantenere luce, sfondo, corporatura, posa e composizione.
- Inserire nelle istruzioni negative gli elementi che tendono a fallire.
Per esempio, nel compositing di prodotto, rendi espliciti soggetto e condizioni di preservazione: "Mantieni la persona e la posa dell'immagine 1 e applica solo l'orologio dell'immagine 2 al polso. Non modificare corporatura, sfondo e illuminazione." Con più riferimenti, è importante non rendere ambigua la corrispondenza tra <image1> e <image2>.
Negli esempi condivisi su Reddit per immagini trasparenti vengono specificati "RGBA image", "alpha channel" e "background is transparent". Se vuoi modificare anche il bordo trasparente, usa un'elaborazione di maschere con supporto alfa, come LanPaint.
Per chi è indicato
Qwen-Image 2.1 è adatto soprattutto ai seguenti usi.
- Chi vuole creare in locale con ComfyUI.
- Chi vuole modificare solo parti specifiche di persone o prodotti.
- Chi vuole riunire più materiali di riferimento in un'unica pubblicità o scena.
- Chi vuole creare materiali di riferimento per personaggi o immagini di riferimento per video.
- Chi vuole creare PNG trasparenti o asset per giochi e Web.
- Team di ricerca e sviluppo che vogliono gestire un'API di generazione e editing immagini su server dedicati.
Al contrario, per restauro fotografico perfettamente fedele, identità rigorosa in opere lunghe e continue, pose complesse in cui le mani sono fondamentali, infografiche dense di testo piccolo o adozione incondizionata per uso commerciale, è indispensabile confrontare altri modelli e verificare la licenza.
Conclusione
L'essenza di Qwen-Image 2.1 sta nell'integrare, in un componente generativo relativamente compatto da 7 miliardi di parametri, T2I, editing delle immagini, fino a 10 riferimenti, editing locale, RGBA trasparente ed estrazione del soggetto. Ciò che suscita maggiore entusiasmo su Reddit non è la semplice generazione di belle ragazze, bensì l'uso che abbrevia i processi creativi: sostituzione di orologi o lattine, character sheet, trasferimento di sfondi e illuminazione, outpainting ed editing alfa.
D'altra parte, la valutazione degli esempi dipende molto dalle impostazioni. CFG, sampler, numero di passaggi, risoluzione, prompt rewriting e LoRA di accelerazione possono produrre risultati così diversi da sembrare modelli differenti. La scelta più sicura è creare prima una base con le impostazioni ufficiali, confrontare una modifica alla volta e svolgere confronti alla cieca con altri modelli per i progetti importanti.
La maggiore cautela riguarda la licenza. Il fatto che i pesi siano pubblici non rende automaticamente libero l'uso commerciale. Il modello è tecnicamente molto interessante, ma per adottarlo nel lavoro è opportuno decidere solo dopo aver verificato la licenza ufficiale e le condizioni più aggiornate.
Link principali
- Blog ufficiale di Qwen-Image 2.1
- Repository GitHub ufficiale
- Documentazione Hugging Face Diffusers
- Modello per ComfyUI
- Reddit: raccolta di esempi 1girl
- Reddit: Editing Beast
- Reddit: consigli per l'editing
- Reddit: outpainting
- Reddit: inpainting del canale alfa
- Reddit: Qwen-Image 2.1 Fix v2.0
※ Questo articolo è stato realizzato sulla base delle informazioni ufficiali e dei post pubblici della community disponibili al 4 ottobre 2026. I voti su Reddit, gli strumenti dell'ecosistema del modello e le condizioni di licenza possono cambiare.