Ho creato un modello di sintesi vocale croato con 32 milioni di parametri. Confronto delle voci durante l'addestramento
Dopo il LLM croato per RAG, questa volta ho provato a creare un piccolo modello di sintesi vocale (TTS) dedicato al croato. L'obiettivo era farlo funzionare in tempo reale sulla CPU di uno smartphone.
Il metodo è stato la «distillazione». Ho fatto leggere a un grande modello di sintesi vocale (HiggsAudio v3) dei copioni in croato per creare i dati di addestramento, poi ho addestrato da zero un modello piccolo con quei dati. Per iniziare, ho svolto un addestramento pilota su 7,5 ore di dati e ho confrontato come cambia la stessa frase nel corso dell'addestramento.
Prima, le conclusioni.
- Con 32 milioni di parametri (18,3 milioni per Matcha-TTS + 13,5 milioni per Vocos), parlava davvero croato
- Dopo 50 minuti di addestramento (5.000 step), leggeva già fedelmente il copione. In seguito è migliorato soprattutto il «rumore»
- Il tasso di errore sui caratteri di 14 frasi di valutazione era dello 0,9% alla fine (10 frasi su 14 coincidevano perfettamente)
- Anche con un solo thread CPU, ha generato un secondo di audio in 0,09 secondi (i7-13700K)
Demo: facciamolo parlare davvero
Ho messo il modello di questo articolo (la versione finale a 30.000 step) nel playground TTS croato. Inserisci il croato che preferisci e lo leggerà subito ad alta voce.
- Puoi scegliere fra 50 frasi d'esempio (saluti, viaggi, ospedale ecc.) oppure inserire fino a 1.000 caratteri
- Puoi modificare velocità di lettura, intensità dell'intonazione e numero di step di sintesi. Con un seed fisso, la stessa frase produce ogni volta lo stesso audio
- La sintesi gira esclusivamente sulla CPU del server (ONNX Runtime; non usa né GPU né API esterne)
- Non sa leggere i numeri, quindi occorre scriverli in parole, come «dvadeset pet (25)»
Cosa ho fatto
1. Creare i copioni: ho chiesto a Gemma 4 31B in locale di scrivere battute di conversazioni quotidiane in croato. Ho specificato casualmente situazione, interlocutore, emozione e lunghezza, con scenari come «parlare con una nonna al mercato» o «avere paura per uno strano rumore nel cuore della notte», 22 righe alla volta. L'idea era una sola voce femminile sui trent'anni. Ho mescolato 23 tipi di emozione (normale, gioia, rabbia, sussurro ecc.).
2. Trasformarli in voce: ho fatto leggere i copioni a HiggsAudio v3 con la voce di un audio di riferimento (16 secondi). Aggiungendo tag emotivi (come <|emotion:anger|>), si arrabbia o si rallegra davvero. Ho creato 4.500 file in circa 5 ore.
3. Controllarli automaticamente: ho trascritto gli audio con Whisper large-v3 e li ho confrontati con i copioni, scartando le letture errate. Inoltre, con un modello di riconoscimento del parlante, ho misurato la somiglianza con la voce di riferimento e ho scartato anche gli elementi in cui la voce era cambiata. Ne sono passati 4.393 su 4.500 (97,6%). Dopo aver tagliato i silenzi iniziali e finali, restavano 7,46 ore.
4. Addestrare il piccolo modello: ho addestrato Matcha-TTS (un TTS basato sul flow matching) per 5 ore su una RTX 4090. Circa 30.000 step. Per la parte che riconverte l'audio in forma d'onda (il vocoder), ho usato Vocos pubblico così com'era.
Il croato è una lingua che si legge quasi esattamente come si scrive, quindi non ho convertito il testo in simboli fonetici: ho inserito direttamente i caratteri. Tuttavia, lj, nj e dž sono un unico suono, quindi li ho trattati come una sola lettera.
Confronto degli audio nel corso dell'addestramento
Ho sintetizzato con i modelli in fase di addestramento una frase non inclusa nei dati: «Molim Vas, možete li mi reći koliko košta ova haljina?» (Mi scusi, quanto costa questo vestito?).
step 5.000 (circa 50 minuti dall'inizio dell'addestramento)
step 10.000 (circa 1 ora e 40 minuti)
step 15.000 (circa 2 ore e 20 minuti)
step 20.000 (circa 3 ore e 10 minuti)
step 30.000 (circa 5 ore, versione finale)
Come riferimento, ecco uno dei dati di addestramento creati da HiggsAudio nel ruolo di insegnante (una frase diversa: «Samo polako hodajte, nema potrebe da žurimo kroz ovaj mrak.»).
Trascritta con Whisper, questa frase era identica al copione, carattere per carattere, dallo step 5.000 fino alla fine. In altre parole, già all'inizio sapeva «cosa stava dicendo».
La differenza sta nella pulizia del suono. All'ascolto, allo step 5.000 si percepisce un rumore granuloso, molto ridotto allo step 10.000. Diventa evidente osservando lo spettrogramma dello stesso audio (tempo sull'asse orizzontale, frequenza su quello verticale).
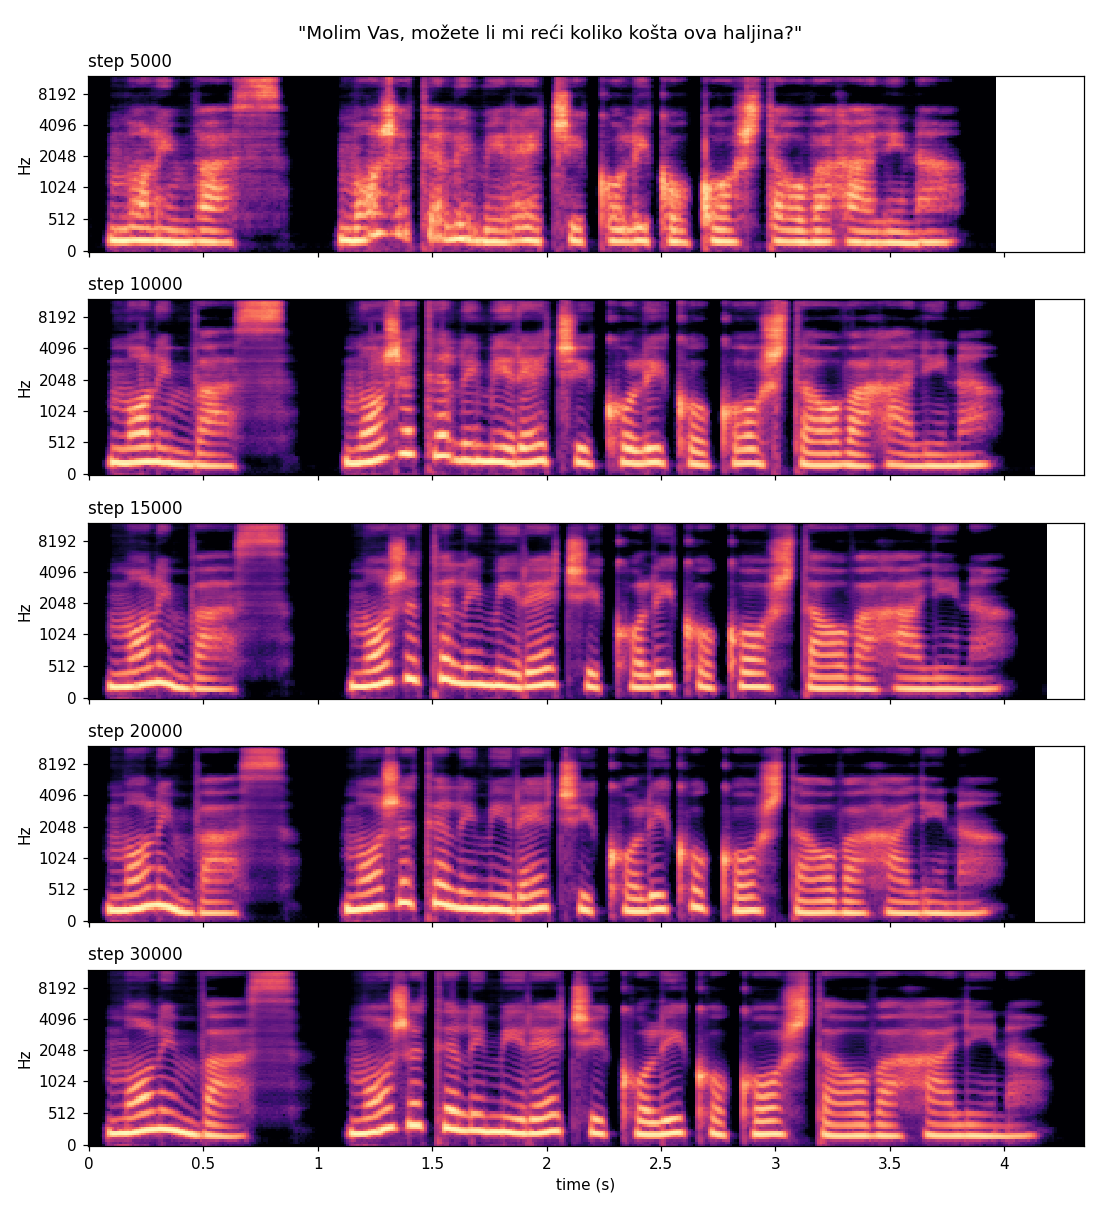
Le strisce orizzontali, gli armonici, che si allineano in base all'altezza della voce, allo step 5.000 sono sfocate e gli spazi fra le strisce risultano nebulosamente riempiti. È la parte che si percepisce come rumore. Dallo step 10.000 in poi, le strisce diventano nitide e gli spazi si scuriscono. Con il procedere dell'addestramento, le strisce sembrano curvarsi dolcemente verso l'alto e il basso, rendendo più evidente anche il movimento dell'altezza della voce, cioè l'intonazione.
I numeri
Ho trascritto con Whisper large-v3 14 frasi di valutazione (tutte esterne ai dati di addestramento) e ne ho misurato il tasso di errore sui caratteri (CER). Comprendono da brevi saluti fino a monologhi di circa 16 secondi.
| Step | Tempo di addestramento | Tasso di errore sui caratteri | Corrispondenza perfetta |
|---|---|---|---|
| 5.000 | Circa 50 minuti | 1,1% | 9 / 14 |
| 10.000 | Circa 1 ora e 40 minuti | 3,4% | 8 / 14 |
| 15.000 | Circa 2 ore e 20 minuti | 0,7% | 11 / 14 |
| 20.000 | Circa 3 ore e 10 minuti | 0,9% | 11 / 14 |
| 30.000 | Circa 5 ore | 0,9% | 10 / 14 |
- Il peggioramento dei numeri allo step 10.000 dipende quasi interamente da una sola frase, «Bok!» (Ciao!), trascritta come «Vok». È una differenza di un carattere su tre, quindi quella sola frase porta il tasso di errore al 33%. All'ascolto, lo step 10.000 era molto più pulito dello step 5.000. Il tasso di errore sui caratteri può misurare soltanto se il testo viene letto correttamente: la pulizia dell'audio va giudicata ascoltandolo
- Gli errori rimasti fino alla fine erano le đ e dž di «Đak je pojeo džem» (Lo studente ha mangiato la marmellata). Anche in croato sono suoni rari e venivano trascritti come «Žak» e «Džak»
Velocità sulla CPU
Ho misurato su un i7-13700K, usando PyTorch così com'è (senza ottimizzazioni). La media di tre generazioni di 4 frasi, per un totale di 47,6 secondi di audio. RTF significa «tempo necessario per generare ÷ durata dell'audio»: più è piccolo, più è veloce.
| Numero di thread | Numero di step | Matcha | Vocos | RTF totale |
|---|---|---|---|---|
| 1 | 2 | 0.042 | 0.025 | 0.067 |
| 1 | 4 | 0.067 | 0.025 | 0.092 |
| 4 | 4 | 0.032 | 0.010 | 0.042 |
| 8 | 4 | 0.028 | 0.007 | 0.036 |
Il «numero di step» è il numero di iterazioni che trasformano il rumore in suono durante la sintesi; gli audio del confronto sopra sono stati creati con 4 step. Anche con un solo thread, può generare un secondo di audio in 0,09 secondi. La CPU di uno smartphone è più lenta, ma dovrebbe comunque rientrare nel tempo reale (non l'ho ancora misurato su un dispositivo reale, quindi è una previsione).
Quante ore di dati servono per un TTS?
Visto che con 7,5 ore sono arrivato fin qui, ho cercato i riferimenti generali.
- LJSpeech, il dataset inglese molto usato per TTS a voce singola, dura circa 24 ore. Anche il modello ufficiale di Matcha-TTS è addestrato su questo dataset
- JSUT per il giapponese e CSMSC per il cinese durano circa 10 ore e sono normalmente usati come corpus a voce singola
- Per addestrare da zero, circa 1 ora è il limite inferiore; a seconda del modello possono aumentare gli errori di pronuncia
- Per il fine-tuning di un modello già addestrato, è stato riportato che 30 minuti possano equivalere più o meno a 27 ore di addestramento da zero
Ho trovato anche una ricerca che ha addestrato Matcha-TTS usando solo voce sintetica (Università Jiao Tong di Shanghai, dicembre 2025). Indica che una maggiore varietà nei testi, audio pulito senza rumore e uno stile di parlato coerente facilitano l'addestramento. Poiché i dati sintetici non hanno rumore e mantengono uniforme lo stile di parlato, a parità di durata potrebbero essere più facili da apprendere rispetto alle registrazioni reali. Probabilmente è anche il motivo per cui 7,5 ore sono bastate per arrivare fin qui.
Le difficoltà incontrate
- Il PC si è bloccato: per errore ho caricato contemporaneamente sulla GPU due modelli da 31B per la creazione dei copioni, saturando la VRAM. Da allora, la regola è «un solo modello alla volta sulla GPU»
- Gemma 4 pensa troppo: circa due terzi dell'output erano «ragionamenti». Disabilitandoli, è diventato circa tre volte più veloce
- Le allucinazioni di HiggsAudio: nel primo test, dopo il silenzio alla fine della frase ha continuato autonomamente con «Hvala što pratite kanal» (Grazie per aver seguito il canale), creando una clip di 81 secondi. Sembra aver memorizzato le frasi finali di YouTube. Ho iniziato a scartare gli elementi la cui durata si discostava molto da quella prevista
- Matcha-TTS non funziona su Windows: alcune estensioni C non potevano essere compilate, quindi ho riscritto quella parte in Python (numba)