Notizie sull'IA per la generazione di immagini e video — 2026-10-01
Le soluzioni open source (Qwen-Image-2.1, LTX 2.5) stanno prendendo slancio attorno a ComfyUI, mentre i grandi operatori closed source (Google Nano Banana, OpenAI Sora, xAI Grok Imagine) fanno notizia soprattutto per abusi, cause legali e chiusure di servizi.
Ultime notizie sull'IA per la generazione di immagini e video — 2026-10-01
Diciamolo subito: in questo momento il fronte open source è davvero rovente 🔥 Qwen-Image-2.1 di Alibaba (solo 7B, ma trasparenza nativa e output 2K) e LTX 2.5, modello video open source, si stanno diffondendo rapidamente nella comunità di ComfyUI, rendendo sempre più potente l'ambiente per sperimentare in locale, gratuitamente e senza censure 😤 Sul fronte closed source (famiglia Google Nano Banana, OpenAI Sora, Midjourney, xAI Grok Imagine), le funzioni sono certamente brillanti, ma risaltano di più le notizie di incidenti: deepfake, abusi legati a materiale pedopornografico, cause e chiusure di servizi. Il tono della conversazione è quindi molto diverso 🙄 A essere sinceri, questa volta non siamo riusciti a raccogliere quasi nessun dato davvero pertinente al tema da X e Bluesky: scusate 🙏
Attraverso le piattaforme
Tre elementi emergono con chiarezza su più piattaforme!
- Open source = ComfyUI è diventato il linguaggio comune: su Reddit (Vlo 0.3 ha ottenuto 1.055 pt in r/StableDiffusion), YouTube (numerosi video su Qwen-Image-2.1 e LTX 2.5) e Lemmy (workflow derivati da Qwen-Image-2.1 pubblicati ogni giorno su !«メールアドレス»), ComfyUI coincide chiaramente con lo standard di fatto 💪
- Il closed source diventa notizia soprattutto attraverso abusi e polemiche: Reddit (SM Entertainment avvia azioni legali per immagini deepfake di idol K-pop, 730 pt), Lemmy (la funzione Nano Banana di Google Earth sospesa in un giorno per immagini di disastri contraffatte, score 473), Bluesky (il giornalista di 404 Media Emanuel Maiberg continua a indagare sulle immagini generate senza consenso), Pinterest (almeno 7 immagini su 50 veicolano timori sul tema “l'IA sostituirà i giornalisti”) — è davvero interessante che quattro piattaforme di generi diversi mostrino la stessa dinamica 🫣
- Censura più severa → migrazione verso il locale: su Reddit (richieste di alternative a Seedream/MiniMax H3 dopo l'inasprimento dei filtri NSFW di WAN 3.0, e consigli di passare a Midjourney/VeniceAI dopo lamentele sulla censura eccessiva di ChatGPT) e Lemmy (sostegno a infrastrutture gratuite e distribuite come AI Horde), emerge nitidamente l'idea che “se le regole diventano troppo restrittive, si passa all'open source” 🏃
Piattaforma per piattaforma
Reddit: raccolti 12 thread (non si raggiunge il criterio di completamento di 20). La causa sui deepfake K-pop (730 pt) e la polemica sul videoclip Vocaloid (327 pt) hanno dominato nettamente; le storie su etica e danni hanno generato più attenzione delle discussioni sui trend tecnici. Sono presenti temi sia closed sia open source.
X: un risultato davvero disastroso 😭 Le query non erano parole chiave pertinenti, bensì trend croati (Spain, Tesla, JubJub ecc.) riutilizzati così come sono; di conseguenza, su 40 post raccolti, quelli realmente legati al tema sono di fatto zero. La conclusione della fase X è che non c'è nulla di utile da dire sull'IA per la generazione di immagini e video.
YouTube: analizzati 10 video. I progetti open source Qwen-Image-2.1 e LTX 2.5 si sono diffusi subito nei canali in inglese, mentre nei canali giapponesi hanno maggiore forza i confronti pratici tra soluzioni closed source come Nano Banana, Flow e Sora2. È interessante anche la separazione degli interessi open/closed per lingua.
Bluesky: l'API ufficiale di ricerca full-text (searchPosts) ha continuato a restituire HTTP403 e non era utilizzabile, quindi si è passati a un approccio alternativo di monitoraggio per account. Sul lato closed source, dfl.bsky.social pubblica ogni giorno paesaggi generati con Nano Banana 2; gli autori open source (come doctordiffusion) sembrano invece inattivi dalla prima metà del 2025, con pochi post davvero attuali.
Lemmy: selezionati 11 elementi (esaminati oltre 60). !«メールアドレス» è estremamente ricca di informazioni tecniche open source; per il closed source predominano notizie nate da polemiche, come il caso Google Earth e la causa per CSAM contro xAI Grok Imagine. Per quantità di materiale esaminato, il criterio di completamento è stato ampiamente raggiunto.
Pinterest: controllati tutti i 50 pin. Gran parte erano immagini stock per SEO e miniature da listicle; l'unica vera demo di prodotto era circa la griglia di trasformazioni di Lumalabs. Non è comparsa nemmeno un'immagine relativa all'open source (ComfyUI, Stable Diffusion UI ecc.). Le immagini di brand closed source (Veo2, Gemini Omni) risaltano, ma è stato anche rilevato il riuso della stessa immagine in più pin.
Cosa osservare
- Qwen-Image-2.1 (Alibaba, pesi aperti da 7B): YouTube “A 7B Model That Beats Nano Banana 2.0?” https://www.youtube.com/watch?v=fwHS0ubmI7I e Lemmy https://lemmy.dbzer0.com/post/75874773 — benchmark indipendenti sostengono che superi i principali modelli closed source; è il simbolo dello slancio open source 🚀
- LTX 2.5 (modello video completamente open source): YouTube https://www.youtube.com/watch?v=6B9WSxi6j8E — workflow pratici in ComfyUI fino a multi-shot e output 2K
- Polemica “Nano Banana” di Google Earth: Lemmy https://lemmy.world/post/50167698 (score 473) — schema tipico dei grandi operatori closed source: lancio della funzione → abuso → sospensione immediata
- Il rallentamento di Sora 2: YouTube (TBS NEWS DIG) https://www.youtube.com/watch?v=_r9hojDlABM — dopo il clamore iniziale, il servizio è avviato verso uno spegnimento graduale (la fine dell'API è indicata per il 2026-09-24)
- Causa di SM Entertainment sui deepfake K-pop: Reddit https://www.reddit.com/r/kpop/comments/1wsdr6d/ — i problemi di diritto all'immagine dovuti agli abusi dell'IA raccolgono le reazioni più forti, indipendentemente dal fatto che il sistema sia closed o open source
- Vlo 0.3 (editor video IA open source): Reddit https://www.reddit.com/r/StableDiffusion/comments/1wsmat4/ — strumento locale che integra Minimax H3/Qwen2.1/Krea2/LTX2.5
Raccomandazioni
- Nella prossima raccolta per X, usare parole chiave direttamente collegate al tema (Midjourney, Sora, Stable Diffusion, Wan, Kling ecc.). I dati attuali non sono utilizzabili.
- Se
searchPostsdi Bluesky continua a restituire 403, valutare un diverso metodo di accesso, ad esempio un'API autenticata. - Continuare a monitorare l'adozione di Qwen-Image-2.1 e LTX 2.5 come indicatori open source nel prossimo ciclo.
- Dare priorità alle notizie di abuso e polemica relative alle aziende closed source (Nano Banana/Google Earth, causa Grok Imagine), poiché tendono a massimizzare l'engagement.
- Suddividere Reddit in più query per ampliare la raccolta e avvicinarsi al criterio di circa 20 elementi.
- Verificare nel prossimo ciclo come cambieranno gli equilibri del mercato video closed source dopo la fine dell'API Sora.
Qualità dei dati
Per X, un errore nella scelta delle query ha prodotto solo dati estranei al tema: di fatto, “nessun dato”. Bluesky ha dovuto ricorrere al tracciamento alternativo degli account perché l'API full-text era bloccata con 403, e non ha raggiunto il criterio di circa 20 elementi. Anche Reddit si è fermato a 12 risultati con una sola query. Lemmy (oltre 60 elementi esaminati), Pinterest (tutti i 50 pin esaminati) e YouTube (10 video analizzati) hanno invece fornito una quantità di dati generalmente sufficiente.
Riepilogo per piattaforma
Reddit — Notizie sull'IA per la generazione di immagini e video
Dove
I 12 thread raccolti provengono da nove subreddit. Di seguito membri e numero di elementi raccolti (tutti trovati con la query “Image and Video Generation AI News”).
| Subreddit | Membri | Elementi raccolti |
|---|---|---|
| r/kpop | 3,893,359 | 1 |
| r/youtube | 3,462,568 | 1 |
| r/StableDiffusion | 1,027,325 | 1 |
| r/AI_Agents | 452,181 | 1 |
| r/Vocaloid | 218,928 | 1 |
| r/aiwars | 170,021 | 1 |
| r/generativeAI | 159,505 | 4 |
| r/B2BForHire | 139,944 | 1 |
| r/GenAI4all | 49,028 | 1 |
r/generativeAI, con quattro elementi, è il più presente; qui si concentrano thread di domande del tipo “Quali strumenti IA gratuiti posso usare?”. Negli altri subreddit compare un elemento ciascuno, e spiccano argomenti su film, musica e K-pop in cui la GenAI è stata usata o ha creato problemi.
Cosa dice la gente
- Thread n. 1 “Dreamworks usa GenAI dal 2023” (r/aiwars, 17 pt, 48 commenti, 2026-09-30, https://www.reddit.com/r/aiwars/comments/1wty4m6/): sostiene che opere Dreamworks come Trolls Band Together e Kung Fu Panda 4 siano state prodotte con GenAI. Il commento principale è scettico: “Nothing you posted says that these movies are 'produced with gen AI'. ... You have no idea how they used AI in these productions.” (u/Majestic-Coat3855, 25 pt)
- Thread n. 2 “Cerco alternative image-to-video per adulti dopo il rafforzamento dei filtri di DreamFort” (r/generativeAI, 10 pt, 8 commenti, 2026-09-30, https://www.reddit.com/r/generativeAI/comments/1wtzefv/): la generazione NSFW di WAN 3.0 è diventata improvvisamente più rigida e gli utenti cercano modelli closed alternativi, come Seedream 2.0 Unfiltered e MiniMax H3.
- Thread n. 3 “I contenuti generati dall'IA stanno uccidendo YouTube” (r/youtube, 107 pt, 21 commenti, 2026-09-25, https://www.reddit.com/r/youtube/comments/1wqbl4f/): segnala l'aumento dei video IA assemblati con una voce narrante. “We have entered the realm of slop.” (u/three-sense, 2 pt), “YouTube CEO says he's pro ai slop.” (u/HotUKTakes, 2 pt)
- Thread n. 4 “Non esiste uno strumento di generazione video IA totalmente gratuito” (r/generativeAI, 55 pt, 36 commenti, 2026-09-30, https://www.reddit.com/r/generativeAI/comments/1wty6zj/): discussione realistica sul fatto che il costo delle GPU cloud non sia beneficenza. “videos are not like cheap LLMs, no one can give it away for free” (u/opengradient, 5 pt)
- Thread n. 5 “Qual è il miglior generatore di immagini IA focalizzato sul gratuito?” (r/generativeAI, 4 pt, 54 commenti, 2026-09-26, https://www.reddit.com/r/generativeAI/comments/1wqfleb/): vengono consigliati Yodayo/MoescapeAI (50 crediti/24 h), Leonardo (token gratuiti giornalieri) e altri.
- Thread n. 6 “Cercasi creator di video IA/content manager IA” (r/B2BForHire, 2 pt, 5 commenti, 2026-09-25, https://www.reddit.com/r/B2BForHire/comments/1wpx42u/): annuncio che richiede esperienza pratica in video ibridi IA e interamente generati dall'IA. Segnale che la produzione video IA è già diventata un mercato professionale.
- Thread n. 7 “AnythingBecomeMoe usa GenAI nel nuovo MV ‘DisplayHolic’” (r/Vocaloid, 327 pt, 105 commenti, 2026-09-28, https://www.reddit.com/r/Vocaloid/comments/1wsa4nz/): opinioni divise. “I don't understand when incredibly talented people embrace ai” (u/AungCowMyat, 297 pt) contro “at least they're disclosing it... far better usage than some others who just straight up reject the fact that they used AI” (u/memorie_desu, 200 pt)
- Thread n. 8 “SM Entertainment avvia azioni legali contro immagini generate dall'IA che prendono di mira Lim Yoona e Winter delle aespa” (r/kpop, 730 pt, 52 commenti, 2026-09-28, https://www.reddit.com/r/kpop/comments/1wsdr6d/): forti preoccupazioni sui deepfake. “the deepfakes are so concerning. glad sm is taking action :(” (u/llamacana, 167 pt)
- Thread n. 9 “Vlo 0.3 — editor/generatore video open source con IA dedicato al compositing” (r/StableDiffusion, 1,055 pt, 71 commenti, 2026-09-28, https://www.reddit.com/r/StableDiffusion/comments/1wsmat4/): accolto bene per i workflow integrati con Minimax H3, Qwen2.1, Krea2 e LTX2.5. “Great ad, same as before :) I forgot about this app, I will Def try it.” (u/Maskwi2, 22 pt)
- Thread n. 10 “I video IA diventati virali nel 2024 mostrano oggi un'evoluzione della qualità pazzesca” (r/GenAI4all, 199 pt, 66 commenti, 2026-09-24, https://www.reddit.com/r/GenAI4all/comments/1wou5vb/): thread nostalgico sul salto di qualità in pochi anni, con molte reazioni coerenti con il titolo “the leap in quality since then is insane”.
- Thread n. 11 “Voglio uno strumento di generazione immagini IA senza guardrail” (r/AI_Agents, 0 pt, 22 commenti, 2026-09-29, https://www.reddit.com/r/AI_Agents/comments/1wt7jqr/): dalle lamentele sulla censura eccessiva di ChatGPT arrivano numerosi consigli di passare a Midjourney, VeniceAI e modelli open source cinesi.
- Thread n. 12 “Esiste uno strumento IA gratuito che crea video animati da una sceneggiatura?” (r/generativeAI, 4 pt, 23 commenti, 2026-09-27, https://www.reddit.com/r/generativeAI/comments/1wrip4m/): “Minimax H3 with comfyUI” (installazione locale, u/Amonsul_, 4 pt) è la risposta più forte. Resta anche la conclusione che, per ottenere qualità, alla fine bisogna pagare.
Segnali
- Tendenza in crescita: la reazione al rafforzamento dei filtri closed source (thread n. 2) mostra in più thread (n. 2, n. 11, n. 12) una volontà coerente di passare a modelli open source/locali (ComfyUI, Minimax H3, famiglia SDXL). L'idea che “per evitare la censura serve il locale” sta diventando un modello ricorrente.
- Segnali di professionalizzazione: il thread di lavoro (n. 6) e quello su Dreamworks (n. 1) mostrano che la GenAI sta andando oltre l'hobby e viene incorporata nell'infrastruttura professionale del cinema e della produzione di contenuti.
- Argomentazioni respinte: l'aspettativa di generatori video “completamente gratuiti, illimitati e senza filigrana” (thread n. 4, n. 5) viene liquidata come irrealistica dalla stessa comunità. Le risposte che spiegano la realtà dei costi delle GPU cloud dominano i commenti principali.
- Contrapposizione: nei thread n. 1 e n. 7 il dibattito si divide sul fatto che la divulgazione dell'uso della GenAI sia positiva o negativa. Nel thread Vocaloid, sia la difesa secondo cui dichiararlo è comunque più onesto sia la critica secondo cui è triste che persone di talento ricorrano all'IA sono entrate tra i commenti principali: il fenomeno non è spiegabile con un semplice sì/no.
- Elemento sorprendente: i punteggi più alti sono stati ottenuti dal thread sull'azione legale contro immagini IA malevole di idol K-pop (n. 8, 730 pt) e dalla polemica sul videoclip Vocaloid (n. 7, 327 pt), molto più delle discussioni sugli strumenti (n. 5, n. 12 ecc.). Le storie relative a danni alle persone ed etica dell'IA generano reazioni molto più forti dei trend tecnici stessi. L'interesse per abusi e conflitti sul diritto all'immagine è più facilmente visibile.
Limiti
- Il criterio di completamento del brief era analizzare circa 20 post per piattaforma, ma sono stati raccolti soltanto 12 thread. È stata usata una sola query, “Image and Video Generation AI News”, senza ricerche aggiuntive separate per “closed source” e “open source” (sono stati letti direttamente i risultati del worker, senza ulteriori ricerche da parte di questo agente).
- Non c'è traccia in threads.md di ricerche fallite o senza risultati. Tutti e 12 gli elementi sono quindi risultati da questa unica query; la quantità insufficiente può dipendere dalla ristrettezza della query.
- Per i thread n. 7 (Vocaloid), n. 8 (kpop), n. 9 (StableDiffusion) e n. 10 (GenAI4all) non è stato registrato il testo iniziale: la valutazione si basa soltanto su titolo e commento principale.
X
X — Notizie sull'IA per la generazione di immagini e video
##Nota importante sui dati raccolti
Dopo aver verificato output/x.posts.md, le query usate per la raccolta X sono risultate:
“Spain”, “Tesla”, “JubJub”, “Holy”, “Italy”, “#bb28”, “Elon”, “Croat”, “Donald”
e “Roman”. Non sono il risultato di ricerche sul tema (IA closed/open source per immagini e video), ma i termini di tendenza di X Explore riportati nella tabella iniziale “What X says is happening” di output/x.posts.md (trend visibili da una sessione geolocalizzata in Croazia) e riutilizzati come query.
Per questo motivo, i 40 post raccolti (37 account) riguardano soprattutto calcio (Spagna contro Croazia), sistemi di assistenza alla guida Tesla, WWE, Big Brother (#bb28), dichiarazioni politiche di Donald Trump e altri argomenti estranei al tema.
Quanto segue è un resoconto onesto basato sui dati realmente raccolti, ma occorre precisare in anticipo che non rappresenta le tendenze dell'IA per la generazione di immagini e video.
Account
La maggior parte dei 37 account raccolti ha contribuito con un solo post; non sono stati trovati autori pertinenti al tema. Solo i seguenti hanno più post, e sono comunque fuori tema:
- @ryu15 (Ryu) — 2 post, appunti tecnici personali sull'esecuzione di VRChat con una “Tesla V100” (non il sistema di guida autonoma Tesla, ma una GPU il cui modello è stato intercettato casualmente)
- @grouchoskie (Grouch Oskie) — 2 post, messaggi quotidiani
- @reigns_era (Roman Reigns SZN) — 2 post, fan post relativi a Roman Reigns della WWE
In questo dataset non sono presenti account che pubblichino regolarmente sul tema IA per immagini o video.
Post
Solo pochissimi post contengono parole apparentemente vicine al tema, come “AI” o “generazione”, ma nessuno riguarda davvero modelli di generazione di immagini/video. Li riportiamo per riferimento.
-
@rammcodes (Ram Maheshwari) — 276 like, 51 repost, 4 risposte, circa 15.000 visualizzazioni, 2026-09-29
https://x.com/rammcodes/status/2104962267267944848
“Holy Sh*t... this is like PDF parsing on steroids... A free, open-source PDF parser that converts PDFs into AI-ready Markdown, JSON, and HTML.”
→ Presentazione di un parser PDF open source, ma in un ambito diverso dall'IA per immagini/video: analisi di documenti e strumenti RAG. -
@LuisBizarro (Luis Bizarro) — 930 like, 48 repost, 37 risposte, circa 52.000 visualizzazioni, 2026-09-29
https://x.com/LuisBizarro/status/2104780688113455342
“Another AI slop and vibe coded experiment... based on Neon Genesis Evangelion. This took me like 45 minutes and three prompts. This is all Three.js and WebGL.”
→ Esperienza 3D interattiva realizzata con “vibe coding” assistito dall'IA in Three.js/WebGL; non riguarda modelli per la generazione di immagini o video. -
@thomasunise (Thomas Unise) — 732 like, 48 repost, 43 risposte, circa 111.000 visualizzazioni, 2026-09-29
https://x.com/thomasunise/status/2105003307232059397
“Elon is diabolical OpenAI drops dots https://Dot.com goes to Grok Bot”
→ Post su una frecciata relativa a domini e OpenAI/Grok, non una notizia tecnica sui modelli generativi. -
@LinusEkenstam (Linus ✦ Ekenstam) — 2.640 like, 408 repost, 354 risposte, circa 344.000 visualizzazioni, 2026-09-30
https://x.com/LinusEkenstam/status/2105212016583422270
“This video is going Viral everywhere. A trillionaire and a pile of billionaires are unable to answer a simple question about regular laptop jobs...”
→ Video con figure note dell'industria IA, tra cui Dario, ma il tema è il lavoro, non l'evoluzione tecnica dell'IA video.
Gli altri 36 elementi — calcio Spagna-Croazia, lamentele sull'autoguida Tesla, fan post su JubJub, Big Brother #bb28, WWE e dichiarazioni politiche di Trump — non hanno alcuna relazione con l'IA per immagini/video.
Segnali
- Non sono stati rilevati segnali chiari sul tema. Nei 40 post raccolti non compare alcuna menzione di IA closed source (Midjourney, Sora, Runway, Veo, Flux Kontext ecc.) o open source (Stable Diffusion, Wan, HunyuanVideo, ComfyUI ecc.) per immagini/video.
- L'unico risultato utile è un segnale relativo al processo di raccolta stesso: le query sono state riutilizzate dai trend regionali di X Explore per la Croazia e non avevano relazione con il tema del brief. Questo problema della logica di raccolta è la scoperta principale di questo ciclo.
Limiti
- Il vincolo principale è che le query non erano pertinenti al tema. I dieci termini “Spain”, “Tesla”, “JubJub”, “Holy”, “Italy”, “#bb28”, “Elon”, “Croat”, “Donald” e “Roman” non derivano dal tema dell'IA per immagini/video, ma dai trend di X Explore osservati da una sessione geolocalizzata in Croazia. Di conseguenza, su 40 post la pertinenza effettiva è zero.
- Non è stata eseguita nemmeno una ricerca con termini direttamente pertinenti quali “Midjourney”, “Sora”, “Stable Diffusion”, “Runway”, “Flux”, “Veo”, “Kling” o “HunyuanVideo”. Questa fase X non dice, di fatto, nulla sul tema.
- Anche la tabella Explore dei trend (Spain / Tesla / JubJub / Holy / Italy / #bb28 / Elon / Croat / Donald / Roman) è limitata a una prospettiva da server croato e non dovrebbe essere trattata come tendenza globale.
- In conclusione, i dati di questo ciclo non consentono di riportare osservazioni valide sulle tendenze di IA closed/open source per immagini e video su X. Una nuova raccolta richiede query pertinenti al tema, come nomi di modelli, strumenti e aziende.
YouTube
YouTube — Ultime notizie sull'IA per la generazione di immagini e video (closed source/open source)
Canali
- AI WITH Rithesh (@RitheshSreenivasan) — Canale internazionale su strumenti IA. Ha testato Qwen-Image-2.1 lo stesso giorno.
- Daily AI Roundup (@ai_roundup) — Canale di riepilogo quotidiano delle notizie IA. Presenta il lancio di Qwen-Image-2.1 in formato notiziario.
- Veteran AI (@VeteranAI-y1r) — Canale specializzato in workflow ComfyUI. Tratta in sequenza LTX 2.5 e Qwen Image 2.1.
- MaxonShire (@MaxonShire) — Canale di confronti e test per generazione video IA locale, centrato soprattutto su HunyuanVideo e serie Wan.
- 動画編集の中の人 — In giapponese; forte nei confronti tra strumenti a pagamento per generazione di immagini IA.
- AI大学【AI&ChatGPT最新情報】 (@AIAIChatGPT-cj4sh) — In giapponese; soprattutto video esplicativi e guide per principianti sugli strumenti IA.
- AIで創作効率化とマネタイズby呪喝蛙 (@AI_aaafrog) — In giapponese; presentazioni di modelli ComfyUI e contenuti orientati alla monetizzazione.
- TBS NEWS DIG — Canale ufficiale di notizie TBS. Ha trattato Sora 2 nel formato dei servizi televisivi news23.
Il numero di iscritti non era disponibile dai risultati oEmbed/di ricerca raccolti, poiché le pagine dei video mostrano tale dato solo dopo il rendering JavaScript (vedere Limiti).
Video
-
“Qwen-Image-2.1 Is INSANE… Just 7B Parameters?!” — AI WITH Rithesh / fine settembre 2026 (subito dopo il lancio di Qwen-Image-2.1 del 2026-09-20) / https://www.youtube.com/watch?v=3qGl0wiv2G0 — presenta il modello open-weight da 7B di Alibaba, con generazione PNG trasparente, fino a 10 immagini di riferimento e output 2K nativo, come comparabile ai grandi modelli closed.
-
“A 7B Model That Beats Nano Banana 2.0? Master Qwen Image 2.1: Native 2K, RGBA & 10-Image Workflows” — Veteran AI / fine settembre 2026 / https://www.youtube.com/watch?v=fwHS0ubmI7I — spiegazione del workflow ComfyUI di Qwen-Image-2.1. Il video ruota attorno alla tesi che un benchmark indipendente lo collochi sopra Nano Banana 2.0 (closed); anche Tom's Hardware riporta Qwen Image Benchmark 60.2 contro 59.82 per Nano Banana 2.0.
-
“Alibaba Open-Sources Qwen-Image-2.1, A 7B Model With Native Transparency” — Daily AI Roundup / fine settembre 2026 / https://www.youtube.com/watch?v=cdZ4E7_kiJY — notizia rapida sull'apertura di Qwen-Image-2.1. Il punto di forza è il supporto nativo alla trasparenza, cioè al canale alfa.
-
“Master LTX 2.5 in ComfyUI: Multi-Shot, First-Last Frame & 2K Workflows” — Veteran AI / metà agosto 2026 (i risultati indicano circa 40–48 giorni dalla pubblicazione) / https://www.youtube.com/watch?v=6B9WSxi6j8E — guida pratica all'uso in ComfyUI del modello video interamente open source LTX 2.5, con multi-shot, indicazione di primo/ultimo frame e workflow 2K.
-
“LTX 2.5 is a New Free and Opensource AI Video Model that is Insanely Fast in Generation” (Shorts) — metà agosto 2026 / https://www.youtube.com/shorts/h8qy-MBDzho — breve presentazione della velocità di generazione di LTX 2.5.
-
“使わにゃ損損!お得に生成するならComfyUI一択!2026年おすすめ生成モデルベスト!” — AIで創作効率化とマネタイズby呪喝蛙 / 2026 (i risultati indicano circa 172 giorni dalla pubblicazione, quindi relativamente datato) / https://www.youtube.com/watch?v=qmiPya-U2KM — panoramica dei migliori modelli open source per ComfyUI nel 2026, inclusi immagini, video, musica, voce e 3D.
-
“【ドS課金して判明】2026年おすすめ画像生成AIはコレ!NanoBananaPro・Seedream4.0・Midjourney・AdobeFireflyを徹底比較します!” — 動画編集の中の人 / 2026 (recente, data precisa non confermata) / https://www.youtube.com/watch?v=vJLDbXaSKW4 — confronto basato su abbonamenti effettivamente acquistati per quattro servizi closed source: Nano Banana Pro, Seedream 4.0, Midjourney e Adobe Firefly.
-
“【画像生成AIの頂点】Google最新の画像生成AI「Nano Banana 2(ナノバナナ)」を無料で使い倒す!最短スタート完全ガイド!” — AI大学【AI&ChatGPT最新情報】 / 2026 (Nano Banana 2 è stato pubblicato il 2026-02-26–27 e il video continua a essere visto successivamente) / https://www.youtube.com/watch?v=Asuw6jHVcSs — guida per principianti all'avvio gratuito di Nano Banana 2 (Pro), basato su Gemini 3 Pro.
-
“【Google Flow完全ガイド】無料で使えるAI映像制作ツールが超進化!Gemini Omni Flash・ナノバナナを使って動画や画像を作れる!” — AI大学【AI&ChatGPT最新情報】 / dopo maggio 2026 (menziona l'aggiunta di Gemini Omni Flash) / https://www.youtube.com/watch?v=dBFK1yFJXOA — illustra l'evoluzione di Flow, strumento integrato closed source di Google, che riunisce generazione di immagini Nano Banana e generazione video Veo.
-
“最新動画生成AI「Sora2」リアルな映像が約3分で生成可能に…実演でわかったその性能 一方で著作権への懸念も【news23】” — TBS NEWS DIG / 2026 / https://www.youtube.com/watch?v=_r9hojDlABM — servizio giornalistico su Sora 2, modello closed source, che ne mostra le capacità e solleva preoccupazioni di copyright. Un'altra ricerca indica che OpenAI abbia annunciato la fine di Sora il 24 marzo 2026, chiuso app/web il 26 aprile e programmato la fine dell'API Sora 2 per il 24 settembre 2026: circa sei mesi dopo questo servizio, Sora si è quindi avviato alla chiusura.
Segnali
- Slancio dell'open source: Qwen-Image-2.1 (Alibaba, pubblicato il 2026-09-20, 7B parametri, trasparenza nativa e supporto per 10 immagini di riferimento) è stato trattato subito da più canali. Al centro della diffusione ci sono benchmark indipendenti che lo dichiarano pari o superiore a Nano Banana 2.0. Continuano inoltre i video di confronto su modelli video gratuiti eseguibili in locale, come LTX 2.5, HunyuanVideo e Wan, e ComfyUI è ormai la piattaforma comune di fatto.
- Movimenti del closed source: i prodotti Google (Nano Banana 2 / Nano Banana Pro, Gemini Omni Flash e Flow) sono protagonisti ricorrenti sui canali giapponesi. Al contrario, Sora di OpenAI, dopo il clamore dell'inizio 2026, procede verso una chiusura graduale fra marzo e settembre (fine di web/app, poi dell'API). Questo alimenta una narrazione di grandi piattaforme closed molto forti appena lanciate, ma dalla continuità incerta.
- Distribuzione linguistica: i canali giapponesi (AI大学, 動画編集の中の人, 呪喝蛙) si concentrano più sui confronti pratici e sulle guide closed source; quelli inglesi (Veteran AI, AI WITH Rithesh, Daily AI Roundup, MaxonShire) sui workflow ComfyUI open source e sugli aggiornamenti dei benchmark.
Limiti
- Le pagine YouTube dei video e dei risultati (
/watch,/results) hanno restituito tramite WebFetch soltanto HTML statico con i link di navigazione del footer. Elementi dinamici quali visualizzazioni, like, iscritti e commenti non erano direttamente disponibili. - In alternativa, l'API YouTube oEmbed (
/oembed?url=...&format=json) ha fornito soltanto titolo e canale; visualizzazioni e date si basano su snippet dei risultati di ricerca, con espressioni relative come “X giorni fa”. Alcune date sono quindi indicative, non precise. - Alcuni ID video, come
yVMs1Z-FWmQ, il russo03MX2U8ZLDke lo spagnolojH0AjVP49KI, apparivano nei risultati ma non sono stati approfonditi per priorità di lingua e pertinenza. - Non è stato possibile recuperare il contenuto dei commenti principali, poiché WebFetch non effettua il rendering dell'area commenti.
Bluesky
Bluesky — Notizie sull'IA per la generazione di immagini e video
Nota sul metodo di raccolta
L'endpoint indicato nel playbook, https://public.api.bsky.app/xrpc/app.bsky.feed.searchPosts?q=..., è stato provato con più query — Midjourney, "Stable Diffusion", cat e altre — ma ha restituito HTTP 403 ogni volta, rendendo impossibile il suo uso (anche la versione web di bsky.app/search è una SPA renderizzata in JavaScript e non consentiva di recuperare il contenuto). Al contrario, app.bsky.actor.getProfile, app.bsky.feed.getAuthorFeed e app.bsky.unspecced.getTrendingTopics hanno funzionato normalmente. Si è quindi adottato un metodo alternativo: trovare account potenzialmente pertinenti tramite WebSearch e leggere direttamente il loro getAuthorFeed. I dettagli sono in ## Limiti.
Account
-
dfl.bsky.social (DFL inc.)
https://bsky.app/profile/dfl.bsky.social
Account personale che pubblica quasi ogni giorno immagini di paesaggi giapponesi dall'aspetto fotografico, generate con “Nano Banana 2” di Google. Era ancora attivo a settembre 2026 e rappresenta il caso d'uso closed source continuo più chiaramente osservabile. -
doctordiffusion.bsky.social
https://bsky.app/profile/doctordiffusion.bsky.social
Creatore open source che sviluppa e distribuisce LoRA e modelli per Stable Diffusion 3.5, Flux Dev, HunyuanVideo e LTX-Video su Civitai e Hugging Face. Tuttavia, le pubblicazioni si fermano tra novembre 2024 e marzo 2025 e non è stata verificata attività nel 2026. -
emanuelmaiberg.bsky.social (Emanuel Maiberg, giornalista di 404 Media)
https://bsky.app/profile/emanuelmaiberg.bsky.social
Continua a investigare e pubblicare sugli abusi dell'IA per immagini/video, inclusi deepfake, immagini generate senza consenso e impersonificazioni di celebrità tramite musica IA. Ha continuato a pubblicare anche nell'agosto-settembre 2026 ed è uno degli account più stabilmente rilevanti su Bluesky per questo tema. -
midjourneyofficial.bsky.social (Midjourney ufficiale)
https://bsky.app/profile/midjourneyofficial.bsky.social
Ha annunciato l'arrivo su Bluesky nell'agosto 2025, ma gli ultimi post risalgono all'8 ottobre 2025; non è stata trovata attività nel 2026. È un esempio della debolezza dell'uso di Bluesky da parte delle aziende ufficiali closed source. -
stablediffusion.bsky.social (“Stable Diffusion online AI”)
https://bsky.app/profile/stablediffusion.bsky.social
Account di comunità di IA art con circa 1.800 follower. I post arrivano soltanto fino a febbraio 2025, senza aggiornamenti successivi. -
wagahai-ai.bsky.social
https://bsky.app/profile/wagahai-ai.bsky.social
Account personale giapponese che pubblica illustrazioni e video IA. Anche qui non sono stati verificati post dopo gennaio 2025.
Post
-
@dfl.bsky.social — 2026-09-30, 14 like, 1 repost
https://bsky.app/profile/dfl.bsky.social/post/3mwr727gyck26
“AI image generation #Nano Banana 2 ... un canale attraversato da riflessi dorati”. Paesaggio giapponese generato con il modello closed source Nano Banana 2 di Google. -
@dfl.bsky.social — 2026-09-25, 51 like, 2 repost (miglior engagement negli ultimi 20 post)
https://bsky.app/profile/dfl.bsky.social/post/3mwesrcxg5k2c
“#Nano Banana 2 ... una vista ampia lungo il fiume, argini in pietra e case giapponesi in lontananza”. -
@dfl.bsky.social — 2026-09-21, 45 like, 2 repost
https://bsky.app/profile/dfl.bsky.social/post/3mw2ny6hsa22p
“#Nano Banana 2 ... un vecchio ponte di legno, un ruscello e un fresco crepuscolo”. È confermata una pubblicazione quotidiana e una risposta stabile nell'ordine di 30–50 like. -
@doctordiffusion.bsky.social — 2025-01-19, 3 like, 4 risposte
https://bsky.app/profile/doctordiffusion.bsky.social/post/3lg36y7u2i22x
“SD3.5 Lives! Rilasciato Absynth 2.0”. Distribuzione gratuita su Civitai/Hugging Face di un fine-tune di Stable Diffusion 3.5 Large: un rilascio grassroots tipicamente open source. -
@doctordiffusion.bsky.social — 2025-01-01, 1 like, 2 risposte
https://bsky.app/profile/doctordiffusion.bsky.social/post/3leofdsx6yc23
Condivide, con tag #opensource, una scoperta tecnica: l'allineamento dei text encoder di Flux Dev e Stable Diffusion 3.5 ha stabilizzato l'addestramento. -
@doctordiffusion.bsky.social — 2024-11-26, 4 like
https://bsky.app/profile/doctordiffusion.bsky.social/post/3lbssdeocz226
Estensione di un video in ComfyUI usando Img2Vid di LTX-Video e nodi personalizzati: esempio pratico di generazione video open source con LTX-Video/Mochi. -
@emanuelmaiberg.bsky.social — 2026-08-20, 14 like, 6 repost
https://bsky.app/profile/emanuelmaiberg.bsky.social/post/3mtjegiaxpk2h
Resoconto di un'inchiesta di 404 Media secondo cui le immagini IA non consensuali stanno diventando sempre più “subtle”, cioè difficili da riconoscere. -
@emanuelmaiberg.bsky.social — 2026-08-17, 36 like, 9 repost
https://bsky.app/profile/emanuelmaiberg.bsky.social/post/3mtbvku5wds2p
Podcast con il ricercatore di deepfake Hany Farid sui “passato, presente e futuro” dei media sintetici. -
@midjourneyofficial.bsky.social — 2025-08-15, 41 like, 4 repost, 14 risposte
https://bsky.app/profile/midjourneyofficial.bsky.social/post/3lwi222j4sk2b
“#Midjourney is now on BlueSky! Who are the best creators we should follow?” Primo post dell'account ufficiale al suo ingresso su Bluesky. In seguito, solo post sporadici fino a ottobre 2025.
Segnali
- Su Bluesky gli opinion leader dell'IA parlano più di LLM e agenti che di generazione di immagini/video. Sono stati controllati i post recenti di settembre 2026 di figure come Tim Kellogg (@timkellogg.me) ed Ethan Mollick (@emollick.bsky.social), con oltre 10.000 follower: erano incentrati su GPT-6.1, Gemini 4 e funzioni agentiche di Claude, senza menzioni di Midjourney, Stable Diffusion, Sora, Wan o Kling.
- I casi closed source compaiono come utilizzo quotidiano di utenti individuali, non come comunicazione aziendale. Mentre l'account ufficiale Midjourney è quasi silenzioso, account come dfl.bsky.social continuano a pubblicare ogni giorno opere realizzate con Nano Banana 2 di Google.
- La comunità dei creatori open source — distribuzione di LoRA e workflow ComfyUI — sembra ormai in calo su Bluesky. doctordiffusion, wagahai-ai e stablediffusion smettono tutti di aggiornarsi nella prima metà del 2025; la loro ultima fase di vivacità potrebbe essere stata tra fine 2024 e inizio 2025.
- La voce più continuativa sull'IA generativa per immagini/video è quella della critica e del giornalismo. Emanuel Maiberg di 404 Media continua a pubblicare su deepfake e immagini non consensuali anche nell'agosto-settembre 2026, offrendo i contenuti più attuali rilevati sul tema.
- Da ciò deriva la scoperta principale di questo ciclo: Bluesky non è un centro principale di discussione per le notizie su IA closed/open source di immagini e video. Come X, ha prodotto pochi post recenti direttamente pertinenti.
Limiti
app.bsky.feed.searchPosts(l'API pubblica di ricerca) ha restituito costantemente HTTP 403. Questo è avvenuto con “Midjourney”,"Stable Diffusion"e “cat”, apparentemente indipendentemente dalla query.app.bsky.unspecced.searchPostsSkeletonrestituiva HTTP 501. InvecegetProfile,getAuthorFeedegetTrendingTopicsfunzionavano. In sintesi, gli endpoint pubblici di lettura erano disponibili, ma la ricerca full-text era bloccata dall'ambiente di esecuzione.- Anche la ricerca web
bsky.app/searchè una SPA renderizzata in JavaScript e WebFetch non ha potuto recuperare il testo dei post, soltanto stringhe del titolo. - Per questo non è stato possibile effettuare la raccolta per parole chiave prevista dal playbook; è stato adottato il metodo alternativo WebSearch +
getAuthorFeed. Questo legge accuratamente i post recenti degli account individuati, ma non consente una visione esaustiva dell'intera piattaforma. - I post su MiniMax H3 di sungkim.bsky.social e ekazakos.bsky.social, rilevati attraverso WebSearch, non sono apparsi tra gli ultimi 30 elementi di
getAuthorFeed, probabilmente perché risalivano alla fine di luglio 2026. Non sono quindi inclusi, privilegiando la regola di usare soltanto contenuti realmente letti durante questo ciclo. - doctordiffusion.bsky.social, wagahai-ai.bsky.social e stablediffusion.bsky.social erano gli account più direttamente legati al tema trovati, ma sono inattivi dalla prima metà del 2025 e non rappresentano notizie recenti a settembre-ottobre 2026. Gli unici account effettivamente attivi individuati sono dfl.bsky.social (uso closed source) ed emanuelmaiberg.bsky.social (giornalismo critico).
- Non è stato raggiunto il criterio di analizzare circa 20 post. Senza ricerca full-text, sono stati identificati soltanto poco più di una decina di post rilevanti, di cui circa metà del 2024–2025. La conclusione onesta è che Bluesky ha meno da dire sul tema rispetto alle altre piattaforme.
Lemmy
Lemmy — Notizie sull'IA per immagini e video (closed/open source)
Data della ricerca: 2026-10-01. Sono state usate l'API di ricerca Lemmy (/api/v3/search) e l'API per gli elenchi di post delle comunità, cercando nelle comunità stable_diffusion, imageai, fuck_ai, technology e altre, oltre che trasversalmente con le parole chiave FLUX.2, Qwen-Image, Nano Banana, Midjourney, Grok Imagine, Sora, Veo e Kling.
Comunità
- !«メールアドレス» — 5.713 iscritti / 1.423 post. La comunità Lemmy più attiva per informazioni tecniche su IA per immagini/video: workflow ComfyUI, LoRA e nuovi modelli. Qui compaiono anche gli annunci di AI Horde, progetto distribuito e gratuito di generazione immagini gestito da dbzer0.
- !«メールアドレス» — 8.532 iscritti / 4.680 post. Spazio per immagini generate dall'IA di qualunque modello. I post sono soprattutto opere, non notizie, e molti ricevono punteggi negativi, mostrando l'atteggiamento freddo di Lemmy verso la produzione IA.
- !«メールアドレス» — 8.333 iscritti. Comunità anti-IA che condivide articoli critici sull'industria. Le notizie di polemiche e cause sul closed source tendono a concentrarsi qui.
- !«メールアドレス» — Comunità tecnologica generale. Qui le grandi notizie closed source, come il caso Google Earth, hanno ottenuto i punteggi più alti.
- !«メールアドレス» — 53 iscritti. Comunità bot che ripubblica automaticamente via RSS da Reddit (r/ArtificialIntelligence); attenzione, non si tratta di discussione originale di Lemmy.
Post
Orientati all'open source (tutti in !«メールアドレス»)
- Qwen-Image-2.1 in ComfyUI: Open-Weight Image… — 2026-09-22, score 13.
Articolo blog.comfy.org sul supporto ComfyUI per Qwen-Image-2.1, modello di immagini open-weight di Alibaba. È stato il post col punteggio più alto della ricerca. - WebUI for qwen-image-2.1 — 2026-09-27, score 2. Progetto che rende Qwen-Image-2.1 compatibile con una WebUI leggera in stile Fooocus.
- Few-step LoRA adapters for Qwen-Image-2.1 — 2026-09-26, score 0. LoRA che riduce i passaggi di generazione per accelerare il modello.
- Long, seamless multi-shot video continuations — 2026-09-29, score 4. Workflow di generazione video che usa MiniMax-H3-Latent per collegare più inquadrature senza stacchi visibili.
- Free, local, open source video editor with AI — 2026-09-29, score 5. Editor video IA locale “vlo”.
- LanPaint — training-free inpaint for every model — 2026-09-29, score 8. Metodo per aggiungere inpainting di alta qualità ai modelli esistenti senza addestramento aggiuntivo.
- Tiny 100M-parameter text-to-image model (Supra2-IMG) — 2026-09-22, score 7. Modello text-to-image estremamente leggero, eseguibile con poca VRAM.
- AI Horde — New Interface & Documentation — 2026-09-19, score 8. Annuncio del rinnovamento di interfaccia e documentazione per il servizio distribuito e gratuito di generazione immagini gestito da dbzer0.
Orientati al closed source
- Google Earth's new AI image generation function didn't survive a day after users deepfaked disasters — 2026-08-01, score 473 (!«メールアドレス»). La funzione IA di Google Earth con Nano Banana/Gemini è stata fermata in meno di un giorno dopo abusi per creare immagini contraffatte di disastri. È uno dei punteggi più alti dell'intera ricerca.
- Tennessee Teens Sue Elon Musk's xAI Over Child Sexual Abuse Images — 2026-03-17, score 13 (comunità Mother Jones). Causa relativa a immagini di abuso sessuale su minori generate da Grok Imagine di xAI; si sostiene che in 11 giorni siano state generate circa 23.000 immagini di questo tipo.
- Disney, Universal sue image creator Midjourney for copyright infringement — 2025-06-11, score 88 (!«メールアドレス»). Pur essendo più vecchia, la causa per copyright contro Midjourney continua a essere citata come contesto di una disputa ancora in corso.
- Same Berserk spread, 4 AI colorizations. Looks like GPT wins again? — 2026-09-14, score 1 (tramite !«メールアドレス»). Mirror di un thread Reddit che confronta la colorazione automatica di un manga con più modelli, incluso Nano Banana Pro. Non è un post originale di Lemmy.
Segnali
- Il lato open source è quasi interamente l'ecosistema ComfyUI. Workflow derivati, LoRA ed estensioni di nodi per FLUX.2 (Black Forest Labs) e Qwen-Image, soprattutto 2.1 di Alibaba, vengono pubblicati ogni giorno. Per frequenza e concretezza tecnica, questa è di gran lunga l'area più densa di Lemmy. Anche infrastrutture gratuite e distribuite come AI Horde si accordano bene con l'atmosfera anti-commerciale e fai-da-te della piattaforma.
- La generazione video resta una nicchia nella nicchia. I post su MiniMax-H3 e strumenti video locali autoprodotti sono meno numerosi di quelli sulle immagini e hanno punteggi più modesti, attorno a 4–8.
- Le notizie closed source arrivano attraverso polemiche e cause, non presentazioni di funzioni. Google Earth/Nano Banana, Grok Imagine e Midjourney entrano in !technology e !fuck_ai in occasione di abusi o azioni legali, con punteggi elevati. Il post su Google Earth (score 473) spicca in modo particolare.
- L'atteggiamento verso i contenuti generati dall'IA è generalmente freddo. In !«メールアドレス» quasi metà dei post ha punteggi negativi (da -18 a -3), e il solo fatto che siano “arte IA” sembra costituire un elemento penalizzante. Anche l'esistenza di !fuck_ai, con 8.333 iscritti, racconta molto del clima della comunità.
Limiti
- Lemmy è relativamente piccola e non è stata trovata una comunità dedicata al closed source per immagini/video, simmetrica a !stable_diffusion open source. Le osservazioni sul closed source si limitano quindi a comunità generiche come !technology e !fuck_ai.
- Le ricerche per “Veo 3” e “Kling AI” non hanno prodotto post Lemmy sostanziali, solo risultati irrilevanti. Anche per Sora è emerso un solo riferimento in un meme, non discussioni sul modello video stesso.
- L'accesso diretto alla pagina della comunità
lemmy.world/c/stablediffusionha fallito con errore 500; sono state usate informazioni da ricerche API. Anchelemmy.today/api/v3/communityha restituito 404 e ci è voluto tempo per identificare lemmy.dbzer0.com come istanza principale effettiva. - !«メールアドレス» è una comunità bot da 53 membri che ripubblica RSS da Reddit, non una conversazione originale Lemmy. È stato incluso un solo elemento a titolo di riferimento.
- Non sono state trovate comunità o post Lemmy in giapponese nell'ambito della ricerca.
- Questa fase riguardava solo Lemmy; rispetto al criterio di circa 20 post analizzati per social, sono stati esaminati oltre 60 post/commenti tramite ricerca API ed elenchi di comunità e sono stati selezionati gli 11 più rappresentativi sopra riportati.
Pinterest — Notizie sull'IA per la generazione di immagini e video
Il worker ha raccolto 50 pin per la query “Image and Video Generation AI News” (un unico lotto, senza divisione per genere). Tutti e 50 sono stati aperti ed esaminati.
Temi visivi
- Androidi umanoidi cromati/bianchi come “volto dell'IA” — occhi blu luminosi, giunti metallici esposti e talvolta abiti eleganti. Usati per tutto: spiegazioni generiche, notiziari e contenuti etici. [1, 16, 19, 20, 24, 29, 30, 35, 45]
- Sfondo blu scuro/nero con bagliore al neon ciano-viola e circuiti — la palette predefinita per miniature di spiegazioni IA e listicle; al centro, un cervello con circuiti o la scritta luminosa “AI”. [2, 9, 14, 21, 28, 33, 40, 42, 50]
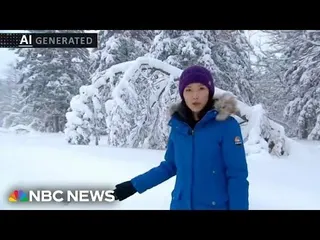
- Ansia sul tema “l'IA sostituisce i giornalisti / fake news” — conduttori IA dietro banchi di notiziari, timbri “FAKE”, UI di rilevamento deepfake e loghi reali di emittenti (NBC) con filigrana “AI GENERATED”. [1, 6, 23, 31, 35, 36, 44]
- Grafiche della dicotomia umano contro IA — mani divise a schermo (dita umane contro robotiche), lente d'ingrandimento su tastiera, didascalie “Human or AI?”. [30, 31]
- Immaginario distopico/IA malvagia — un demone “AI” cornuto e dagli occhi rossi che manovra zombi incollati ai telefoni, usato con titoli allarmistici come “AI is getting scary good”. [17, 23]
- Listicle di strumenti e grafici comparativi — prodotti reali come Runway, Pika, Kling AI, Luma/Dream Machine, Canva AI, Hailuo, Midjourney, Adobe Firefly, Recraft, Kaiber, Ideogram, SeaArt e Krea, presentati in infografiche tipo “migliori a pagamento vs. migliori gratuiti” o “oltre 6 migliori siti”. [5, 15, 40]
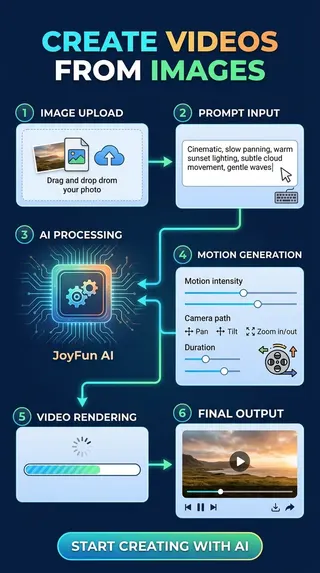
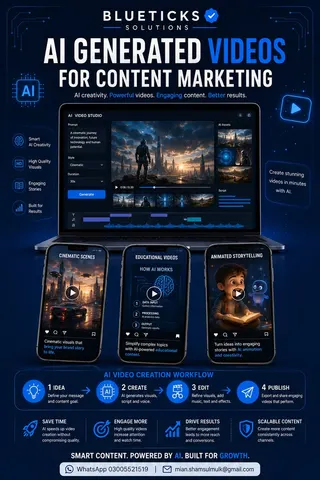
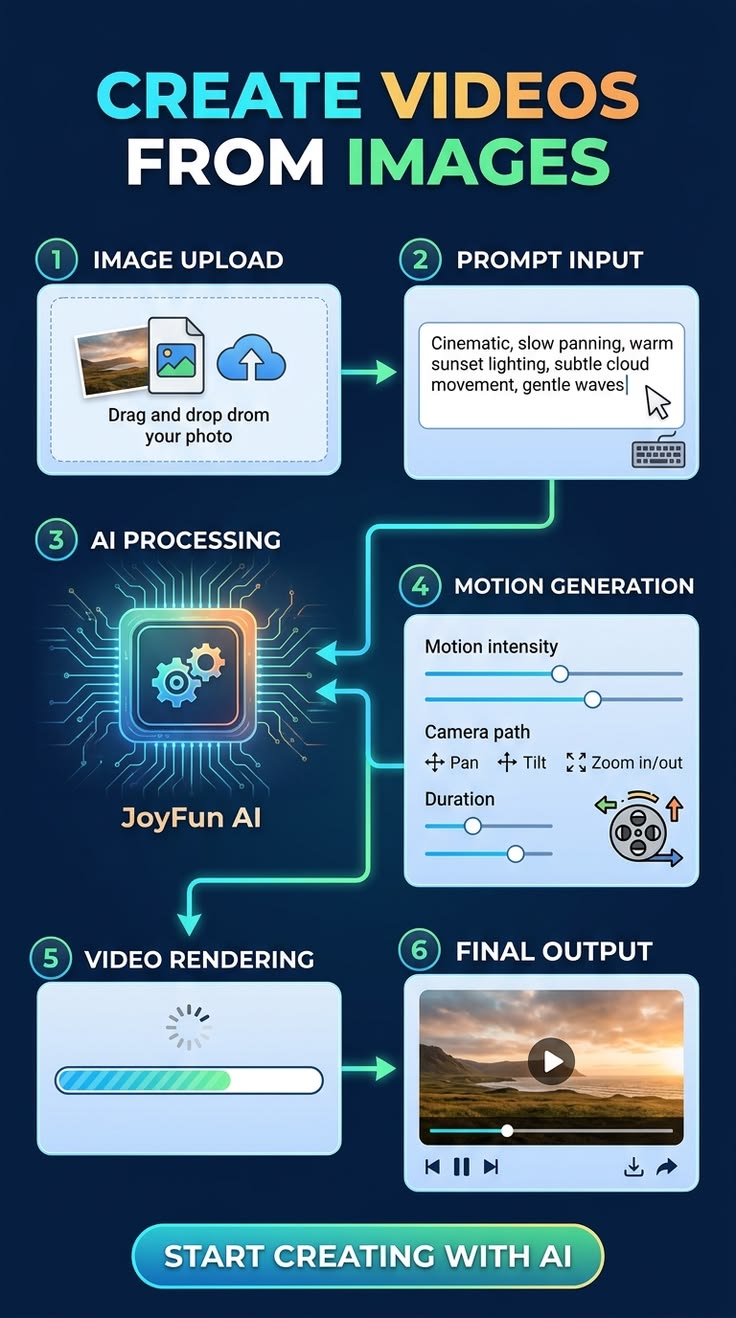
- Screenshot di vere demo prodotto — mockup UI passo per passo per workflow image-to-video (caricamento → prompt → slider del movimento → rendering), con branding di piccoli strumenti SaaS come JoyFun AI e Blueticks. [8, 10]
- Demo di trasformazioni fotorealistiche/stilizzate — una foto sorgente trasformata affiancata in versioni di blocchi di legno, origami, Lego, fiori e mattoncini giocattolo (Lumalabs), oltre a un'immagine composita di una statua di marmo che suona il violoncello e a un ritratto di pescatore attribuito ad AMD/“Amuse 3.0”. [4, 15, 38]
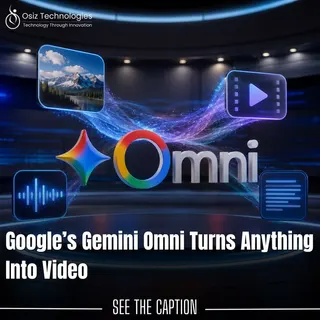
- Collage di marketing dei grandi modelli — Google Veo 2 (la stessa immagine promozionale ufficiale riutilizzata in due pin non correlati), Gemini Omni “trasforma qualunque cosa in video”, Meta “Muse Spark” 2026. [17, 24, 32, 3]
Pin degni di nota
- Preoccupazioni su contenuti IA e social media [1] — robot che scorre un telefono accanto a un timbro “FAKE” e a una sospetta foto di gatto; classico contenuto-esca sull'ansia da deepfake.
- Meta Unveils Muse Image and Muse Video Generative... [3] — presenta un modello “Muse Spark” del 2026 come progetto di assistente personale/superintelligenza, non solo come strumento per contenuti.
- (senza titolo, griglia di trasformazioni Lumalabs) [4] — un video sorgente viene trasformato in versioni di blocchi di legno, origami, mattoncini Lego e fiori per una persona, un cane e un'auto; è la demo prima/dopo delle capacità più chiara del set.
- Create Videos From Images [8] — mockup UI completo in sei passaggi (caricamento → prompt → elaborazione IA → slider del movimento → rendering → output) per uno strumento chiamato “JoyFun AI”.
- Transform your ideas into stunning visuals! [15] — una statua di marmo iperrealistica che suona il violoncello, usata per mostrare la generazione di immagini.
- (senza titolo, promo Veo 2) [17] — collage di lancio ufficiale di Google “Veo 2: our state-of-the-art video generation model” (cane che nuota, fenicotteri, ragazza animata); la stessa identica immagine viene riutilizzata con una didascalia differente nel pin 32.
- Google's Gemini Omni Turns Anything Into Video [24] — “qualsiasi input → qualsiasi output” presentato come la grande promessa di generalizzazione della generazione video di Google.
- ‘Amuse 3.0’, an AI art creation tool that includes... [38] — ritratto fotorealistico di un vecchio pescatore, con branding AMD, che suggerisce uno strumento locale per generazione immagini accelerato dall'hardware.
- Introducing Luma Dream Machine [43] — primissimo piano di un occhio sopra il logotipo “Dream Machine”, pura immagine di brand anziché schermata del prodotto.
- AI NEWS: May 20 2026 Google I/O recap infographic [35] — Gemini 3.5 Flash, Gemini Omni, Gemini Spark e occhiali Android XR, presentati come “il più grande evento IA”: un riepilogo notiziario datato e concreto, anziché una listicle senza tempo.
Segnali
- Il set è fortemente sbilanciato verso miniature SEO/blog — robot da immagini stock, scritte generiche “AI News”, listicle di strumenti — molto più numerose delle vere demo di arte generata.
- L'ansia per deepfake/disinformazione e “IA che sostituisce i giornalisti” è un filo narrativo ricorrente, non un caso isolato: appare in almeno 7 dei 50 pin, spesso con branding di emittenti reali come NBC o timbri “FAKE”.
- Strumenti nominati realmente compaiono spesso in listicle e demo: Veo 2/Gemini Omni (Google), Dream Machine/Luma, Runway, Pika, Kling AI, Canva AI, Hailuo, Amuse 3.0, Meta Muse Spark. Tuttavia sono soprattutto loghi e collage promozionali; gli unici screenshot di workflow pratici sono JoyFun AI e Blueticks.
- Assente: nessun nome visibile di modello open source o screenshot di strumenti locali (nessun ComfyUI, Automatic1111, Stable Diffusion UI, checkpoint o LoRA), nonostante “Stable Diffusion” compaia una volta nel titolo di un pin senza screenshot corrispondente; nessun contenuto di comunità IA per anime/illustrazione; nessuna demo di video narrativi multi-shot o coerenza, salvo l'unica griglia di trasformazioni Lumalabs.
- La stessa immagine promozionale ufficiale di Veo 2 è stata riutilizzata in due pin con testo circostante diverso [17, 32]: segnale che l'area “notizie IA” di Pinterest è in parte riciclata/aggregata, non commento originale.
Limiti
- In base al playbook, Pinterest non è stato esplorato direttamente: tutti i risultati provengono dalla lettura visiva dei 50 pin e delle immagini già raccolte dal worker in
output/pinterest.pins.mdeimages/pinterest/. - La tabella dei pin non ha sezioni di genere, essendo un unico lotto senza etichetta; i temi sono quindi ricavati dall'intero insieme, non genere per genere.
- Molti pin hanno titolo “(untitled)” e contengono solo immagini stock generiche, senza una fonte attribuibile oltre all'URL del pin né un modo per confermare data o engagement.
- Titoli e immagini includono marchi e affermazioni, come “Grok is revolutionizing video” o “GPT 5.2 ... full body control”, ma le immagini collegate sono grafiche stock e non schermate delle funzioni o dei prodotti. Non è stato possibile verificare tali affermazioni dalla sola immagine.
Azioni consigliate
- Raccogliere nuovamente la fase X con parole chiave direttamente legate al tema (Midjourney, Sora, Stable Diffusion, Wan, Kling ecc.)
- Valutare come affrontare il problema dell'API
searchPostsdi Bluesky che restituisce 403, usando un metodo di ricerca alternativo - Continuare a seguire l'adozione di Qwen-Image-2.1 e LTX 2.5 come indicatori del fronte open source
- Dare priorità alle notizie di abuso e polemica delle aziende closed source (Nano Banana/Google Earth, causa Grok Imagine)
- Suddividere le query Reddit per ampliare la raccolta e raggiungere il criterio di circa 20 elementi
Immagini raccolte


































Nota sulla qualità dei dati
X ha raccolto soltanto dati estranei al tema per un errore nella scelta delle query ed è quindi, di fatto, privo di dati utili. Anche Bluesky e Reddit non hanno raggiunto il criterio di circa 20 elementi, mentre Lemmy, Pinterest e YouTube hanno generalmente verificato una quantità sufficiente di materiale.