Notizie sull’IA per la generazione di immagini e video — 2026-09-27
La chiusura dell’API Sora sta scuotendo il panorama della generazione video closed-source, mentre l’ecosistema open-weight, guidato da Qwen-Image-2.1 e LTX-2.5, si sta espandendo rapidamente su più piattaforme fin dal lancio.
Sebbene la fine dell’API Sora stia ridisegnando il panorama della generazione video closed-source, l’ecosistema open-weight, con Qwen-Image-2.1 e LTX-2.5 in prima linea, si sta espandendo rapidamente su diverse piattaforme subito dopo il rilascio.
Notizie sull’IA per la generazione di immagini e video — 2026-09-27
La cosa che mi ha entusiasmato di più nel preparare questo riepilogo è che lo slancio del fronte open source non si ferma davvero più 🔥🔥 Qwen-Image-2.1, LTX-2.5 e gli altri hanno fatto sì che YouTube, Lemmy e Bluesky reagissero tutti insieme praticamente al momento del rilascio. Dall’altra parte, Sora 2 del mondo closed-source ha davvero chiuso i battenti (app il 26/4, API il 24/9), e sembra sia iniziato un gioco delle sedie tra Veo, Kling, Runway e Grok Imagine 🪑💨 Inoltre, su tutte le piattaforme è fortissima l’idea che “non bisogna nascondere ciò che è stato creato con l’IA”: dalle fotografie immobiliari ai concorsi scientifici, se si viene scoperti si rischiano facilmente polemiche e licenziamento 😱 Onestamente, i dati di X erano totalmente inutilizzabili, quindi lo dichiaro apertamente 🙏
Tra le piattaforme
- I nuovi modelli open-weight ricevono riscontri immediati su più piattaforme subito dopo il lancio. Qwen-Image-2.1 (Alibaba, 7B parametri, output con trasparenza) ha già avuto vari video di “Day 0 review” su YouTube; su !stable_diffusion di Lemmy sono comparsi, nel giro di pochi giorni, articoli sulla compatibilità con ComfyUI, LoRA e ControlNet; su Bluesky singoli creatori lo indicavano già nei propri profili come strumento usato. Anche LTX-2.5 (Lightricks, 22B parametri, audio sincronizzato) viene citato sia su YouTube sia su Bluesky. La velocità della risposta iniziale della comunità open source è davvero impressionante ⚡
- Il contraccolpo contro l’uso di IA “senza dichiarazione” è diventato un tema polemico trasversale. Su Reddit, lo stesso sdegno è emerso in tre contesti completamente diversi: foto di annunci immobiliari (26.980 pt), video vincitori di concorsi scientifici (oltre 1.100 pt) e licenziamento di un CEO per immagini pubblicitarie generate dall’IA (585 pt). Su Lemmy, il sostegno a una legge sui watermark e la causa Midjourney contro Hollywood, che chiede la divulgazione dell’uso dell’IA, seguono lo stesso filo conduttore; Pinterest ospita inoltre un’intera categoria di immagini che alimentano l’ansia per deepfake e disinformazione. Non è più una polemica isolata: sta diventando un tema strutturale 🔥
- Nano Banana (Google) è diventato di fatto il punto di riferimento per i confronti. Su YouTube compaiono sia video che presentano Grok Imagine 2.0 come “15 volte più economico di Nano Banana Pro”, sia video che descrivono l’open-source Qwen-Image-2.1 come “Better than Nano Banana”. Sia il mondo closed sia quello open lo stanno usando come metro di paragone 👀
- ComfyUI è l’infrastruttura comune della comunità di sviluppo. Reddit lo cita nei consigli per chi vuole creare video gratis in locale; YouTube nei video di installazione di LTX-2.5 e Qwen-Image-2.1; Lemmy in oltre cinque nodi estesi pubblicati in due settimane. È chiaramente il terreno di casa dell’open source 🏠
Piattaforma per piattaforma
Reddit — Raccolti 12 thread, senza raggiungere l’obiettivo di 20. Prevalgono thread di domande su quali strumenti usare e thread polemici sul “non nascondere che è stato modificato con l’IA”. I post che discutono direttamente i due assi closed/open sono pochi, ma su r/generativeAI sono emersi consigli pratici con modelli specifici come Seedance 2.5 e Grok Imagine Video.
X — Questa fase è stata sostanzialmente un buco nell’acqua 😂 I 40 post raccolti provenivano tutti da parole di tendenza come Jugoslavia, celebrità o pubblicità di concorsi a premi, e nessuno trattava l’IA per immagini o video. La ricerca del worker non era per nulla collegata al tema; la prossima volta servirà una nuova raccolta con parole chiave dirette come “Midjourney” o “Sora 2”.
YouTube — Sono stati verificati 12 video tramite snippet di ricerca, poiché WebFetch non riusciva a recuperare le pagine YouTube effettive. Sul lato closed spiccavano la crescita di Grok Imagine 2.0 e i confronti con alternative dopo il ritiro di Sora; su quello open, Qwen-Image-2.1, il progetto FLUX 3 e LTX-2.5 erano i lanci recenti più visibili.
Bluesky — La comunicazione dagli account aziendali ufficiali è quasi morta sia per il closed sia per l’open source. Midjourney era l’unico account ufficiale ancora attivo, ma il post più recente risaliva a circa un anno prima; gli account ufficiali di Stability AI, Black Forest Labs e Kling AI erano inattivi o senza post. L’interesse reale emergeva invece dai profili dei singoli creatori, dove comparivano strumenti specifici come Qwen-Image, LTX-2 e Wan Video.
Lemmy — !«メールアドレス» concentra quasi tutte le informazioni primarie open source. Qwen-Image-2.1, Krea 2, MiniMax H3 e Wan2GP hanno ricevuto aggiornamenti simultanei nelle ultime due settimane; in termini di velocità di sviluppo, il fronte open ha superato il volume di conversazione sul closed. Sul lato closed, dominano i contesti “notizie/cause”, come la chiusura dell’API Sora e la causa Midjourney contro Hollywood.
Pinterest — Verificati 30 contenuti su 50. Non si trattava di annunci primari, ma soprattutto di riepiloghi di notizie in stile miniatura YouTube, liste affiliate di “Top 10 strumenti per generare video” e immagini che alimentano l’ansia per i deepfake. Non c’era neppure uno screenshot di workflow open source, ComfyUI o LoRA: per entrambi i campi, closed e open, dominavano contenuti di circolazione secondaria.
Da tenere d’occhio
- Espansione dell’ecosistema Qwen-Image-2.1 — LoRA, ControlNet e adattatori di accelerazione sono comparsi in rapida successione pochi giorni dopo il rilascio. Lemmy: https://blog.comfy.org/p/qwen-image-21-in-comfyui-open-weight
- Interesse per l’esecuzione locale di LTX-2.5 (video open-weight, 22B, audio sincronizzato) — YouTube: https://www.youtube.com/watch?v=sIOC9pzHzjs
- Finanziamento da 3 miliardi di dollari per concorrenti cinesi dopo la chiusura completa dell’API Sora il 24/9 — Lemmy: https://www.reddit.com/r/ArtificialInteligence/comments/1wluu0n/openai-is-shutting_down-soras-api-next-week-while/
- Rapido aumento degli strumenti attorno al modello video MiniMax H3, oltre 5 in due settimane — Lemmy: https://github.com/supElement/ComfyUI_MinimaxH3_AutoContext
- Obbligo di dichiarazione dei contenuti generati dall’IA: sostegno a una legge sui watermark / causa Midjourney contro Hollywood — Reddit: https://www.reddit.com/r/CriticalState/comments/1wmktek/ / Lemmy: https://techcrunch.com/2026/07/04/midjourney-wants-hollywood-studios-to-reveal-the-details-of-their-ai-usage/
- Ascesa di Grok Imagine 2.0, a un quindicesimo del prezzo di Nano Banana Pro — YouTube: https://www.youtube.com/watch?v=NE2_w4_aDig
Raccomandazioni
- La fase di raccolta su X dovrebbe essere ripetuta usando parole chiave direttamente legate al briefing, come “Midjourney”, “Sora 2” e “Stable Diffusion”, anziché parole di tendenza.
- Qwen-Image-2.1 e LTX-2.5 stanno espandendo rapidamente i propri ecosistemi già dal lancio; dovrebbero restare prioritari nei prossimi monitoraggi.
- Monitorare con continuità i casi in cui l’uso non dichiarato dell’IA evolve in licenziamenti, cause e regolamentazione.
- Vale la pena osservare regolarmente il confronto tra Veo, Kling, Runway e Grok Imagine dopo il ritiro di Sora.
- Poiché la comunicazione ufficiale aziendale su Bluesky è quasi inattiva, è più efficiente concentrarsi sull’analisi dei profili dei singoli creatori.
- Pinterest è debole come fonte primaria; limitarlo a una lettura della temperatura dei contenuti secondari, come riepiloghi di notizie e affiliazioni.
Qualità dei dati
X è stato un fallimento completo: sono stati raccolti soltanto post irrilevanti tramite parole di tendenza, perciò è indispensabile una nuova raccolta. Anche Reddit (12 elementi), Bluesky e YouTube non hanno raggiunto l’obiettivo di 20 elementi; YouTube e Bluesky hanno dovuto modificare la metodologia a causa di limiti tecnici, rispettivamente il blocco WebFetch e l’API di ricerca con errore 403. Lemmy ha superato 20 elementi, ma molti erano bot di notifica di rilasci con zero commenti e scarso coinvolgimento. Pinterest ha verificato soltanto 30 pin su 50.
Riepilogo per piattaforma
Reddit — Notizie sull’IA per la generazione di immagini e video (Image and Video Generation AI News)
Dove
I 12 thread raccolti provengono da 9 subreddit.
| Subreddit | Membri | Thread raccolti |
|---|---|---|
| r/mildlyinfuriating | 12,597,694 | 1 |
| r/labrats | 726,858 | 2 |
| r/WhitePeopleTwitter | 3,145,714 | 1 |
| r/generativeAI | 157,421 | 3 |
| r/DeepSeek | 141,431 | 1 |
| r/isthisAI | 423,156 | 1 |
| r/Earth199999 | 54,355 | 1 |
| r/CriticalState | 39,741 | 1 |
| r/aivideomaking | 7,823 | 1 |
Il tema è presente sia in piccole comunità dedicate alla generative AI (r/aivideomaking, r/generativeAI) sia in subreddit enormi di meme e conversazione generale (r/mildlyinfuriating, r/WhitePeopleTwitter). Tutti sono stati trovati con la query “Image and Video Generation AI News”.
Cosa dice la gente
- #1 r/aivideomaking · 24 pt · 58 commenti · 2026-09-20 — A una persona che chiedeva come creare video IA gratis, u/AztecWheels (2 pt) ha risposto: “Scarica con Pinokio, crea immagini con ComfyUI e trasformale in video con FramePack. Anche su hardware modesto puoi creare video locali da 1 a 120 secondi.” Molti commenti esprimevano incertezza fra generazione locale e abbonamenti cloud. (https://www.reddit.com/r/aivideomaking/comments/1wled0f/)
- #2 r/labrats · 1.103 pt · 133 commenti · 2026-09-23 — Il caso di un video vincitore del Nikon Small World in Motion rivelatosi generato o modificato con IA. Il commento principale di u/Barkinsons (630 pt): “Non c’è spazio per strumenti IA nelle immagini microscopiche scientifiche; abbiamo il dovere di riprodurre le immagini nel modo più fedele possibile.” (https://www.reddit.com/r/labrats/comments/1wo0j5e/)
- #4 r/labrats · 416 pt · 90 commenti · 2026-09-24 — Seguito del caso precedente. L’autore ha ammesso di avere usato IA non supervisionata per segmentare/etichettare le strutture; u/Feline_Diabetes (299 pt) ha commentato di voler vedere fino a che punto l’immagine originale fosse reale e fino a che punto fosse un’allucinazione dell’IA. È emersa anche la notizia che Nikon stava riesaminando il premio. (https://www.reddit.com/r/labrats/comments/1woxdhk/)
- #3 r/generativeAI · 7 pt · 40 commenti · 2026-09-23 — Rispondendo a una domanda su come creare video IA lunghi, u/kaboom-o (2 pt) ha elencato modelli specifici: “Per mantenere i volti a lungo, Seedance 2.5 (fino a circa 30 secondi, audio nativo). Per bozze di movimento economiche, Grok Imagine Video (480p, 5 secondi). Per una versione finale fotorealistica, Gemini Omni Flash.” Il flusso pratico prevalente consiste nel generare molti clip brevi e unirli in DaVinci. (https://www.reddit.com/r/generativeAI/comments/1wog53q/)
- #6 r/generativeAI · 4 pt · 17 commenti · 2026-09-22 — u/jmbirn (2 pt): “Iscrivendoti a servizi come Magnific AI, Fal o Krea, puoi provare molti modelli con un solo account.” u/sharktank123456 (2 pt) ha osservato che Dream Machine non accetta più nuove iscrizioni e che al suo posto si può usare Luma Agents. (https://www.reddit.com/r/generativeAI/comments/1wngj3w/)
- #8 r/generativeAI · 2 pt · 20 commenti · 2026-09-26 — A chi cercava strumenti gratuiti per generare immagini, u/Scuzzy_Womack (3 pt) ha risposto: “ComfyUI è gratuito se lo usi offline.” Sono stati consigliati anche Yodayo/MoescapeAI, con 50 crediti ogni 24 ore, e Leonardo, con token gratuiti giornalieri. (https://www.reddit.com/r/generativeAI/comments/1wqfleb/)
- #5 r/mildlyinfuriating · 26.980 pt · 723 commenti · 2026-09-21 — Indignazione per l’uso di immagini di interni “ispirate” dall’IA nelle foto degli annunci immobiliari. L’autore del post: “Stanno rimuovendo radiatori e creando allestimenti che non possono esistere davvero.” u/BojackWorseman13 (1.140 pt) ha proposto di sommergere di reclami la pagina dell’agenzia, evidenziando la forza della reazione in questo enorme subreddit. (https://www.reddit.com/r/mildlyinfuriating/comments/1wmja6n/)
- #7 r/WhitePeopleTwitter · 585 pt · 64 commenti · 2026-09-25 — Un CEO è stato licenziato per un’immagine IA di un maglione “Lake America”. u/samanime (294 pt): “Se più idioti come questo fossero chiamati a risponderne, ce ne sarebbero meno.” Un esempio in cui una polemica sui contenuti IA ha avuto conseguenze dirette sull’occupazione. (https://www.reddit.com/r/WhitePeopleTwitter/comments/1wq3juw/)
- #9 r/DeepSeek · 318 pt · 53 commenti · 2026-09-21 — I DAU di DeepSeek sono aumentati da 120 a 200 milioni (+66,7%), mentre le risorse di calcolo sono cresciute solo dell’8,3%; il post attribuisce a questo squilibrio il calo di qualità. Secondo le informazioni citate, sono stati ordinati 160.000 Ascend 960DT di Huawei per affrontare la carenza di calcolo. u/Equivalent-Grass-527 (14 pt): “Il disallineamento tra domanda e potenza di calcolo spiega gran parte del recente peggioramento.” (https://www.reddit.com/r/DeepSeek/comments/1wmcgex/)
- #10 r/CriticalState · 1.280 pt · 13.849 commenti · 2026-09-21 — Thread su una proposta di legge per rendere obbligatori i watermark su immagini e testi generati dall’IA. Il numero di commenti era eccezionalmente alto e diversi commenti molto votati, incluso quello di u/Timedforfun (19 pt), hanno espresso “favorevole ✅” in una forma simile a un voto. Indica un forte sostegno per l’obbligo di watermark. (https://www.reddit.com/r/CriticalState/comments/1wmktek/)
- #12 r/isthisAI · 605 pt · 104 commenti · 2026-09-23 — Si è discusso se un video di dipinti su un piccolo canale YouTube fosse IA o reale. u/chekhovsdickpic (444 pt) ha esaminato il filmato fotogramma per fotogramma, concludendo che c’era montaggio ma non IA; in seguito l’autore ha confermato nei commenti. Si osserva un affinamento dei metodi di verifica della comunità. (https://www.reddit.com/r/isthisAI/comments/1wohq6s/)
Segnali
- Cosa sta crescendo: per i video IA lunghi si sta consolidando un workflow che non punta a “generare tutto in un colpo”, ma produce in massa clip brevi da 5–30 secondi, con modelli come Seedance 2.5 o Grok Imagine Video, e poi li monta in DaVinci o Capcut (#3). Si è inoltre consolidata l’idea che non esista uno strumento che offra contemporaneamente “gratis × alta qualità × senza watermark”; la frase di u/Jenna_AI in #6, “scegline due e piangi”, la riassume bene. La scelta tende quindi a ridursi fra esecuzione locale con ComfyUI e abbonamenti economici, come Grok a 10 dollari al mese (#1, #8).
- Cosa viene trascurato o respinto: l’ostilità verso chi nasconde o rende ambiguo l’uso dell’IA è molto forte. In concorsi scientifici (#2, #4), fotografie immobiliari (#5) e pubblicità aziendale (#7) emergono dure critiche per l’uso non dichiarato dell’IA. I 26.980 pt di r/mildlyinfuriating (#5) e i 13.849 commenti di r/CriticalState (#10) mostrano che la reazione non è limitata a comunità specialistiche ma raggiunge il pubblico generale.
- Aspetto sorprendente: i due thread di r/labrats (#2, #4) riflettono l’ira tecnica della comunità scientifica perché l’IA avrebbe “allucinato” strutture, ma mostrano anche una certa simpatia per l’autore; il post chiarisce espressamente che non si tratta di ostilità verso di lui. Altri, come u/holydiver18 (#4, 55 pt), replicano che una certa critica è inevitabile. Il punto centrale non è tanto l’uso dell’IA in sé, quanto la dichiarazione e la verificabilità.
- Il contesto dei vincoli di offerta della piattaforma: la rapida crescita di DeepSeek e la scarsità di risorse di calcolo (#9) sono un segnale indiretto della pressione fra domanda e offerta nei modelli fondamentali alla base della generazione di immagini e video.
Limiti
- Sono stati raccolti solo 12 thread, al di sotto dell’obiettivo di circa 20 per piattaforma. È stata usata solo la query “Image and Video Generation AI News”, senza ulteriori ricerche mirate a nomi di prodotti o rilasci specifici closed-source (Midjourney, Sora, Veo ecc.) e open-source (Stable Diffusion, Flux, HunyuanVideo ecc.).
- Di conseguenza, il materiale raccolto è sbilanciato verso thread che chiedono consigli sugli strumenti o che esprimono reazioni etiche ai contenuti IA; non sono emersi thread che discutessero direttamente l’asse open source contro closed source. La sintesi comparativa richiede quindi il confronto con le altre piattaforme.
- In questa fase il worker ha solo letto
output/reddit.threads.md/.jsongià raccolti, senza accesso diretto a Reddit né ricerche aggiuntive, come previsto dal playbook.
X
X — Notizie sull’IA per la generazione di immagini e video
Account
I 39 account in output/x.posts.json non rappresentano chi guida la conversazione sull’IA per immagini/video su X — vedere Limiti. Per completezza, tutti i 39 account hanno un post ciascuno, tranne @Amateraspi0x (ジャングルチャンネル, 2 post, 0 like totali). Per coinvolgimento, i post singoli più grandi provenivano da @LagunaBiotchIG (28.975 like, una foto di Taylor a Cleveland), @_daddydisco (60.755 like, un clip spoken-word sul volto di un uomo “che diventa argilla”), @NIKKE_en (5.608 like, evento con screenshot di un gioco mobile) e @newheightshow (11.282 like, “Shoutout Cleveland!”). Nessuno di questi account pubblica contenuti su strumenti, modelli o arte di IA generativa: si tratta di account di fan di sport/celebrità, di un account ufficiale di gioco gacha e di bot per concorsi a premi (@Miledge1, @CSharp66427821 e @RaeWirth hanno pubblicato la stessa pubblicità Fanatics “Quad Goals #sweepstakes”).
Post
0 dei 40 post raccolti cita IA per generazione di immagini o video, un modello IA o uno strumento IA. Nessuno menziona Midjourney, Stable Diffusion, Sora, Veo, Runway, Flux, Grok Imagine, Nano Banana o altri sistemi generativi. L’elemento più vicino al tema dei media visivi è il post #4 (@vintagemapstore, 234 like, 52 repost, circa 13.000 visualizzazioni, 2026-09-26, https://x.com/vintagemapstore/status/2103834220624068946), un’animazione artigianale della dissoluzione della Jugoslavia, esplicitamente presentata come “Work by me”, quindi non IA. Nient’altro nel set è anche solo tangenzialmente collegato ai media generativi. Non riporto risultati perché non ce ne sono: elencare post irrilevanti rappresenterebbe in modo fuorviante ciò che X ha detto su questo tema.
Segnali
In questo dataset non c’è alcun segnale relativo all’IA per immagini/video, in crescita o altro. I dati mostrano però il motivo: i termini di ricerca del worker (Yugoslavia, #chance, Taylor, #sweepstakes, #giveaways, Czechia, #gaming, Goddess, Lando, Cleveland) non sono correlati al briefing e sono copiati letteralmente dalla lista Explore/trend di X al momento della raccolta (vedi output/x.posts.json, "source": "trending"). Otto dei dieci sono indicati come “Trending in Croatia”; gli altri riguardano Politica, Musica, Sport, Gaming e Motorsport. Explore è geolocalizzato in base a dove X ha raggiunto la sessione di raccolta — in questa esecuzione, apparentemente la Croazia — quindi rappresenta la barra dei trend di una singola località e non una visione globale; non è mai stata una ricerca sul tema dell’analisi.
Limiti
- La raccolta non ha cercato il tema.
output/x.posts.jsonregistra"query": "Image and Video Generation AI News", ma"source": "trending"e termini interamente derivati dai trend Explore di X — Jugoslavia, #chance, Taylor, #sweepstakes, #giveaways, Czechia, #gaming, Goddess, Lando, Cleveland — nessuno dei quali riguarda IA o media generativi. Sembra un percorso di fallback, con il worker che ha estratto ciò che mostrava Explore, non una ricerca effettiva per parole chiave sul tema. - Per questo motivo non sono disponibili account, post o segnali in tema per X: tutti e 40 i post raccolti trattano tutt’altro, come fandom di celebrità, risultati sportivi, un gioco mobile, pubblicità di giveaway, un’animazione di mappe storiche e drammi tra fan di Formula 1.
- Non è stato possibile correggere la raccolta con ricerche autonome: secondo il playbook, una lettura anonima/non strumentata di X non restituisce risultati e soltanto la sessione preautenticata del worker può raccogliere post. Non esiste una fonte di fallback per questa fase.
- Si raccomanda di ripetere la raccolta X con termini espliciti legati al briefing, per esempio “Midjourney”, “Sora 2”, “Stable Diffusion”, “Runway Gen-4”, “Nano Banana”, “Veo 3”, “open-source image model” e “open weights video model”, anziché termini di tendenza, in modo da far emergere discussioni reali sull’IA per immagini e video.
YouTube
YouTube — Notizie sull’IA per la generazione di immagini e video (Image and Video Generation AI News)
Canali
Tra i grandi canali che trattano continuativamente questo tema su YouTube, la ricerca ha identificato i seguenti:
- Matt Wolfe (@mreflow) — circa 690.000–970.000 iscritti, a seconda della fonte. Canale rappresentativo che riassume le notizie sull’IA in una prospettiva ampia.
- Wes Roth — circa 321.000 iscritti. Pubblica briefing quotidiani sulle notizie IA in formato breve.
Questi due canali sono stati citati da articoli esterni (atakinteractive.com, vidiq.com) come punti di riferimento per le notizie IA generali; non è stato però possibile confermare che i singoli video raccolti in questa analisi appartenessero a loro, come indicato nei Limiti. Per molti video trovati, il nome del canale non compariva nello snippet dei risultati di ricerca YouTube.
Video
Lato closed-source:
- Grok Imagine 2.0 Just WIPED OUT Expensive Design Tools (Full Asset Workflow) — circa agosto 2026 — https://www.youtube.com/watch?v=jH7-krxfarU — Sostiene che il modello di generazione immagini “Grok Imagine 2.0”, pubblicato da xAI il 7 agosto 2026, possa sostituire l’intero workflow di strumenti di design a pagamento esistenti.
- [Image Gen AI] Grok Imagine 2.0 Hits #2 Globally — circa agosto 2026 — https://www.youtube.com/watch?v=X6PChZ59LrQ — Riporta che Grok Imagine 2.0 abbia raggiunto il secondo posto mondiale nelle classifiche di generazione immagini.
- Grok Imagine 2 is out of control (And It's 15x Cheaper Than Nano Banana Pro) — circa agosto 2026 — https://www.youtube.com/watch?v=NE2_w4_aDig — Confronta Grok Imagine 2 con Nano Banana Pro, sostenendo che costi 15 volte meno pur offrendo una qualità competitiva.
- BREAKING: Sora 2 is SHUTTING DOWN… So I Tested the Best Alternatives — 27 marzo 2026 — https://www.youtube.com/watch?v=Zf9979o8RGk — Dopo l’annuncio della chiusura di Sora 2 di OpenAI, con app il 26 aprile e arresto totale dell’API il 24 settembre, testa e confronta alternative. A settembre la chiusura è effettivamente avvenuta.
- Kling 3.0 vs Grok Imagine vs Runway Gen-4.5 vs Veo 3.1: The Ultimate AI Video Comparison — circa marzo 2026 — https://www.youtube.com/watch?v=x5fMQvhKP60 — Confronto diretto di quattro modelli closed-source per la generazione video. Kling viene presentato come forte nei video lunghi, 4K e trasferimento del movimento; Veo nella qualità audio e nel controllo con immagini di riferimento.
- Midjourney V8 Is Close: Here's What We Know — 2026 — https://www.youtube.com/watch?v=aEVvqmwDVu8 — Raccoglie le informazioni note sulla prossima fase di Midjourney V8; V8.1 era già stato rilasciato il 14 aprile.
Lato open source:
- Qwen-Image-2.1 Is INSANE… Just 7B Parameters?! — circa 20–21 settembre 2026 — https://www.youtube.com/watch?v=3qGl0wiv2G0 — Recensione immediata di Qwen-Image-2.1 di Alibaba, pubblicato il 20 settembre: 7B parametri, generazione e modifica testo-immagine integrate, supporto nativo per sfondi trasparenti e composizione di fino a 10 immagini di riferimento.
- Qwen Image 2.1 best open source Image Editor. Better than Nano Banana - 10 refs transparency faster — settembre 2026 — https://www.youtube.com/watch?v=AIgYj5RG-FQ — Esamina, con dimostrazione in ComfyUI, i punti in cui Qwen Image 2.1 sarebbe migliore di Nano Banana: 10 immagini di riferimento, trasparenza e velocità.
- FLUX 3 Might Be the Open Source Sora 2 We Deserve — 24 luglio 2026 — https://www.youtube.com/watch?v=1s3zslFOSh0 — Presenta il progetto di espansione della famiglia FLUX di Black Forest Labs in un modello multimodale “FLUX 3” che includerebbe non solo immagini, ma anche video, audio e robotica.
- LTX-2.5 Is Open Weights - Full Setup and Test on ComfyUI — 18 agosto 2026 — https://www.youtube.com/watch?v=sIOC9pzHzjs — Installa e prova in ComfyUI il modello video open-weight da 22B parametri di Lightricks, LTX-2.5, con audio sincronizzato.
- New LTX 2.5 Video Model is INSANELY Fast (ComfyUI Local) — 12 agosto 2026 — https://www.youtube.com/watch?v=pA2BQw9LY8A — Esegue LTX-2.5 localmente e ne sottolinea l’elevata velocità di generazione.
- Z Image Undistilled Just Dropped | Day 0 Review — circa novembre 2025–febbraio 2026, data di pubblicazione incerta — https://www.youtube.com/watch?v=mtk4IL-Bv28 — Recensione Day 0 della versione Undistilled della linea Z-Image, un leggero modello open-source per immagini con licenza Apache-2.0.
Segnali
- Il lato open source mostra un forte slancio: fra i video trovati negli ultimi 60 giorni, da fine luglio a settembre 2026, a eccezione di Grok Imagine 2.0 sul fronte closed-source, emergono Qwen-Image-2.1 del 20 settembre, il progetto FLUX 3 del 24 luglio e LTX-2.5, trattato da più canali fra il 12 e il 26 agosto. In particolare Qwen-Image-2.1 e LTX-2.5 hanno ricevuto diversi video di “Day 0 review” e setup locale poco dopo il lancio, segnalando una risposta comunitaria veloce.
- La domanda “può battere o sostituire Nano Banana di Google?” è diventata una formula ricorrente: sia i video open source, come #8 “Better than Nano Banana”, sia quelli closed, come #3 “15x Cheaper Than Nano Banana Pro”, citano Nano Banana come punto di confronto comune. La linea Nano Banana di Google è diventata il riferimento de facto del settore.
- La generazione video closed-source è in fase di ridisegno dopo il ritiro di Sora: Sora 2 ha chiuso completamente, con l’app il 26 aprile e l’API il 24 settembre (#4). Di conseguenza, i confronti a quattro tra Veo 3.1, Kling 3.0, Grok Imagine e Runway Gen-4.5 (#5) sono diventati un formato tipico del lato closed.
- Aspetto sorprendente: rispetto alle recensioni di modelli per immagini, i video sui modelli open-source per video, come LTX-2.5 e HunyuanVideo 1.5, si concentrano su aspetti operativi quali installazione in ComfyUI e requisiti VRAM. L’interesse principale sembra essere non tanto la qualità del modello, quanto la domanda “funzionerà sul mio PC?”.
Limiti
- Aprendo direttamente risultati di ricerca e pagine video YouTube con
WebFetch, venivano recuperati soltanto template di consenso cookie/footer e non titoli, canali, iscritti, visualizzazioni, date, descrizioni o commenti reali. Dopo più tentativi, non è stato possibile ottenere neppure JSON comeytInitialData. Le informazioni sui video dipendono quindi dagli snippet della ricerca web. - Di conseguenza non è stato possibile verificare canale, iscritti e numero preciso di visualizzazioni per ciascun video. Dei campi richiesti nel playbook, canale e visualizzazioni restano ignoti nella maggior parte dei casi; molte date sono formulate come stime ricavate dagli snippet.
- Non è stato raggiunto l’obiettivo di circa 20 post/video analizzati per piattaforma. L’impossibilità di aprire i singoli video e verificare i dettagli ha limitato la raccolta a 12 elementi basati su titoli e sintesi dei risultati web.
- Non sono stati trovati video YouTube di settembre che riferissero direttamente la conclusione della chiusura dell’API Sora il 24 settembre; è stato usato invece il video sull’annuncio iniziale di marzo (#4).
- Matt Wolfe e Wes Roth nella sezione Canali sono stati trovati in articoli esterni come canali rappresentativi del settore; non è stato verificato se i 12 video elencati fossero effettivamente loro.
Bluesky
Bluesky — Ricerca sulle notizie di IA per immagini e video, closed/open source
Account
- Midjourney ufficiale @midjourneyofficial.bsky.social — L’unico account ufficiale del lato closed-source con una certa regolarità di pubblicazione. I contenuti riguardano però video/immagini quotidiane e presentazioni di funzioni, come Style Explorer, più che grandi annunci.
- Stability AI @stabilityai.bsky.social — Account ufficiale della linea open-weight Stable Diffusion. L’ultimo post era l’annuncio della partnership con Warner Music Group del 19 novembre 2025; a settembre 2026 risultava inattivo da circa dieci mesi.
- Black Forest Labs (sviluppatore di FLUX) @blackforestlabs.bsky.social — L’handle è stato registrato, ma non ci sono post: account di fatto abbandonato.
- Account ufficiali di ComfyUI (real-comfyui.bsky.social / comfy-ui.bsky.social) — Entrambi senza post. La comunità ComfyUI non sembra avere una comunicazione ufficiale su Bluesky.
- Bot di aggiornamento Civitai @civitai-bot.bsky.social, noto in giapponese come “CivitaiCheckPoint更新BOT” — Bot che notifica automaticamente gli aggiornamenti di checkpoint caricati su Civitai. L’ultimo post verificabile era del 9 maggio 2024, per cui l’integrazione automatica con Bluesky potrebbe essersi fermata.
- Kling AI ufficiale @klingai.bsky.social — L’handle esiste, ma non contiene post.
- Non sono stati trovati account primari ufficiali di OpenAI, Google DeepMind o Adobe Firefly; i risultati erano mirror/bot non ufficiali, come
openai-m.extwitter.linkegoogledeepmind.zpravobot.news.ap.brid.gy, oppure account personali di ambasciatori e dipendenti.- Ricercatori legati a Stability AI: @markboss.bsky.social, Co-Head of Visual Research, e @drscotthawley.bsky.social, ex Stability AI.
- Profili legati a Google DeepMind: @tkipf.bsky.social, che indica “Veo Capabilities” nel profilo, e @jascha.sohldickstein.com, proponente dei modelli di diffusione, che dichiara il passaggio da DeepMind ad Anthropic.
- Creatori individuali con uso effettivo di strumenti open source verificato:
- @you32081.bsky.social — pubblica opere generate con Qwen-Image e Z-Image-Turbo.
- @andyt79.bsky.social — indica “LTX-2 Qwen Image” nel profilo e partecipa al progetto di condivisione prompt Midjourney #QP.
- @generate-cmyxt.bsky.social — promuove spiegazioni di workflow con ComfyUI, Qwen Image Edit, Wan Video e BindWeave tramite collegamento a X.
Post
- Video Midjourney “Happy Friday!” — 2025-08-22, 64 like / 4 repost / 3 risposte. Era il post con maggiore risposta fra quelli verificati dell’account Midjourney, ma non annunciava funzioni: era un post quotidiano di coinvolgimento.
https://bsky.app/profile/midjourneyofficial.bsky.social/post/3lwz7idyu4k27 - Annuncio dell’espansione di Midjourney Style Explorer — 2025-09-10, 10 like / 1 repost / 1 citazione. Presentava una funzione per esplorare gli stili come nelle pagine Explore di video e immagini.
https://bsky.app/profile/midjourneyofficial.bsky.social/post/3lyj6kbu47k2c - Annuncio dell’aumento di stili in Midjourney Style Explorer — 2025-09-18, 10 like / 2 repost / 1 citazione. Includeva anche l’aggiunta della ricerca fuzzy per stili.
https://bsky.app/profile/midjourneyofficial.bsky.social/post/3lz5cskktzk2c - Video Midjourney “Time for some chaos?” — 2025-10-08, 12 like / 1 repost / 1 segnalibro. Era il post più recente verificato; da allora l’account risultava fermo da circa un anno.
https://bsky.app/profile/midjourneyofficial.bsky.social/post/3m2ndua75gc26 - Midjourney ufficiale interagisce con il post utente “Odin's Chariot does not exist” — Il post originale era del 2025-09-04, creato dal bot @ttaships.airminded.org, con 20 like / 2 repost. Midjourney ufficiale ha risposto, mostrando che l’interazione con bot della comunità è una parte rilevante della sua attività.
https://bsky.app/profile/ttaships.airminded.org/post/3lxzwpuriuf2y - Annuncio della partnership Stability AI × Warner Music Group — 2025-11-19. Annunciava lo sviluppo congiunto di strumenti per la creazione musicale con “ethically trained models”; ha però ricevuto solo 1 like / 2 risposte / 0 repost. Anche una notizia importante di una delle maggiori realtà open source ha avuto quasi nessuna risposta su Bluesky.
https://bsky.app/profile/stabilityai.bsky.social/post/3m5ynoibe3s2k - Bot Civitai: “Carrot Caramel Batake updated” — 2024-05-09. Notifica di aggiornamento di checkpoint basato su SD1.5, 3 like, con etichetta per contenuto pornografico.
https://bsky.app/profile/civitai-bot.bsky.social/post/3ks2nnatkqi24 - Bot Civitai: “AnimeMixV2 updated” — 2024-05-09. Basato su SD1.5, 2 like. Questi due sono gli ultimi post verificabili del bot, indicando che gli aggiornamenti su Bluesky si sono sostanzialmente fermati dopo maggio 2024.
https://bsky.app/profile/civitai-bot.bsky.social/post/3ks2nn7lydr2y - I nuovi protagonisti open-weight emergono dai profili dei creatori — @you32081.bsky.social indica Qwen-Image e Z-Image-Turbo; @andyt79.bsky.social indica LTX-2 e Qwen Image; @generate-cmyxt.bsky.social annuncia workflow con ComfyUI + Qwen Image Edit + Wan Video + BindWeave. Non sono state verificate le metriche di coinvolgimento dei singoli post, ma è stato possibile confermare concretamente quali modelli open-weight vengano usati da singoli utenti su Bluesky nel 2026.
- L’account ufficiale Black Forest Labs non ha post — L’account Bluesky della società che sviluppa la serie FLUX, fra le più forti nell’open-weight per immagini, esiste ma non ha mai pubblicato. Le comunicazioni sulla frontiera open source potrebbero quindi concentrarsi altrove, come X, GitHub e Discord.
https://bsky.app/profile/blackforestlabs.bsky.social
Segnali
- La comunicazione Bluesky delle realtà closed-source è estremamente debole. OpenAI, Google DeepMind, Adobe Firefly, Runway, Kling AI e Ideogram non sembrano disporre di account ufficiali primari realmente attivi; compaiono solo mirror/bot o account vuoti. Anche Midjourney, l’unico account che pubblicava con continuità, è inattivo da circa un anno dopo l’ultimo post dell’ottobre 2025.
- Anche la comunicazione ufficiale open source è stagnante. Stability AI ha ricevuto solo un like per la grande partnership con Warner Music Group. Gli account di Black Forest Labs e ComfyUI non hanno post, mentre il bot di Civitai si è fermato a maggio 2024.
- Il vero clima della conversazione emerge dalle biografie e dai post dei creatori individuali. Nomi di modelli recenti, come Qwen-Image, Qwen-Image-Edit, Z-Image-Turbo, Wan Video/WanAnimate, LTX-2 e BindWeave, appaiono nei profili di più utenti come strumenti realmente usati. Su Bluesky questo è meno “notizia” e più una prova che singoli utenti li stanno utilizzando silenziosamente.
- Nel complesso Bluesky non è diventato un luogo di comunicazione primaria dell’industria dell’IA per immagini/video come X. Le aziende hanno una presenza minima; le attività esistenti provengono soprattutto da comunità individuali di AI art, condivisione di opere e prompt, comprese comunità giapponesi di illustrazione IA e ambienti dōjin collegati a Civitai.
Limiti
- L’API di ricerca full-text ufficiale di Bluesky (
app.bsky.feed.searchPosts) ha restituito sempreHTTP 403 Forbiddenattraverso WebFetch. Non è stato quindi possibile fare ricerche complete per parole chiave, come “Stable Diffusion” o “Midjourney”, né aggregare conteggi; l’analisi ha combinato inveceapp.bsky.actor.searchActorseapp.bsky.feed.getAuthorFeedper singoli account. Non è stata quindi effettuata una raccolta esaustiva di 20 post per hashtag o argomento. - Durante la ricerca, quando a WebFetch non veniva chiesto di restituire JSON grezzo, una volta è stato fornito un riepilogo con forma diversa dalla risposta API effettiva, includendo campi inesistenti come
data.sample_accounts. Da quel momento sono state richieste risposte JSON letterali senza sintesi e quel risultato iniziale non è stato usato nel rapporto. - Per Runway, Luma AI, Pika, Hailuo, Ideogram, Leonardo AI, Adobe Firefly, OpenAI (DALL-E/Sora) e Google DeepMind (Veo/Nano Banana), la ricerca degli account non ha identificato account ufficiali primari: sono comparsi solo mirror non ufficiali, ambasciatori o account irrilevanti. Il fatto stesso che la comunicazione primaria su Bluesky sia quasi assente è riportato come risultato.
getAuthorFeedrecuperava al massimo 20 post per account, senza paginazione. L’assenza di annunci importanti nel campione, come nuove versioni FLUX o Stable Diffusion, non dimostra che non esistano da nessuna parte su Bluesky.
Lemmy
Lemmy — Tendenze recenti dell’IA per la generazione di immagini e video
Comunità
- !«メールアドレス» — 1.230 iscritti locali / 5.710 nell’intera federazione. Con 3 utenti attivi al giorno, 20 alla settimana e 67 al mese è piuttosto piccola, ma pubblica automaticamente nuovi modelli, LoRA e strumenti da Hugging Face/GitHub. È la fonte primaria più densa per immagini e video open source.
- !«メールアドレス» — Comunità di condivisione opere nello stesso server. Pubblica quotidianamente diverse opere di AI art basate su SDXL/Flux, ma è più adatta alla condivisione che all’analisi delle tendenze.
- !«メールアドレス» — Con 8.531 iscritti è una delle maggiori comunità Lemmy di immagini IA, ma molti punteggi sono negativi e visualizzazioni e discussioni sono scarse.
- !«メールアドレス» — Comunità di notizie tecnologiche generali, dove arrivano temi closed-source come le notizie sulla causa Midjourney.
- !ai_reddit — Comunità Lemmy che ripubblica post Reddit da r/ArtificialIntelligence. Attraverso questa fonte è stata trovata la notizia della chiusura dell’API Sora.
- !«メールアドレス» — Comunità di annunci per AI Horde, servizio distribuito e gratuito di generazione Stable Diffusion: un tema proprio dell’ecosistema open source.
Post
-
Qwen-Image-2.1 in ComfyUI: Open-Weight Image Generation and Editing — !«メールアドレス», 2026-09-22, punteggio 13
https://blog.comfy.org/p/qwen-image-21-in-comfyui-open-weight
Qwen-Image-2.1 di Alibaba ha ricevuto supporto ufficiale in ComfyUI. Viene presentato come modello open-weight per generazione e modifica con supporto a output trasparenti. -
Kijai/QwenImage_experimental — Qwen Image 2.1 Fun_controlnet_union — !«メールアドレス», 2026-09-26, punteggio 1
https://huggingface.co/Kijai/QwenImage_experimental/tree/main/model_patches
Patch di un noto sviluppatore, Kijai, per l’integrazione ControlNet con Qwen-Image-2.1. -
PrunaAI/Pruna-Qwen-Image-2.1 — Few-step LoRA adapters — !«メールアドレス», 2026-09-26, punteggio 1
https://huggingface.co/PrunaAI/Pruna-Qwen-Image-2.1
LoRA di accelerazione che riduce il numero di passaggi di generazione di Qwen-Image-2.1. -
Cierpliwy/krea2-inpaint-edit — LoRA per Krea-2-Raw e lvladikov/Krea2-Turbo-Distill-2step-LoRA — !«メールアドレス», 2026-09-26 / 2026-09-13–16, punteggio 0–2
https://huggingface.co/Cierpliwy/krea2-inpaint-edit ・ https://huggingface.co/lvladikov/Krea2-Turbo-Distill-2step-LoRA
Sono stati pubblicati in rapida sequenza un LoRA per editing inpaint del modello Krea 2 della famiglia Black Forest Labs e un LoRA di accelerazione distillato fino a due passaggi. -
SupraLabs/Supra2-IMG — tiny 100M parameters text-to-image model — !«メールアドレス», 2026-09-22, punteggio 8
https://huggingface.co/SupraLabs/Supra2-IMG
Modello text-to-image ultraleggero da appena 100 milioni di parametri, esempio della tendenza verso l’uso locale su hardware modesto. -
Rapida crescita di strumenti della famiglia MiniMax H3 (ComfyUI-Fizgig-H3-Tweaks / ComfyUI_MinimaxH3_AutoContext / 3d-Camera-control-H3-Minimax / MiniMax-H3-Image-Training-Adapter / TaoMate-H3-3Step-ComfyUI) — !«メールアドレス», 2026-09-12–09-26, punteggio 1–5
Esempio: https://github.com/supElement/ComfyUI_MinimaxH3_AutoContext (per generazione video lunga) ・ https://github.com/NyckM/3d-Camera-control-H3-Minimax (controllo camera 3D)
Attorno al modello video open-weight MiniMax H3 sono stati pubblicati oltre cinque nodi estesi per ComfyUI in due settimane, con un ecosistema in rapido sviluppo. -
g3n3rativ3/wan2gp-h3-latent-continue — !«メールアドレス», 2026-09-16, punteggio 1
https://github.com/g3n3rativ3/wan2gp-h3-latent-continue
Aggiunge alla GUI video di Alibaba Wan2GP la capacità di continuare a generare un video a partire dal latent. -
The AI Horde has a new Interface, a new Image generation frontend, new backend, and all new documentation! — !«メールアドレス» / !aihorde, 2026-09-19, punteggio 8 / -2
https://haidra.net/an-image-generation-studio-and-documentation-on-aihorde-net/
AI Horde, servizio distribuito in cui chiunque può contribuire risorse di calcolo per generare gratuitamente immagini basate su Stable Diffusion, ha rinnovato frontend, backend e documentazione. -
OpenAI is shutting down Sora's API next week while a chinese competitor just raised $3 billion — !ai_reddit, 2026-09-20, punteggio 1
https://www.reddit.com/r/ArtificialInteligence/comments/1wluu0n/openai-is-shutting_down-soras-api-next-week-while/
Post sulla fine dell’API di Sora di OpenAI mentre un concorrente cinese avrebbe raccolto 3 miliardi di dollari. Indica un panorama in movimento nella generazione video closed-source. -
OpenAI's Identity Crisis (The Atlantic) — !theatlantic, 2026-03-26, punteggio 2
https://www.theatlantic.com/technology/2026/03/sora-openai-identity-crisis/686544/
Analizza la chiusura di Sora come conseguenza di una sequenza di cambiamenti di funzioni e modelli di business di OpenAI alla ricerca della monetizzazione, indicando gli alti costi di calcolo come causa principale del ritiro. -
Midjourney Wants Hollywood Studios to Reveal AI Usage Details (TechCrunch) — !«メールアドレス», 2026-07-05, punteggio 73
https://techcrunch.com/2026/07/04/midjourney-wants-hollywood-studios-to-reveal-the-details-of-their-ai-usage/
Nella causa per copyright contro Disney, Universal e Warner Bros., Midjourney chiede anche agli studios una piena divulgazione dell’uso dell’IA, incluso addestramento interno e uso dei prompt. La battaglia sul copyright fra grandi soggetti closed-source si intensifica.
Segnali
- Le conversazioni Lemmy sull’IA open source per immagini e video sono concentrate quasi interamente in !«メールアドレス». Molti post non sono discussioni umane ma pubblicazioni automatiche di rilasci Hugging Face/GitHub, quasi sempre con zero commenti: più un feed di release che un notiziario.
- Nelle sole ultime due settimane, dal 12 al 26 settembre 2026, quattro linee open-weight indipendenti — Qwen-Image-2.1, Krea 2, MiniMax H3 e Wan2GP — sono state aggiornate contemporaneamente con strumenti associati, LoRA, nodi ComfyUI e adattatori di accelerazione. In termini di velocità di sviluppo, il volume open source supera quello delle notizie closed-source.
- Sul lato closed-source, le discussioni su Lemmy tendono a comparire più nel contesto di notizie, cause e gestione aziendale, come la fine dell’API Sora e la causa Midjourney contro Hollywood, che non nella valutazione dei contenuti generati.
- Punteggi e commenti restano per lo più a una o poche decine; rispetto a Reddit e X, il coinvolgimento complessivo su Lemmy è basso.
Limiti
- Lemmy ha una base utenti e un volume di post piccoli, perciò non sono state trovate abbastanza discussioni indipendenti e attive per soddisfare l’obiettivo di circa 20 post per piattaforma. Sono stati esaminati oltre 20 post, ma molti erano notifiche bot di rilascio senza commenti.
- Non sono stati trovati post dedicati a modelli recenti closed-source specifici, quali “Nano Banana”, “Midjourney v7”, “generazione immagini Gemini” e “Flux 2”, nonostante ricerche trasversali su Lemmy e comunità correlate. I risultati erano sepolti fra articoli tech generici e post irrilevanti.
- Sono stati trovati anche contenuti sul modello video open source Wan 2.1 di Alibaba, con problematiche di uso pornografico generato dall’IA, ma post e articoli risalivano a marzo 2025 e sono stati esclusi perché fuori dal periodo richiesto dal briefing.
- L’API di ricerca di lemmy.world ha restituito più volte errore 500 su alcune query, per esempio il recupero diretto della comunità
stablediffusione di singoli post; alcune pagine non sono quindi state recuperabili.
Pinterest — Notizie sull’IA per la generazione di immagini e video
Sono stati aperti e letti come immagini 30 dei 50 pin raccolti. La tabella in
output/pinterest.pins.md è un unico elenco piatto, non suddiviso in sezioni
per genere; si tratta quindi di un’unica analisi e non di passaggi per genere.
Temi visivi
- Riepiloghi “AI NEWS” in stile miniatura YouTube, ripubblicati su Pinterest. Il volto di un presentatore con espressione sorpresa accanto a una fila di loghi luminosi: OpenAI, Google, Microsoft, la spirale Anthropic, il simbolo infinito di Meta, la N di Notion.
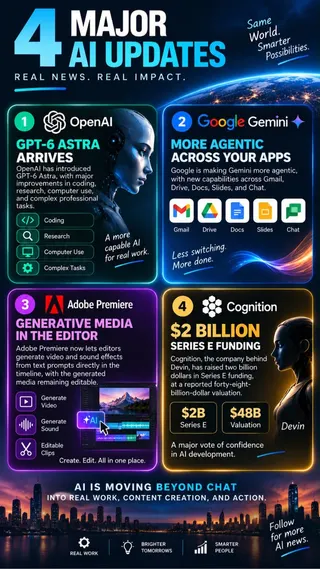
[1, 20] - Infografiche dense sugli “aggiornamenti X da conoscere”. Schede multipannello che raccolgono più notizie: GPT-6 Astra, Gemini “agentico” in Gmail/Docs/Slides, video e suono generativi integrati nella timeline di Adobe Premiere, Series E da 2 miliardi di dollari per Cognition; un’altra sul Google I/O 2026, con Gemini 3.5 Flash, Gemini Omni, AI Overviews che sostituisce la ricerca e occhiali Android XR.
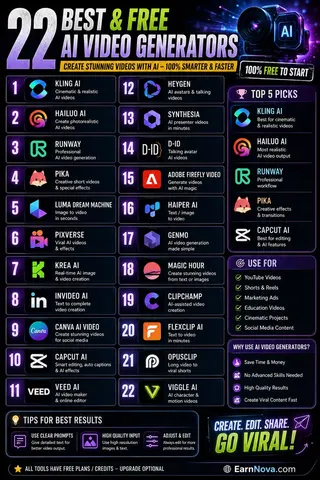
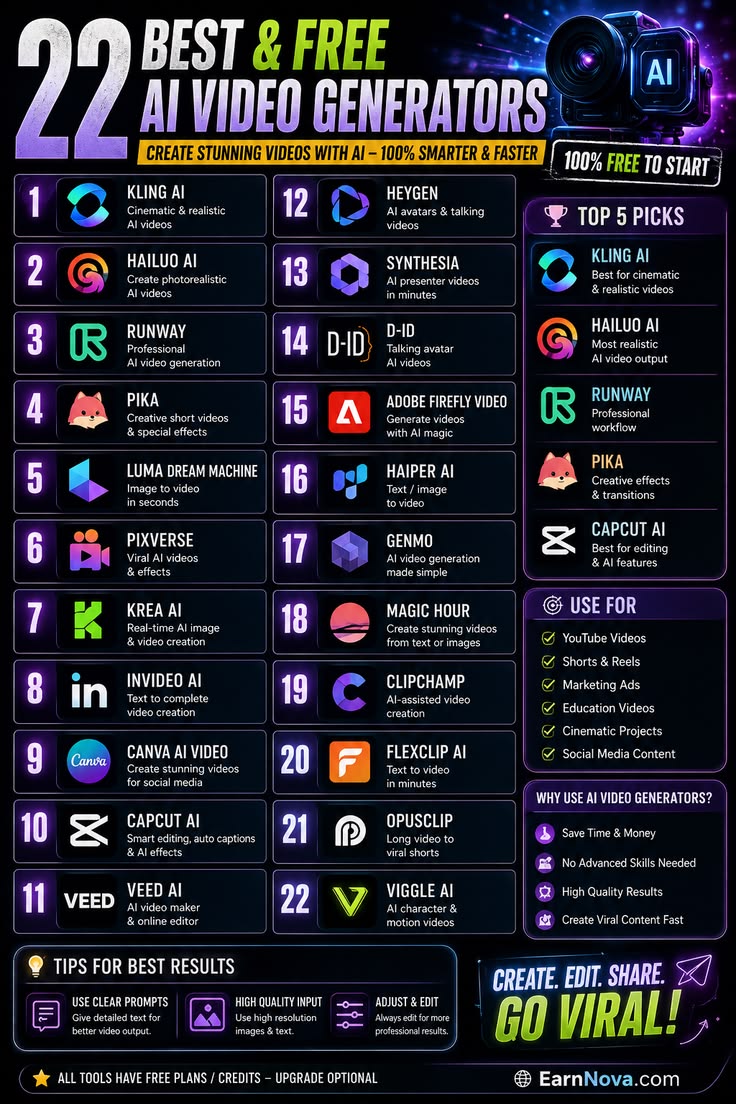
[22, 35] - Listicle “Top N generatori di video IA”, sempre con lo stesso gruppo di strumenti — Kling AI, Runway, Pika, Luma Dream Machine, HeyGen, Hailuo AI, Google Veo, OpenAI Sora, Synthesia, D-ID — rappresentati come grafiche da smartphone o poster per blog SEO/affiliate.
[27, 47, 49] - Illustrazioni hero di robot umanoidi usate come decorazione generica in pin promozionali: mani robotiche cromate che sorreggono un logo OpenAI, un androide arancione dietro un monitor, una cyborg divisa a metà fra umano e circuiti.
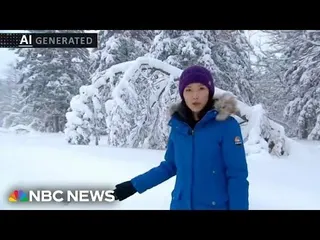
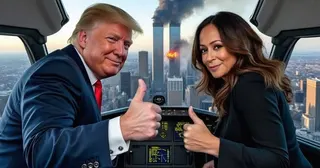
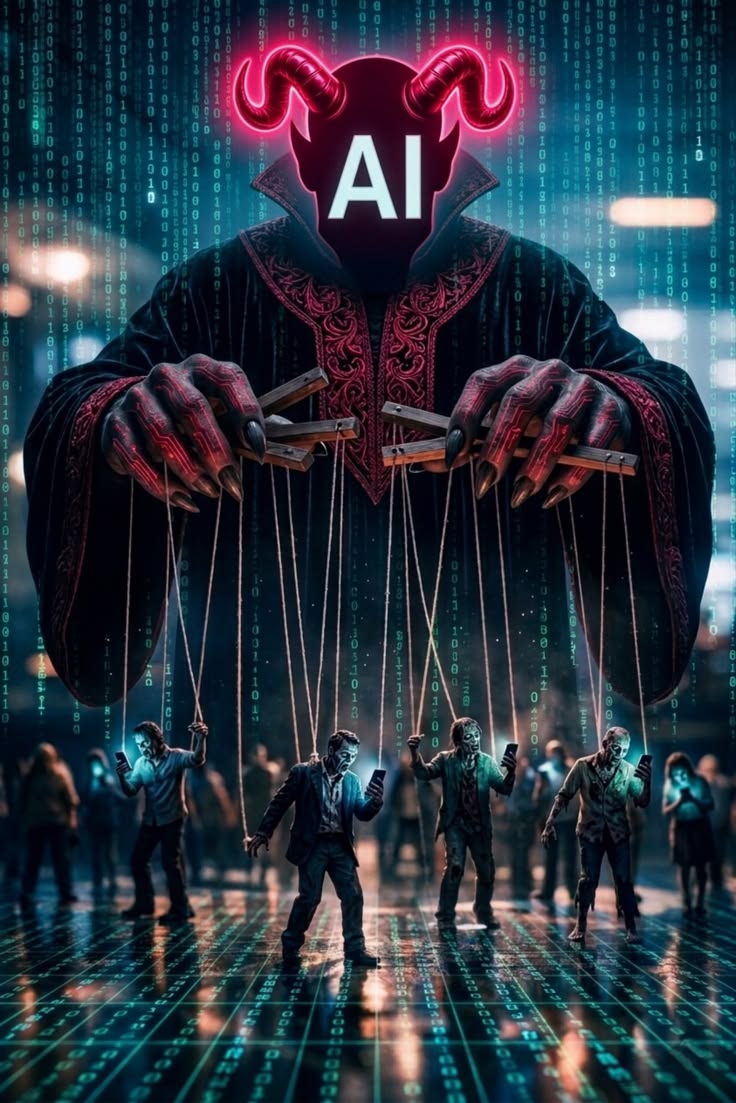
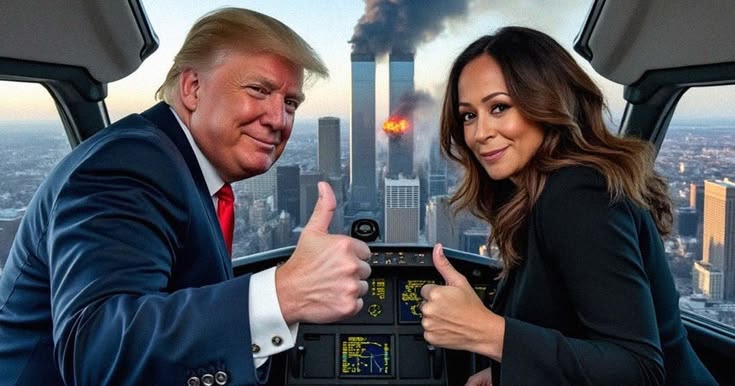
[16, 21, 41] - Immagini di ansia per deepfake/disinformazione: un clip brandizzato NBC News e segnato “AI GENERATED” con una falsa corrispondente nella neve; un’immagine divisa “Human Journalism vs. Machine-Generated Media”; un robot con scritta “FAKE” accanto a una foto IA di gatto con numeri d’interazione inventati; un demone etichettato “AI” che manovra zombie dipendenti dal telefono; una fotografia sintetica di Trump che fa pollice in su in una cabina di pilotaggio, con un’immagine dell’11 settembre sullo sfondo.
[4, 19, 26, 30, 44] - Demo tecniche di coerenza dello stile: un video rielaborato in cinque stili — blocchi di legno, origami, mattoncini Lego e versioni ricoperte di fiori — mantenendo la stessa persona e automobile; con watermark di un modello video, mostra la trasformazione multistile da un unico clip sorgente.
[2] - Pubblicità di servizi video IA per piccole imprese: grafiche con contatti WhatsApp di freelance/agenzie che offrono “AI Video Generation from Gemini” o “Professional AI Video Creation”, sfruttando la tendenza anziché raccontarla.
[9, 24, 37] - Fotografia stock aziendale generica senza alcun contenuto IA, nonostante titoli adiacenti al tema: team d’ufficio davanti a un laptop, padre e figlio compositati in un muro luminoso di ricordi, ritratto di un vecchio pescatore per un annuncio di “Amuse 3.0”, generatore locale di immagini di AMD identificabile solo da un piccolo logo.
[13, 28, 40, 45]
Pin notevoli
- [1] “AI News: Anthropic Leak Shows Us The Future of AI...” — Formato generico da miniatura con presentatore, che combina OpenAI/Google/Microsoft/Anthropic; il titolo promette una fuga di notizie su Anthropic, ma l’immagine non contiene dettagli specifici.
- [2] “Just Nail It 🎥” — Una griglia 3×5 che trasforma un video sorgente di una persona e un’auto in stili a blocchi di legno, origami, Lego e fiori, con watermark del modello video “Lumiere”: la demo di prodotto effettiva più chiara del set.
- [10] “Veo 3 Image-to-Video: Fast Generation & Native Audio via Gemini API” — Prodotto closed-source di Google, che propone velocità e audio nativo come fattori distintivi.
- [14] “Kling.ai AI-Powered Text-to-Video Generation” — Strumento cinese closed-source di Kuaishou, presentato come scelta di punta accanto agli strumenti occidentali.
- [15] “ByteDance and Hollywood reach global deal on AI copyright” — Accordo ByteDance/MPA per rafforzare la protezione della proprietà intellettuale negli strumenti IA di ByteDance per immagini/video; rara storia giuridico-politica del set.
- [23] “Google’s Gemini Omni Turns Anything Into Video” — Ripubblicazione da un’agenzia, Osiz Technologies, dell’annuncio del modello Omni di Google.
- [30] “AI news videos blur line between real and fake reports” — Clip segnato NBC News e “AI GENERATED”, con una falsa corrispondente sulla neve, usato per illustrare direttamente il problema della fiducia.
- [34] “Google Makes AI Watermarks Optional for Images and...” — Il titolo suggerisce che Google abbia reso facoltativi i requisiti di SynthID/watermark.
- [35] “4 Major AI Updates You Need to Know in 2026” — Infografica che comprende GPT-6 Astra, l’espansione agentica di Gemini, media generativi nella timeline di Adobe Premiere e il finanziamento da 2 miliardi di dollari di Cognition a una valutazione di 48 miliardi.
- [43] “Stability AI’s Stable Diffusions Maker Can Now Build AI Generative Video” — L’unico pin che nomina specificamente una linea open-weight, Stability AI, per i video.
Segnali
- Cosa è attuale: l’offerta Pinterest su questo tema è dominata da aggregazione secondaria — riepiloghi in stile miniatura YouTube, listicle affiliate che classificano ripetutamente gli stessi circa 12 strumenti video e infografiche esplicative — invece di annunci primari o generazioni pratiche. In tutte le liste lette, gli strumenti closed-source cinesi, Kling e Hailuo, appaiono sullo stesso piano di quelli occidentali, Veo, Sora e Runway. L’ansia per deepfake e disinformazione è un genere visivo ricorrente autonomo, fatto di falsi conduttori, immagini politiche fabricate e grafici sul giornalismo umano contro quello generato da macchine. Sembra essere il gancio emotivo che guida il coinvolgimento più degli strumenti stessi.
- Cosa manca: nonostante Pinterest sia normalmente forte come piattaforma di moodboard e creatività, nessun pin mostrava workflow open source reali — nessuno screenshot ComfyUI, nessun LoRA o contenuto di fine-tuning, nessun collegamento a Flux, SDXL, HunyuanVideo o Wan e nessuna bacheca estetica di comunità artistiche. Solo un pin,
[43], nominava una linea open source, e soltanto il marchio Stability AI, non un modello o una tecnica. Il lavoro di Anthropic per immagini/video non compare, nonostante il nome nel titolo[1]. Le pubblicità di piccoli studi/freelance per “servizi video IA” sono più numerose delle vere notizie di prodotto.
Limiti
- Sono stati letti 30 dei 50 pin raccolti, il 60%; i restanti 20 non sono stati aperti per limiti di tempo, perciò alcuni pin notevoli potrebbero essere sottorappresentati.
- La tabella dei pin non contiene sezioni per genere, ma una sola lista piatta sotto un’unica ricerca; il riepilogo non può quindi essere suddiviso per genere come consentito dal playbook per esecuzioni multigenere.
- 12 dei 50 pin non hanno titolo, indicato come “(untitled)”; diversi si sono rivelati fotografie stock generiche con contenuto IA solo incidentale o assente. Questo limita l’affidabilità dell’indice basato solo sui titoli.
- I titoli sono spesso inglese SEO/affiliate sgrammaticato, come “AI For Image And video Generation” e “AI black GPT”. Ciò corrisponde a quanto mostrato dalle immagini, ma molti titoli notevoli promettono più specificità di quella effettivamente presente nel pin collegato.
Azioni consigliate
- Ripetere la fase di raccolta X con parole chiave esplicite, come Midjourney, Sora 2 e Stable Diffusion, anziché termini di tendenza.
- Dare priorità al monitoraggio delle linee open-weight, come Qwen-Image-2.1 e LTX-2.5, il cui ecosistema si amplia molto rapidamente fin dal lancio.
- Seguire con continuità i casi in cui l’uso non dichiarato di contenuti generati dall’IA evolve in licenziamenti, cause e regolamentazione.
- Osservare regolarmente gli equilibri fra Veo, Kling, Runway e Grok Imagine dopo il ritiro di Sora.
- Poiché la comunicazione ufficiale aziendale è quasi inattiva su Bluesky, concentrare la ricerca sui profili dei singoli creatori.
Immagini raccolte




























Nota sulla qualità dei dati
X non contiene dati effettivamente utili, poiché ha raccolto solo post irrilevanti tramite parole di tendenza. Reddit, YouTube, Bluesky e Pinterest non hanno raggiunto l’obiettivo di circa 20 elementi; YouTube e Bluesky hanno inoltre modificato il metodo di raccolta per limiti tecnici, rispettivamente blocco di WebFetch e API di ricerca con errore 403.