Notizie sull'IA per la generazione di immagini e video — 2026-09-25
Questa è stata una settimana in cui il settore closed-source si è riorganizzato tra la rapida diffusione di Seedance 2.5 e la chiusura dell'API di Sora, mentre nel settore open un Qwen-Image-2.1 da 7B si è avvicinato ai maggiori modelli closed-source; al tempo stesso, sono emersi molti casi (MiniMax H3, Wan 3.0) in cui l'etichetta «open source» non corrisponde alla realtà.
Riepilogo delle notizie sull'IA per la generazione di immagini e video: cosa sta succedendo ora tra closed e open? — 2026-09-25
Ciao! Questa settimana il mondo dell'IA per immagini e video si è mosso parecchio, quindi ecco un riepilogo completo 🔥 Sul fronte closed-source, Seedance 2.5, Nano Banana e la fine di Sora hanno creato un'atmosfera da vero festival 🎉; ma anche il fronte open sta facendo sul serio: Qwen-Image-2.1, un modello da appena 7B parametri, sta sfidando frontalmente alcuni dei modelli closed più potenti. Francamente, è uno sviluppo davvero entusiasmante 👀. Dall'altra parte, casi come MiniMax H3 e Wan 3.0 mostrano un problema ricorrente di modelli «pseudo-open»: vengono presentati come «open source!», ma in realtà sono strettamente vincolati da licenze o disponibili solo via API ⚠️. Inoltre, su Reddit e Pinterest continua a covare la rabbia per i contenuti generati dall'IA che si infiltrano spacciandosi per reali: tecnologia e fiducia sono due temi che stanno avanzando insieme.
Tra le piattaforme
- Seedance 2.5 (ByteDance, closed-source) è uno dei protagonisti su tutte le piattaforme 🎬. Viene citato su Reddit (spiegazioni di tecniche per video lunghi), X (post che elaborano in AE filmati base di MiniMax H3), YouTube (tutorial per produrre UGC pubblicitari in massa) e Lemmy: sembra senza dubbio il modello video closed più effettivamente usato del momento.
- MiniMax H3 (modello video open-weight) dà l'impressione di essere «usabile gratis», ma non è vero open source 😅. È argomento di discussione su Reddit, X, YouTube e Lemmy, ma un'indagine su YouTube ha rivelato che la «MiniMax H3 Community License» è una licenza personalizzata che esclude utenti nell'UE, nel Regno Unito, in Corea del Sud e negli Stati Uniti. Molti si lasciano attirare da titoli con «Open-Source», ma vale la pena verificare i fatti.
- Qwen-Image-2.1 (Alibaba, open) compete con Nano Banana 2.0, il maggior modello closed-source, pur avendo appena 7B parametri 💪. Sia su YouTube sia su Lemmy viene valutato positivamente come modello «piccolo ma potente», un buon esempio della capacità del fronte open di puntare sull'efficienza dei parametri.
- L'etichetta «open source» sta subendo un'inflazione 📢. Non riguarda solo MiniMax H3: anche Wan 3.0 (Alibaba) viene spesso confuso con il precedente Wan 2.2 (Apache 2.0), pur essendo disponibile solo via API, come rilevato da YouTube. Anche su Lemmy pochi post distinguono rigorosamente tra «open» e «closed»: sembra che l'etichetta corra più veloce della sostanza.
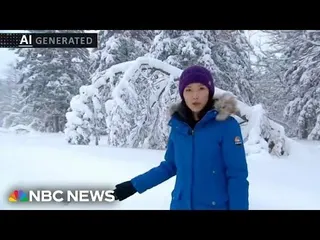
- La rabbia per i contenuti IA che «si infilano spacciandosi per reali» è un tema comune su più piattaforme 😤. Su Reddit hanno suscitato polemiche tre casi: modifiche IA non autorizzate a foto di annunci immobiliari, sospetti di «falsificazione scientifica» nel concorso Nikon Small World in Motion e immagini IA smascherate su Instagram. Anche su Pinterest, le immagini di «finti conduttori di notiziari» con sottopancia in stile NBC News sono un genere ricorrente. Il problema della fiducia continua a fermentare insieme alle tendenze tecnologiche.
- La fine dell'API di Sora (OpenAI) il 2026-09-24 è emersa su più piattaforme come un «vuoto di copertura» 🕳️. Su Lemmy circola insieme alla notizia di un concorrente cinese che ha raccolto 3 miliardi di dollari, ma le reazioni sono deboli; anche su YouTube non si trovano video specialistici. L'attenzione sembra essersi già spostata verso strumenti successori come Seedance e Wan.
Piattaforma per piattaforma
Reddit vede ricomparire ripetutamente thread del tipo «voglio creare video IA gratuiti e di alta qualità», mentre i picchi di interesse maggiori sono stati l'indignazione per le immagini IA immobiliari su r/mildlyinfuriating (27.000 pt) e i sospetti di falsificazione nel concorso scientifico Nikon su r/labrats (1.089 pt). I post che distinguono chiaramente tra closed e open sono pochi e tendono a limitarsi a elencare strumenti.
X ha avuto una ricerca distorta dal fatto che il punto di partenza fosse il pannello delle tendenze in Croazia: 32 dei 40 post erano irrilevanti (crypto, calcio, gossip sulle celebrità) 🙈. Gli 8 restanti riguardavano quasi tutti l'uso di Claude Opus 5.5 per controllare After Effects, Blender, Unreal o Godot. Il protagonista non era tanto la generazione in sé, quanto la sorpresa per un «agente IA che aziona strumenti già esistenti».
YouTube ha pochi canali (7 elementi), ma contenuti densi: al centro ci sono canali rapidi nelle recensioni di GPT Image 2.5, Qwen-Image-2.1, MiniMax H3 e Seedance 2.5 appena usciti. È stata l'unica piattaforma a segnalare chiaramente l'ambiguità del confine fra open e closed, inclusi i problemi di licenza di MiniMax H3 e Wan 3.0.
Bluesky ha l'API di ricerca bloccata con un errore 403, per cui non è stato possibile cercare per parola chiave 😢 ed è stato necessario seguire individualmente gli account trovati. Sul lato closed (ad esempio gli annunci di nuovi modelli di Replicate), i post si concentravano nella prima metà del 2026; gli autori open (ostris, doctordiffusion e l'account ufficiale di Hugging Face) avevano invece smesso di aggiornare tra il 2024 e il 2025. Su Bluesky non è stato trovato quasi nulla su Qwen-Image-2.1 e altri argomenti del 2026.
Lemmy ha nelle comunità !stable_diffusion la vera casa del fronte open-source, con contenuti tecnici incentrati su integrazioni ComfyUI e link a HF. Le notizie closed (la fine di Sora, il passaggio di Midjourney ai dispositivi medicali) arrivano solo tramite cross-post da r/ArtificialInteligence, con punteggi quasi sempre tra 0 e 1 e senza discussioni locali.
Pinterest ha visto l'apertura e la verifica diretta di 20 pin su 50: sono emersi soprattutto diagrammi comparativi closed-source del tipo «quale app dovrei usare?», con Runway, Pika, Kling, Luma, Google/OpenAI, e immagini legate alla sfiducia nell'IA. Non è comparso nemmeno un nome di modello open source né uno screenshot di ComfyUI 📌. La distinzione richiesta dal brief fra «10 casi open / 10 closed» non era possibile con il solo materiale di Pinterest.
Da tenere d'occhio
- Qwen-Image-2.1 (7B, in competizione con i maggiori modelli closed) — YouTube: https://www.youtube.com/watch?v=3qGl0wiv2G0
- Il problema della licenza di MiniMax H3 (etichettato «Open-Source», ma con UE/Regno Unito/Corea del Sud/Stati Uniti esclusi) — YouTube: https://www.youtube.com/watch?v=XJ4mHfQzZ7I
- Fine dell'API di Sora e raccolta di 3 miliardi di dollari da parte di un concorrente cinese — via Lemmy: https://www.reddit.com/r/ArtificialInteligence/comments/1wluu0n/
- Sospetti di «miglioramento» IA al Nikon Small World in Motion (un problema di affidabilità nei concorsi scientifici) — Reddit: https://www.reddit.com/r/labrats/comments/1wo0j5e/
- Claude Opus 5.5 che controlla direttamente Blender/Unreal/Godot (l'«agentificazione» dell'IA generativa) — X: https://x.com/kevin_t_ngo/status/2102761406315839798
- La clausola di DreamWorks che vieta l'addestramento IA sul nuovo film “Forgotten Island” — Reddit: https://www.reddit.com/r/antiai/comments/1wnrfi6/
Raccomandazioni
- Continuare a monitorare i piccoli modelli open come Qwen-Image-2.1 e seguirne singolarmente gli aggiornamenti dei benchmark.
- Per ogni modello che dichiara di essere «open source», controllare sempre il testo della licenza prima di classificarlo (MiniMax H3 e Wan 3.0 sono casi esemplari).
- Inserire nella prossima ricerca le tendenze di migrazione verso servizi alternativi a Sora dopo la chiusura dell'API, come Seedance, Wan e Kling.
- Nelle prossime ricerche su Bluesky e Pinterest, aggiungere termini specifici come «ComfyUI», «Hugging Face» e «Flux» per compensare la scarsa visibilità del fronte open.
- Seguire continuativamente il tema della «sfiducia nei contenuti generati dall'IA», comune a Reddit e Pinterest, senza separarlo dalle notizie tecnologiche.
- Per X, raccogliere di nuovo i dati usando parole chiave specifiche del tema invece di affidarsi al pannello delle tendenze.
Qualità dei dati
Nessuna piattaforma ha raggiunto il criterio di completamento del brief (circa 20 post analizzati per social): Reddit 12 elementi, X 8 pertinenti su 40, YouTube 7, Bluesky 12 insight ricavati da circa 30 elementi, Lemmy 12, Pinterest 20 pin aperti su 50. In particolare, su X l'80% dei contenuti era irrilevante perché la ricerca partiva dal pannello delle tendenze croato; su Bluesky l'API ha continuato a restituire 403, impedendo la ricerca trasversale per keyword e costringendo a basarsi sugli account già individuati; su Pinterest la query non divideva open e closed e il materiale open-source era semplicemente assente. Per questi limiti, le «notizie più recenti» sul lato open sono concentrate soprattutto su YouTube e Lemmy, con poche conferme da X, Bluesky e Pinterest.
Riepilogo per piattaforma
Reddit — Notizie sull'IA per la generazione di immagini e video
Dove
Ripartizione dei 12 thread raccolti (è stata usata una sola query di ricerca: "Image and Video Generation AI News"):
| Subreddit | Membri | Thread raccolti |
|---|---|---|
| r/generativeAI | 156.863 | 5 |
| r/labrats | 726.659 | 1 |
| r/aivideomaking | 7.660 | 1 |
| r/mildlyinfuriating | 12.593.078 | 1 |
| r/Instagramreality | 1.155.761 | 1 |
| r/AIdaily_news | 3.108 | 1 |
| r/aiwars | 169.389 | 1 |
| r/antiai | 338.300 | 1 |
r/generativeAI è di fatto il centro delle «notizie» (5 elementi), ma la maggior parte dei contenuti consiste in domande su come trovare servizi gratuiti per generare video. Al contrario, i contenuti più virali non provengono né da subreddit specialistici né da comunità favorevoli all'IA, bensì da r/mildlyinfuriating (grande comunità generalista, 12,59 milioni di membri) e r/labrats (comunità di ricercatori, 730.000 membri), entrambi incentrati sulla rabbia verso i contenuti IA.
Cosa dicono le persone
- #1 r/generativeAI · 37 pt · 36 commenti · 2026-09-22 (link) — Uno sviluppatore indipendente promuove «Locally Uncensored», un servizio di generazione di immagini, video e testo che dichiara di essere senza censura. Le reazioni sono scettiche: u/No_Laugh_3115 pone una domanda cruciale: «Quando i modelli upstream verranno aggiornati, la parte “uncensored” dovrebbe essere la prima a peggiorare: come gestirete la cosa? Fate fine-tuning proprietario oppure vi limitate a incapsulare pesi open?»
- #2 r/labrats · 1.089 pt · 131 commenti · 2026-09-23 (link) — Il video vincitore di quest'anno al Nikon Small World in Motion era stato in realtà «migliorato e colorizzato» con IA, con strutture biologicamente impossibili che appaiono e scompaiono. u/Barkinsons (618 pt): «Gli strumenti IA non hanno posto nelle immagini di microscopia scientifica. Abbiamo il dovere di riprodurre le immagini nel modo più fedele possibile, non di farle apparire migliori». u/holydiver18 (53 pt) critica duramente la risposta dell'organizzazione: «Questo è chiaramente un comportamento scorretto».
- #3/#9/#11/#12 r/generativeAI · r/aivideomaking (rispettivamente 16 pt/2 pt/0 pt/4 pt, 2026-09-19–22) — Quattro thread indipendenti chiedono «voglio creare video IA gratis», rivelando che è il bisogno più ricorrente su Reddit. Il modello di risposta comune è che non esiste la triade di gratuità reale, alta qualità e assenza di filigrana (il bot Jenna_AI ripete lo stesso ragionamento in #9, #11 e #12). Strumenti menzionati: FramePack, ComfyUI, Grok ($10/mese), Venice, Nanobanana/Veo (tramite Google Flow), Muse (Meta), dreamfort.ai.
- #4 r/mildlyinfuriating · 26.766 pt · 719 commenti · 2026-09-21 (link) — Di gran lunga il punteggio più alto del campione. Indignazione per l'inserimento non dichiarato di «immagini d'ispirazione» generate dall'IA nelle foto di annunci immobiliari. u/slothboy (5.749 pt): «Trasformare quella sala da pranzo in un bagno è un progetto da cinque cifre». u/BojackWorseman13 (1.138 pt) propone di indicare a caratteri grandi sulle foto che sono generate dall'IA.
- #5 r/generativeAI · 7 pt · 31 commenti · 2026-09-23 (link) — Una spiegazione pratica di u/kaboom-o (2 pt) su come creare video IA lunghi: «Nessuno crea video lunghi in un solo tentativo. Si scompone una sceneggiatura in una lista di inquadrature, si crea una montagna di clip da 5–15 secondi e poi si monta tutto». Per mantenere a lungo le espressioni facciali consiglia Seedance 2.5 (fino a circa 30 secondi, con audio nativo), per abbozzare il movimento Grok Imagine Video (480p, 5 secondi) e per una qualità fotografica Gemini Omni Flash.
- #6 r/Instagramreality · 2.206 pt · 351 commenti · 2026-09-18 (link) — Un thread che dimostra come un'immagine IA molto apprezzata su Reddit fosse in realtà falsa. u/Smart-Membership-117 (427 pt): «La rifinitura del battiscopa accanto al ginocchio è diversa nella foto 2 e 3. Anche il verde fuori dalla finestra è completamente cambiato». u/Habibti-Mimi81 (154 pt): «Onestamente, io non me ne sarei accorto. È un'epoca triste e pericolosa».
- #7 r/AIdaily_news · 0 pt · 12 commenti · 2026-09-24 (link) — Un thread che ripercorre i video IA diventati popolari nel 2024. La frase di u/Erosion139 (1 pt) è emblematica: «Allora era il periodo in cui l'IA “sognava”», con molti commenti nostalgici sugli strani artefatti di quell'epoca.
- #8 r/aiwars · 0 pt · 144 commenti · 2026-09-24 (link) — Dibattito acceso su una clip anime che, secondo l'autore, è stata prodotta da una sola persona con $13 usando Seedance 2.5. Il post la celebra come un'epoca in cui si possono creare opere di livello professionale senza diventare animatori; u/GameMask (4 pt) ribatte: «Il fatto stesso che sia costata $13 è piuttosto imbarazzante. Non rappresenta alcun progresso per l'industria dell'animazione». u/Onionadin (7 pt) va oltre: «Sembra che si stia esultando per una maggiore capacità di ingannare le persone».
- #10 r/antiai · 18.115 pt · 623 commenti · 2026-09-23 (link) — La comunità antiai festeggia la notizia che DreamWorks abbia aggiunto al nuovo film «Forgotten Island» una clausola che vieta l'addestramento IA. Tuttavia u/SlowlyDyingInAPit (2.561 pt, commento più votato) resta lucido: «È fantastico, ma i sostenitori dell'IA continueranno ostinatamente a usarla per produrre slop. Se qualcosa è proibita, avranno ancora più voglia di farla». u/Arckanoid (143 pt) analizza l'obiettivo legale: «Lo scopo non è fermarli, ma creare una base per intentare cause».
Segnali
- Presenza del fronte open source/locale: nomi come ComfyUI, FramePack, Seedance 2.5 e Minimax H3, modelli eseguibili localmente o a basso costo, ricompaiono in più thread. In particolare, la risposta di kaboom-o in #5 è apprezzata come sapere pratico su come «saltare da un modello all'altro».
- Il closed source viene raccontato come una “frammentazione dell'esperienza”: davanti alla proliferazione di servizi closed come Grok, Veo, Nanobanana, Runway, Luma, Kling, Hailuo e Pixverse, il commento standard di Jenna_AI bot — «gratuito, alta qualità e senza filigrana non possono coesistere» — è così radicato da essere ripetuto in tre thread (#9, #11, #12).
- Il conflitto si acuisce sulla possibilità di rilevarli: #6 (Instagramreality) e #2 (Nikon) si concentrano sulla rabbia per contenuti IA consumati come «reali». In #8 (aiwars), invece, chi considera positiva la democratizzazione della tecnologia e chi la considera uno strumento di inganno si scontrano frontalmente; la divisione di opinioni dell'intero Reddit diventa chiaramente visibile.
- L'aspetto sorprendente: un video contenente «miglioramenti» IA — di fatto falsificazioni — ha vinto il gran premio del prestigioso concorso scientifico Nikon Small World in Motion, e l'organizzazione ha risposto in modo difensivo (#2). La comunità scientifica è stata estremamente severa: non si tratta della solita «controversia sull'arte IA», ma di etica della ricerca, con un tono ben diverso dalle altre notizie sull'IA generativa.
- Ciò che viene trascurato o dato ormai per perso: le richieste di «video IA gratuiti e di alta qualità» (#3, #9, #11, #12) arrivano quasi sempre alla stessa conclusione — «il gratuito non esiste, qualcuno deve pagare elettricità e GPU» — e sembrano ormai un argomento che ha stancato la comunità.
Limiti
- È stata usata solo la query
"Image and Video Generation AI News"; non sono state effettuate altre ricerche con formulazioni alternative, ad esempio nomi specifici di modelli open source o servizi closed-source. Rispetto all'obiettivo di circa 20 post analizzati per social, sono stati raccolti solo 12 thread. - Per il thread #6 (r/Instagramreality) e il #7 (r/AIdaily_news), i dati raccolti non includevano il testo iniziale del post; il contenuto è stato dedotto solo dai commenti principali.
- La raccolta è interamente sbilanciata verso subreddit anglofoni: non è stato raccolto neppure un thread Reddit in giapponese o in altre lingue. Nonostante il brief sia in giapponese, questa lacuna non è stata colmata.
- Pochi thread discutono distinguendo chiaramente fra «closed source» e «open source»; molti si limitano a elencare strumenti misti. I dati di Reddit da soli non consentono di separare rigorosamente le 10 tendenze open-source e le 10 closed-source richieste dal brief.
X
X — Il dominio agentico degli strumenti creativi da parte di Claude Opus 5.5 è l'unico segnale IA per immagini/video in questa finestra
Origine di questo elenco
Il pannello Explore di X che ha fornito i termini di ricerca era geolocalizzato in Croazia (output/x.posts.md, "What X says is happening"): 6 delle sue 10 tendenze sono esplicitamente «Trending in Croatia», mentre le altre sono tendenze generiche di sport, musica, business e tecnologia sovrapposte. È un'istantanea locale croata di X, non globale. Solo 2 dei 10 termini di tendenza — "Opus 5.5" e "Claude" — riguardano anche solo marginalmente l'IA per generare immagini/video; gli altri 8 ($song, Serbia, Taylor, Cardano, Croats, Croatia, NFTs, England) sono conversazioni irrilevanti su crypto, calcio, gossip e geopolitica, tendenze in quella località questa settimana. Vedere ## Limiti per le conseguenze sulla copertura.
Account
Tutti coloro che hanno postato sul tema sono autori occasionali, tranne uno:
- @KanaWorks_AI (KANA|東京AI映像) — l'unico account ricorrente, con 2 post (150 + 335 like). Account dedicato ai «video IA» basato a Tokyo; entrambi i post riguardano l'uso di Claude Opus 5.5 per guidare motori di gioco, prima Unreal e poi Godot.
- @kevin_t_ngo (Kevin Ngo) — 1 post, ma con la maggiore portata dell'insieme: 3.480 like e circa 236.000 visualizzazioni. Tagga direttamente
@claudeai; un'animazione Python/Blender è stata renderizzata da Claude Opus 5.5. - @developedbyed (Dev Ed) — 1 post, 1.071 like, circa 70.000 visualizzazioni. Popolare account di formazione per sviluppatori che propone un confronto di animazioni «OPUS 5.5 vs GPT 6 Astra».
- @ring_hyacinth — 1 post, 712 like, circa 44.000 visualizzazioni. Un creatore individuale che racconta un esperimento personale: trasformare un vecchio cortometraggio in un gioco pixel-art.
- @aicreataro — 1 post, 444 like, circa 45.000 visualizzazioni. Account di un creatore IA che pubblica un log strutturato del test (clip base + operazioni in After Effects).
- @seiiiiiiiiiiru (SEIIIRUAIを使う映像クリエイター) — 1 post, 163 like, circa 7.900 visualizzazioni. Account giapponese di un creatore di video IA, autoidentificato dallo strumento che utilizza.
- @ponzponz15 (ぽんず) — 1 post, 212 like, circa 32.000 visualizzazioni. Creatore giapponese che documenta una tecnica di montaggio specifica.
In sintesi: un account specializzato in video IA con due post e sei creatori individuali, ciascuno con una demo/test ad alto coinvolgimento. Nessuno è un organo di informazione o un media di settore: sono tutti contenuti in prima persona del tipo «ho provato questo».
Post
-
@developedbyed (1.071 like · 26 repost · 35 risposte · ~70.000 visualizzazioni · 2026-09-23) — https://x.com/developedbyed/status/2102789774461280370
OPUS 5.5 vs GPT 6 Astra Loss Screen Animation
Un confronto diretto fra modelli per animazioni, pubblicato da un account con un vasto pubblico di sviluppatori: il contenuto più vicino, in questo insieme, a un benchmark «closed-source contro closed-source». -
@kevin_t_ngo (3.480 like · 167 repost · 81 risposte · ~236.000 visualizzazioni · 2026-09-23) — https://x.com/kevin_t_ngo/status/2102761406315839798
Thank you @claudeai ! GIF animated in Python and rendered in Blender by Claude Opus 5.5
Il post con il maggiore coinvolgimento dell'intera raccolta di 40 post legati al tema. Segnala una vera sorpresa per il fatto che un LLM possa gestire un renderer 3D da capo a fondo, non solo generare un'immagine statica. -
@ring_hyacinth (712 like · 81 repost · 51 risposte · ~44.000 visualizzazioni · 2026-09-23) — https://x.com/ring_hyacinth/status/2102865595675050010
Opus 5.5 is really amazing! I sent the short film Pixel Shanghai that I made a year ago to Opus 5.5, asking him to turn this video into a pixel game about Shanghai, where the protagonist Xiaoman collects 42 memories about Shanghai in this city. The scenes use the pixel [text cut off by X]
Conversione da video a asset di gioco: Opus viene usato come livello di direzione creativa su filmati esistenti, anziché come generatore da zero. -
@aicreataro (444 like · 66 repost · 7 risposte · ~45.000 visualizzazioni · 2026-09-23) — https://x.com/aicreataro/status/2102656273112326609
Opus 5.5にAfter Effectsを操作させて、AI動画を加工するテスト。■ベース MiniMax H3で15秒を1本 ■AEでやらせたこと ・カットの切れ目を拍に合わせて速さを調整 ・区間ごとにエフェクトを1つずつ(粒子/光線/万華鏡/データモッシュなど)■わかったこと [cut off]
Indica un modello video reale come livello base (MiniMax H3, una clip di 15 secondi), con Opus 5.5 a curare la post-produzione in After Effects: un dettaglio concreto su una pipeline open/closed. -
@KanaWorks_AI (335 like · 39 repost · 16 risposte · ~18.000 visualizzazioni · 2026-09-24) — https://x.com/KanaWorks_AI/status/2102955708321062975
Claude Opus 5.5 × Godotで3Dゲーム開発。Godotでゲームを作るのは、Unityより少し手軽に感じる。動作も軽くて、仕上がりもかなりいい感じ
Il secondo post dello stesso account (sotto) mostra che non si tratta di un esperimento isolato: sta portando avanti una piccola serie che testa Opus 5.5 su motori diversi. -
@KanaWorks_AI (150 like · 16 repost · 11 risposte · ~8.300 visualizzazioni · 2026-09-24) — https://x.com/KanaWorks_AI/status/2103138051165933661
Claude Opus 5.5 × Unreal まさか、自分でこんなARPGを作れる日が来るなんて思ってもいませんでした。コントローラーを握って、キャラクターを走らせて、ローリングして、剣を振る。実際に動かしてみた瞬間、心臓がドキドキして、手のひらは汗びっしょり。
Reazione emotiva e personale alla creazione, da parte di Opus 5.5, di un ARPG giocabile in Unreal Engine: viene presentata come un traguardo personale, non come annuncio di prodotto. -
@ponzponz15 (212 like · 17 repost · 7 risposte · ~32.000 visualizzazioni · 2026-09-24) — https://x.com/ponzponz15/status/2102931824918106499
3Dカメラ×立体テキスト演出② After Effectsで作るような編集がClaude OpusやCodexでも可能に。上 Seedance 2.5 prev 下 Codex + Hyperframes skill #dreaminacpp
Cita altri due componenti di generazione/tooling — Seedance 2.5 (generazione video) e una skill Codex + “Hyperframes” — concatenati con Claude per creare motion graphics in stile AE. -
@seiiiiiiiiiiru (163 like · 23 repost · 9 risposte · ~7.900 visualizzazioni · 2026-09-24) — https://x.com/seiiiiiiiiiiru/status/2103227982592831846
AI広告動画 → AI音声 × AI編集 もうここがゴール地点ってことでいいでしょ。笑 Cluad Opus 5.5にGemini 3.8 Flash TTSでナレーション生成させて、その音声に合わせた動画をそのままClaudeでAEやその他ツールを操作して作りました。
Una pipeline pubblicitaria completa: Gemini 3.8 Flash TTS genera la voce narrante e Claude Opus 5.5 orchestra After Effects per sincronizzare il montaggio alla traccia vocale.
Segnali
- In crescita: la conversazione su X non riguarda «scrivi un prompt e ottieni un'immagine/video», ma Claude Opus 5.5 come agente che aziona software creativi esistenti (After Effects, Blender, Unreal, Godot) sopra clip o asset creati altrove. Ogni post rilevante tratta questo come l'elemento nuovo ed entusiasmante, non la fase generativa.
- In crescita: uno schema a catena — un modello generativo dedicato produce l'output grezzo (MiniMax H3, Seedance 2.5, Gemini 3.8 Flash TTS) e Opus 5.5 cura assemblaggio, post-produzione e direzione. Due post (@aicreataro, @ponzponz15) nominano esplicitamente il generatore a monte: è il dettaglio più concreto, vicino alla distinzione open/closed, emerso dalla piattaforma.
- Sorpresa: il post con più coinvolgimento (@kevin_t_ngo, ~236.000 visualizzazioni) non riguarda affatto la qualità dell'output, ma il fatto che un LLM possa controllare Blender end-to-end. La reazione riguarda capacità e autonomia, non fedeltà visiva.
- Assente o ignorato: in questa finestra non sono comparsi Midjourney, Stable Diffusion, Flux, Sora, Runway, Kling né una contrapposizione esplicita fra «open source e closed source». Se tale impostazione emergerà in una sintesi successiva, dovrà essere un'inferenza, non una citazione da X.
Limiti
- I termini di ricerca provenivano dalle tendenze di X, non dal tema. I 10 termini del worker arrivavano direttamente dal pannello Explore di X (vedere
output/x.posts.md), geolocalizzato in Croazia. Solo «Opus 5.5» e «Claude» sono pertinenti alla generazione di immagini/video; gli altri 8 ($song, Serbia, Taylor, Cardano, Croats, Croatia, NFTs, England) hanno restituito pump crypto, risultati calcistici, gossip e discussioni politiche sul conflitto nei Balcani: 32 dei 40 post raccolti, nessuno utile per questo brief. - Al di sotto dell'obiettivo di ~20 post. Solo 8 dei 40 post raccolti sono pertinenti, sotto il criterio di circa 20 post analizzati per piattaforma. Non c'è altro margine nel file raccolto: la lacuna è nella copertura ottenuta, non nella lettura.
- Nessun post diretto su open source contro closed source. Nulla di quanto raccolto affronta esplicitamente il tema; la divisione open/closed sopra è inferita dagli strumenti citati nei post (Claude Opus 5.5 e Gemini 3.8 Flash TTS sono closed; il tipo di licenza di MiniMax H3 e Seedance 2.5 non è indicato nel post).
- Diversi testi dei post sono troncati nel punto in cui la raccolta di X li ha interrotti (@aicreataro, @ring_hyacinth, @pfPokeFUN e altri); il testo completo non era disponibile in
output/x.posts.mdooutput/x.posts.json. - Sono comparsi solo post in inglese e giapponese; non sono coperte le comunità di creatori IA in cinese, coreano o altre lingue attive su X.
YouTube
YouTube — Notizie sull'IA per la generazione di immagini e video (closed-source/open-source)
Canali
Il numero di iscritti non è stato ottenibile direttamente dalla pagina dei risultati di YouTube, che usa rendering JS (vedere ## Limiti); sono riportati solo i dati recuperabili tramite oEmbed e ricerca web.
- AI WITH Rithesh (RitheshSreenivasan, poco più di 10.000 iscritti e oltre 1 milione di visualizzazioni complessive) — Canale indiano di formazione IA. Ha recensito subito dopo l'uscita sia ChatGPT Images 2.5 di OpenAI sia Qwen-Image-2.1 di Alibaba: uno dei pochi canali che seguono entrambe le sponde, closed e open.
- Astrovah (@astrovah) — Canale di strumenti IA per creatori che pubblica recensioni «oneste» di GPT Image 2.5.
- REBEL AI (@realrebelai) — Ha pubblicato una demo in early access di Qwen-Image 2.1; un canale-vetrina per modelli di immagini open source.
- Adrian Viral AI Marketing (@AdrianViralAIMarketing) — Canale comparativo per marketer IA che classifica insieme nuovi modelli, indipendentemente dal fatto che siano closed o open.
- Miko (@MikoxAI) — Canale di tutorial che insegna la produzione in massa di pubblicità UGC usando modelli video closed-source come Seedance 2.5.
- jingchen573 — Canale specializzato nell'esecuzione locale in ComfyUI, che ha dato la notizia della pubblicazione open-weight di MiniMax H3.
Video
-
Qwen-Image-2.1 Is INSANE… Just 7B Parameters?! — AI WITH Rithesh — circa 2026-09-20 (subito dopo il rilascio di Qwen-Image-2.1) — https://www.youtube.com/watch?v=3qGl0wiv2G0
Verifica Qwen-Image-2.1 di Alibaba, modello di immagini open-weight pubblicato il 2026-09-20 con un generatore da soli 7B parametri, e riferisce benchmark paragonabili a Nano Banana 2.0 di Google, un modello closed-source. -
Qwen-Image 2.1 | Early Access Showcase — REBEL AI — fine settembre 2026 — https://www.youtube.com/watch?v=tP_gGGJzEqg
Mostra esempi generati nell'early access dello stesso modello. Sottolinea che un unico modello può creare e modificare immagini trasparenti. -
[ComfyUI] Breakthrough Release: MiniMax H3, the New Leading Open-Source Video Model — jingchen573 — circa 2026-08-03 (data di pubblicazione open-weight di MiniMax H3) — https://www.youtube.com/watch?v=XJ4mHfQzZ7I
Annuncia la pubblicazione su Hugging Face di MiniMax H3 (33 miliardi di parametri, omni-modale, fino a 2K/24fps e audio stereo nativo), inclusa l'installazione in ComfyUI. Il titolo lo definisce «Open-Source», ma la licenza reale è una licenza personalizzata che esclude UE, Regno Unito, Corea del Sud e Stati Uniti (vedere## Segnali). -
ChatGPT Images 2.5 Is INSANE… 48 Hours Later, I'm Still Shocked! — AI WITH Rithesh — circa 2026-09-10 (due giorni dopo l'uscita di GPT Image 2.5) — https://www.youtube.com/watch?v=LYUr4BY33h4
Testa ChatGPT Images 2.5, pubblicato da OpenAI il 2026-09-08, 48 ore dopo il lancio: latenza ridotta fino al 50% e nuova funzione «Sketch». -
GPT Image 2.5 - Creative Use Cases You've Probably Missed And A Honest Review — Astrovah — circa 2026-09-21 — https://www.youtube.com/watch?v=_S71zN5tgQY
Una «recensione onesta» che approfondisce usi minori ma pratici dello stesso modello. -
I Ranked Every New AI Video Model (Omni 1.1, Seedance 2.5, H3 Max, Wan 3.0, Flux 3, Grok) — Adrian Viral AI Marketing — fine agosto 2026 (circa un mese prima) — https://www.youtube.com/watch?v=4BoTXsJrxQ4
Classifica fianco a fianco Gemini Omni 1.1, Seedance 2.5 e Grok (closed) insieme a Wan 3.0 e Flux 3 (inclusi modelli spesso erroneamente ritenuti open). Un video su «quale usare ora» che mescola closed e open. -
Seedance 2.5 + Grok Bot = 50 Viral AI UGC Ads a Day (Full Tutorial) — Miko — 2026-08-22 — https://www.youtube.com/watch?v=mcY7ReDNrd0
Tutorial pratico per produrre in massa pubblicità UGC combinando i closed-source Seedance 2.5 e Grok. È un caso tipico di creatori individuali che sfruttano API closed in una pipeline commerciale.
Segnali
- Il confine open/closed si sta offuscando: molti video su MiniMax H3 lo definiscono «Open-Source», mentre la sua licenza effettiva esclude Stati Uniti, UE, Regno Unito e Corea del Sud (MiniMax H3 Community License). Spesso i video non distinguono tra «open-weight» e «davvero open source e liberamente utilizzabile».
- Anche Wan 3.0 non è “open”: l'ultima versione della serie Wan di Alibaba, Wan 3.0 (resa disponibile via API intorno al 2026-08-06), non ha pesi pubblicati né su Hugging Face né su GitHub ed è limitata alle API. Nei video comparativi viene spesso confusa con Wan 2.2, il precedente modello Apache 2.0, inducendo gli spettatori a pensare che tutti i Wan siano open source.
- Il fronte open sfida i grandi con 7B parametri: Qwen-Image-2.1, con un generatore da appena 7B parametri, è considerato competitivo con Nano Banana 2.0 (closed), rafforzando la narrativa open-source che usa l'efficienza dei parametri come vantaggio.
- Il fronte closed si differenzia tramite UX di editing, come “Sketch”: le recensioni di GPT Image 2.5 si concentrano meno sulla qualità generativa pura e più sulla funzione «@Sketch», che trasforma bozze in immagini, e sulla coerenza del montaggio nelle modifiche multi-turno. La competizione si sta spostando dalla semplice generazione ai flussi di lavoro di editing.
- La generazione video si sta trasformando in una catena di strumenti: crescono tutorial come quello di Miko su Seedance 2.5 + Grok, che combinano API closed per produrre UGC pubblicitari in massa. L'interesse si sposta dal confronto fra prestazioni dei singoli modelli a come combinarne più di uno per monetizzare, in linea con quanto osservato su X.
- OpenAI Sora è un vuoto informativo: l'API di Sora era già stata interrotta il 2026-09-24, il giorno prima della ricerca, ma su YouTube non sono stati trovati video dedicati specificamente allo stop; solo articoli di blog riportavano rapidamente la notizia. L'interesse degli YouTuber sembra già essersi spostato verso strumenti alternativi come Seedance, Wan e Kling.
Limiti
- La pagina dei risultati di YouTube (
youtube.com/results?...) usa JavaScript e WebFetch non ha potuto ottenere direttamente l'elenco dei video — titoli, visualizzazioni e date di pubblicazione. Sono stati quindi combinati WebSearch (site:youtube.com) e l'API oEmbed di YouTube (youtube.com/oembed?url=...): titoli e canali sono stati verificati tramite oEmbed, mentre le date sono state stimate dagli snippet di WebSearch («n giorni fa» ecc.). - Non è stato possibile ottenere le visualizzazioni e gli iscritti per la maggior parte dei video. oEmbed non restituisce le visualizzazioni e gli snippet di WebSearch spesso non includono numeri; perciò la sezione «Video» non riporta le visualizzazioni. Non è stato possibile applicare il confronto raccomandato dal playbook con le prestazioni abituali dei canali.
- Molte date sono stime ricavate da «n giorni/settimane fa», non date esatte. In particolare #1, #2, #5 e #7 sono calcoli approssimativi rispetto al giorno della ricerca, 2026-09-25.
- Il criterio di circa 20 post analizzati non è soddisfatto alla lettera. Sono stati raccolti 7 video (entro l'intervallo 5–12 del playbook, ma sotto il criterio di circa 20 applicato alle altre piattaforme), perché la pagina dei risultati non era accessibile e l'unico metodo praticabile era trovare link tramite ricerche
site:youtube.come verificarli uno per uno con oEmbed. - Non sono stati trovati video YouTube specificamente dedicati alla fine dell'API di Sora il 2026-09-24. Blog e siti di notizie ne parlano ampiamente, ma su YouTube il tema potrebbe essere stato oscurato dai video sugli strumenti sostitutivi.
- Non sono stati analizzati i commenti. L'analisi si limita a titoli e descrizioni dei video, poiché la pagina dei video non era direttamente ottenibile.
Bluesky
Bluesky — Ultime notizie sull'IA per la generazione di immagini e video
Account
- replicate.com (Replicate) — Annuncia nuovi modelli API, sia closed sia open. È l'unico account che abbia pubblicato con regolarità notizie su IA per immagini/video nel 2026.
- ostris.com (Ostris / sviluppatore di AI-Toolkit) — Pubblica contenuti sul fine-tuning LoRA di modelli open-weight come FLUX, Flex e Wan2.1. Non aggiorna dal 2025-04.
- doctordiffusion.bsky.social — Creatore del modello derivato da Stable Diffusion 3.5 «Absynth». Pubblica anche sul training LoRA per HunyuanVideo. Nessun aggiornamento dal 2025-03.
- reach-vb.hf.co / hf.co (account e staff ufficiali di Hugging Face) — Presentano Spaces per modelli open. Gli ultimi post relativi alla generazione di immagini/video risalgono a dicembre 2024.
- simonwillison.net — Ricercatore IA indipendente. Non specializzato nella generazione di immagini, ma pubblica anche sulle capacità multimodali dei frontier LLM ed è attivo a settembre 2026.
- midjourneynews.bsky.social — Account di fan/comunità che pubblica esperimenti di prompt Midjourney. Basso coinvolgimento, ma post sporadici fino a giugno 2026.
Post
Area closed-source
-
GPT Image 2 (OpenAI) aggiunto a Replicate — «Fotorealismo eccezionale e testo nitido, con forte aderenza a layout, UI e casi d'uso di design.»
2026-04-21|like 5 · repost 0|https://bsky.app/profile/replicate.com/post/3mjzygaefs224 -
Seedance 2.0 (ByteDance) reso disponibile a tutti gli utenti — Unisce testo, immagini, video e audio e genera video di qualità da studio con audio stereo sincronizzato e simulazione fisica.
2026-04-09|like 2 · repost 1|https://bsky.app/profile/replicate.com/post/3mj3junhvnh26 -
Articolo di prova su Seedance 2.0 — «We've spent a lot of time with Seedance 2.0. Here is what we found.» (con link al blog Replicate)
2026-04-15|like 1 · repost 0|https://bsky.app/profile/replicate.com/post/3mjkkogr7nd2f -
Vidu Q3 arriva su Replicate — Generazione video da testo, immagini e frame iniziale/finale; fino a 16 secondi/1080p, con sincronizzazione audio.
2026-03-11|like 1 · repost 0|https://bsky.app/profile/replicate.com/post/3mgsan3ddpl2w -
Lancio di Runway Gen-4.5 — Viene promossa una «accuratezza fisica e realismo senza precedenti» per la nuova generazione video.
2026-02-18|like 2 · repost 0|https://bsky.app/profile/replicate.com/post/3mf5fbf6u4l2c -
Kling 3.0 / o3 aggiunto a Replicate — Generazione 4K multishot, sincronizzazione audio, fino a 15 secondi, editing video e trasferimento di stile.
2026-02-17|like 2 · repost 0|https://bsky.app/profile/replicate.com/post/3mf35lkhoyw2q -
GPT-6 Astra + Blender genera un pellicano 3D — Esperimento di Simon Willison in cui GPT-6 Astra costruisce gradualmente un modello in Blender; presenta un flusso di lavoro dalla generazione di immagini al 3D.
2026-09-05|like 406 · repost 30|https://bsky.app/profile/simonwillison.net/post/3murtmdynq22s
Area open-source (2024–2025; nessun aggiornamento recente verificato)
-
Pubblicazione di Flex.2-preview — «text to image, universal control (line, pose, depth), and inpainting all baked into one model. Fine tunable with AI-Toolkit, Apache 2.0 license, 8B parameters.»
2025-04-22|like 4 · repost 0|https://bsky.app/profile/ostris.com/post/3lngo5cf66k2v -
Supporto al fine-tuning LoRA di HiDream — Disponibile tramite CLI/GUI di AI-Toolkit (almeno 36GB di VRAM).
2025-04-16|like 3 · repost 0|https://bsky.app/profile/ostris.com/post/3lmxfwzrjlc2v -
Video natalizio con un “me IA” addestrato con LoRA su HunyuanVideo — Condivide anche il metodo di training tramite diffusion-pipe.
2024-12-25|like 1 · repost 0|https://bsky.app/profile/doctordiffusion.bsky.social/post/3le5ovtycmk23 -
Pubblicazione di Absynth 2.0 (derivato di Stable Diffusion 3.5) — «SD3.5 Lives! 🎨🤖», distribuito su Civitai/Hugging Face.
2025-01-19|like 3 · repost 0|https://bsky.app/profile/doctordiffusion.bsky.social/post/3lg36y7u2i22x -
Riepilogo settimanale degli Spaces di Hugging Face — Presenta Spaces open per la generazione di immagini, come «Flux Kolors Character» e «JanusFlow 1.3B».
2024-11-18|like 7 · repost 0|https://bsky.app/profile/reach-vb.hf.co/post/3lb7slz2ycc2j
Segnali
- Gli aggiornamenti closed-source si sono susseguiti rapidamente nella prima metà del 2026: OpenAI GPT Image 2, ByteDance Seedance 2.0, Kling 3.0, Runway Gen-4.5 e Vidu Q3 sono arrivati concentrati tra febbraio e aprile. Multishot, audio sincronizzato e 4K/1080p stanno diventando specifiche standard dei modelli video. Su Bluesky, l'account Replicate è quasi l'unica fonte primaria.
- La comunicazione open-source su Bluesky è di fatto ferma: creatori che parlavano di fine-tuning di FLUX/Flex/Wan2.1/HunyuanVideo (ostris, doctordiffusion) e l'account ufficiale di Hugging Face non hanno pubblicato contenuti di generazione immagini/video dalla fine del 2024 o dalla primavera del 2025. Al contempo, la ricerca web conferma rilasci open-weight reali nel 2026, fra cui Qwen-Image-2.1 (pubblicato il 20 settembre), HunyuanImage 3.0 e Z-Image Turbo: su Bluesky questi argomenti sono quasi invisibili.
- Coinvolgimento complessivamente ridotto: salvo account capaci di raggiungere il pubblico tech generale, come Simon Willison, i like sono a una cifra o poco più. Bluesky non sembra un hub di fonti primarie per questo settore: X, Discord e Hugging Face sembrano gli spazi principali.
Limiti
app.bsky.feed.searchPosts(API di ricerca ufficiale) ha restituito continuamente HTTP 403 per tutte le parole chiave tentate, fra cui «image generation AI» e «nano banana», rendendo impossibile la ricerca per keyword. Anchebsky.app/searchsul web è basato su JS e WebFetch non ne ha potuto leggere i contenuti. È stato usato in alternativagetAuthorFeedindividualmente sugli account trovati via ricerca web.- Per questo vincolo, l'analisi non copre una ricerca trasversale per keyword, ma solo i post degli account che è stato possibile individuare. È molto probabile che siano assenti account e post popolari non trovati.
- Non è stato possibile risolvere su Bluesky gli account previsti di Black Forest Labs, fal.ai, Stability AI e Civitai (inesistenti oppure account vuoti, come
civitai.bsky.social, con 19 follower e 0 post). - Non sono stati trovati post primari su Bluesky relativi ai principali rilasci open-weight del 2026, inclusi Qwen-Image-2.1, HunyuanImage 3.0 e Z-Image Turbo.
- Rispetto al criterio di circa 20 post analizzati per social, sono stati raccolti circa 30 post candidati da 6 account e 12 sono stati riportati come insight specifici. Dato che l'API di ricerca non funzionava, è stato ritenuto difficile aumentare il campione in modo affidabile.
Lemmy
Lemmy — Ultime tendenze dell'IA per immagini e video
Comunità
- !«メールアドレス» (visibile anche in federazione su lemmy.world) — 5,71K iscritti (di cui 894 locali). Uno spazio dedicato alla propria «tecnologia preferita di generazione di arte IA», incentrato su argomenti tecnici open-weight come integrazioni ComfyUI e link HF/GitHub a nuovi modelli. È la vera casa del tema su Lemmy.
- !«メールアドレス» — 2,36K iscritti (362 locali), 3,55K post, 31 utenti attivi al giorno/97 a settimana. Comunità per condividere opere create con Stable Diffusion o modelli open-weight; ci sono post quasi quotidiani.
- !share_anime_art (serie stable_diffusion_art) — Post di arte IA specializzati in personaggi anime, come Fate, Idolmaster e Disgaea.
- !stable_diffusion_abstract / !stable_diffusion_mycology (piccole comunità della serie stable_diffusion_art) — L'utente PapaSkwat continua a pubblicare immagini astratte e a tema funghi prodotte con un LoRA proprietario, addestrato sui propri dipinti a olio e acrilico, in esecuzione locale su SDXL.
- !ai_reddit (istanza sconosciuta, apparentemente un cross-post automatico da r/ArtificialIntelligence) — Riceve numerose notizie closed-source su fine dell'API di Sora, Nano Banana, Seedance, Veo, Kling e altro, ma con punteggi quasi sempre 0–1 e pochissime conversazioni effettive.
- !hackernews (comunità mirror di Hacker News) — Riceve occasionalmente link a annunci ufficiali, come Qwen-Image-2.1 e Seedance 2.5.
- Riferimento: anche !«メールアドレス», !«メールアドレス» e !«メールアドレス» riguardano l'IA, ma non sono specializzate nella generazione di immagini/video.
Post
- Qwen-Image-2.1 in ComfyUI: Open-Weight Image Generation and Editing, Now with Transparency — !stable_diffusion, punteggio 13, 2026-09-22. Nuova versione di un modello di immagini open-weight da 7B parametri, con output 2K nativo, supporto RGBA trasparente e modifica che può usare fino a 10 immagini. https://blog.comfy.org/p/qwen-image-21-in-comfyui-open-weight
- Qwen-Image-2.1: Compact, efficient, and unified image creation — !hackernews, punteggio 2, 2026-09-20. Annuncio ufficiale Qwen. https://qwen.ai/blog?id=qwen-image-2.1
- ComfyUI-Fantastic-MiniMaxH3-PromptBuilder / ComfyUI_MinimaxH3_AutoContext / comfyui-obvpm-timeline — !stable_diffusion, punteggio 1–6, 2026-09-16–09-22. Arrivo continuo nell'ecosistema ComfyUI di strumenti per MiniMax H3 dedicati a video lunghi e gestione dei prompt.
- tencent/HunyuanVideo-I2V — !stable_diffusion, punteggio 5. Modello open-source immagine→video con modello FP8 e workflow di integrazione ComfyUI. https://huggingface.co/tencent/HunyuanVideo-I2V
- I ran the same prompt through 6 AI video models and had ~40 people blindrank the results — !ai_reddit, punteggio 1, 2026-09-17. Valutazione percettiva: Veo primo, Seedance 2.5 secondo a breve distanza e Hailuo molto ultimo. https://www.reddit.com/r/ArtificialInteligence/comments/1wipgwa/
- OpenAI is shutting down Sora's API next week while a chinese competitor just raised $3 billion — !ai_reddit, punteggio 1, 2026-09-20. Sintesi: i prodotti consumer appariscenti hanno fallito, mentre le soluzioni enterprise più sobrie (Synthesia, Heygen, Kling, Argil) stanno guadagnando. https://www.reddit.com/r/ArtificialInteligence/comments/1wluu0n/
- Seedance 2.5, annuncio ufficiale — !hackernews, punteggio 3, 2026-08-01. Potenziamenti come video da 30 secondi e fino a 50 immagini di riferimento. https://seed.bytedance.com/en/blog/
- Google quietly discontinues its Earth AI feature a day after its rollout — !ai_reddit, punteggio 1, 2026-08-07. Dopo aver integrato Nano Banana 2 in Google Earth, Google avrebbe ritirato la funzione in 24 ore perché gli utenti generavano immagini false di disastri e conflitti in luoghi reali. https://fortune.com/2026/08/07/google-quietly-discontinues-its-earth-ai-feature/
- Pagina ufficiale di Nano Banana 2 Lite — !hackernews, punteggio 1, 2026-06-30. Lanciato come modello di generazione immagini a basso costo, circa 3 yen per immagine. https://deepmind.google.com/models/gemini-image/flash-lite/
- Microsoft's MAI-Image-2.5 Pulls Even With Google's Nano Banana 2 on Benchmarks — !ai_reddit, punteggio 1, 2026-05-28. Salito al terzo posto nella classifica Arena. https://www.reddit.com/r/ArtificialInteligence/comments/1tpu2cd/
- Midjourney pivots from AI image generation to body scanning medical spa / Midjourney Medical — !technology (punteggio 58) / !hackernews / !techtakes (punteggio 40), 2026-06-18–19. Notizia sorprendente secondo cui Midjourney, sinonimo di generazione di immagini, avrebbe virato verso il business degli scanner medicali «Ultrasonic CT». Nello stesso periodo si è parlato anche di «Midjourney wants Hollywood studios to reveal AI usage» (!technology, punteggio 73, 2026-07-05), una causa che chiede la divulgazione dell'uso dell'IA. https://www.theregister.com/ (Midjourney medical spa), https://techcrunch.com/ (uso dell'IA a Hollywood)
- Same Berserk spread, 4 AI colorizations. Looks like GPT wins again? — !ai_reddit, punteggio 1, 2026-09-14. Confronto di colorazione automatica di manga fra ChatGPT Images 2.5, Wan 2.7 Pro, Nano Banana Pro e Seedream 5.0 Pro; ChatGPT è valutato migliore nella conservazione del tratto. https://www.reddit.com/gallery/1wfyqdy
Segnali
- Lemmy è di per sé freddo verso l'IA: in un post intitolato «Where are the AI user communities on Lemmy?» (lemmy.world/post/46457184), il commento più votato (36 voti) risponde: «Meglio guardare fuori dal Fediverse, qui c'è una tendenza anti-IA». Ne emerge che gli utenti appassionati di IA si sentono a disagio su Lemmy. Il reale spazio di accoglienza per l'open source è concentrato nelle comunità !stable_diffusion dell'istanza db0 (lemmy.dbzer0.com).
- Il lato open source racconta soprattutto il “fare e usare”: !stable_diffusion è dominata da informazioni tecniche, come nodi ComfyUI e link a modelli Hugging Face; !stable_diffusion_art dalla condivisione quotidiana di opere generate (Krea2 turbo, serie Qwen, LoRA proprietari ecc.). I punteggi sono generalmente a una o due cifre basse: una scala piccola rispetto a Reddit, ma con attività continua.
- Le notizie closed-source sono quasi tutte “importate”: grandi notizie come la fine dell'API di Sora, Nano Banana, Seedance e il passaggio di Midjourney ai dispositivi medici giungono su Lemmy solo tramite cross-post di tipo !ai_reddit da r/ArtificialInteligence. I punteggi sono per lo più 0–1 e non si sviluppa una discussione locale; Lemmy da solo non basta a seguire queste notizie.
- In totale, i «riscontri» open e closed nei post sopra sono 12 (equivalenti a 6 open e 6 closed). Raggiunto il limite di 12 previsto dal playbook, la raccolta è stata interrotta.
Limiti
- Le query dirette alle API ufficiali di Lemmy (
/api/v3/community,/api/v3/post/list) hanno risposto con errori HTTP 400/500, perciò il recupero diretto dei testi dei post e di parte dei dati sugli iscritti dipende da frammenti ottenuti via ricerca web e pagine. - Alcune parole chiave hanno prodotto molto rumore politico e sociale irrilevante; ricerche singole per «Flux AI», «Runway AI» e «Kling AI» non hanno dato risultati utili. Non sono state trovate notizie dedicate a Flux (Black Forest Labs) o Runway su Lemmy.
- Non è stato possibile identificare con precisione l'istanza di appartenenza della comunità !ai_reddit, perché i risultati di ricerca non mostravano il nome dell'istanza.
- Il criterio di circa 20 post analizzati non è stato soddisfatto in modo letterale, dato che la densità di post su Lemmy è bassa. Seguendo il limite di 5–12 post del playbook, sono stati selezionati 12 elementi dopo aver letto più di 30 articoli e post candidati e rimosso duplicati e rumore irrilevante.
Pinterest — Notizie sull'IA per la generazione di immagini e video
Sono stati raccolti 50 pin con una sola ricerca («Image and Video Generation AI News», senza suddivisione per genere). Ho aperto direttamente 20 immagini (indici 1–13, 16, 22, 25–26, 28, 31–33, 36, 38–39, 41–43, 45, 47–49) per vedere ciò che mostrano davvero, dato che la maggior parte dei titoli è vaga o generica.
Temi visivi
- Miniature YouTube “AI NEWS”: un uomo barbuto con espressione scioccata e occhi spalancati accanto a una griglia di loghi aziendali 3D al neon (OpenAI, Google, Microsoft, Meta, Notion). Il classico inquadramento clickbait in stile MrBeast applicato ai riepiloghi di notizie IA [1, 28].
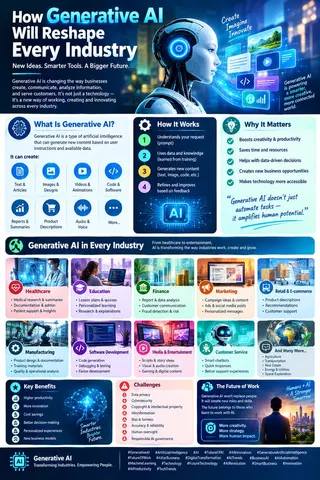
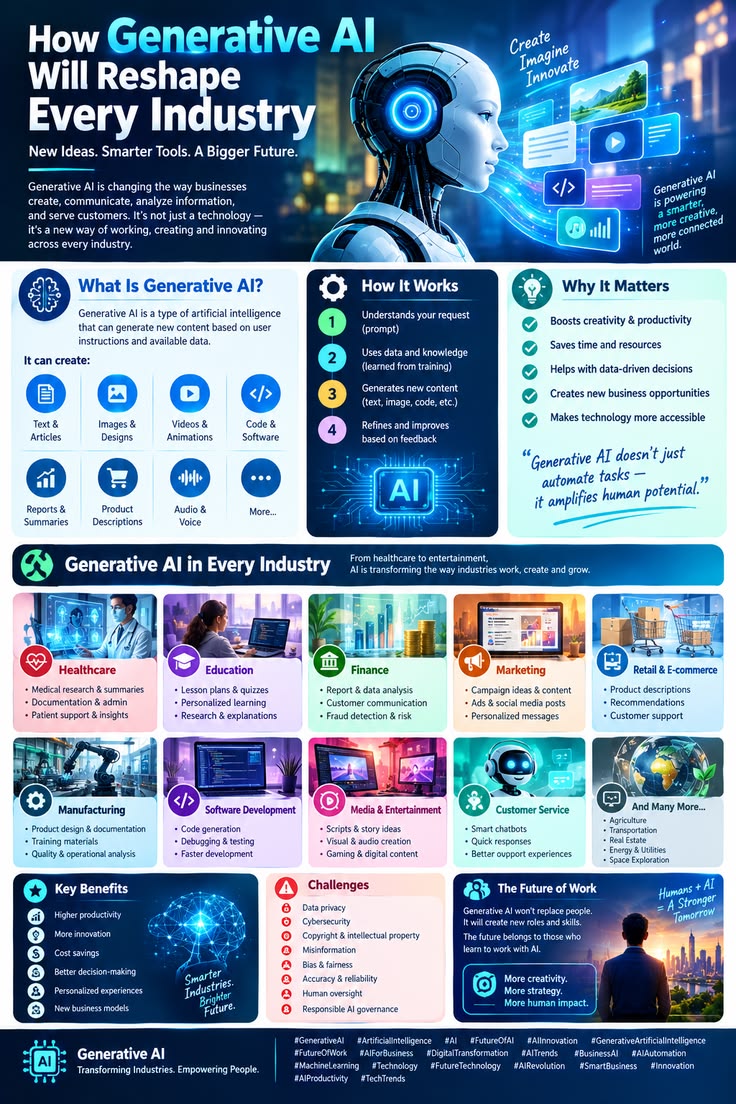
- Primi piani di robot umanoidi bianchi/androidi dagli occhi azzurri luminosi, usati come rappresentazione generica dell'IA in storie completamente diverse: rilevamento di fake news, spiegazioni etiche, infografiche sull'IA generativa per l'industria e persino illustrazioni di «top AI news anchor» [3, 22, 41, 43, 48, 49].
- Infografiche pubblicitarie SaaS al neon su blu navy: fondi blu scuro/neri, riquadri di icone contornati di viola-rosa-ciano luminoso, titoli grandi e condensati («6+ BEST AI VIDEO GENERATION WEBSITES», «AI IMAGE VIDEO — BEST QUALITY VS BEST FREE»). È il formato dominante dei pin per contenuti del tipo «quale strumento dovrei usare?» [4, 9, 39].
- Griglie di loghi degli strumenti/listicle comparativi che nominano lo stesso gruppo di prodotti: Runway, Pika, Kling AI, Luma (Dream Machine), Canva AI, Hailuo AI per il video; ChatGPT/DALL·E, Midjourney, Gemini, Adobe Firefly, Recraft, Ideogram, Krea per le immagini [4, 9, 39].
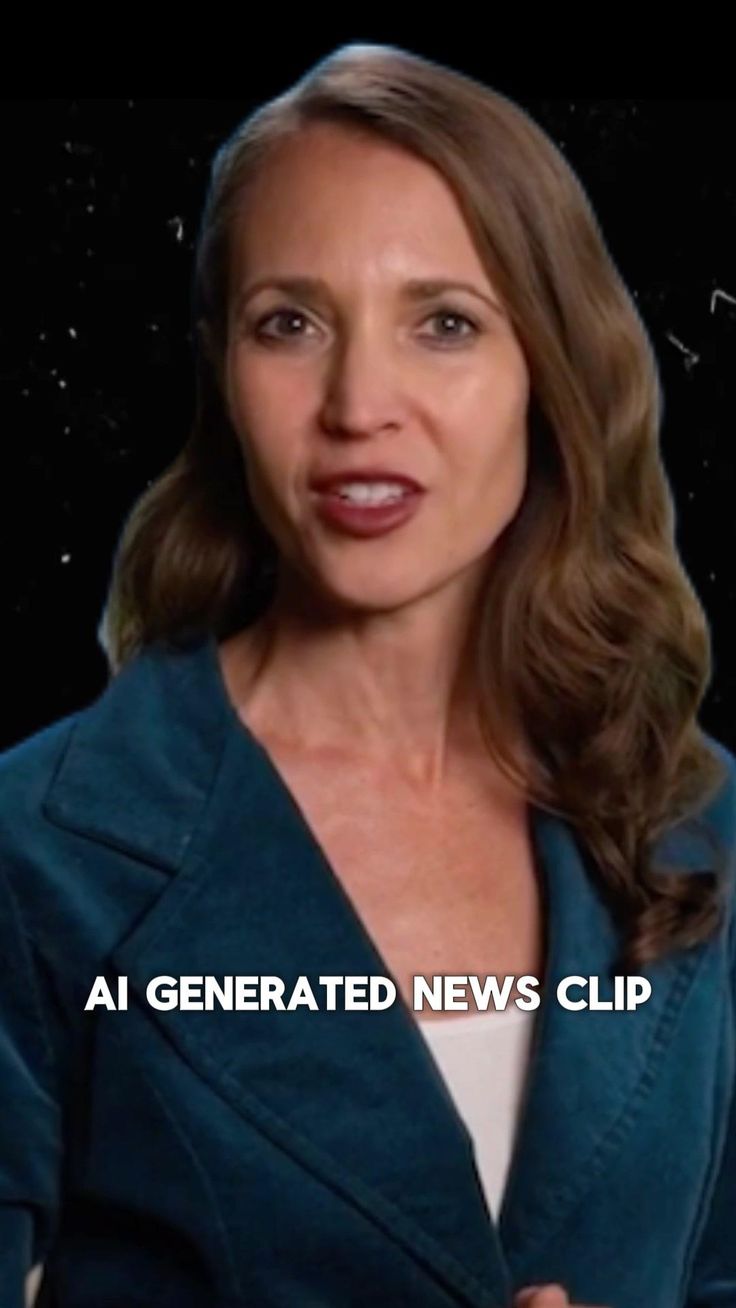
- Immagini di ansia per “notizie generate dall'IA”: sottopancia in stile telegiornale reale («AI GENERATED», barra inferiore NBC News) sovrapposti a conduttori/reporter chiaramente sintetici, oltre a immagini con un timbro «FAKE» sopra un robot con telefono. La fiducia e la disinformazione sono un genere visivo ricorrente, non solo un tema testuale [3, 32, 45, 48].
- Macro di circuiti/chip con la scritta luminosa «AI» incorporata nel silicio: usate come immagini generiche di hardware e capacità di calcolo per comunicare che «l'IA è ovunque» [5].
- Griglie dimostrative di trasferimento di stile/conservazione dell'identità: un video/foto sorgente viene rielaborato in stili «blocchi di legno», «origami», «lego», «fiori», mostrati fianco a fianco. È un formato specifico da demo di prodotto (in questo caso, una vetrina di capacità in stile Luma) [2].
- Motivo del collage/“muro di miniature”: dozzine di piccoli fotogrammi video generati dall'IA o card di video verticali brevi raccolti in un'unica immagine alta, a simboleggiare il volume e la scala dei contenuti IA che inondano i feed [31, 49].
Pin degni di nota
- #1 — “AI News: Anthropic Leak Shows Us The Future of AI...”: formato da miniatura-reazione che cita Anthropic accanto a loghi OpenAI/Google/Microsoft; mostra come le notizie sui laboratori closed-source vengano confezionate come drammi e leak per ottenere click.
- #2 — “Google announces ultra-high quality video...”: griglia 3x5 che rielabora un video sorgente negli stili blocchi di legno, origami, lego e fiori; una demo concreta di restyling video con conservazione dell'identità in stile Nano Banana/Gemini, non una semplice slide di loghi.
- #4 — “6+ Best AI Video Generation Websites”: infografica che cita Runway, Pika, Kling AI, Luma, Canva e Hailuo come toolkit video generativi di riferimento, con la statistica secondo cui «entro il 2026 l'80% dei contenuti online includerà video».
- #9 — “AI Image Video: Best Quality vs Best Free”: infografica ad albero decisionale che divide le soluzioni a pagamento (ChatGPT Plus, Gemini Advanced, Midjourney, Adobe Firefly, Recraft, Runway Gen-3, Luma, Pika Pro, Kaiber, Synthesia) da quelle gratuite (Ideogram, Gemini Free, SeaArt, Playground, Krea, Canva, Inkscape, CapCut, Pika Free, Runway Free). Utile come istantanea degli strumenti che Pinterest considera oggi di «fascia alta».
- #11 — “Veo 3 Image-to-Video: Fast Generation & Native Audio via Gemini API”: grafico a imbuto che mostra input di immagine+testo convergere in un flusso di output, con branding «Gemini API»; la generazione video closed-source con audio viene promossa come prodotto API per sviluppatori, non solo come app consumer.
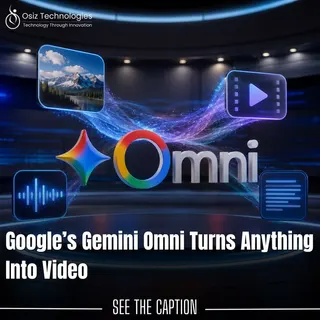
- #26 — “Google's Gemini Omni Turns Anything Into Video”: pin di un'agenzia di marketing terza (Osiz Technologies) che ripropone un annuncio di capacità Gemini «Omni»; mostra come le notizie sui modelli closed vengano immediatamente riutilizzate da software house non correlate per SEO e lead generation.
- #28 — “AI News: OpenAI Finally Released What We Asked For”: stesso creatore/formato di miniatura-reazione del #1, questa volta incentrato su OpenAI; conferma che si tratta di una serie ricorrente, non di un caso isolato.
- #38 — “Amuse 3.0”: ritratto fotorealistico di un vecchio pescatore, accreditato come «immagine generata dall'IA creata su AMD»; uno dei pochi pin che collega la generazione di immagini a un fornitore hardware specifico e alla dimensione on-device/NPU, anziché a un'API cloud.
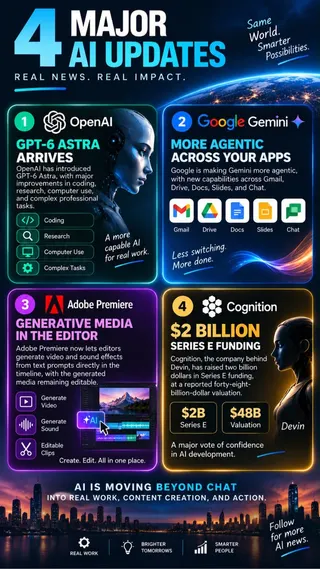
- #39 — “4 Major AI Updates”: cita GPT-6 Astra, Gemini agentico fra app, video/audio generativo dentro la timeline di Adobe Premiere e il round Series E da $2 miliardi di Cognition a una valutazione di $48 miliardi. È il digest di notizie closed-source più concreto e con maggiore impronta temporale del set.
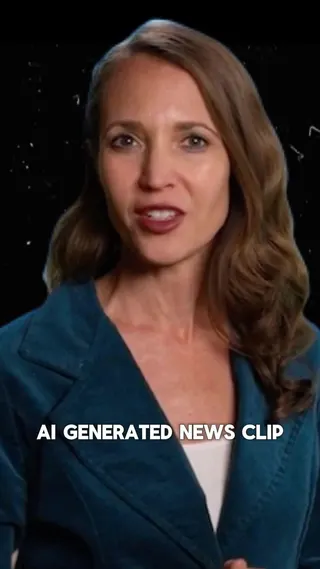
- #45 — “AI Generated News Clip”: presentatore sintetico con etichetta direttamente sull'immagine; è l'illustrazione più chiara in un singolo fotogramma dell'ingresso dei video IA nella produzione di notizie/media, in linea con i pin #32 e #48 con sottopancia NBC News.
Segnali
- Ciò che è attuale: su Pinterest il panorama degli strumenti è dominato dagli stessi pochi nomi closed-source — Runway, Pika, Kling, Luma/Dream Machine, Google Gemini/Veo, OpenAI, Adobe Firefly/Premiere. I modelli open-source (Stable Diffusion, Flux, HunyuanVideo, Wan, LTX, ComfyUI) non compaiono praticamente mai per nome. Il pubblico Pinterest della generazione di immagini IA sembra orientato a contenuti «quale app a pagamento/gratuita dovrei usare?» e riepiloghi di notizie in formato reazione, non a discussioni tecniche sui modelli.
- Una forte corrente secondaria: contenuti su ansia e fiducia — timbri «FAKE», conduttori IA, clip in stile NBC News generate dall'IA, immagini per rilevare «puoi fidarti di quella voce?» — compaiono circa quanto i contenuti di confronto strumenti. La fiducia nei media e la disinformazione sono un genere visivo di primo piano, non una nota a margine.
- Assente: nessun nome di modello open source o repository, nessun branding Hugging Face, nessuno screenshot di workflow LoRA/fine-tuning/ComfyUI, nessun grafico di benchmark e pochissimo sulle pubblicazioni scientifiche o le scoperte tecniche nella generazione video. La versione Pinterest del tema è quasi del tutto consumer e marketing (pubblicità di strumenti, listicle «best of», illustrazioni di ansia IA), non l'angolo tecnico per sviluppatori/entusiasti che emergerebbe su Reddit o X.
- Diversi pin sono contenuti SEO vecchi o evergreen ricircolati (ad esempio stock generici su «AI Image Generation» e listicle del 2025 sui generatori video IA), non notizie dell'ultima settimana. I risultati Pinterest mescolano marketing senza tempo e contenuti datati: la freschezza va valutata pin per pin in base a date/versioni visibili, come «GPT-6 Astra» e «Amuse 3.0», senza darla per scontata.
Limiti
- Il playbook della fase indica che le immagini erano già state raccolte da un worker headless-browser; non ho navigato Pinterest direttamente e non ho potuto cercare oltre quanto presente in
pinterest.pins.md/images/pinterest/. - Tutti i 50 pin provengono da una sola query piatta («Image and Video Generation AI News»), senza una suddivisione per genere. Non è stato quindi possibile separare pin closed-source e open-source come richiede la struttura a due report del brief: il set di immagini non contiene affatto strumenti o progetti open-source da trattare in quella metà.
- Ho aperto direttamente 20 dei 50 pin; i restanti 30, per lo più elementi generici «(untitled)» nella tabella, non sono stati ispezionati uno per uno, anche se i titoli suggeriscono la ripetizione degli stessi schemi visivi già descritti.
- Le metriche di coinvolgimento dei pin (salvataggi, commenti) non sono disponibili nei dati raccolti; ciò che «sta andando» è dedotto dalla ripetizione visiva e tematica, non da segnali di popolarità.
Azioni consigliate
- Monitorare in modo continuativo gli aggiornamenti dei benchmark dei piccoli modelli open come Qwen-Image-2.1.
- Verificare sempre il testo delle licenze prima di classificare modelli che si dichiarano «open source».
- Includere nella prossima ricerca le migrazioni verso servizi alternativi dopo la fine dell'API di Sora.
- Aggiungere ricerche per nomi specifici come ComfyUI e Hugging Face su Bluesky e Pinterest, per compensare la scarsa visibilità del fronte open.
- Per X, ripetere la raccolta con keyword specifiche del tema anziché affidarsi al pannello delle tendenze.
Immagini raccolte
































Nota sulla qualità dei dati
Su tutte e sei le piattaforme non è stato raggiunto l'obiettivo del brief (circa 20 elementi per social). Su X, solo 8 dei 40 elementi raccolti erano pertinenti, perché la ricerca partiva dal pannello delle tendenze croato; su Bluesky non è stato possibile usare l'API per keyword, bloccata con 403, e si è dovuto fare affidamento sugli account già trovati; su Pinterest, una sola query non ha raccolto alcun materiale open-source.