Notizie sull'IA per la generazione di immagini e video — 2026-09-23
L'IA closed-source per immagini/video sta subendo una forte ritirata (l'API di Sora 2 chiude il 2026-09-24, Midjourney vira ai dispositivi medici, polemiche sui prezzi di Grok Imagine/Seedance), mentre gli strumenti open-source costruiti attorno a ComfyUI (Wan, HunyuanVideo, FLUX.2, Qwen-Image, MiniMax H3) stanno silenziosamente diventando lo standard per il lavoro di produzione reale.
Il fronte più caldo tra IA open e closed source per immagini e video — 2026-09-23
Ho dato un'occhiata e siamo davvero in una fase interessantissima 🔥 Mentre le realtà closed-source (Sora 2, Midjourney, Grok Imagine e simili) fanno annunci appariscenti, dietro le quinte stanno ritirando prodotti, alzando prezzi e cambiando direzione a ritmo serrato: onestamente iniziano a sembrare instabili 😳 Dall'altra parte, i progetti open-source (Wan, FLUX.2, Qwen-Image, HunyuanVideo) si stanno raccogliendo attorno al nodo centrale di ComfyUI e, senza troppo clamore, stanno entrando sul serio nei flussi di produzione 💪 Guardando Reddit, X, YouTube, Bluesky, Lemmy e Pinterest, emerge chiaramente questo schema: «notizie spettacolari = closed source», «uso pratico costante = open source». Inoltre, cresce fortemente la richiesta di obbligare a segnalare chiaramente i contenuti generati dall'IA 📢
Tra le piattaforme
- Il rallentamento e il cambio di direzione del closed source sono visibili su più piattaforme. Su YouTube è stato riportato che Sora 2 chiuderà l'app dopo appena sei mesi (2026-04-26) e terminerà anche l'API il giorno successivo alla ricerca, il 2026-09-24; a fronte di costi operativi di circa 1 milione di dollari al giorno, i ricavi complessivi dagli abbonamenti sarebbero stati solo di 2,1 milioni di dollari (https://www.youtube.com/watch?v=bIL7uU4CYnE). La stessa notizia sulla chiusura dell'API di Sora è stata condivisa anche su Lemmy attraverso un mirror di r/ArtificialInteligence (https://www.reddit.com/r/ArtificialInteligence/comments/1wluu0n/), in contrasto con i 3 miliardi di dollari raccolti dalla cinese Kuaishou (Kling): il tono era chiaramente «sono le applicazioni enterprise meno vistose a fare soldi».
- L'open source compare ovunque come “infrastruttura operativa” basata su ComfyUI. Reddit cita ComfyUI + FramePack per generare video persino su PC poco potenti; Lemmy ha visto due estensioni ComfyUI per MiniMax H3 nell'ultima settimana; YouTube è pieno di tutorial per eseguire Wan/HunyuanVideo/LTX in locale. Su tre piattaforme diverse, ComfyUI e l'ecosistema Wan sono emersi indipendentemente come parole chiave.
- Il malcontento per l'eccessiva monetizzazione è rivolto ai servizi closed-source. Su Reddit sono comparsi tre thread alla ricerca di generatori video gratuiti, soprattutto per la riduzione delle quote gratuite; su Bluesky un'artista di Tokyo ha definito ripetutamente “devastating” il costo di Seedance 2.5 (https://bsky.app/profile/metalmickey.bsky.social/post/3mu25rbs4dk2e).
- Dal lato degli utenti emerge stanchezza da confronto: “quale strumento dovrei usare?”. Su YouTube sono ormai un formato fisso i confronti come Sora 2 vs Seedance 2.0 vs Runway, mentre Pinterest ha fatto circolare molto matrici decisionali “Best Quality vs Best Free” (YouTube: https://www.youtube.com/watch?v=rb0p_mY3tPs / Pinterest #10). Cresce il pubblico che non cerca fedeltà a un singolo modello, ma vuole sapere quale sia attualmente il più forte.
- La diffidenza verso i contenuti IA e la richiesta di obblighi di etichettatura sono comuni a più piattaforme. Su Reddit un thread di proposta legislativa ha raccolto 13.841 commenti, di gran lunga il maggior volume di discussione dell'intera raccolta (https://www.reddit.com/r/CriticalState/comments/1wmktek/). Su Pinterest, immagini con timbri “FAKE” e badge di rilevamento IA sono ormai un genere a sé.
Per piattaforma
Reddit — Dei 12 thread raccolti, solo 4 provengono da comunità specializzate in IA per immagini e video; gli altri sono thread di subreddit generici del tipo “ho trovato contenuti generati dall'IA e mi irritano”. Mentre torna ripetutamente la domanda di video generativi gratuiti e locali, DeepSeek (open-weight) mostra anche un raro caso in cui l'open source rischia di soffrire del proprio successo: la crescita degli utenti (DAU da 120 a 200 milioni) ha superato il potenziamento del calcolo, causando un peggioramento della qualità (https://www.reddit.com/r/DeepSeek/comments/1wmcgex/).
X — Soprattutto tra gli account giapponesi, si è vista una vera ondata di demo di “generazione in un colpo solo” con Claude Opus 5.5 e Grok 4.7. @cherry_mx_reds, @NFT_Chen, @riku720720 e @chetaslua hanno pubblicato demo diverse quasi nello stesso periodo, tra il 21 e il 22 settembre: sembra una verifica collettiva subito dopo il rilascio. Sul lato open, sviluppatori indipendenti come @shinshin86 e @GeekCatX hanno messo in evidenza il numero di stelle GitHub. Il limite è che più di 20 dei 40 contenuti raccolti erano rumore fuori tema, derivato dalle parole chiave di tendenza specifiche di X.
YouTube — È stata la fonte più ricca di informazioni. Il massimo tema è stato l'ascesa e caduta di Sora 2, dall'annuncio trionfale al ritiro in sei mesi; prosegue inoltre la competizione di aggiornamenti di Nano Banana 2, GPT Image 2.5 e della serie Midjourney V8. Sul fronte open, Alibaba (Wan), Tencent (HunyuanVideo), Black Forest Labs (FLUX) e Lightricks (LTX) sono i protagonisti principali, mentre ComfyUI si è consolidato come il “quadro di cablaggio” su cui continuano ad arrivare nuovi nodi.
Bluesky — Non esiste un hub forte dedicato all'IA per immagini e video; gli account ufficiali di Stability AI, Midjourney e Runway sono quasi inattivi. L'unico aggiornamento costante è arrivato da @ethanhe, interno a xAI. Tuttavia, l'API di ricerca full-text ha restituito 403 per tutta la durata dell'indagine, costringendo a seguire solo account già noti.
Lemmy — È piccolo — anche la comunità principale ha soltanto 5.713 iscritti — ma i post attorno a ComfyUI in !«メールアドレス» hanno un'alta densità informativa. Sul lato closed sono risaltate notizie di “ritiro e cambio di rotta” — fine dell'API Sora, svolta di Midjourney verso i dispositivi medici, ritiro immediato di Earth AI di Google — più che lanci appariscenti.
Pinterest — Più che articoli di notizie, predominano immagini in stile miniatura “AI NEWS”, grafici comparativi e visual dedicati agli avvertimenti sui deepfake. Dell'open source si trova quasi solo “Amuse 3.0” di AMD. Al contrario, l'incertezza dei consumatori su quale strumento scegliere e la cautela verso i contenuti generati dall'IA emergono con forza come generi visivi.
Punti da seguire
- Fine dell'API di Sora 2 (2026-09-24) — YouTube: https://www.youtube.com/watch?v=bIL7uU4CYnE
- Forte crescita dei DAU di DeepSeek e degrado qualitativo per carenza di calcolo — Reddit: https://www.reddit.com/r/DeepSeek/comments/1wmcgex/
- Proposta di legge per rendere obbligatoria l'etichettatura dei contenuti IA (13.841 commenti) — Reddit: https://www.reddit.com/r/CriticalState/comments/1wmktek/
- Continuano ad apparire estensioni ComfyUI + MiniMax H3 per la generazione di video lunghi — Lemmy: https://github.com/supElement/ComfyUI_MinimaxH3_AutoContext
- Grok 4.7 genera automaticamente una scena 3D in Blender (410.000 visualizzazioni) — X: https://x.com/cherry_mx_reds/status/2102098340699668865
- Midjourney passa dalla generazione di immagini ai dispositivi medici, inclusi scanner CT a ultrasuoni — Lemmy: https://www.theregister.com/ai-and-ml/2026/06/18/midjourney-pivots-to-medical-devices/
Azioni consigliate
- Mentre aumenti di prezzo e ritiri continuano tra gli strumenti closed, monitorare con continuità lo stack OSS Wan, HunyuanVideo, FLUX.2 e ComfyUI + MiniMax H3 come principale alternativa pratica.
- Anticipare il clima favorevole agli obblighi di etichettatura dei contenuti IA, sempre più evidente su Reddit e Pinterest, preparando una policy per indicarne provenienza e attribuzione.
- Dopo la chiusura dell'API di Sora 2 il 24 settembre, seguire dove migreranno gli utenti: Kling, Seedance e Runway sono i probabili beneficiari.
- Considerare l'ondata di demo one-shot di Opus 5.5/Grok 4.7 su X come hype di breve durata legato alla finestra di rilascio, senza sopravvalutarne la minaccia alla quota di attenzione dell'OSS.
- Osservare i limiti infrastrutturali proprietari che emergono quando un modello open-weight diventa rapidamente popolare, come nel caso DeepSeek, come indicatore anticipatore di vincoli d'offerta.
- Per rispondere alla stanchezza da confronto evidente su YouTube e Pinterest, privilegiare contenuti comparativi rispetto a notizie su un singolo prodotto.
Qualità dei dati
Solo YouTube e Pinterest hanno raggiunto più o meno il criterio di completamento di circa 20 elementi analizzati per social; gli altri presentano lacune. Reddit si è fermato a 12 thread, di cui appena 4 da subreddit specializzati. X ha raccolto 40 post, ma più della metà era rumore dovuto a parole chiave di tendenza non pertinenti; i post davvero centrati sul tema erano circa 11. Su Bluesky, l'API di ricerca full-text ha restituito 403 per tutta la durata dell'indagine e sono stati raccolti soltanto 10 elementi seguendo account conosciuti. Lemmy è intrinsecamente troppo piccolo — la comunità principale ha 5.713 membri — per arrivare a 20 post, e circa metà dei contenuti sono mirror di Reddit. Di 50 pin Pinterest, solo 26 sono stati verificati visivamente; inoltre non è stato possibile ottenere metriche di engagement come il numero di like.
Riepilogo per piattaforma
Reddit — Notizie sull'IA per immagini e video
Dove (subreddit)
I 12 thread raccolti sono distribuiti in 10 subreddit. Le comunità specializzate in IA per immagini e video sono poche; gli altri sono thread di subreddit generici che citano o contestano contenuti IA.
| Subreddit | Membri | Thread raccolti |
|---|---|---|
| r/generativeAI | 156,181 | 3 |
| r/mildlyinfuriating | 12,586,808 | 1 |
| r/aivideomaking | 7,498 | 1 |
| r/CriticalState | 39,096 | 1 |
| r/Instagramreality | 1,155,566 | 1 |
| r/Purdue | 100,731 | 1 |
| r/DeepSeek | 140,681 | 1 |
| r/ImagineAiArt | 19,446 | 1 |
| r/youngpeopletiktoks | 8,226 | 1 |
| r/youtube | 3,459,719 | 1 |
Solo r/generativeAI, r/aivideomaking, r/DeepSeek e r/ImagineAiArt sono comunità specializzate in IA generativa (4 thread). Gli altri 8 thread provengono da subreddit generici, nel contesto “ho trovato contenuti IA e mi ha dato fastidio”.
Reazioni della comunità
- La ricerca di generatori video IA gratuiti ricorre in tre thread distinti (thread #2 “Which AI video generator can still be used for free?” r/generativeAI, 20pt, 73 commenti, 2026-09-16 / thread #3 “Looking for a free AI video generator” r/aivideomaking, 7pt, 28 commenti, 2026-09-20 / thread #10, stesso titolo, r/generativeAI, 4pt, 28 commenti, 2026-09-20). Con le opzioni closed-source sempre più a pagamento, u/RioMetal (+4) ha consigliato l'open source: «se puoi eseguirli in locale, Wan e Minimax non mancano».
https://www.reddit.com/r/generativeAI/comments/1whtesl/ - Malcontento perché “tutto ciò che l'IA consiglia è diventato a pagamento” (testo del thread #2): una reazione tipica al ridimensionamento delle quote gratuite dei servizi closed-source.
https://www.reddit.com/r/generativeAI/comments/1whtesl/ - Soluzioni pratiche per l'uso locale e open source: u/AztecWheels (+2, thread #3) spiega che installando FramePack via Pinokio, anche un PC poco potente può fare conversione immagine→video, senza audio, da 1 a 120 secondi. La combinazione ComfyUI + FramePack è citata come riferimento per la generazione video open source su hardware modesto.
https://www.reddit.com/r/aivideomaking/comments/1wled0f/ - Reazione contraria al “datelo gratis”: u/activematrix99 (+2, thread #3) lo paragona al pretendere un pasto gratuito al ristorante, ricordando che le aziende hanno investito miliardi in questa tecnologia. La comunità è quindi divisa.
https://www.reddit.com/r/aivideomaking/comments/1wled0f/ - Crescita rapida di DeepSeek (open-weight) e carenza di calcolo: il thread #7 “some deepseek news, if you care” (r/DeepSeek, 292pt, 45 commenti, 2026-09-21) riporta DAU passati da 120 a 200 milioni (+66,7%), mentre la capacità di calcolo sarebbe aumentata solo dell'8,3%, causando peggioramenti qualitativi e problemi nelle rigenerazioni. Come risposta, sarebbe stato ordinato un lotto di 160.000 Ascend 960DT di Huawei. u/Equivalent-Grass-527 (+13) ritiene che lo squilibrio tra domanda e risorse di calcolo spieghi meglio il degrado recente.
https://www.reddit.com/r/DeepSeek/comments/1wmcgex/ - Discussione GPT Image 2.5 Flare (closed) vs KREA 2 (open): thread #9 “GPT Image 2.5 Flare — is this actually the best AI image generating model right now?” (r/ImagineAiArt, 93pt, 62 commenti, 2026-09-16). u/Dependent_Quit_3730 (+3, in portoghese) lo considera perfetto per chi vuole semplicità, ma continua a usare KREA 2; u/SeaworthinessFresh16 (+2) sostiene che i risultati di ComfyUI + Krea2 sembrino uguali. Per alcuni, quindi, il divario pratico con i modelli open è minimo nonostante il clamore del nuovo modello closed.
https://www.reddit.com/r/ImagineAiArt/comments/1wi79wi/ - Forte reazione contro foto immobiliari generate dall'IA: thread #1 “It should be illegal to post AI-generated "inspirational" images in house listing photos.” (r/mildlyinfuriating, 25.962pt, 706 commenti, 2026-09-21; il punteggio più alto della raccolta). u/BojackWorseman13 (+1.128) ritiene che gli agenti immobiliari debbano ricevere molte lamentele sui social e che, anche se non illegali, le immagini IA debbano essere chiaramente dichiarate.
https://www.reddit.com/r/mildlyinfuriating/comments/1wmja6n/ - Proposta di legge per l'obbligo di watermark sui contenuti IA: thread #4 “[Law Proposal] Every ai generated image and text must need to have watermark.” (r/CriticalState, 1.246pt, 13.841 commenti, 2026-09-21; il maggior numero di commenti della raccolta). I commenti principali sono nettamente favorevoli; u/Timedforfun (+16) afferma che non sia qualcosa da nascondere e invita a votare a favore.
https://www.reddit.com/r/CriticalState/comments/1wmktek/ - Immagini IA indistinguibili per il pubblico diventano virali: thread #5 “AI generated images on Reddit with thousands of upvotes and comments” (r/Instagramreality, 2.148pt, 343 commenti, 2026-09-18). u/Habibti-Mimi81 (+146) dice di non essersene accorto e indica come unico indizio l'angolo delle piastrelle grigie, definendola un'epoca triste e pericolosa.
https://www.reddit.com/r/Instagramreality/comments/1wk0euk/ - Persino gli avvisi ufficiali universitari usano immagini IA, definite “slop”: thread #6 “AI generated image on MSEE wall” (r/Purdue, 139pt, 19 commenti, 2026-09-21). Il post chiede se non si potesse assumere un graphic designer e lamenta l'impossibilità di sfuggire allo “slop” IA.
https://www.reddit.com/r/Purdue/comments/1wmq43f/ - Contenuti video generati con Sora e simili arrivano nei subreddit di repost TikTok: thread #11 “another ai generated grounded video” (r/youngpeopletiktoks, 81pt, 35 commenti, 2026-09-19). u/Pretend-Goat-8065 (+5) commenta semplicemente “Another Sora ai”, nominando direttamente il prodotto closed-source.
https://www.reddit.com/r/youngpeopletiktoks/comments/1wkjvor/ - Reazione negativa ai capitoli IA automatici di YouTube: thread #12 (r/youtube, 3pt, 22 commenti, 2026-09-17). u/avatar0027 (+2) segnala che i capitoli generati automaticamente dalle trascrizioni vengono mostrati con maggiore aggressività e che gli spettatori non hanno un'opzione per disattivarli globalmente; soltanto i creator possono spegnerli uno per uno. Non riguarda direttamente la generazione video, ma è un ulteriore segnale di stanchezza verso l'espansione delle funzioni IA.
https://www.reddit.com/r/youtube/comments/1wiqamq/
Segnali
- In crescita: la domanda di generazione video gratuita e locale — Wan 2.2, Minimax H3, ComfyUI + FramePack — ricorre in tre thread indipendenti. L'aumento dei prezzi e la monetizzazione degli strumenti closed-source alimentano l'interesse verso l'open source.
- In crescita: l'opinione pubblica che chiede un obbligo di indicare che un contenuto è generato dall'IA; il thread #4, con 13.841 commenti, è la discussione più ampia dell'intera raccolta. Su Reddit nel complesso, regolamentazione e trasparenza ottengono molto più coinvolgimento della gara sulle prestazioni dei modelli.
- Spesso trascurato: esiste una reazione contraria alla richiesta di avere tutto gratis, espressa ad esempio da u/activematrix99. La comunità non considera affatto scontato l'accesso gratuito.
- Aspetto sorprendente: DeepSeek, open-weight, soffrirebbe di degrado qualitativo per la rapidissima crescita degli utenti e la scarsità di calcolo. Non è il consueto confronto open contro closed, ma un nuovo vincolo d'offerta: un modello open diventa così popolare che la propria infrastruttura non riesce a stargli dietro.
- Divergenza di opinioni: nel thread #9 i commenti che confrontano GPT Image 2.5 Flare con KREA 2 si dividono; più persone sostengono che il closed abbia più risonanza, ma non un vantaggio percepibile nell'uso reale.
Limiti
- Il criterio del brief richiedeva l'analisi di circa 20 post per social, ma in reddit.threads.md/.json erano stati raccolti solo 12 thread usando un'unica query, “Image and Video Generation AI News”. Poiché l'approccio era leggere dati già raccolti, non sono state eseguite ricerche aggiuntive.
- Dei 12 elementi, solo 4 provengono da comunità specializzate — r/generativeAI, r/aivideomaking, r/DeepSeek e r/ImagineAiArt. Gli altri 8 sono thread derivati di subreddit generici; quasi nessuno tratta come tema principale notizie su nuovi prodotti o aggiornamenti closed/open.
- I principali subreddit specializzati, inclusi r/StableDiffusion, r/midjourney, r/runwayml e r/aivideo, non compaiono nemmeno una volta nel set raccolto.
- Il testo del post del thread #9, relativo a GPT Image 2.5 Flare, si interrompe a metà del prompt; non è stato possibile verificare il seguito né l'immagine allegata.
- Per il vincolo di non poter navigare Reddit direttamente, la ricerca non ha approfondito oltre questi 12 thread, con altre query o thread aggiuntivi.
X
X — Notizie sull'IA per immagini e video
Su X (Twitter), soprattutto tra account giapponesi, sono in fermento le demo video e di animazione create con “Claude Opus 5.5” e “Grok 4.7”; tuttavia, più della metà dei 40 contenuti raccolti era rumore non correlato al tema (vedere Limits).
Account
- @cherry_mx_reds(Tak) — L'account più rilevante della raccolta. Ha pubblicato una demo dell'animazione “Oktoberfest” generata in un colpo solo da Opus 5.5 (373 like) e una di Grok 4.7 che crea una scena 3D in Blender (1.636 like, circa 410.000 visualizzazioni). Verifica demo di due modelli diversi con un approccio comparativo.
- @NFT_Chen(SuSu_酥酥) — Ha pubblicato una demo in cui Opus 5.5 usa codice per creare un'animazione stop-motion dall'aspetto disegnato a mano (151 like, circa 40.000 visualizzazioni). Un singolo post, ma molto condiviso e con spiegazione dettagliata.
- @chetaslua — Un caso di generazione video interattiva con Opus 5.5, usando solo JavaScript e senza asset, MCP o skill (435 like): una demo più orientata all'implementazione tecnica.
- @riku720720(Rikuo) — Una pubblicazione sull'animazione pixel art generata con Opus 5.5 (173 like), con prompt condiviso nelle risposte.
- @old_pgmrs_will(gestore di NeuralWire.org) — Due post su Grok 4.7: uno su una app di fotoritocco autogenerata con demo automatica (8 like), l'altro in risposta alle critiche al modello con un aggiornamento sui miglioramenti UI di un'app di editing video (8 like). Portata ridotta, ma pubblicazione continua come account di notizie IA.
- @shinshin86(sviluppatore di AITuber OnAir) — Ha segnalato che lo strumento open-source “Still2Rig PSD”, per separare automaticamente un'immagine in livelli PSD, ha superato 60 stelle GitHub (586 like, circa 28.000 visualizzazioni).
- @ishitaku39(いしたく) — Ha presentato “ARDY Mini”, derivato alleggerito da uno sviluppatore indipendente affinché il modello di ricerca NVIDIA “ARDY” funzioni nel browser (226 like).
- @GeekCatX(知识猫AI实验室) — Ha segnalato che l'open-source “Hand-drawn Video Skill”, da storia a video disegnato a mano, ha superato 2.000 stelle GitHub (103 like), condividendo anche gli aggiornamenti dopo un mese.
- @so_ainsight — Riepilogo settimanale di repository IA GitHub in rapida crescita (573 like, circa 49.000 visualizzazioni). Non è limitato a immagini e video, ma fornisce contesto sulla vitalità dell'OSS IA.
Post
Closed source(Opus 5.5 / Grok 4.7)
-
#1 @riku720720 — 173 like, 19 repost, 1 risposta, circa 19.000 visualizzazioni, 2026-09-22. https://x.com/riku720720/status/2102515055116063144
Opus 5.5 è davvero assurdo... ha prodotto questa animazione pixel art in meno di cinque minuti.
Il fulcro del post è la sorpresa per la velocità: un'animazione pixel art generata in meno di cinque minuti. -
#2 @NFT_Chen — 151 like, 20 repost, 13 risposte, circa 40.000 visualizzazioni, 2026-09-22. https://x.com/NFT_Chen/status/2102455102896509431
This isn't drawn by a human! Claude Opus 5.5 used code to hand-draw this animation frame by frame. ... 32 seconds, all generated by AI.
Il punto sorprendente è proprio il metodo: stop-motion dall'aspetto disegnato a mano, generato tramite codice. -
#3 @cherry_mx_reds — 373 like, 17 repost, 10 risposte, circa 36.000 visualizzazioni, 2026-09-21. https://x.com/cherry_mx_reds/status/2102493303388475855
Opus 5.5 one-shot this animation in 14m and 48s "Oktoberfest" by Opus 5.5
Enfatizza la generazione in un colpo solo e indica il tempo preciso: 14 minuti e 48 secondi. -
#4 @chetaslua — 435 like, 23 repost, 10 risposte, circa 20.000 visualizzazioni, 2026-09-22. https://x.com/chetaslua/status/2102501773705670994
Interactive video gen in whatever art style you want by @claudeai Opus 5.5 coded no assets, mcp, skill, only js
Demo tecnica che sottolinea la leggerezza dell'implementazione: video interattivo, senza asset, MCP o skill, solo JavaScript. -
#17 @AbhinavXJ — 57 like, 2 repost, 2 risposte, circa 3.200 visualizzazioni, 2026-09-22. https://x.com/AbhinavXJ/status/2102473742723260606
they said pace the frontier and now we have Grok 4.7 Claude Opus 5.5 GPT-6 sol and luna in span of 2 days
Non parla di un singolo modello, ma della velocità dei rilasci: diversi modelli di primo piano in soli due giorni. -
#19 @cherry_mx_reds — 1.636 like, 215 repost, 127 risposte, circa 410.000 visualizzazioni, 2026-09-21. https://x.com/cherry_mx_reds/status/2102098340699668865
Grok 4.7 made this in blender. I didn't tell it what to make but only that it should be something it can accomplish in 10 minutes or so.
La demo più coinvolgente della raccolta, notevole perché entra nella generazione 3D in Blender. -
#18 @old_pgmrs_will — 8 like, 0 repost, 0 risposte, circa 611 visualizzazioni, 2026-09-21. https://x.com/old_pgmrs_will/status/2102182047989338264
Ho fatto generare a Grok 4.7 un'app di fotoritocco per uso personale e le ho fatto implementare anche una demo automatica delle operazioni.
Un caso d'uso pratico: app personale generata dall'IA, con funzione di dimostrazione automatica. -
#20 @old_pgmrs_will — 8 like, 0 repost, 0 risposte, circa 599 visualizzazioni, 2026-09-22. https://x.com/old_pgmrs_will/status/2102376309020299517
Vedo soprattutto all'estero post del tipo “Grok-4.7 non serve a nulla”, ma o sono hater o non sanno usarlo.
Esistono pareri negativi su Grok 4.7; l'autore replica però che il modello gli sta facendo progredire rapidamente l'UI/UX della sua app di editing video, mostrando una valutazione divisa.
Open source
-
#33 @shinshin86 — 586 like, 59 repost, 2 risposte, circa 28.000 visualizzazioni, 2026-09-21. https://x.com/shinshin86/status/2102163713679577301
Lo strumento IA “Still2Rig PSD”, che crea PSD da immagini statiche, ha superato 60 stelle GitHub... affidandolo a un agente IA come Codex insieme a un'immagine, può eseguire See-through su Google Colab, separare i livelli e assemblare il PSD.
Uno strumento OSS indipendente supera 60 stelle GitHub; il suo elemento distintivo è l'integrazione con agenti IA. -
#34 @ishitaku39 — 226 like, 22 repost, 3 risposte, circa 9.800 visualizzazioni, 2026-09-21. https://x.com/ishitaku39/status/2102038146489946532
Ho potuto generare il movimento del personaggio in tempo reale in base ai commenti... Ho integrato “ARDY Mini” nel mio AITuber. È una variante alleggerita da uno sviluppatore indipendente del modello di ricerca NVIDIA “ARDY”, fino a farlo funzionare nel browser.
Esempio di comunità OSS che rende pratico un modello di ricerca NVIDIA attraverso un derivato leggero. -
#35 @GeekCatX — 103 like, 18 repost, 4 risposte, circa 7.800 visualizzazioni, 2026-09-22. https://x.com/GeekCatX/status/2102336276230025224
Hand-drawn Video Skill has been updated again! ...the GitHub Stars for story-to-handdrawn-video have now exceeded 2,000. This time, the focus is on adding more art styles
Il progetto OSS “story-to-handdrawn-video” supera 2.000 stelle; l'aggiornamento aggiunge soprattutto altri stili artistici. -
#36 @so_ainsight — 573 like, 75 repost, 6 risposte, circa 49.000 visualizzazioni, 2026-09-21. https://x.com/so_ainsight/status/2101871551255830529
I 10 repository IA in più rapida crescita su GitHub questa settimana: 1. OpenCodeReview...
Riepilogo dei repository IA in crescita su GitHub, non limitato a immagini e video ma utile come contesto della spinta dell'OSS.
Segnali
- In crescita: i post dimostrativi individuali che mostrano Claude Opus 5.5 e Grok 4.7 capaci di creare video e animazioni in poco tempo e a basso costo ottengono sistematicamente engagement. In particolare Opus 5.5 è stato testato quasi contemporaneamente, il 21-22 settembre 2026, da più account indipendenti — @riku720720, @NFT_Chen, @cherry_mx_reds e @chetaslua — segnalando una ondata collettiva di verifica appena dopo il rilascio.
- Trascurato o controverso: Grok 4.7 riceve sia elogi per la generazione 3D in Blender, con circa 410.000 visualizzazioni, sia critiche del tipo “non serve a nulla”; @old_pgmrs_will ribatte in prima persona. Non è quindi un consenso puramente celebrativo.
- Aspetto sorprendente: sul lato open-source, gli sviluppatori indipendenti di area giapponese — @shinshin86, @ishitaku39 e @GeekCatX — mettono in risalto il numero di stelle GitHub. Più che annunci aziendali, prevale il racconto di singoli che combinano modelli di ricerca esistenti e agenti IA per trasformarli in strumenti operativi.
- Secondo aspetto sorprendente: tra le 10 query di ricerca su X, solo “Opus 5.5”, “Grok 4.7” e “GitHub” erano direttamente collegate all'IA per immagini e video. Le altre 7 — #chance, England, #sweepstakes, #giveaways, Lauren, $SONG e Jesus — erano trend Explore di X totalmente irrilevanti per il tema.
Limiti
- Delle 10 query, #chance (reality sentimentale ABEMA), England (meteo e calcio), #sweepstakes (campagne a premi come Fanatics), #giveaways (concorsi legati a festività indiane), Lauren (scandalo di una cantante R&B e telenovela brasiliana “Estrelas da Casa”), $SONG (token crypto su Cardano) e Jesus (contesti religiosi, critica ai videogiochi, telecronaca calcistica) erano estranee all'IA per immagini e video. Più di 20 dei 40 post raccolti ricadono in questo rumore, probabilmente perché le query sono state selezionate meccanicamente dai trend Explore di X.
- L'elenco Explore di X era basato sulla posizione del server e includeva “Trending in Croatia”, quindi rappresentava tendenze locali croate e non dinamiche globali. È probabile che anche le query rumorose derivassero da questa lista.
- I post direttamente pertinenti sono soltanto 11: quattro su Opus 5.5, quattro su Grok 4.7 e tre su strumenti open-source GitHub. L'analisi dei soli post non soddisfa il minimo richiesto dal brief di 10 osservazioni ciascuna per closed e open source; occorre integrarla con le altre piattaforme.
- Nelle query X non comparivano OpenAI (GPT-6/Sora), Midjourney, Stable Diffusion o Runway, né altri principali attori dell'IA per immagini e video; in questa raccolta non sono quindi state verificate le reazioni su X a tali prodotti.
YouTube
YouTube — Ultime notizie sull'IA per immagini e video (closed source/open source)
Canali
- OpenAI (canale ufficiale) — pubblica gli annunci ufficiali di Sora 2 e ChatGPT Images 2.5.
- Google / Google DeepMind (ufficiali) — annunci della serie Gemini “Nano Banana”.
- Adobe (ufficiale) — annunci sull'espansione multi-modello di Firefly.
- Runway (ufficiale) — annunci su Gen-4.5 e sul server MCP.
- Lev Selector — canale indipendente che riassume settimanalmente notizie IA, con la serie “Exciting AI Updates Weekly”.
- Creatori di tutorial ComfyUI / Stable Diffusion — tutorial per eseguire localmente modelli open source come Wan, LTX, Flux e HunyuanVideo.
- Canali di confronto e recensione — molti video mettono a confronto Sora 2, Seedance 2.0, Runway e Kling.
- Il numero di iscritti non è stato verificabile, poiché l'HTML delle pagine richiede rendering JavaScript e gli snippet di ricerca non lo riportavano (vedere
## Limits).
Video
Closed source
- Introducing Sora 2 — OpenAI ufficiale / 2025-09-30 / https://www.youtube.com/watch?v=gzneGhpXwjU — Bill Peebles, Rohan Sahai e Thomas Dimson presentano Sora 2, modello video generativo di nuova generazione fedele alla fisica e capace di sincronizzare dialoghi, oltre alla nuova app Sora.
- OpenAI Abandons Sora to Refocus on Enterprise Solutions — canale di analisi / intorno a marzo 2026 / https://www.youtube.com/watch?v=bIL7uU4CYnE — Spiega la chiusura dell'app Sora il 2026-04-26 e dell'API il 2026-09-24, il giorno successivo alla ricerca. Riporta costi operativi di circa 1 milione di dollari al giorno contro ricavi complessivi di 2,1 milioni.
- OpenAI Shuts Down Sora & Kills ChatGPT Integration Plans | What Happened? — canale di analisi / intorno a marzo-aprile 2026 / https://www.youtube.com/watch?v=9rhmczPT6Jk — Attribuisce il contesto della chiusura di Sora anche al fallimento, immediatamente prima dell'annuncio, di una partnership con Disney da 1 miliardo di dollari.
- Introducing ChatGPT Images 2.5 — OpenAI ufficiale / intorno al 2026-09-08 / https://www.youtube.com/watch?v=6l7ble9P74o — Annuncia GPT Image 2.5, o ChatGPT Images 2.5: generazione 50% più veloce e nuova funzione “Sketch” per trasformare direttamente schizzi disegnati a mano in immagini.
- Sketch with ChatGPT Images 2.5 — OpenAI ufficiale / settembre 2026 / https://www.youtube.com/watch?v=imPtIEAEHSU — Demo in cui si digita “@Sketch”, si disegna direttamente in ChatGPT e si trasforma lo schizzo in un'immagine IA.
- The New Gemini Image Generator is Insane (Nano Banana 2) — recensione / 2026-02-27 / https://www.youtube.com/watch?v=nikIxHM_AQY — Recensione del passaggio di Google a “Nano Banana 2” come modello di generazione immagini predefinito nell'app Gemini.
- Midjourney Update | March 2026: V8 Alpha, BIG Changes Coming, New Edit Model + More — canale dedicato a Midjourney / intorno a marzo 2026 / https://www.youtube.com/watch?v=TZ1zWvbXFug — Annuncia la V8 alpha, punto di partenza degli aggiornamenti V8.1 del 2026-04-14 e V8.2, con qualità e personalizzazione migliorate e modello di editing aperto a tutti il 2026-08-27.
- Kling 3.0: the biggest advancement in AI video generation? — recensione / prima metà 2026 / https://www.youtube.com/watch?v=G1VHCrl4jy4 — Valuta “Kling 3.0” di Kuaishou, presentato come il primo modello a generare video nativi in 4K e 60 fps e come numero uno della categoria video di Artificial Analysis.
- Grok Imagine 1.5 Preview - Mind-Blowing AI Video Just Dropped 🔥 | xAI — recensione / 2026-06-03 / https://www.youtube.com/watch?v=grxiFAC-NNI — Verifica l'anteprima Grok Imagine 1.5 di xAI.
- Sora 2 vs. Seedance 2.0 vs. Runway: The 2026 AI Video War Explained — confronto / 2026-02-13 / https://www.youtube.com/watch?v=rb0p_mY3tPs — Confronta Sora 2, Seedance 2.0 di ByteDance e Runway.
- Runway Ships an MCP Server - Generate Video From Inside Claude, ChatGPT, Cursor and Replit — Runway ufficiale / intorno al 2026-05-27 / https://www.youtube.com/shorts/t9Bg_4rOQqM — Runway annuncia un server MCP che consente di generare video direttamente da Claude, ChatGPT, Cursor e Replit.
Open source
- Now that Wan 2.5 (open source model from Alibaba China) can do AI dialogues, AI Lip Syncing to... — analisi / prima metà 2026 / https://www.youtube.com/watch?v=kzXNJO6caGw — Presenta Wan 2.5 di Alibaba, modello open source che supporta generazione di dialoghi e lip-sync.
- Wan2.6: Multi-shot Storytelling & Cinematic Shot Control — tutorial / fine 2025-inizio 2026 / https://www.youtube.com/watch?v=VHJ925WoWgw — Spiega “multi-shot storytelling”, nuova capacità di Wan 2.6 di creare video cinematografici multi-inquadratura fino a 15 secondi da un singolo prompt.
- Black Forest Labs: FLUX 2 – The King of AI Image Generation — recensione / 2026-06-04 / https://www.youtube.com/watch?v=WZfKzzX65-o — Valuta FLUX.2 di Black Forest Labs.
- FLUX.2 Just Beat Every AI Image Model — Black Forest Labs' Most Powerful Release Yet — recensione / 2025-11-27 / https://www.youtube.com/watch?v=VMBSUBKON_U — Sostiene che FLUX.2 superi i modelli esistenti per qualità, controllo e coerenza.
- Qwen Image-2512 First Test – The BEST Open Source Image Model! — recensione / 2026 / https://www.youtube.com/watch?v=SBaK616nP6Q — Verifica l'ultima generazione Qwen-Image 2.1 di Alibaba, che integra rendering del testo, editing e generazione trasparente e possiede un componente generativo da 7B parametri.
- HunyuanVideo 1.5 vs Wan 2.7 Comparison: Which is The Best Free Local Video AI Generation Model? — confronto / 2026 / https://www.youtube.com/watch?v=4GNT4-QYekg — Confronta in locale HunyuanVideo 1.5 di Tencent, 8,3B parametri ed eseguibile su GPU consumer, e Wan 2.7 di Alibaba.
- LTX 2 Full Tutorial | Run on Low VRAM PC + Video & Audio AI Generation (2026 Strongest Open-Source?) — tutorial / 2026 / https://www.youtube.com/watch?v=ytxbq9ZSgxo — Spiega come eseguire LTX-2 di Lightricks su PC con poca VRAM. LTX-2 è diventato completamente open source nel gennaio 2026 e a marzo è arrivato LTX-2.3 con editor video desktop.
- Best Open-Source AI Video in 2026: WAN 2.2 vs LTX 2.3 — confronto / 2026 / https://www.youtube.com/watch?v=ZZ5VH-rqHXQ — Confronta Wan 2.2 e LTX 2.3, due protagonisti del video generativo open source.
- Inpaint Canvas for ComfyUI: Krita-Style Layers, Colour Match & Retouch in One Node — analisi ComfyUI / inizio settembre 2026, pubblicato due settimane prima / https://www.youtube.com/watch?v=Lz7AT8SByx8 — Presenta il nodo custom open source “Inpaint Canvas”, pubblicato il 2026-09-05, con livelli, selezioni, selezioni assistite da SAM ed export PSD, trasformando ComfyUI in uno strumento di pittura completo.
Segnali
- La maggiore notizia closed-source è la fine di Sora 2: annunciato con grande enfasi a fine settembre 2025, Sora 2 ha chiuso l'app appena sei mesi dopo, il 2026-04-26, e avrebbe dovuto chiudere l'API il 2026-09-24, il giorno successivo alla ricerca. Vari video di analisi riportano costi operativi di circa 1 milione di dollari al giorno a fronte di soli 2,1 milioni di ricavi complessivi. Anche la partnership Disney, stimata a 1 miliardo, sarebbe saltata immediatamente prima dell'annuncio della chiusura.
- La generazione immagini vede aggiornamenti rapidi da Google, OpenAI e Midjourney: Nano Banana 2 per Gemini nel febbraio 2026, GPT Image 2.5/ChatGPT Images 2.5 l'8 settembre con Sketch e Midjourney V8→V8.1→V8.2 tra marzo e agosto, con il modello di editing aperto a tutti.
- I contenuti che confrontano la “guerra” dei generatori video sono un formato stabile: abbondano video e Shorts che mettono sullo stesso piano Sora 2, Seedance 2.0, Runway Gen-4.5, Kling 3.0 e Grok Imagine. Ciò suggerisce che l'interesse degli spettatori non sia la fedeltà a un prodotto, ma capire quale sia il migliore in quel momento.
- I principali fronti open-source sono Alibaba (Wan), Tencent (HunyuanVideo), Black Forest Labs (FLUX) e Lightricks (LTX): tutti distribuiscono modelli su Hugging Face/GitHub e generano molti tutorial per ComfyUI e GPU locali. Wan sta espandendosi rapidamente da dialoghi e lip-sync a riprese multi-shot.
- L'ecosistema ComfyUI si consolida come “quadro di cablaggio” della generazione IA: nel solo settembre 2026 sono comparsi Core Sparse Attention Node, Comfy Compiler, Inpaint Canvas, MiniMax H3 RefMods, Krea2T Enhancer e altri nodi, rafforzando il suo ruolo di livello intermedio che rende operativi i modelli open-source.
- Adobe Firefly diventa un hub che riunisce entrambe le fazioni: oltre ai propri modelli, integra più di 30 modelli esterni, tra cui Runway Gen-4.5, Google Nano Banana Pro, generazione immagini OpenAI e Black Forest Labs FLUX.2 [pro]. Anche nell'impresa si diffonde quindi la logica di combinare strumenti, anziché sceglierne uno solo.
- Recensioni e confronti con titoli sensazionalistici occupano una quota rilevante: formule come “BEST AI Image Generator in 2026 (Don't Choose Wrong!)” proliferano, rendendo la scelta del modello stessa un contenuto più importante dell'informazione tecnica.
Limiti
- Le pagine dei risultati e dei video YouTube richiedono rendering JavaScript; WebFetch restituiva solo il footer e non permetteva di ottenere visualizzazioni, iscritti o data di pubblicazione. Le date e le descrizioni derivano quindi solo dagli snippet di ricerca e non vengono riportati dati precisi sulle visualizzazioni.
- Per alcuni video — Wan 2.6 e confronti HunyuanVideo, ad esempio — la ricerca indicava solo “2026” e non il mese; non è stato possibile verificare rigorosamente il criterio di recenza entro 60 giorni. Sono stati prioritizzati gli elementi chiaramente recenti, come la chiusura dell'API Sora, ChatGPT Images 2.5 e Inpaint Canvas.
- Non è stato trovato un video YouTube ufficiale che annunciasse tempestivamente la fine dell'API Sora il 2026-09-24; sono stati verificati solo video successivi di canali di analisi.
- Le query non hanno portato in alto canali o video YouTube giapponesi, quindi le fonti sono prevalentemente anglofone.
Bluesky
Bluesky — Ultimi sviluppi nell'IA per immagini e video
Account
- @stabilityai.bsky.social — Account ufficiale Stability AI. Nella seconda metà del 2025 si concentra però soprattutto su Stable Audio e partnership enterprise, non sui modelli di immagini; engagement quasi nullo.
- @midjourneyofficial.bsky.social — Account ufficiale Midjourney. Ha annunciato l'arrivo su Bluesky nell'agosto 2025, ma l'ultimo post risale al 2025-10-08; non ci sono notizie recenti.
- @promptheroofficial.bsky.social — Account ufficiale PromptHero, servizio di condivisione prompt, che comunica la disponibilità di modelli closed come Sora 2.
- @ethanhe.bsky.social — Ingegnere del team Grok Imagine di xAI, in precedenza NVIDIA/Meta. Uno dei pochi addetti ai lavori che pubblica direttamente novità e offerte di lavoro su Grok Imagine.
- @chorizemabang.bsky.social — Utente giapponese che genera video con Grok Imagine e riporta problemi e insoddisfazione dall'ottica di chi usa davvero il prodotto.
- @metalmickey.bsky.social(澤村徹)— Artista residente a Tokyo, autore di videoclip e opere espositive con Seedance 2.5, GPT-6 e Suno V6; fornisce resoconti concreti dei costi di produzione.
- @you32081.bsky.social — Creatore che produce numerose illustrazioni IA R-18 con modelli open-source come Qwen-Image e Z-Image-Turbo.
- @lijack1001.bsky.social — Account SEO/spam affiliato che pubblica molti siti clone relativi a Nano Banana Pro, Seedance, Sora 2, Veo 3, Wan e GPT-5 Image. Non è una fonte di notizie, ma indica i nomi di modelli considerati parole chiave redditizie.
- @runwayml.bsky.social / @blackforestlabs.bsky.social / @comfy-ui.bsky.social — Gli handle ufficiali di Runway, Black Forest Labs e ComfyUI esistono, ma hanno pochissimi post o solo un post recente del 2024: di fatto sono inattivi.
Post
- PromptHero: “Sora 2 is now available on Prompthero: No watermarks, Available in Europe, Combine it with other models” — 2025-10-13, 0 like/0 repost. Post
Closed source. Indica che un servizio terzo di prompt rivende Sora 2 come senza watermark e disponibile in Europa. - xAI・Ethan He: “Excited to share our most advanced image generation model at xAI! Grok Imagine Quality mode — enhanced details, stronger text rendering...” — 2026-04-05, 0 like/0 repost. Post
Closed source. Un ingegnere ufficiale annuncia la Quality mode di Grok Imagine, con dettagli e rendering del testo migliorati. - xAI・Ethan He: annuncio di assunzione per trainer video “familiarity with AI video generation tools (Grok Imagine, Runway, Kling, Sora, Veo, or similar)” — 2026-03-29. Post
Closed source. Prova che xAI investe in personale per produrre dati di addestramento di modelli video, citando Runway, Kling, Sora e Veo come riferimenti. - @chorizemabang: “Grok Imagine ormai non riesce proprio più a generare, ma forse ha il suo fascino creare con calma un'opera al giorno.” — 2026-06-05, 13 like/1 repost. Post
Closed source. Segnalazione di problemi di generazione dal punto di vista di un utente. - @chorizemabang: “Grok Imagine è finito, quindi come scusa pubblico opere vecchie…” — 2026-05-31, 11 like/1 repost. Post
Closed source. Insieme al post precedente, indica problemi di stabilità di Grok Imagine tra maggio e giugno. - @metalmickey: “road movie rain version. Stitched Seedance2.5's 30-second clips. Fees are devastating.” — 2026-08-27. Post
Closed source. Esempio di produzione reale, un road movie IA di circa cinque minuti realizzato cucendo clip Seedance 2.5, accompagnato da lamentele sul costo elevato. - @metalmickey: “Attempted creating music video entirely AI-delegated without writing a single prompt line. GPT-6 Astra enables voice-directed workflow.” — 2026-09-07. Post
Closed source. Esempio di nuovo workflow per videoclip: tutto delegato all'IA mediante istruzioni vocali con GPT-6 Astra, senza scrivere un prompt. - Stability AI: “We're launching our Stability AI Image Services on Amazon Bedrock, bringing professional-grade image editing capabilities...” — 2025-09-18, 0 like/0 repost. Post
Orientato a API closed. Servizi di editing immagini, come inpainting e trasferimento di stile, offerti tramite AWS Bedrock. - Midjourney ufficiale: “#Midjourney is now on BlueSky! Who are the best creators to follow here?” — 2025-08-15, 41 like/4 repost. Post
Midjourney è closed source, ma questo è pressoché l'ultimo post dell'account: un esempio di ingresso sulla piattaforma senza consolidamento. - @you32081: illustrazioni IA R-18 create con Qwen-Image / Z-Image-Turbo — 2026-08-01, 6 like/0 repost. Post
Open source. Esempio di Qwen-Image e Z-Image-Turbo, modelli open-weight cinesi, ormai usati concretamente per la produzione di opere doujin e R-18.
Segnali
- Su Bluesky non esiste un hub forte specializzato in notizie di IA per immagini e video. Midjourney, Stability AI, Runway, Black Forest Labs e ComfyUI pubblicano raramente o ottengono da zero a poche interazioni, e sono di fatto inattivi. Non è un luogo di discussione rapida come X o Reddit.
- Le notizie closed arrivano quasi esclusivamente da singoli addetti ai lavori delle aziende. L'unico account con pubblicazione continua è Ethan He di xAI, ingegnere di Grok Imagine, che tra marzo e aprile 2026 ha annunciato la Quality mode e l'assunzione di trainer video.
- Grok Imagine sembra essersi destabilizzato tra maggio e giugno 2026. L'utente giapponese @chorizemabang ha scritto più volte che non riusciva più a generare e che il servizio era “finito”, poco dopo l'annuncio del potenziamento di aprile; possibile segnale di infrastruttura insufficiente rispetto alla crescita.
- Seedance 2.5 di ByteDance spicca nei registri di produzione reale. L'artista di Tokyo @metalmickey ha usato clip Seedance 2.5 per un road movie IA di circa cinque minuti nell'agosto 2026, lamentandone ripetutamente il costo elevato: un problema concreto dei servizi closed/a pagamento.
- Le citazioni dell'open source — Flux, Wan, Qwen-Image, Z-Image-Turbo, HunyuanImage e ComfyUI — compaiono a frammenti come hashtag in post personali di IA R-18/doujin, non come notizie. Non è stato trovato un divulgatore specializzato comparabile a r/StableDiffusion.
- Sono frequenti spam SEO e affiliazioni che sfruttano i nomi dei modelli. Account come @lijack1001 pubblicano in modo meccanico link a siti clone per Nano Banana Pro, Seedance 2.0, Sora 2, Veo 3, Wan 2.2 e GPT-5 Image. Sono inutili come fonti, ma testimoniano quali termini hanno domanda di ricerca.
- Nano Banana Pro è citato spesso nelle community R-18 e IA-art. Ricorre in hashtag e biografie accanto a Ideogram 4 e Krea 2, apparentemente consolidato come strumento commerciale usato oggi.
Limiti
- L'API ufficiale di ricerca full-text di Bluesky (
app.bsky.feed.searchPosts) ha risposto HTTP 403 a tutte le query provate —Stable Diffusion,Midjourney,Flux,teste altre — e non è mai stata utilizzabile.app.bsky.actor.getProfile,app.bsky.actor.searchActorseapp.bsky.feed.getAuthorFeedfunzionavano; perciò l'indagine ha potuto solo cercare account e leggere i loro feed. - La versione web di
bsky.appè una SPA con rendering lato client e il fetch restituiva pagine vuote; è stato necessario interrogare direttamente l'API JSON pubblica. - Senza ricerca full-text è molto probabile che siano sfuggiti post pertinenti di account sconosciuti o difficili da trovare. In particolare, non è possibile distinguere se gli account specializzati in notizie open-source non esistano oppure non siano stati scoperti a causa del vincolo di ricerca.
- Sono stati esaminati gli account ufficiali di Stability AI, Midjourney, Runway, Black Forest Labs e ComfyUI, ma nessuno aveva notizie recenti su modelli per immagini/video. Questa è una caratteristica di Bluesky e non dimostra l'assenza di discussione sulle altre piattaforme.
Lemmy
Lemmy — Notizie sull'IA per immagini e video (open source/closed source)
Lemmy è un forum federato di piccole dimensioni. Le discussioni su immagini IA si concentrano soprattutto in !«メールアドレス» e nelle comunità vicine, nonché in !«メールアドレス», che effettua mirror automatici di r/ArtificialInteligence tramite bot. La ricerca ha attraversato Lemmy mediante l'API di ricerca di lemmy.world (/api/v3/search) e ricerche web, usando termini come “image generation”, “video generation”, “Stable Diffusion”, “Flux”, “Qwen Image”, “Sora”, “Midjourney”, “Nano Banana”, “Grok Imagine” e “ComfyUI”.
Comunità
!«メールアドレス»— 5.713 iscritti. Principalmente post tecnici su modelli open-weight per immagini/video e su ComfyUI.!«メールアドレス»— 2.361 iscritti. Principalmente condivisione di opere generate, con poca rilevanza da notizie.!«メールアドレス»— Pubblica ogni giorno molte immagini anime generate tramite civitai; si tratta di opere, non di notizie.!«メールアドレス»(Free Open-Source AI) — 4,84K iscritti, 1,81K locali. Dedicata all'IA open source in generale, con pochi post specifici su immagini/video.!«メールアドレス»— Community che fa mirror automatico di r/ArtificialInteligence. Non rappresenta discussioni native Lemmy, ma repost di Reddit.!stable_diffusion_abstraction(50 persone)/!stable_diffusion_furry(52 persone)/!stable_diffusion_mycology(97 persone) — Comunità di nicchia per la condivisione di opere, con pochi iscritti.
Post
Orientati all'open source
-
Qwen-Image-2.1 in ComfyUI: Open-Weight Image Generation and Editing, Now with Transparency
!«メールアドレス», 2026-09-22, punteggio 9
https://blog.comfy.org/p/qwen-image-21-in-comfyui-open-weight
Modello Alibaba Qwen da 7 miliardi di parametri per generazione ed editing di immagini open-weight. Supporta output RGBA trasparente per loghi e cutout, risoluzione nativa 2048×2048, fino a 10 immagini di riferimento e integrazione nativa in ComfyUI. -
Qwen-Image-2.1: Compact, efficient, and unified image creation
!«メールアドレス», 2026-09-20, punteggio 1
https://qwen.ai/blog?id=qwen-image-2.1
Annuncio sul blog ufficiale Qwen: fonte primaria del post ComfyUI precedente. -
supElement/ComfyUI_MinimaxH3_AutoContext: A long video generation solution that breaks through the memory barrier
!«メールアドレス», 2026-09-16, punteggio 1
https://github.com/supElement/ComfyUI_MinimaxH3_AutoContext
Estensione ComfyUI per MiniMax H3. Divide automaticamente un video in segmenti e li collega tramite latent anchoring, superando i vincoli VRAM nella generazione di video lunghi. Licenza Apache-2.0, 31 stelle e 153 commit. -
Adudeguyman/ComfyUI-Fantastic-MiniMaxH3-PromptBuilder
!«メールアドレス», 2026-09-16, punteggio 3
https://github.com/Adudeguyman/ComfyUI-Fantastic-MiniMaxH3-PromptBuilder
Prompt builder ComfyUI per MiniMax H3. Un altro esempio dell'aggiornamento attivo dell'ecosistema che circonda i flussi locali di generazione video. -
Boogu-Image-0.1 — Efficient Image Generation Foundation Model
!«メールアドレス», 2026-06-17, punteggio 5
https://boogu.org/
Pubblicazione di un nuovo modello open source per immagini, orientato alla leggerezza e all'efficienza. -
AI video generation is becoming less about the model and more about the workflow
!«メールアドレス»(repost Reddit), 2026-09-19, punteggio 1
https://www.reddit.com/r/ArtificialInteligence/comments/1wkl4db/
Post secondo cui la qualità della generazione video dipende sempre più dalla costruzione del workflow con modelli open-weight e strumenti nello stile di ComfyUI, più che dal modello isolato.
Orientati al closed source
-
OpenAI is shutting down Sora's API next week while a Chinese competitor raised $3B
!«メールアドレス»(repost Reddit), 2026-09-20, punteggio 1
https://www.reddit.com/r/ArtificialInteligence/comments/1wluu0n/
La chiusura dell'API Sora 2 il 24 settembre, con app già chiusa in aprile, viene contrapposta ai 3 miliardi raccolti da Kuaishou, concorrente cinese di Kling. La tesi è che l'offerta consumer appariscente fallisca, mentre il business enterprise meno glamour sia redditizio. -
Midjourney pivots from AI image generation to body scanning medical spa(articolo di contesto, grande svolta di giugno i cui effetti continuano)
!«メールアドレス», 2026-06-18, punteggio 58
https://www.theregister.com/ai-and-ml/2026/06/18/midjourney-pivots-to-medical-devices/
Secondo il rapporto, Midjourney passa dalla generazione di immagini IA a dispositivi medici quali scanner CT a ultrasuoni. In relazione,!«メールアドレス»contiene post “Midjourney Medical” e “Midjourney Ultrasonic CT Scanner”, entrambi del 2026-06-18. -
Midjourney wants Hollywood studios to reveal the details of their AI usage
!«メールアドレス», 2026-07-05, punteggio 73
https://techcrunch.com/2026/07/04/midjourney-wants-hollywood-studios-to-reveal-ai-usage/
Seguito sul conflitto di Midjourney con Hollywood riguardo copyright e uso dell'IA per immagini/video, anche dopo la svolta medica. -
Google lanciert KI-Bildgenerierung Nano Banana 2 Lite
!«メールアドレス», 2026-07-02, punteggio 0
https://www.itmagazine.ch/artikel/87529/
Notizia tecnologica svizzera sul rilascio da parte di Google di “Nano Banana 2 Lite” della famiglia Gemini;!«メールアドレス»include anche un post alla fonte primaria deepmind.google del 2026-06-30. -
Seedream 5.0 Pro is here: an honest comparison and technical breakdown
!«メールアドレス»(repost Reddit), 2026-07-10, punteggio 1
https://www.reddit.com/gallery/1usc03q
Recensione e confronto del modello closed di ByteDance “Seedream 5.0 Pro”. -
Google quietly discontinues its Earth AI feature a day after its rollout after users made no-no images
!«メールアドレス»(repost Reddit), 2026-08-07, punteggio 1
https://fortune.com/2026/08/07/
Rapporto secondo cui Google ha ritirato Earth AI appena un giorno dopo il lancio, a causa di immagini problematiche create dagli utenti: un esempio di difficoltà nei guardrail dei fornitori closed-source. -
Elon Musk maakt complete AI-film met zijn versie van The Odyssey
!«メールアドレス», 2026-07-22, punteggio 1
https://lemy.nl/post/4342454
Articolo in olandese secondo cui Elon Musk starebbe producendo un film basato su una sua interpretazione dell'Odissea usando le funzioni di generazione video di Grok; argomento con forte impronta di marketing closed-source. -
Same Berserk spread, 4 AI colorizations. Looks like GPT wins again?
!«メールアドレス»(repost Reddit), 2026-09-14, punteggio 1
https://www.reddit.com/gallery/1wfyqdy
Confronto di quattro IA, tra cui un modello GPT, nella colorazione della stessa pagina manga; la conclusione riportata è che GPT prevalga.
Segnali
- Le discussioni vive su IA per immagini/video in Lemmy sono quasi tutte limitate ai post su strumenti ComfyUI di
!«メールアドレス»e ai mirror Reddit in!ai_reddit. Le notizie originali native di Lemmy sono poche. - Sul lato open source, i post riguardano più spesso workflow ComfyUI e nodi/estensioni che modelli isolati. Due estensioni per MiniMax H3 sono apparse nella stessa settimana, indice di vitalità del livello operativo per il video generativo.
- Sul lato closed-source dominano ritiri e cambi di direzione: fine dell'API Sora, svolta medica di Midjourney, ritiro immediato di Earth AI di Google. Si parla più di fallimenti di monetizzazione e correzioni di rotta che di lanci vistosi.
- Comunità di opere come
!«メールアドレス»pubblicano molto, ma sono flussi di immagini civitai senza rilevanza da notizie.
Limiti
- Lemmy è molto più piccolo di Reddit e X; anche
!«メールアドレス»ha appena 5.713 iscritti. Non esiste abbastanza volume di notizie native per soddisfare il target di circa 20 post analizzati: la scala è coerente con le 5-12 voci previste dal playbook. !ai_redditnon contiene discussioni native Lemmy ma repost automatici di Reddit, quasi senza commenti; le reazioni della comunità Lemmy sono quindi di fatto non osservabili.- Gli endpoint
/api/v3/communityrichiedevano spessocommunity_id; alcune comunità, comeaiwarso ricerche singole perimageai, hanno restituito 400/404. In tali casi ci si è limitati a integrare con risultati web. - Le ricerche di modelli video specifici — “Wan”, “HunyuanVideo” e “Kling” — producevano molto rumore per collisioni con nomi comuni o abbreviazioni; non sono stati trovati post chiaramente nativi Lemmy su questi termini.
Pinterest — Notizie sull'IA per la generazione di immagini e video
Temi visivi
- Formato miniatura YouTuber “AI NEWS”: creator barbuti scioccati o entusiasti davanti a loghi al neon a riquadro arrotondato di OpenAI, Google, Microsoft, Meta e Notion, disposti a griglia — lo stile di pin più ricorrente del set. [1, 8, 30]
- Hero shot SaaS per strumenti di generazione video IA: mockup UI blu navy/viola scuro con un box luminoso “text prompt → generate”, oppure una simpatica mascotte robot bianca con ciak, accompagnati da righe di icone per Text to Video / AI Editing / Auto Soundtrack / Captions. [6, 11, 16]
- Grafici comparativi “miglior strumento” e classifiche: matrici decisionali dai bordi al neon e schede “My Top Picks” che confrontano ChatGPT Plus, Midjourney, Gemini, Ideogram, Kling, Runway, Luma e Pika per fascia di prezzo e caso d'uso. [10, 20]
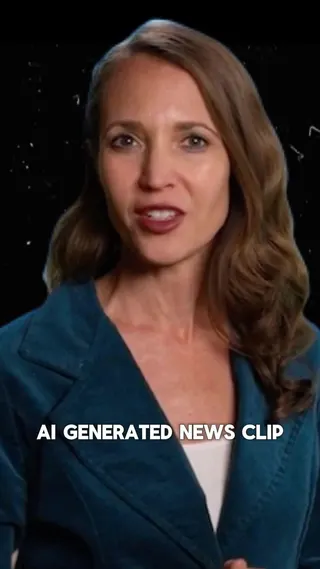
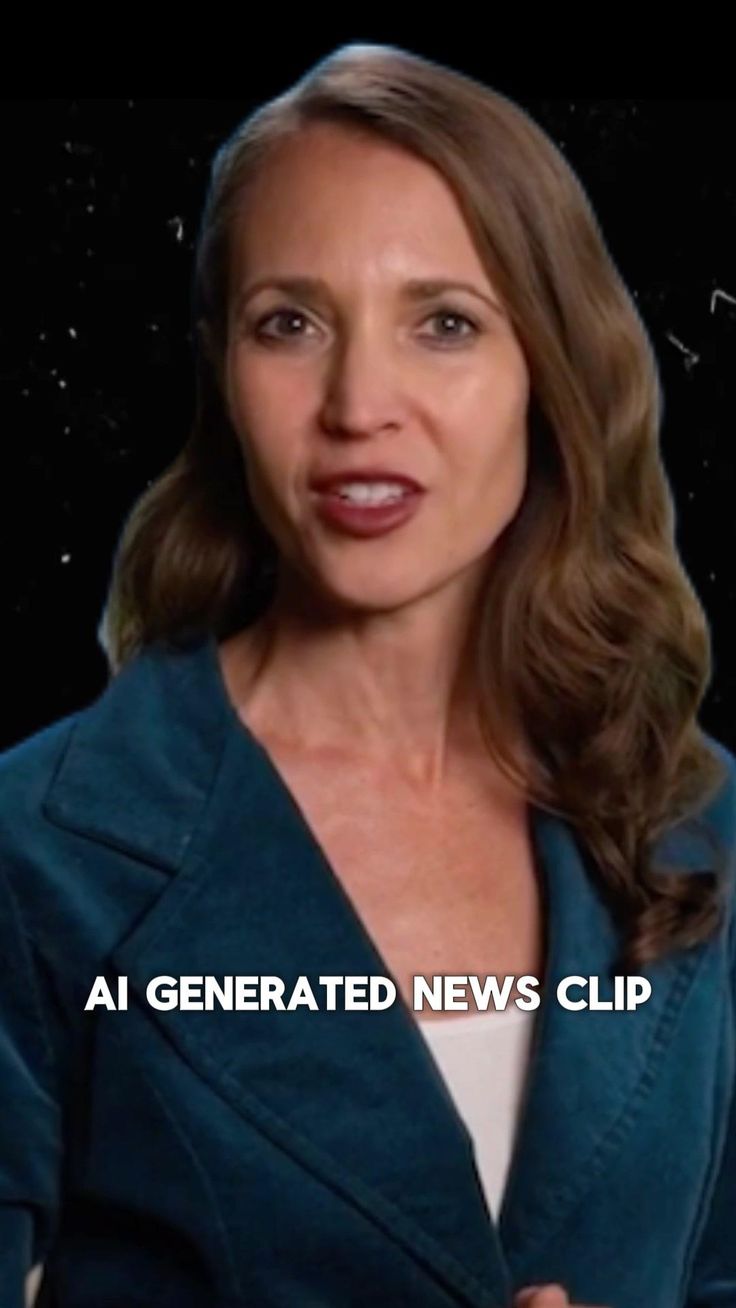
- Immagini di avvertimento su deepfake e disinformazione: grafiche con timbri rossi “FAKE”, lenti d'ingrandimento su un “?”, un occhio metà umano/metà wireframe, badge di rilevamento vocale “97% likely AI generated” e la didascalia “AI GENERATED NEWS CLIP” sovraimpressa su un finto conduttore. [4, 27, 38, 49]
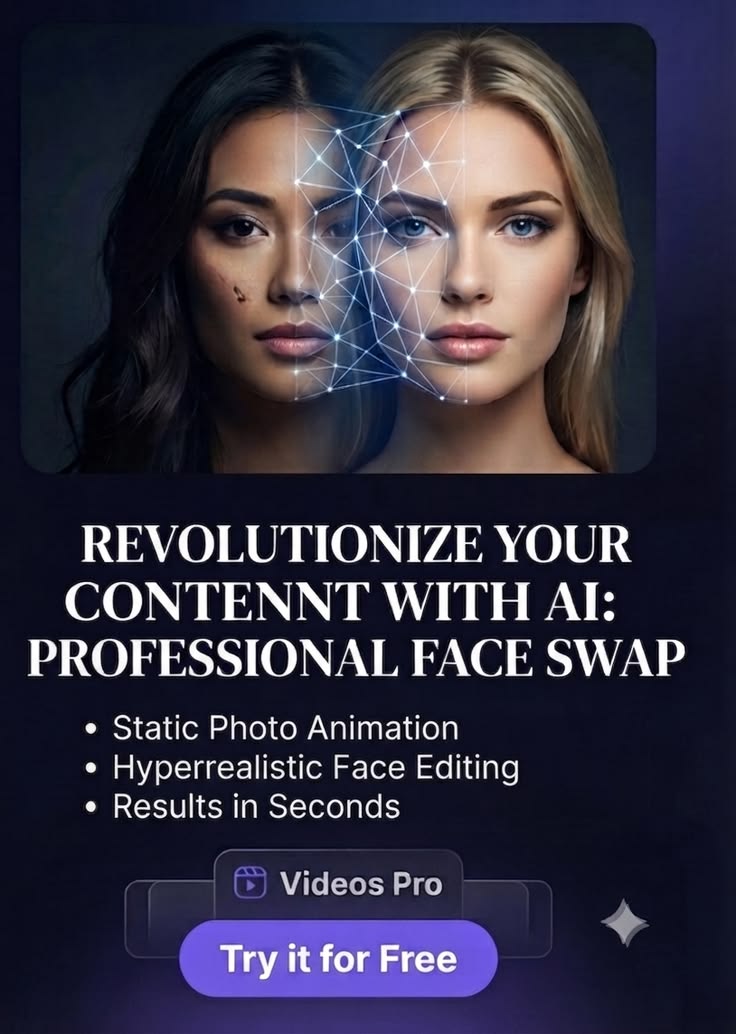
- Pubblicità di app per face swap e fusione di identità: due volti che si dissolvono in una mesh triangolata (“Professional Face Swap”) e un trittico madre+padre→figlio previsto (“AI Baby in Seconds”). [43, 44]
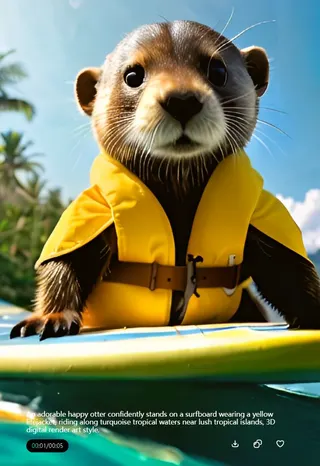
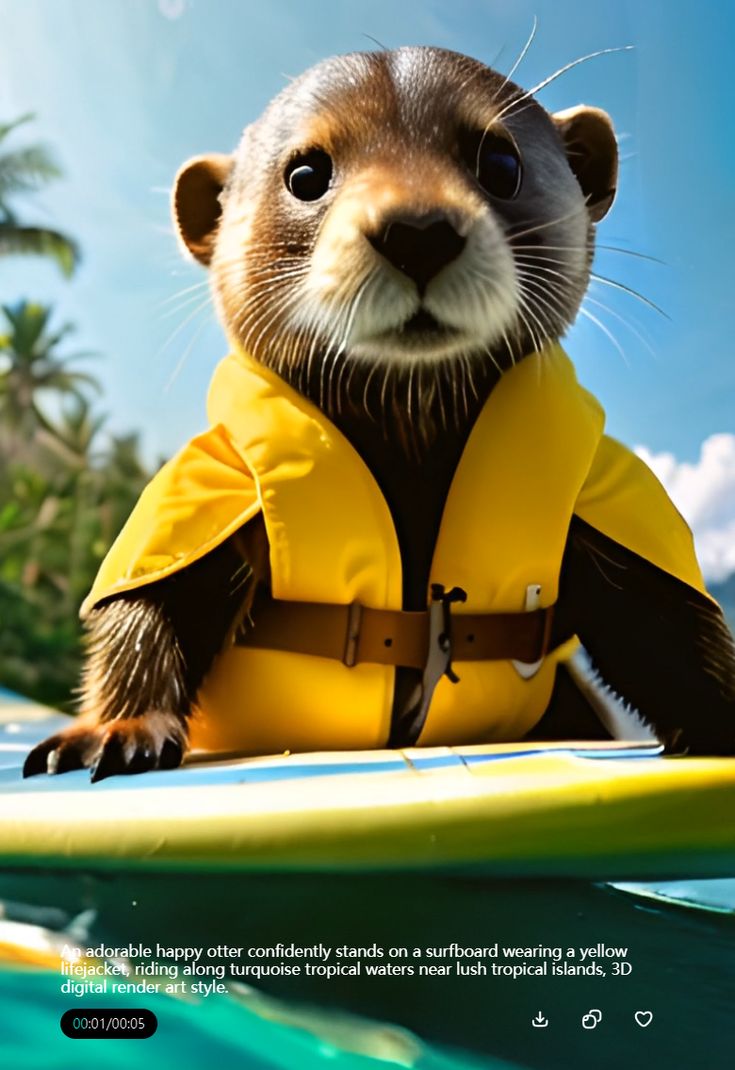
- Stranezze generate dall'IA usate come demo di stile o esca per engagement: una lontra iperrealistica su una tavola da surf con giubbotto salvagente, ritratto di un vecchio pescatore e collage fantasy con castello, orso polare, coppia samurai e torta. Mostrano la qualità della generazione, non notizie. [13, 34, 45]
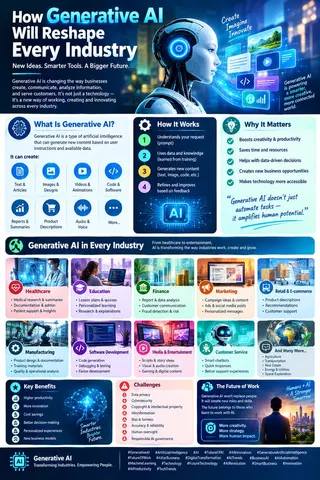
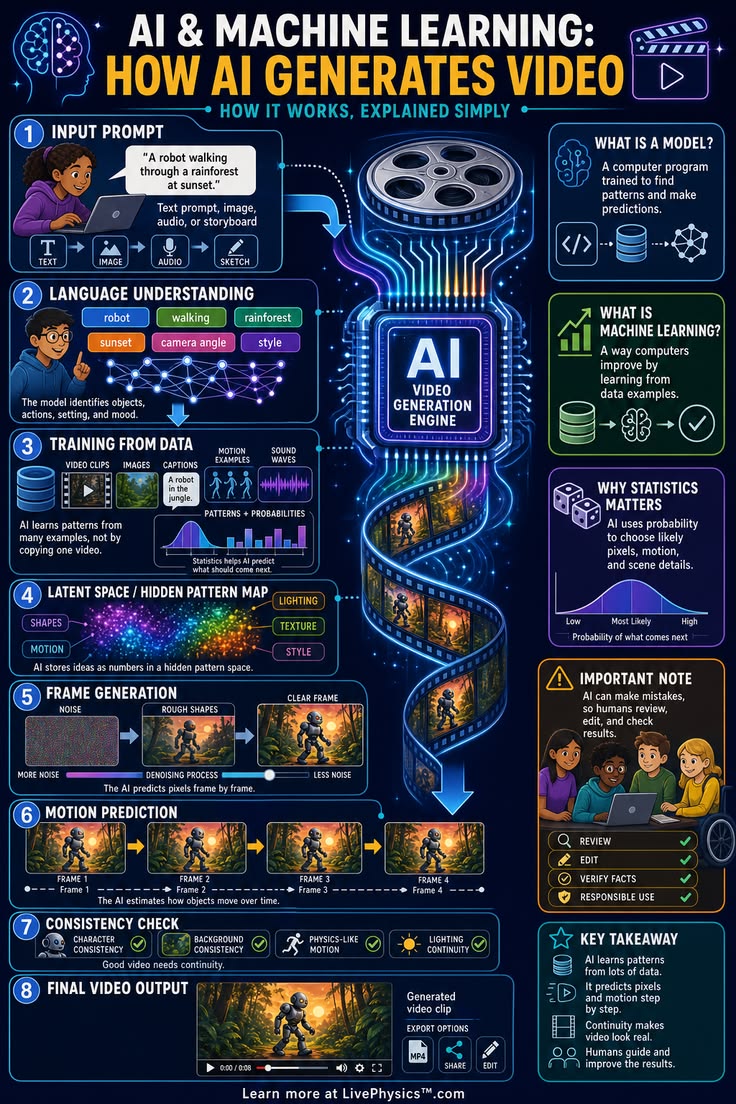
- Infografiche esplicative in linguaggio semplice: diagramma in otto fasi su come l'IA genera video — prompt → comprensione linguistica → spazio latente → diffusione dei frame → controllo di coerenza → output — rivolto a un pubblico non tecnico. [12]
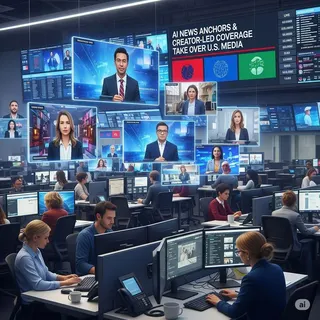
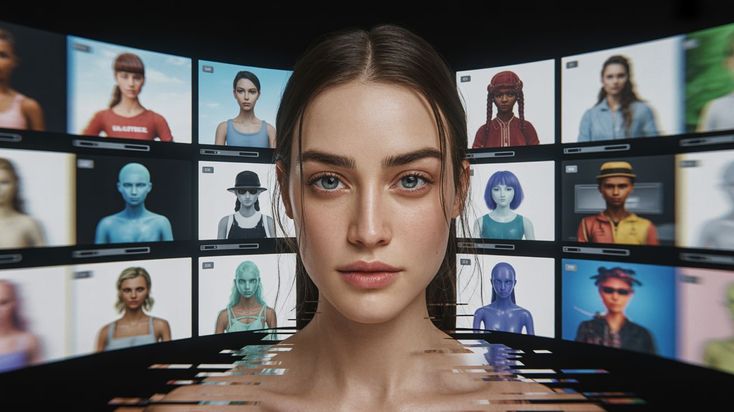
- Immagini su disruption delle redazioni ed economia degli avatar: collage di una regia con conduttori IA sugli schermi, griglia di avatar influencer stilizzati dietro un volto fotorealistico e grafica a strada biforcata “Human Journalism vs Machine-Generated Media”. [38, 40, 23]
Pin notevoli
- #1 — “AI News: Anthropic Leak Shows Us The Future of AI...”: miniatura archetipica con creator scioccato e loghi OpenAI/Google/Microsoft/ChatGPT; stabilisce il template visivo ripreso dagli altri pin “AI NEWS”.
- #3 — “Google announces ultra-high quality video...”: griglia 3×5 che trasforma un video sorgente in stili “blocchi di legno / origami / Lego / fiori”; demo concreta di restyling video tipo Lumiere, non una semplice scheda di notizia.
- #10 — “AI Image Video: Best Quality vs Best Free”: matrice decisionale completa che confronta 10 strumenti a pagamento, 10 gratuiti e casi d'uso; l'artefatto più chiaro dell'ansia “quale strumento IA dovrei davvero usare?”.
- #12 — “AI & Machine Learning: How AI Generates Video Infographic”: infografica LivePhysics.com per principianti sul processo di diffusione e predizione dei frame in otto fasi, utile come risorsa “spiegalo a un amico”.
- #27 — “AI is getting scary good”: riunisce generatori video IA, rilevatori vocali “97% likely AI generated” ed etica IA; la più concentrata espressione visiva del tema dell'ansia da deepfake.
- #38 — “AI News Anchors & Creator-Led Coverage Take Over U.S. Media”: collage di una redazione in cui conduttori IA riempiono una parete di monitor, visualizzando direttamente la sostituzione di talenti televisivi tradizionali.
- #40 — “Het perfecte avatar-tijdperk” in olandese, l'era perfetta degli avatar: un volto fotorealistico davanti a una griglia di avatar IA stilizzati, che cattura il trend degli influencer IA in un risultato Pinterest europeo e multilingue.
- #43 — Akool “Professional Face Swap” (pubblicità in spagnolo): due volti femminili che si fondono tramite un overlay di mesh facciale; prodotto commerciale di face swap promosso direttamente su Pinterest.
- #44 — “AI Baby in Seconds”: trittico madre/figlio previsto/padre, sottogenere distinto e in rapida crescita apparso come cluster di pin autonomo.
- #49 — “You Are Not Prepared for This Terrifying New Wave of AI-Generated Videos”: finto conduttore generato dall'IA con l'etichetta “AI GENERATED NEWS CLIP” direttamente nell'inquadratura, il pin più esplicitamente ammonitore del set.
Segnali
- La stanchezza decisionale sugli strumenti è l'angolo dominante per i consumatori. Un'ampia quota dei pin consiste in grafici comparativi, matrici “migliore gratuito vs a pagamento” e schede “le mie scelte principali”, non in notizie su un singolo rilascio. Gli utenti Pinterest cercano più aiuto per scegliere e adottare che annunci. [10, 20, 29]
- L'ansia per deepfake e disinformazione è un vero genere visivo, non una nota marginale: timbri FAKE, badge di rilevamento vocale ed etichette di contenuto IA ricorrono quasi quanto i contenuti promozionali. [4, 27, 38, 41, 49]
- Il trend dei conduttori IA ha una forte trazione visiva: più pin indipendenti — collage di regie, contenuti con branding Channel1, etichette “AI generated news clip” — li presentano come fenomeno reale e discusso, non ipotetico. [38, 49, 50]
- Assente: l'open source è quasi invisibile. Nell'intero campione l'unico strumento chiaramente locale/open è “Amuse 3.0” di AMD [34]; non compaiono screenshot di Stable Diffusion, ComfyUI o UI di modelli locali, a differenza della forte presenza vicina al closed source, con loghi e mockup di ChatGPT, Gemini, Midjourney, Kling, Runway e Luma.
- Assenti: screenshot diretti dei più recenti modelli closed nominati. Nel campione non sono comparsi screenshot dell'UI di Sora 2, Nano Banana o Veo 3 nativo; la maggior parte dei pin closed è costituita da miniature affiliate/creator che parlano delle notizie, non dal prodotto stesso.
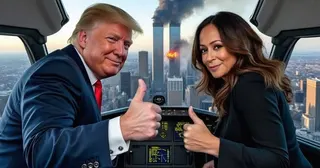
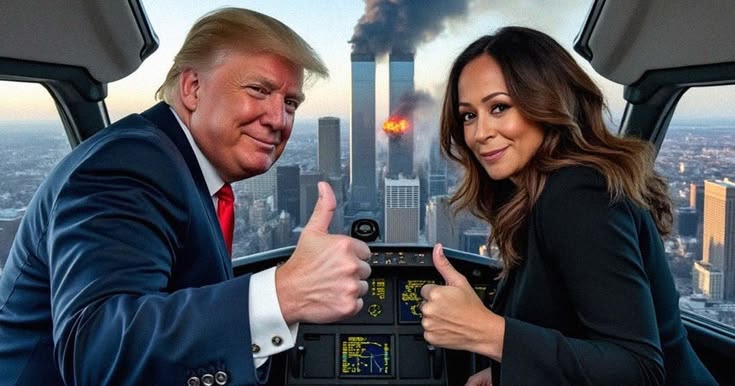
- Avvertenza: il pin #47, intitolato “Elon Musk's New AI Already Being Used to Generate...”, mostra in realtà un'immagine composita di Donald Trump e una donna che fanno il pollice in su nella cabina di un aereo, con il World Trade Center in fiamme sullo sfondo. Il titolo non descrive affatto l'immagine: esempio concreto di immagini realistiche IA su disastri/politica che circolano con titoli clickbait non corrispondenti. I titoli dei pin di questo dataset non sono quindi affidabili per descriverne il contenuto.
Limiti
- Non sono stati definiti generi per questa raccolta; un'unica ricerca non filtrata di “Image and Video Generation AI News” ha mescolato miniature di creator, pubblicità di prodotti, foto stock e immagini in stile notizia, anziché categorie già ordinate per argomento.
- Dei 50 elementi raccolti, sono stati aperti e ispezionati visivamente 26, selezionando un campione rappresentativo e vario, non tutti i 50. Le conclusioni si basano su quel campione.
- Vari titoli non corrispondevano alle immagini, soprattutto il #47; un'analisi costruita solo sulla tabella dei titoli sarebbe quindi inaffidabile. Il rapporto si basa su ciò che le immagini mostrano effettivamente.
- I pin Pinterest raccolti non riportano conteggi di repin o like; l'idea di “trend” è inferita dalla ripetizione di uno stile visivo nel campione, non da popolarità misurata.
- Pinterest tende a contenuti secondari e derivati — miniature, header di blog, creatività pubblicitarie — piuttosto che annunci primari. Per confermare dettagli di prodotto/versione, ad esempio su Veo o Kling, servono le fonti primarie sulle altre piattaforme trattate qui.
Azioni consigliate
- Monitorare lo stack OSS per video locali — Wan, HunyuanVideo, FLUX.2, ComfyUI + MiniMax H3 — come alternativa pratica mentre gli strumenti closed aumentano i prezzi e chiudono prodotti.
- Anticipare il sentimento favorevole alla dichiarazione dei contenuti IA in crescita su Reddit e Pinterest, predisponendo ora messaggi su provenienza ed etichettatura.
- Osservare dove migreranno gli utenti dopo la chiusura dell'API di Sora 2 il 2026-09-24; Kling, Seedance e Runway sono i probabili beneficiari.
- Considerare l'ondata di demo one-shot Opus 5.5/Grok 4.7 su X come hype breve della finestra di rilascio, non come minaccia duratura alla rilevanza dell'OSS.
- Monitorare la tensione nello scaling del calcolo di DeepSeek come indicatore anticipatore di ciò che accade quando l'adozione open-weight supera l'infrastruttura dell'operatore.
- Rispondere alla stanchezza “quale strumento uso?” visibile su YouTube e Pinterest con contenuti comparativi, invece di notizie su un solo prodotto.
Immagini raccolte


























Nota sulla qualità dei dati
Solo YouTube e Pinterest hanno raggiunto approssimativamente il target di circa 20 elementi del brief. Reddit ha restituito soltanto 12 thread, in gran parte da subreddit generici fuori tema; dei 40 post di X, più della metà era rumore generato da parole di tendenza non pertinenti; l'API di ricerca full-text di Bluesky ha restituito 403 per tutta la raccolta, perciò la copertura si è basata unicamente su account noti; Lemmy è semplicemente una piattaforma troppo piccola — comunità principale con circa 5.713 iscritti e metà dei post costituiti da mirror Reddit — per raggiungere 20 post nativi.