Notizie sull’IA per la generazione di immagini e video — 2026-09-20
L’open source (in particolare i modelli cinesi come Qwen, Wan e MiniMax-H3) sta rapidamente affermandosi come alternativa per chi esaurisce le quote gratuite dei servizi closed-source. Nel frattempo, la fase X non ha prodotto dati a causa di query di ricerca irrilevanti, perciò questa analisi si basa sostanzialmente su cinque piattaforme.
Riepilogo delle notizie sull’IA per la generazione di immagini e video — closed source vs open source — 2026-09-20
Ehilà! Questa volta ho controllato a tutta velocità sei piattaforme — Reddit, X, YouTube, Bluesky, Lemmy e Pinterest 🔥🔥 In sintesi, il fronte closed-source (Google Veo/Nano Banana, Sora 2, Midjourney, Kling, Seedance e simili) continua a dominare le notizie e la sincronizzazione audio sta davvero diventando una funzione standard. Ma il fronte open-source, soprattutto i modelli cinesi Qwen, Wan e MiniMax-H3, sta recuperando a velocità folle e si sta imponendo come rifugio per gli utenti che hanno esaurito le quote gratuite 🚀 Un altro punto importante, anche se meno appariscente: la reazione negativa contro i contenuti generati dall’IA è più forte nei luoghi frequentati dal pubblico generale che nelle comunità di appassionati di IA 😤. Detto con onestà, però, la fase X è stata un completo buco nell’acqua, quindi le fondamenta di questo report coprono di fatto cinque piattaforme 🙏
Across platforms
- Lo slancio dell’open source non accenna a fermarsi: Reddit (Wan, Minimax H3 e Krea2 vengono citati in più discussioni come rifugi dopo l’esaurimento delle quote gratuite closed-source), Lemmy (oltre 15 post di strumenti ComfyUI per MiniMax-H3 soltanto a settembre nella community
!stable_diffusion) e YouTube (Qwen-Image→Qwen-Image-2512→Z-Image, Wan 2.5→2.6→2.7 aggiornati quasi mensilmente) raccontano tutti la stessa storia. L’idea che “open source = alta qualità gratis” sta ormai diventando de facto 💪 - La generazione video closed-source considera ormai normale avere l’audio: la stessa tendenza è emersa su Bluesky (audio sincronizzato di Kling 3.0 annunciato da Replicate, integrazione audio-video di Seedance 2.0) e YouTube (Grok Imagine 1.5 presentato come capace di generare insieme dialoghi e suoni ambientali) 🎬🔊
- La famiglia Veo/Nano Banana di Google è diventata il “volto” del closed source: la conferma arriva da tre fonti — Pinterest (filmati Veo caldi in stile Pixar riutilizzati ripetutamente come immagini virali), YouTube (Theo - t3.gg afferma senza mezzi termini che “Google won image generation”) e Reddit (si discute dell’espansione delle quote gratuite di Google Flow) 👀
- La reazione negativa ai contenuti IA sta esplodendo fuori dalle comunità di appassionati: Reddit (354 punti di rabbia per l’ammissione di opere IA ad ArtPrize e 63 punti di lamenti per gli obiettivi di produzione di immagini IA sul lavoro), Lemmy (la community anti-IA
!fuck_aiconta 9.179 utenti attivi mensili, tra le più grandi di Lemmy) e Pinterest (i quiz “Real vs AI” per distinguere vero e falso sono diventati un genere autonomo) trasmettono tutti la stessa atmosfera 😨 - Le fonti primarie arrivano più da individui che da aziende: su Bluesky gli account aziendali ufficiali sono quasi silenziosi, mentre ricercatori indipendenti come Simon Willison e provider di hosting come Replicate fungono da fonti. Anche su YouTube i canali personali con rassegne settimanali, come AIPOD-CAST e Lev Selector, sono fonti di notizie. La scarsità di canali in cui le aziende comunicano direttamente sembra una tendenza comune 📢
Platform by platform
Reddit: raccolte 12 discussioni da 9 subreddit, meno dell’obiettivo di 20. In più thread ricorre il tema dell’open source (Wan, Minimax H3, Krea2) come via di fuga dopo l’esaurimento delle quote gratuite closed-source, mentre le opinioni su GPT Image 2.5 Flare sono divise a metà tra chi lo definisce “incredible” e chi dice “è uguale a Krea2” 😂 Il punto sorprendente è che le discussioni più accese non erano nei subreddit tecnici, ma nelle community generaliste (reazione ad ArtPrize, 354pt) e professionali (lamenti dei designer, 63pt).
X: onestamente, è stato un incidente totale 🙈 I 40 post raccolti derivavano solo dalla ricerca di trend generici della zona di connessione, nei dintorni della Croazia, come “Greenland”, “#Bitcoin” e “Chelsea”; nessuno riguardava l’IA per immagini o video. Quindi X non ha offerto alcuna osservazione né sul closed source né sull’open source. È una lacuna evidente nella piattaforma nominata esplicitamente dal brief 🕳️
YouTube: esaminati 12 video. I canali favorevoli al closed source (Theo, Astrovah, Woollyfern, specializzato negli aggiornamenti mensili di Midjourney, e FixNode) e quelli favorevoli all’open source (Bijan Bowen, HitPaw, MaxonShire e Promptus AI) si distinguono nettamente: il lato open enfatizza “ComfyUI”, “esecuzione locale” e “gratis”, mentre il lato closed punta su qualità e funzionalità. Peccato che la pagina dei risultati di ricerca dipenda così tanto da JavaScript da rendere quasi impossibile ottenere visualizzazioni e iscritti 😅
Bluesky: poiché l’API ufficiale di ricerca veniva bloccata ripetutamente con errore 403, la ricerca è stata riorientata sui post di ricercatori indipendenti (Simon Willison, Max Woolf, Ethan Mollick) e di Replicate. Quasi tutti i post reperiti riguardavano modelli closed-source (GPT Image 2, Runway Gen-4.5, Kling 3.0, Seedance 2.0, Vidu Q3); non sono stati trovati account attivi della community open-source, e l’unico account plausibile era inattivo dal febbraio 2025. È curioso anche che l’immagine di un pellicano in bicicletta sia diventata un classico per confrontare i modelli 🐦🚲
Lemmy: è stata la piattaforma che ha dato l’impressione di essere più equilibrata, con una netta separazione tra open e closed. Sul lato open: raffica di MiniMax-H3 nella community !stable_diffusion e il nuovo modello Boogu-Image-0.1 (Apache-2.0, 10 miliardi di parametri). Sul lato closed: Google Nano Banana 2 Lite, Microsoft MAI-Image-2.5, esperimenti di storie lunghe con Sora 2 e la sorprendente notizia del “pivot verso le spa mediche” di Midjourney 😲 Anche la presenza della community anti-IA !fuck_ai (8.252 membri) è una scoperta tipica di Lemmy.
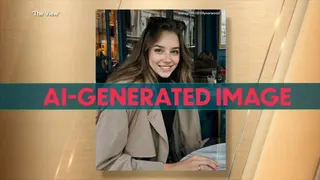
Pinterest: verificate direttamente, incluse le immagini, 30 delle 50 pin raccolte in precedenza. Mentre proliferano elenchi di strumenti closed-source e template riutilizzati per miniature “AI NEWS”, l’open source è quasi del tutto assente: c’è solo un riferimento ad Amuse 3.0, uno strumento locale. Spiccano il riuso frequente dei filmati Google Veo e l’affermazione dei quiz di autenticità “è IA o è reale?” come genere a sé 🎨
What to watch
- Rapida crescita degli strumenti ComfyUI per MiniMax-H3 (Lemmy
!stable_diffusion, esempio: https://github.com/nazgut/ComfyUI-MiniMaxH3-CLSS) — possibile nuovo protagonista dell’open-source video 🔥 - Il problema della “production memory” di Sora 2 (Reddit via Lemmy, https://lemmy.durstig.online/post/59922) — mantenere la coerenza nelle opere lunghe, più che creare singole clip, sembra essere il prossimo ostacolo
- La teoria del dominio di Google Nano Banana Pro (YouTube, Theo - t3.gg, https://www.youtube.com/watch?v=UV9GqinedQ8) — davvero a un livello da rendere Photoshop superfluo? In attesa di ulteriori sviluppi
- La disputa GPT Image 2.5 Flare vs Krea2 open-source (Reddit, https://www.reddit.com/r/ImagineAiArt/comments/1wi79wi/) — si comincia a mettere in dubbio il vantaggio stesso delle versioni a pagamento
- L’ammissione delle opere IA ad ArtPrize (Reddit r/grandrapids, https://www.reddit.com/r/grandrapids/comments/1wi4ub0/) — potrebbe diventare un indicatore della soglia di accettazione nella società generale
- Il passaggio di Midjourney alle spa mediche e le richieste di disclosure a Hollywood (Lemmy, https://lemmy.zip/post/66397234 、https://lemmy.today/post/56011946) — stanno emergendo rischi per l’affidabilità aziendale
Recommendations
- Raccogliere nuovamente i dati della fase X usando query direttamente pertinenti come "Sora 2" "Midjourney" "Stable Diffusion" "Runway Gen" "Kling AI" "open source image generation".
- Inserire a ogni ciclo nella watchlist la frequenza di rilascio dei modelli open-source cinesi MiniMax-H3, Qwen, Wan e Z-Image.
- Continuare a seguire le reazioni nelle community generaliste e professionali, oltre che nei subreddit specialistici sull’IA, poiché i segnali di reazione negativa sono forti.
- Verificare entro la prossima analisi soluzioni alternative al problema 403 dell’API ufficiale di ricerca Bluesky.
- Seguire anche nel prossimo run gli sviluppi sul problema della “production memory” di Sora 2 e sul passaggio di Midjourney alle spa mediche.
- Raccogliere i contenuti Pinterest con tag di genere, così da classificare automaticamente open e closed source.
Data quality
La fase X non ha fornito dati utilizzabili: le query di ricerca erano irrilevanti rispetto al tema, come geopolitica, criptovalute e calcio, e nessuno dei 40 post raccolti era pertinente. Reddit (12 elementi) e Bluesky (circa 12 estratti tramite account personali perché l’API di ricerca era bloccata) non hanno raggiunto il criterio di completamento del brief di circa 20 post per piattaforma. Anche Pinterest e YouTube avevano limitazioni: Pinterest non aveva tag di genere né browsing live, mentre YouTube non consentiva di recuperare visualizzazioni e iscritti a causa della dipendenza da JavaScript. Tuttavia, le informazioni ottenute sono sufficienti per le conclusioni principali. Lemmy e YouTube sono stati relativamente solidi e hanno fornito osservazioni concrete sia sul closed sia sull’open source.
Riepilogo per piattaforma
Reddit — Notizie sull’IA per la generazione di immagini e video
Dove
Le 12 discussioni raccolte provengono da 9 subreddit.
| Subreddit | Membri | Discussioni raccolte |
|---|---|---|
| r/generativeAI | 154,961 | 4 |
| r/graphic_design | 2,929,382 | 1 |
| r/GeminiAI | 375,783 | 1 |
| r/grandrapids | 161,719 | 1 |
| r/aitubers | 28,785 | 1 |
| r/ImagineAiArt | 19,335 | 1 |
| r/AIToolTalks | 6,757 | 1 |
| r/aifilmmaking | 8,200 | 1 |
| r/aivideomaking | 7,267 | 1 |
r/generativeAI è l’hub centrale dedicato direttamente alla generazione IA di immagini e video (4 elementi). r/GeminiAI e r/ImagineAiArt raccolgono esperienze con modelli closed-source; r/aifilmmaking e r/aivideomaking hanno una prospettiva pratica sulla produzione video; r/grandrapids e r/graphic_design mostrano le reazioni quando i contenuti IA incontrano il mondo reale, come concorsi artistici e luoghi di lavoro; r/AIToolTalks funge da valvola di sfogo per l’ansia sull’IA in generale.
Cosa dicono le persone
- Discussione 1 “Which AI video generator can still be used for free?” (r/generativeAI・18pt・57 commenti・2026-09-16) https://www.reddit.com/r/generativeAI/comments/1whtesl/ — la generazione open-source/locale (Wan, Minimax) è un rifugio dopo l’esaurimento delle quote gratuite closed-source. u/RioMetal: “If you can go local you have plenty of them, like Wan or Minimax”
- Discussione 2 “GPT Image 2.5 Flare — is this actually the best AI image generating model right now?” (r/ImagineAiArt・84pt・60 commenti・2026-09-16) https://www.reddit.com/r/ImagineAiArt/comments/1wi79wi/ — opinioni spaccate. u/oldboi777 lo celebra come “incredible upgrade”, mentre u/SeaworthinessFresh16 osserva: “The result in Comfyui with Krea2 looks the same”.
- Discussione 12 “Need a good video generation AI for image to video of people” (r/generativeAI・0pt・22 commenti・2026-09-15) https://www.reddit.com/r/generativeAI/comments/1wh1y9d/ — il tema centrale è l’insoddisfazione per i filtri di censura dei modelli closed-source Google Flow / Nano Banana Pro. u/f5alcon: “Minimax H3 is the best local generator”; u/jworm0624: “Krea 2 turbo for images, minimax h3 for videos. All on comfyui”, con i modelli open-source consigliati come alternative.
- Discussione 7 “Google Flow is giving creators a surprisingly generous amount of free AI video generation right now” (r/aifilmmaking・8pt・7 commenti・2026-09-14) https://www.reddit.com/r/aifilmmaking/comments/1wg7izt/ — Google Flow/Veo, closed source, ha ampliato i crediti gratuiti ed evolve da semplice generazione testo-video a spazio di lavoro creativo con costruzione di scene, controllo della camera e riferimenti ai materiali. C’è però anche una lettura fredda di u/MrBoondoggles: “I'm not surprised Google is giving away Veo at this point... trying to maintain some interest in their product”.
- Discussione 8 “Did Anyone Notice Sudden Quality Drop of Image Generation? From 2 MB to 500 KB” (r/GeminiAI・10pt・25 commenti・2026-09-17) https://www.reddit.com/r/GeminiAI/comments/1wj02p4/ — vengono segnalati cali di qualità in Gemini, closed source, da PNG a JPEG e da 8MB a 2MB a 500KB, con lamentele anche da utenti dei piani a pagamento. u/Well_HellooF: “there's no difference in quality between the free version and the paid one. suck”
- Discussione 5 “ArtPrize Allows Generative AI” (r/grandrapids・354pt・176 commenti・2026-09-16) https://www.reddit.com/r/grandrapids/comments/1wi4ub0/ — forte reazione negativa all’accettazione di opere generate dall’IA in un concorso artistico. u/Chirotera(319pt): “Fucking disgusting. It is not AI "Art," it's fucking theft.” La rabbia nelle community generaliste supera quella dei subreddit tecnici.
- Discussione 10 “Company expects us to generate 500 AI images PER WEEK. Is this realistic?” (r/graphic_design・63pt・133 commenti・2026-09-17) https://www.reddit.com/r/graphic_design/comments/1wieke2/ — designer sul campo esasperati da obiettivi di produzione di massa con strumenti closed-source come ChatGPT. u/Diligent-Educator409(123pt): “500 AI images? Yes. 500 good AI images? No. 1 good AI image? Also no.”
- Discussione 9 “best apps for generating AI videos” (r/aitubers・0pt・46 commenti・2026-09-14) https://www.reddit.com/r/aitubers/comments/1wg3duk/ — c’è domanda di strumenti closed-source che generano automaticamente video da una sceneggiatura, come InVideo AI e Steve AI, ma la community è fredda. u/RobJames007(15pt): “Youtube is trying to reduce AI slop, not allow more of it onto the platform.”
- Discussione 3 “Please help me generate free ai video without subscription” (r/aivideomaking・0pt・20 commenti・2026-09-15) https://www.reddit.com/r/aivideomaking/comments/1wh80z3/ — u/Chance-Business: “google flow you get 50 free credits per day, each vid is 6-12 credits”; u/Bastisheen92: “Local Generation is free if you already own the Hardware”. Riproposizione del contrasto classico tra quote gratuite closed-source e uso locale open-source.
- Discussione 11 “Are all of you also anxious about recent news about AI?” (r/AIToolTalks・12pt・36 commenti・2026-09-13) https://www.reddit.com/r/AIToolTalks/comments/1wfhbnv/ — non parla direttamente della generazione di immagini o video, ma delle preoccupazioni sull’IA in generale: consumo idrico, perdita di lavoro e regolamentazione. I commenti sono polarizzati: u/Big-Pops78 relativizza le preoccupazioni idriche, mentre u/UnburyingBeetle risponde con ironia al termine “cost efficiency”.
Segnali
- In crescita: nomi di modelli open-source/locali come Wan, Minimax H3, LTX Video e Krea2 sono ricorrenti in più discussioni indipendenti (1, 2, 12), nel medesimo contesto di alternativa dopo l’esaurimento delle quote gratuite closed-source. La generazione locale sta diventando sinonimo di “alta qualità gratis”.
- Sminuiti o derisi: è forte il cinismo verso i servizi di generazione video che proclamano di essere gratuiti. In più discussioni (1, 4, 6, 12), l’account bot u/Jenna_AI ha pubblicato commenti sarcastici simili, sostenendo che promettono gratuità ma finiscono per chiedere pagamento; un segnale del tono cinico della community.
- Aspetto sorprendente: rispetto ai subreddit tecnici, le community generaliste (r/grandrapids, 354pt・176 commenti) e professionali (r/graphic_design, 63pt・133 commenti) hanno punteggi e coinvolgimento più alti di quelli dedicati all’IA, spesso a una cifra o poche decine di punti. Reazioni e dibattiti crescono quando i contenuti IA entrano nella vita quotidiana e nel lavoro.
- Conflitto di opinioni: nella discussione 2, GPT Image 2.5 Flare è giudicato “incredible upgrade” da u/oldboi777 e “lo stesso risultato di Krea2” da u/SeaworthinessFresh16. Anche per Google Flow/Veo nella discussione 7 convivono l’apprezzamento per crediti gratuiti generosi e la critica di u/Sea-Temporary-6995: “it's weak at physics and logic. Even Minimax is far better”.
Limiti
- Le discussioni raccolte sono 12, meno del criterio di completamento del brief, circa 20 post analizzati per piattaforma. I 12 elementi forniti dal worker sono tutti i dati Reddit disponibili in questa fase; ulteriori ricerche o consultazioni non sono possibili secondo il playbook.
- È stata usata soltanto la query inglese “Image and Video Generation AI News”; non risultano tentativi con query in giapponese o query mirate come “open source” e “closed source”.
- Alcuni subreddit, tra cui r/aitubers, r/aivideomaking e r/AIToolTalks, sono rappresentati da una sola discussione, quindi non è possibile valutarne la tendenza interna.
X
X — Notizie sull’IA per immagini e video (closed/open source)
Account
I 39 account e 40 post raccolti in output/x.posts.md sono tutti irrilevanti rispetto all’IA per immagini/video. Le query “Greenland” “Denmark” “#Bitcoin” “NATO” “Christ” “Jubjub” “Charles” “Bosnia” “Chelsea” “Belgrade” erano semplici trend Explore di X, geolocalizzati in base alla provenienza della connessione attorno alla Croazia, e non includevano alcuna query legata al brief di ricerca sull’IA generativa di immagini e video.
Di conseguenza, nei dati raccolti non c’è alcun account che permetta di rispondere alla domanda su chi stia guidando questo tema su X. Ecco invece cosa è stato raccolto:
- Cluster politico/geopolitico: @RapidResponse47 (30.291 like, relativo alla Groenlandia), @AJENews, @Rusia_HD, @Globalsurv, @NepCorres e altri, con post su Groenlandia, Danimarca e NATO.
- Cluster criptovalute: @aacryptoverse, @Bitcoin_Pirate_, @StackandRun, @bitcr_org e altri, con post etichettati #Bitcoin, tutti di piccola scala, con da poche a poche decine di like.
- Cluster gossip reale: @barristerlawusa, @hernandez_64876, @thebluestshade, @Rimmesfk, dove “Charles” riguarda il libro di rivelazioni di Charles Spencer.
- Cluster calcio: @icunga_, @john322226, @Cfc_Kemboi, @Pats_Aura, dove “Chelsea” si riferisce ai risultati del Chelsea FC.
- Cluster meme/conversazione: @SardineKing_O, @isellbeforeyou, @0xHeatt, con il meme coin “$jubjub”, e @MarquiseDeBelgr, con due post colloquiali in serbo.
Ogni account compare con uno o due post e nessuno pubblica in modo particolarmente intenso. Il post di @RapidResponse47, con 30 mila like e circa 6,8 milioni di visualizzazioni, è di gran lunga il più grande del gruppo, ma riguarda l’appartenenza della Groenlandia e non il tema dell’analisi.
Post
Tra i 40 post raccolti, 0 menzionano l’IA per la generazione di immagini o video, closed-source o open-source. Non è quindi possibile presentare un post rappresentativo. A titolo puramente indicativo, e dichiarando che è fuori tema, ecco il post con il maggiore coinvolgimento:
- @RapidResponse47 (fuori tema・riferimento) — 30,291 likes・5,022 reposts・1,164 replies・circa 6,800,000 views・2026-09-18. https://x.com/RapidResponse47/status/2101059494587285834 — trovato cercando “Greenland”. È un post politico sull’appartenenza della Groenlandia e non ha alcuna relazione con immagini o video IA.
Segnali
- In questa fase X non è stata trovata alcuna menzione, discussione o notizia su IA per immagini/video, inclusi Midjourney, Sora, Runway, Stable Diffusion, Flux, Wan o Kling. Non esiste materiale su cui valutare se qualcosa sia o non sia popolare.
- Le query utilizzate — Greenland, Denmark, #Bitcoin, NATO, Christ, Jubjub, Charles, Bosnia, Chelsea, Belgrade — corrispondono esattamente alle intestazioni della “X's own Explore list” all’inizio di
output/x.posts.md. Sembra quindi che siano stati cercati soltanto trend generali, geopolitica, gossip reale, calcio e meme crypto della zona di connessione, senza mai usare query tematiche come image generation AI, video generation AI, Sora, Midjourney, Stable Diffusion o open source AI. - Questa fase non consente pertanto di estrarre neppure un’osservazione sulle tendenze closed-source o open-source.
Limiti
- La raccolta non corrisponde al tema. Nessuna delle 10 query in
output/x.posts.mdriguarda l’IA per immagini/video; ripercorrono invece trend Explore di geopolitica, gossip reale, calcio e meme crypto. Il worker non ha mai eseguito una ricerca sul tema del brief, quindi il criterio di completamento di circa 20 post pertinenti non è stato raggiunto. - Sono stati analizzati 40 post, ma nessuno parla di IA per immagini/video.
- Anche
output/x.posts.jsoncontiene gli stessi dati e non offriva ulteriori indizi. - L’unica conclusione possibile è che le query e i post raccolti non permettono di riportare alcuna tendenza X sull’IA generativa di immagini/video, né closed né open source. È necessaria una nuova raccolta con query pertinenti, ad esempio “Sora 2”, “Midjourney”, “Stable Diffusion”, “Runway Gen”, “Kling AI”, “Flux” o “open source image generation”.
YouTube
YouTube — Tendenze recenti nell’IA per immagini e video (closed/open source)
Canali
Orientati al closed source
- Theo - t3.gg(@t3dotgg)— analisi tecnica di Google Nano Banana Pro
- Astrovah(@astrovah)— recensioni e casi d’uso di Sora 2
- Woollyfern(@woollyferncreative)— canale specializzato negli aggiornamenti mensili di Midjourney
- FixNode(@Fixnode1)— tutorial su Runway Gen-4.5
- Higher E-Learning(@higherelearning)— valutazioni dei modelli integrati in Adobe Firefly
- AIPOD-CAST(@AIPOD-CAST)— rassegna settimanale di notizie IA, episodi nella serie 220
- Lev Selector(@lev-selector)— rassegna settimanale di aggiornamenti IA
Orientati all’open source
- Bijan Bowen(@Bijanbowen)— test locali di Qwen Image
- HitPaw Edimakor(@HitPawEdimakorOfficial)— recensioni e guide sulla serie Wan
- MaxonShire(@MaxonShire)— confronti tra modelli video open source
- Promptus AI(@promptusai)— guide all’installazione locale di nuovi modelli, tra cui Z-Image
- 黎黎原上啃 / SweetValberry(@SweetValberry)— spiegazioni in lingua cinese, tra cui FLUX.1 Kontext
Non è stato possibile ottenere il numero di iscritti da nessuna pagina canale, come spiegato nei Limiti, dunque la portata dei canali non è verificabile.
Video
-
“Google won image generation (it's not even close) NANO BANANA PRO BREAKDOWN” — Theo - t3.gg/data di pubblicazione sconosciuta (Nano Banana Pro è stato annunciato il 20 novembre 2025, quindi il video è successivo)/visualizzazioni sconosciute
https://www.youtube.com/watch?v=UV9GqinedQ8
Sostiene che la qualità di generazione immagini di Nano Banana Pro, basato su Gemini 3 Pro, sia a un livello da non rendere necessario Photoshop e svetti persino tra i modelli closed-source. -
“Sora 2 - An Honest Review As Well As 20 Creative Use Cases To Try” — Astrovah/7 ottobre 2025/visualizzazioni sconosciute
https://www.youtube.com/watch?v=pJHWIgri5vk
Valuta Sora 2 come “il video IA più realistico mai visto” e presenta 20 possibili usi professionali. -
“Midjourney Update | July 2026: V8.2 is HERE! Personalization, NIJI Style Creator, and More!” — Woollyfern/luglio 2026/visualizzazioni sconosciute
https://www.youtube.com/watch?v=dvfH5HzCARY
Spiega che Midjourney V8.2 ha aggiunto la personalizzazione e uno style creator per NIJI. È l’episodio più recente di una serie mensile. -
“I Tested Every AI Video Model in Adobe Firefly So You Don't Have To (July 2026)” — Higher E-Learning/luglio 2026/visualizzazioni sconosciute
https://www.youtube.com/watch?v=nOSYufWVdq8
Con l’integrazione in Adobe Firefly di Veo 3.1, Kling 3.0, Runway Gen-4.5 e Sora 2, il video mette tutti i modelli a confronto diretto. -
“Ultimate Runway Gen 4.5 Tutorial For New Users in 2026” — FixNode/29 marzo 2026/visualizzazioni sconosciute
https://www.youtube.com/watch?v=IUge3u4ZrqQ
Tutorial sulla generazione immagine→video con Runway Gen-4.5, con enfasi sulla resa cinematografica. -
“Episode 222: Weekly AI News Summary - 6 September 2026” — AIPOD-CAST/6 settembre 2026/visualizzazioni sconosciute
https://www.youtube.com/watch?v=8f34nSLdNtk
Una rassegna settimanale trasversale su modelli, agenti e business che include anche notizie sull’IA per immagini/video. -
“Exciting AI Updates Weekly - September 18, 2026” — Lev Selector/18 settembre 2026/visualizzazioni sconosciute
https://www.youtube.com/watch?v=Utu4zIcqPtM
Un canale personale riassume rapidamente gli aggiornamenti IA della settimana precedente. È il contenuto più recente nell’ambito di questa ricerca. -
“Qwen Image-2512 First Test – The BEST Open Source Image Model!” — Bijan Bowen/data di pubblicazione sconosciuta (il modello è la versione di dicembre 2025)/visualizzazioni sconosciute
https://www.youtube.com/watch?v=SBaK616nP6Q
Testa localmente Qwen-Image-2512 di Alibaba, con 20 miliardi di parametri, e lo valuta come “il miglior modello open-source per immagini al momento”. -
“Wan 2.6 Review | How to Use Wan 2.6 for Free | New AI Video Generator Tutorial” — HitPaw Edimakor/data di pubblicazione sconosciuta (modello rilasciato nel dicembre 2025)/visualizzazioni sconosciute
https://www.youtube.com/watch?v=6FMisTHYYgA
Recensione e guida gratuita ad Alibaba Wan 2.6, con riferimento a più modalità, tra cui T2V/I2V/R2V. -
“HunyuanVideo 1.5 vs Wan 2.7 Comparison: Which is The Best Free Local Video AI Generation Model?” — MaxonShire/25 giugno 2026/visualizzazioni sconosciute
https://www.youtube.com/watch?v=4GNT4-QYekg
Confronto diretto fra Tencent HunyuanVideo 1.5 e Alibaba Wan 2.7, rilasciato il 22 aprile 2026, due importanti modelli video gratuiti locali. -
“Z-Image Open-Source Image Generator: Free Online and Local Setup” — Promptus AI/2026 (periodo sconosciuto)/visualizzazioni sconosciute
https://www.youtube.com/watch?v=JF4Q5hXh-_Q
Presenta Z-Image di Alibaba, 6 miliardi di parametri e architettura S3-DiT, come modello leggero con qualità superiore a Flux 2 e Qwen Image; spiega inoltre l’integrazione con ComfyUI. -
“FLUX.1 Kontext [dev] is open source! Try image editing locally in ComfyUI” — 黎黎原上啃/2025 (subito dopo la pubblicazione di Flux Kontext Dev)/visualizzazioni sconosciute
https://www.youtube.com/watch?v=v4pp3TdbWNw
Dopo la pubblicazione dei pesi del modello Flux Kontext Dev di Black Forest Labs, mostra l’editing locale delle immagini in ComfyUI. È un po’ datato, ma incluso per comprendere il punto d’origine della linea di sviluppo dell’editing immagini open-source.
Segnali
- Il closed source ha trasformato gli aggiornamenti mensili in una routine: la serie “Update” di Midjourney di Woollyfern pubblica aggiornamenti ogni mese e nel 2026 passa costantemente da V8 a V8.1 e V8.2. Anche Runway e Adobe Firefly ricevono ampie recensioni immediate dai canali tech dopo grandi aggiornamenti ogni pochi mesi.
- La sincronizzazione audio sta diventando una funzione standard per i video closed-source: Kling 3.0, con dialogo nativo in cinque lingue; Seedance 2.0, che riproduce persino la riverberazione con un’architettura audio-video integrata; Grok Imagine 1.5, che genera insieme dialoghi e suoni ambientali. Molti risultati sottolineano una progettazione che genera insieme suono e immagini: la competizione si sposta dalle clip singole alla creazione di cortometraggi con audio.
- La velocità di rilascio dell’open source, soprattutto cinese, eguaglia o supera il closed source: soltanto nella famiglia Alibaba, Qwen-Image→Qwen-Image-2512→Z-Image e Wan 2.5→2.6→2.7 sono stati aggiornati in rapida successione. Tencent HunyuanVideo 1.5 e LTX-2→2.3→2.5 di Lightricks evolvono anch’essi quasi mensilmente o trimestralmente. Nei titoli dei video ricorrono frasi come “miglior open source” e “sconfigge X”, indice di forte interesse del pubblico.
- La maggior parte dei contenuti sui video open-source punta su “ComfyUI”, “esecuzione locale” e “gratis”: canali come HitPaw Edimacor, Promptus AI e MaxonShire mettono in primo piano il modo di usarli gratis e su GPU locale, in contrasto con i canali closed-source, quali Theo, Astrovah e Woollyfern, più concentrati su qualità e funzioni.
- I canali in formato rassegna settimanale, AIPOD-CAST e Lev Selector, trattano l’IA per immagini/video come segmento regolare, segno che non è considerata più una notizia isolata ma un ambito da monitorare continuamente.
Limiti
- La pagina di ricerca YouTube (
https://www.youtube.com/results?search_query=…) viene renderizzata dinamicamente con JavaScript. Recuperandola via WebFetch si ottengono solo collegamenti di navigazione del footer, perciò il metodo previsto dal playbook, leggere titolo, canale, visualizzazioni e data dall’HTML, non ha funzionato. - Come alternativa sono stati trovati i video con ricerca web normale, tramite query
site:youtube.com, e sono stati verificati titolo e canale attraverso l’endpointoembeddi YouTube. Questo metodo non consente di ottenere né visualizzazioni né iscritti, perciò questi dati sono indicati come sconosciuti senza fare stime. - Per la stessa ragione, per alcuni video non è possibile verificare la data precisa di pubblicazione: l’analisi di Nano Banana Pro, il test di Qwen Image-2512, la recensione Wan 2.6 e la presentazione di Z-Image. È stato riportato soltanto un periodo approssimativo basato su snippet del motore di ricerca e sulle date di rilascio dei modelli.
- Non è stato possibile leggere direttamente descrizioni né commenti principali dei video, sempre per la dipendenza da JavaScript.
- Sono stati privilegiati i post entro 60 giorni, dal 22 luglio 2026 in poi, ma sono stati inclusi come contesto uno o due video fuori periodo, come Flux Kontext e il tutorial Runway Gen-4.5, importanti per comprendere la genealogia di open e closed source.
Bluesky
Bluesky — Tendenze recenti nell’IA per immagini e video
Account
- Simon Willison (@simonwillison.net) — ricercatore IA indipendente. Ogni volta che esce un nuovo modello multimodale, ne testa la generazione immagini con il proprio benchmark del “pellicano in bicicletta”. Circa 50 mila follower e alta frequenza di pubblicazione.
- Max Woolf (@minimaxir.bsky.social) — ex data scientist di BuzzFeed. Esperto di etica e R&D nella generazione di contenuti IA, pubblica spesso reazioni a nuovi modelli di generazione immagini.
- Ethan Mollick (@emollick.bsky.social) — professore alla Wharton. Nel trattare le tendenze dell’IA in generale, commenta anche l’evoluzione qualitativa della generazione video.
- Replicate (@replicate.com) — account ufficiale del servizio di hosting di modelli. Annuncia i nuovi modelli closed-source per immagini e video quando vengono aggiunti alla propria piattaforma.
- Stability AI (@stabilityai.bsky.social) — account ufficiale dello sviluppatore di Stable Diffusion. Tuttavia, i post più recenti riguardano soprattutto Stable Audio e API aziendali di editing immagini; non pubblica dal 19 novembre 2025.
- Stable Diffusion online AI (@stablediffusion.bsky.social) — account di condivisione prompt e raccolta di IA art per SDXL/ComfyUI, circa 1.800 follower. Inattivo dal 24 febbraio 2025.
- AI Art News (@ai-art-news.bsky.social) — account di curation delle notizie sull’arte IA. Nessun post dal 18 settembre 2025.
Post
-
Simon Willison (2026-09-19) — nel contesto di un post in cui ha fatto generare a GPT-6 Astra e Claude Fable 5.1 modelli 3D per Blender usando dati cartografici, presenta un workflow da generazione immagini a conversione 3D. 57 like・5 repost.
https://bsky.app/profile/simonwillison.net/post/3mv4su6pfzk24 -
Simon Willison (2026-09-05) — test in cui GPT-6 Astra rende in Blender una scena con un pellicano in bicicletta. 405 like・30 repost.
https://bsky.app/profile/simonwillison.net/post/3murtmdynq22s -
Simon Willison (2026-09-04) — griglia comparativa del benchmark “pellicano in bicicletta” fra GPT-6 Astra e GPT-5.6 Sol/Terra/Luna. 206 like・9 repost.
https://bsky.app/profile/simonwillison.net/post/3mupxubgrls2c -
Simon Willison (2026-09-02) — genera la migliore immagine SVG di sempre di un pellicano con Claude Fable 5.1, livello di ragionamento Max e costo di $3.30 per esecuzione, quindi la anima. 362 like・22 repost.
https://bsky.app/profile/simonwillison.net/post/3muimzxo2sk2g -
Max Woolf (2026-09-19) — osserva che, facendo creare a un’IA un’immagine vettoriale di un pellicano in bicicletta, il modello non comprendeva la relazione tra gambe e pedali. 1 like.
https://bsky.app/profile/minimaxir.bsky.social/post/3mvtt3uxdrk2c -
Max Woolf (2026-09-08) — dopo l’annuncio del nuovo modello di immagini OpenAI, commenta che è stato bene rimandare il suo articolo riassuntivo su ChatGPT Images 2.0, perché il nuovo annuncio, riferito a ChatGPT Images 2.5, sembra più importante. 4 like.
https://bsky.app/profile/minimaxir.bsky.social/post/3muzq6mcadk2n -
Ethan Mollick (2026-09-19) — segnala che, nel diluvio di contenuti IA di massa e bassa qualità, iniziano a comparire anche opere video IA davvero interessanti. 58 like・7 repost.
https://bsky.app/profile/emollick.bsky.social/post/3mvuss476oc2b -
Replicate (2026-04-21) — annuncia l’arrivo di GPT Image 2 di OpenAI su Replicate, sottolineando realismo, rendering del testo e rispetto del layout. 5 like.
https://bsky.app/profile/replicate.com/post/3mjzygaefs224 -
Replicate (2026-04-09) — annuncia la disponibilità per tutti di Seedance 2.0 di ByteDance: integra testo, immagini, video e audio, con audio stereo sincronizzato e fisica realistica. 2 like・1 repost.
https://bsky.app/profile/replicate.com/post/3mj3junhvnh26 -
Replicate (2026-02-18) — annuncia Runway Gen-4.5, generazione video cinematografica caratterizzata da accuratezza fisica e realismo. 2 like.
https://bsky.app/profile/replicate.com/post/3mf5fbf6u4l2c -
Replicate (2026-02-17) — aggiunge Kling 3.0 e Kling o3 di Kuaishou: generazione 4K multi-shot, audio sincronizzato, editing video e trasferimento di stile. 2 like.
https://bsky.app/profile/replicate.com/post/3mf35lkhoyw2q -
Replicate (2026-03-11) — aggiunge Vidu Q3 di Shengshu: fino a 16 secondi, 1080p, generazione video con audio sincronizzato da testo, immagine o frame iniziale e finale. 1 like.
https://bsky.app/profile/replicate.com/post/3mgsan3ddpl2w
Segnali
- Predominio closed-source: quasi tutti i post trovati su questo tema riguardano grandi modelli closed-source, tra cui OpenAI, GPT Image 2 / ChatGPT Images 2.5, Runway Gen-4.5, Kling 3.0, Seedance 2.0 e Vidu Q3. Non sono post organici virali, ma annunci di nuovi modelli da parte di un host come Replicate o test di ricercatori IA indipendenti come Simon Willison e Max Woolf.
- L’open source è quasi assente: non sono stati trovati account attivi che pubblichino su Flux, Stable Diffusion, Qwen-Image, Wan o workflow ComfyUI. L’unico account di community plausibile, stablediffusion.bsky.social, è inattivo dal febbraio 2025. Anche Stability AI è silenziosa dal novembre 2025 e i post più recenti riguardavano Stable Audio e API aziendali, non Stable Diffusion per immagini.
- “Il pellicano in bicicletta” è diventato un benchmark de facto: diversi osservatori IA indipendenti confrontano la qualità della generazione immagini dei nuovi modelli multimodali, quali GPT-6 Astra e Claude Fable 5.1, con lo stesso prompt. È una tendenza interna peculiare di Bluesky, diventata un indicatore comune non ufficiale della capacità dei modelli.
- Assenza di account aziendali ufficiali: gli handle attesi di brand principali, tra cui OpenAI, Midjourney, Runway ML, Black Forest Labs, Hugging Face, Civitai e ComfyUI, non esistono oppure sono account inutilizzati senza post. Bluesky non funziona quindi come canale di annuncio primario per queste aziende: le notizie circolano solo tramite ricercatori individuali o piattaforme intermediarie come Replicate.
- Cambiamento della valutazione dei video generati: il post di Ethan Mollick suggerisce una crescente percezione che, nel mezzo dello “slop” video IA prodotto in massa, stiano iniziando a emergere opere di qualità autentica. Rimane però un commento generale, non riferito a uno specifico modello video open-source.
Limiti
- L’API ufficiale di ricerca Bluesky (
https://public.api.bsky.app/xrpc/app.bsky.feed.searchPosts) ha restituito sempre HTTP 403 Forbidden, indipendentemente dalla keyword e anche attraverso due proxy CORS. Anche l’interfaccia Webhttps://bsky.app/search?q=...è una SPA renderizzata lato client e WebFetch non ne ha potuto leggere il contenuto. - È stato quindi usato il metodo alternativo, basato sugli endpoint accessibili senza autenticazione
app.bsky.actor.getProfileeapp.bsky.feed.getAuthorFeed, recuperando i feed degli account trovati tramite WebSearch o deduzione. Il risultato non è una ricerca per keyword sull’intera rete Bluesky, ma è limitato ai post degli account individuati. - Gli account ufficiali dei brand principali, incluse alcune sezioni di OpenAI, Midjourney, Runway ML, Black Forest Labs, Hugging Face, Civitai, ComfyUI e Stability AI, erano inutilizzati o silenziosi, quindi non è stato possibile recuperare notizie direttamente da loro.
- Per la limitazione della ricerca, non è stato possibile soddisfare in modo chiaro il criterio del brief di circa 20 post tematicamente pertinenti. Dopo aver letto oltre 100 post da 7 account, sono stati selezionati i 12 direttamente rilevanti.
- Le immagini e i video non sono stati visualizzati o verificati; la fonte informativa è solo la descrizione testuale dei post.
Lemmy
Lemmy — Tendenze recenti dell’IA per immagini e video (closed/open source)
Community
- !«メールアドレス» — 5,712 iscritti, di cui 893 locali; 1,407 post e 1,927 commenti. Tratta in generale modelli open-weight per immagini e video. Con 10 utenti attivi giornalieri e 66 mensili ha dimensioni ridotte, ma aggiornamenti frequenti.
- !«メールアドレス» — 2,362 iscritti; 24 attivi giornalieri/114 settimanali/344 mensili. Luogo per opere create con modelli open-weight della famiglia Stable Diffusion, prevalentemente link diretti a immagini civitai.
- !«メールアドレス»(nome della community
share_anime_art, nome visualizzato “Stable Diffusion Anime”)— 1,598 iscritti, di cui 206 locali. Community SFW per illustrazioni anime generate dall’IA. - !«メールアドレス» — 8,252 iscritti, di cui 3,027 locali, e 9,179 utenti attivi mensili: la più grande tra quelle esaminate. Si definisce “a place for all those who loathe AI”; è una community anti-IA incentrata soprattutto su critica e sarcasmo verso l’IA in generale, più che sulla generazione di immagini/video.
- !«メールアドレス» — appena 52 iscritti, ma fa da mirror RSS di discussioni Reddit come r/ArtificialInteligence e riceve spesso argomenti sull’IA per immagini/video. 725 utenti attivi su sei mesi.
- !«メールアドレス»・!«メールアドレス»・!«メールアドレス» — community tech generiche dove circolavano grandi notizie su Midjourney.
Post
- Forte aumento degli strumenti ComfyUI per MiniMax-H3 a settembre(open source)— in
!«メールアドレス»sono stati trovati almeno 15 post di strumenti per MiniMax-H3, modello video, dal 2026-09-01 al 2026-09-16. Esempi:- “ComfyUI-MiniMaxH3-CLSS” — generazione di video con audio di lunghezza arbitraria con 16GB di VRAM consumer (score 0, 2026-09-01) https://github.com/nazgut/ComfyUI-MiniMaxH3-CLSS
- “H3-World” — si presenta come il “primo modello del mondo interattivo” basato su MiniMax-H3 (score 3, 2026-09-02) https://huggingface.co/DANNY621/H3-World
- “ComfyUI-VDN-H3-24GB” — implementazione con attenzione ibrida per GPU da 24GB (score 6, 2026-09-12) https://github.com/Speach1sdef178/ComfyUI-VDN-H3-24GB
- “MiniMax-H3-Image-Training-Adapter” (Circlestone Labs, score 5, 2026-09-12) https://huggingface.co/circlestone-labs/MiniMax-H3-Image-Training-Adapter
- Boogu-Image-0.1 — nuova base open per immagini da un laboratorio legato a Huawei(open source)—
!«メールアドレス», score 5, 2026-06-17. Licenza Apache-2.0, 10 miliardi di parametri e cinque varianti: Base/Turbo da 3-4 step/FP8/Edit. Punta sul rendering di testo bilingue cinese-inglese. https://boogu.org/ - Articolo di verifica tecnica su Seedream 5.0 Pro, modello closed di ByteDance(closed source)— tramite
!«メールアドレス», score 1, 2026-07-10. Post di confronto e analisi tecnica. https://www.reddit.com/gallery/1usc03q - Annuncio Google “Nano Banana 2 Lite”(closed source)— mirror Hacker News, score 1, 2026-06-30, con link alla pagina ufficiale DeepMind. In parallelo è circolato un post di un media tech svizzero in tedesco, score 0, swisstechnews, 2026-07-02. https://deepmind.google/models/gemini-image/flash-lite/
- Microsoft MAI-Image-2.5 si avvicina a Nano Banana 2 nei benchmark(closed source)—
!«メールアドレス», score 1, 2026-05-28. Un post sulla competizione tra Google e Microsoft nei modelli per immagini. https://www.reddit.com/r/ArtificialInteligence/comments/1tpu2cd/ - Resoconto sperimentale su una storia lunga realizzata con Sora 2(closed source)—
!«メールアドレス», score 1, 2026-09-13. L’autore ha iniziato a usare Sora 2 circa un mese dopo il rilascio e ha prodotto sette video di un’ora. L’osservazione chiave: creare belle clip singole non è difficile; la difficoltà reale è la “production memory”, ossia mantenere coerenza. https://lemmy.durstig.online/post/59922(Reddit originale: https://www.reddit.com/r/ArtificialInteligence/comments/1wfabp9/) - Notizia reale del forte pivot di Midjourney da generazione immagini IA a spa medica(closed source/dinamiche aziendali)—
!«メールアドレス», articolo di The Register e crosspost su lemmy.zip, score 58-66, 2026-06-18. La società si sarebbe spostata verso un’attività spa con scansione corporea totale chiamata “Golden Light”, con tecnologia di base presa in prestito da un partner; i commenti la paragonavano sarcasticamente a Theranos. https://lemmy.zip/post/66397234 - Midjourney chiede agli studios di Hollywood di dichiarare l’uso dell’IA(closed source)—
!«メールアドレス», score 73, 2026-07-05. Notizia collegata a controversie sul copyright. https://lemmy.today/post/56011946 - Presentazione dell’articolo InterleaveThinker(open source/ricerca)—
!«メールアドレス», score 0, 2026-06-12. Link a un articolo arXiv intitolato “Reinforcing Agentic Interleaved Generation”. https://arxiv.org/abs/2606.13679 - Temperatura della reazione negativa ai contenuti IA(segnale sociale)—
!«メールアドレス», score 923, 2026-09-13. Il post tratta occhiali smart con IA Ray-Ban Meta, non direttamente la generazione immagini/video, ma le dimensioni della community, 9.179 utenti attivi mensili, e l’intensità della risposta documentano il clima ostile nel dibattito su immagini/video IA. https://lemmy.world/post/51874921
Segnali
- Il lato open-source è dominato da MiniMax-H3. Nella prima metà di settembre, nella community
!stable_diffusiondi lemmy.dbzer0.com, post su nodi ComfyUI, LoRA, quantizzazione e accelerazione VAE per MiniMax-H3 si susseguono ogni giorno; nomi di modelli di generazione precedente, come Wan, Flux e HunyuanVideo, sono quasi scomparsi dalle ricerche. I contributori primari sono spesso sviluppatori indipendenti su GitHub, a conferma di un ecosistema grassroots centrato su Hugging Face e civitai. - Sul lato closed corrono cinque aziende: Google con Nano Banana, Microsoft con MAI-Image, ByteDance con Seedream, OpenAI con Sora 2 e Midjourney, ma il volume delle menzioni su Lemmy è basso, quasi sempre a una cifra. Il flusso principale arriva dai mirror Reddit di
!ai_reddit. Le menzioni originali di Lemmy si concentrano su notizie aziendali come il pivot di Midjourney verso le spa mediche. - I post di opere con link diretti a civitai, in stable_diffusion_art / share_anime_art, sono attivi ma offrono pochi dettagli su modello o prompt, quindi restano “materiale” più che notizie.
- La community anti-IA
!fuck_aiè tra le più grandi di tutto Lemmy e, quando vi arrivano post relativi a immagini/video IA, i commenti contrari tendono a prevalere sul dibattito equilibrato.
Limiti
- Lemmy ha un campione piccolo e la sua API di ricerca restituisce spesso post vecchi, come quelli del marzo 2025 su HunyuanVideo-I2V, oppure risultati irrilevanti: cercando “Flux”, ad esempio, compaiono anche notizie su una startup di combustibile nucleare chiamata Fluxnium. Il rumore è stato rimosso manualmente per ogni keyword.
- Sono stati cercati separatamente
Runway Gen,Kling AIeWan 2.5, ma non sono emersi post direttamente pertinenti: zero per Kling e Runway, risultati Wan soltanto irrilevanti. Non sono quindi state trovate tendenze autonome di Lemmy su questi modelli. !«メールアドレス»è un bot di ripubblicazione RSS da Reddit, non una discussione nativa Lemmy. Nel report la provenienza è indicata chiaramente e sono state incluse solo osservazioni specifiche per evitare duplicazioni con la fase Reddit.- Le notizie del pivot di Midjourney verso le spa mediche e della richiesta di disclosure a Hollywood risalgono rispettivamente al 2026-06-18 e al 2026-07-05, non alla settimana immediatamente precedente; non sono stati trovati sviluppi più recenti.
- Sono stati esaminati circa 20 post, ma gli unici elementi virali con punteggio superiore a dieci sono la notizia della spa medica di Midjourney e il post sugli smart glasses in
!fuck_ai. Non è stato osservato che gli argomenti di sola generazione immagini/video IA diventino grandi fenomeni virali su Lemmy.
Pinterest — Notizie sull’IA per la generazione di immagini e video
30 delle 50 pin raccolte sono state aperte e lette direttamente, immagini incluse, per scrivere questo riepilogo; le altre 20, in gran parte inserzioni stock generiche “AI content creation concept” e grafiche duplicate di raccolte di strumenti, non sono state aperte perché i titoli corrispondevano già ai temi confermati sotto.
Temi visivi
- Domina il template di miniature YouTube “AI news”: sfondo nero/blu navy, volto umano con espressione di sorpresa o risata, grande testo bianco/rosso “AI NEWS” e fila di badge luminosi con loghi di OpenAI, Google, Anthropic-arancione, Meta, Microsoft e Notion. Appare ripetutamente su temi non correlati e a volte il titolo non coincide con l’immagine: si tratta di un template riutilizzabile, non di arte su misura.
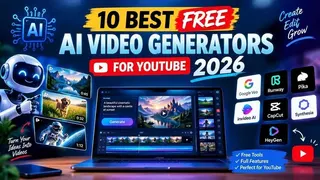
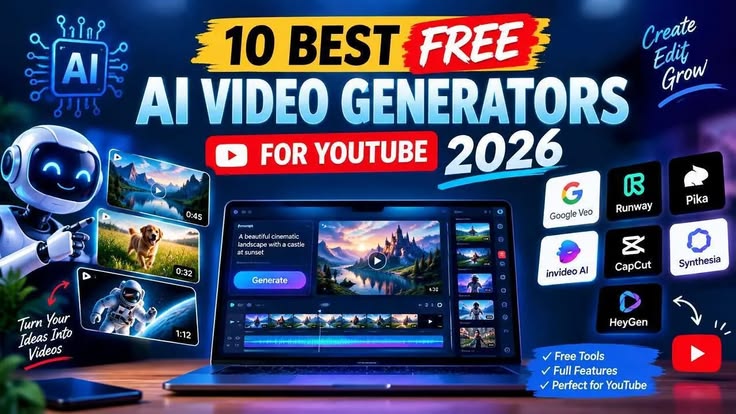
[6, 14, 41, 43, 47] - Le listicle di strumenti usano lo stesso linguaggio infografico scuro e al neon: badge numerati viola/arancioni/turchesi, mockup di laptop con interfaccia di generazione e griglia di loghi concorrenti — Runway, Pika, Kling AI, Luma/Dream Machine, Canva, Hailuo, invideo AI, CapCut, Synthesia, HeyGen. Tutti gli strumenti elencati sono SaaS closed-source.
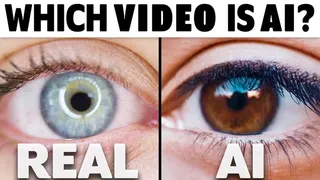
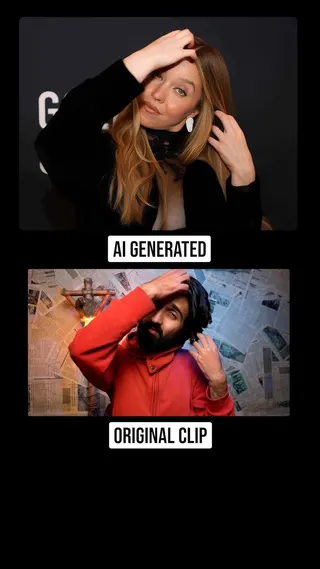
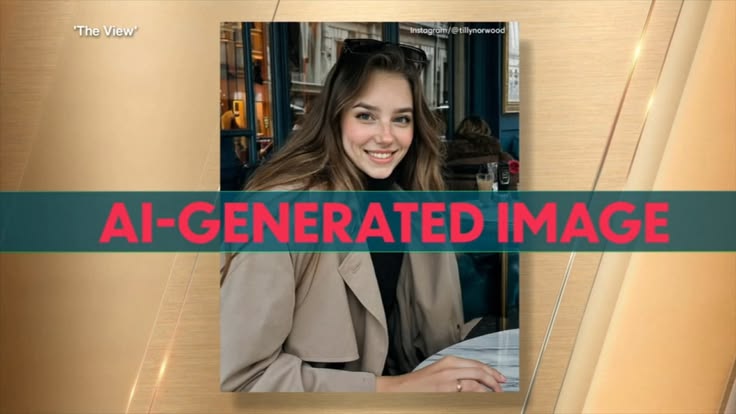
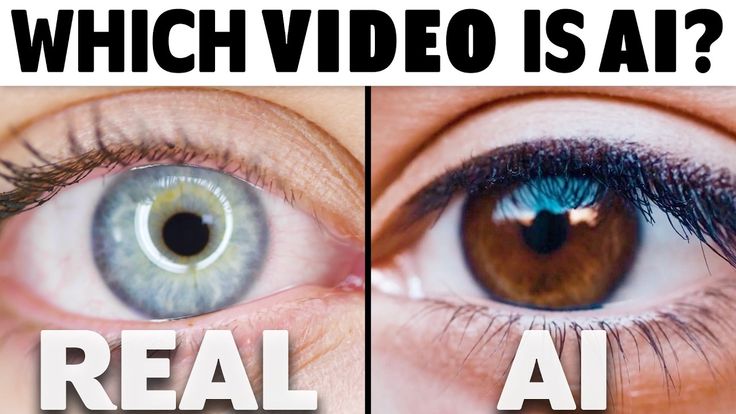
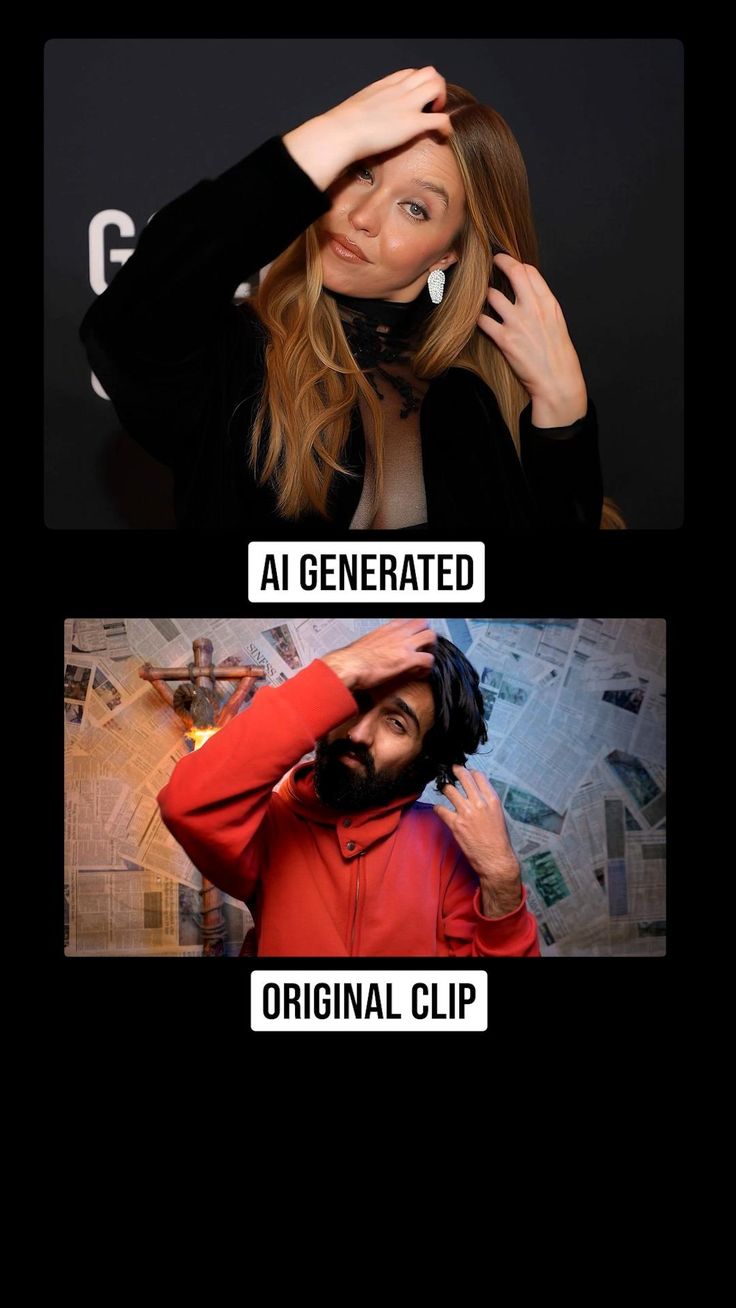
[2, 29] - L’ansia sull’autenticità “Real vs AI” è un formato ricorrente autonomo: quiz affiancati “Which is AI?”, etichette rosse “AI-GENERATED” impresse su foto e meme di confronto “AI GENERATED / ORIGINAL CLIP”. È un genere diffuso quanto le miniature delle notizie.
[3, 21, 32] - Google Veo fornisce il vocabolario visivo predefinito del “video IA cinematografico”: gli stessi fotogrammi caldi in stile Pixar — una ragazza in cucina, fenicotteri, una danzatrice sotto le stelle, un nuotatore, uno scienziato al microscopio — ricorrono su molte pin distinte, insieme a una demo Veo 3 immagine→video con un mostriciattolo di peluche. Nessuna demo reel di un concorrente appare tanto spesso.
[8, 9, 13, 27] - Ritratti IA iperrealistici vengono usati come esca visiva generica, indipendentemente dal soggetto reale dell’articolo: il volto rugoso di un pescatore per annunciare uno strumento, il profilo di una donna dalla pelle scintillante per una card di notizie, un trittico di trasformazione del viso per un’app di svago. Pori, riflessi negli occhi e profondità di campo ridotta indicano che le immagini sono a loro volta generate dall’IA.
[33, 45, 48, 20] - Immagini stock generiche sci-fi/circuiti riempiono gli spazi quando non esiste uno screenshot reale del prodotto: cervelli a filo luminosi, robot umanoidi cromati, uomini d’affari davanti a dashboard IA olografiche. Non hanno valore informativo, servono solo a creare atmosfera.
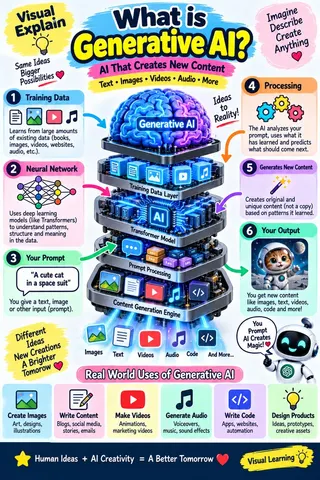
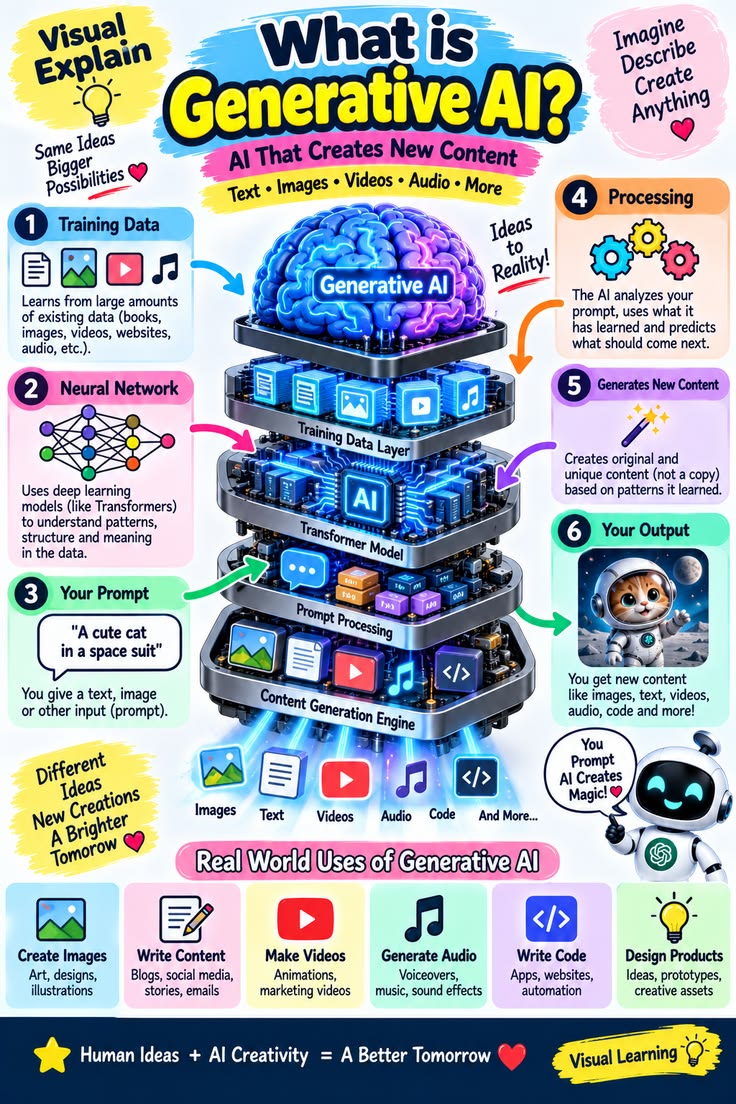
[1, 37, 50] - Le infografiche educative per principianti adottano uno stile pastello e fumettistico — giallo/rosa, mascotte robot sorridente, frecce disegnate a mano — visibilmente più morbido del genere delle miniature per notizie e rivolto a chi non conosce ancora il significato di “IA generativa”.
[7] - I diagrammi tecnici autentici sono rari: nel campione, soltanto una pin mostra una vera figura di architettura del modello, dalle embedding testuali alla diffusione e alle fasi di upscaling, sebbene resa come grafica patinata da rivista anziché illustrazione di ricerca.
[34]
Pin degne di nota
- #48 — “Amuse 3.0”, uno strumento per creare arte IA (pin) — generatore di immagini eseguito localmente e brandizzato AMD, mostrato attraverso un ritratto iperrealistico; è l’unico strumento chiaramente locale o vicino all’open source emerso nel campione, in mezzo a listicle di SaaS closed-source.
- #27 — Google annuncia l’IA di generazione video “Veo 3” (pin) — mostra un’immagine input di un mostriciattolo di peluche e tre video generati in scene differenti: il punto di forza effettivo è quindi la coerenza immagine→video di Veo 3.
- #46 — ByteDance e Hollywood raggiungono un accordo globale sul copyright IA (pin) — card in stile Cointelegraph che riporta un accordo IP ByteDance–MPA relativo agli strumenti per immagini/video, illustrata con un ragazzo generato in stile Pixar.
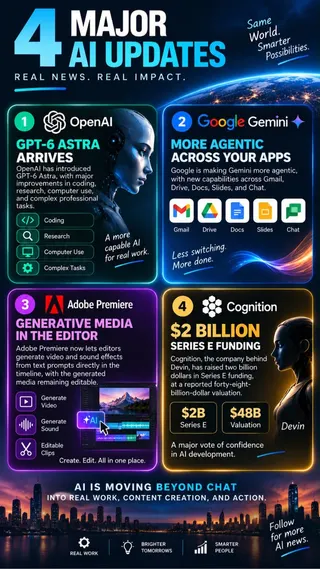
- #10 — “4 Major AI Updates” (pin) — menziona GPT-6 Astra, un Gemini più agentico, media generativi dentro Adobe Premiere e il Serie E da $2B di Cognition con valutazione di $48B, tutti nella stessa infografica.
- #49 — “Today's AI News, May 20 2026” (pin) — riepilogo di Google I/O: Gemini 3.5 Flash, Gemini Omni, Gemini Spark e una spinta sugli smart glasses IA.
- #3 — Hollywood Reporter intervista la prima attrice IA (pin) — schermata TV su “Tilly Norwood”, attrice generata dall’IA, con la cornice stessa marcata “AI-GENERATED IMAGE”.
- #41 — “More than 20% of YouTube is now AI-generated” (pin) — pin con titolo statistico privo di grafico di supporto, presentato come fatto.
- #29 — “10 Best Free AI Video Generators for YouTube 2026” (pin) — la raccolta di strumenti più ampia del campione: Google Veo, Runway, Pika, invideo AI, CapCut, Synthesia e HeyGen, tutti presentati come gratuiti e pronti per YouTube.
- #34 — OpenAI's Secret Image Generation Tool to Debut Soon (pin) — titolo su uno strumento closed-source non ancora rilasciato, illustrato con un autentico diagramma della pipeline di diffusione, seppure in stile rivista, anziché con uno screenshot di prodotto.
- #32 — meme di confronto “AI GENERATED” vs “ORIGINAL CLIP” (pin) — volto/gesto ricreato dall’IA accanto alla clip di origine reale, parte del continuo genere della piattaforma dedicato a individuare l’autenticità.
Segnali
- Attuale: Google Veo, versioni 2 e 3, è il modello video visivamente più ripetuto nella bacheca, più di qualsiasi altro strumento nominato. “L’IA sta andando oltre la chat verso il lavoro reale” è un inquadramento esplicito in più pin, tra timeline generative di Adobe Premiere, finanziamento di Devin di Cognition e Gemini sempre più agentico in Gmail/Drive/Docs. Gli accordi IP e sul copyright, come ByteDance × MPA, sono ormai materiale da notizie mainstream e non più soltanto una vicenda legale di nicchia. Il formato “individua l’IA” e le etichette di autenticità sono un genere a sé, a suggerire una reale ansia del pubblico rispetto a immagini e attori falsi, come Tilly Norwood. Le miniature generiche riutilizzate, con la stessa faccia e gli stessi loghi sotto titoli diversi, indicano che molti contenuti “news” sono prodotti a basso sforzo da content mill invece che reportage originale.
- Assente: la cultura dei modelli open-source è quasi invisibile. Non compaiono screenshot di Stable Diffusion, Flux, ComfyUI, LoRA o repository GitHub; Amuse 3.0 (#48) è l’unico strumento locale/vicino all’open source nel campione, e viene comunque presentato come app consumer patinata, non come progetto open-source. Non sono emerse pin in lingue diverse dall’inglese. Nel campione nessun contenuto è riprodotto come video: tutto è una miniatura statica, quindi non è possibile giudicare la qualità reale dell’output dei modelli, ma solo ciò che viene affermato.
Limiti
- Come previsto dal playbook, Pinterest non è stato navigato direttamente. Il riepilogo è costruito esclusivamente dalla tabella raccolta in precedenza
output/pinterest.pins.mde daimages/pinterest/manifest.json/immagini, tutti da una sola query senza nome, “Image and Video Generation AI News”, non da un’analisi per genere. Il campogenredel manifest è vuoto per ogni pin, quindi non è stato possibile redigere un confronto per genere. - Sono state aperte 30 delle 50 pin; le altre 20 sono state saltate perché i titoli duplicano formati già coperti, come inserzioni stock “AI content creation concept” e grafiche ricorrenti di raccolte di strumenti. È quindi un controllo a campione, non una copertura completa.
- Diversi titoli delle pin sono vuoti, “(untitled)”; in questi casi la descrizione si basa sul testo visibile nell’immagine.
- In alcune pin, il contenuto dell’immagine non corrisponde letteralmente al titolo, per esempio l’immagine della #47 è una generica card di canale “AI NEWS”, non qualcosa di specifico su Grok 5. Questo sostiene l’osservazione sui template generici riutilizzati, ma implica che i titoli vadano letti come indicativi, non come reportage verificato.
- Nessuna pin mostra una data di pubblicazione; non è stato quindi possibile verificare la freschezza delle affermazioni giornalistiche, come la statistica sul 20% di contenuti IA su YouTube, basandosi soltanto sull’immagine.
Azioni consigliate
- Raccogliere nuovamente la fase X con query direttamente legate al tema, come 'Sora 2' 'Midjourney' 'Stable Diffusion' 'Runway Gen' 'Kling AI' 'open source image generation'
- Monitorare continuativamente la frequenza dei rilasci dei modelli open-source cinesi, come MiniMax-H3, Qwen, Wan e Z-Image
- Seguire non solo le community specializzate in IA, ma anche quelle generaliste e professionali, per monitorare l’espansione della reazione negativa contro i contenuti IA
- Verificare metodi di accesso alternativi per risolvere il problema 403 dell’API ufficiale di ricerca Bluesky
- Seguire nel prossimo run gli sviluppi sul problema della “production memory” di Sora 2 e sul pivot di Midjourney verso le spa mediche
- Aggiungere tag di genere alla raccolta Pinterest per consentire una classificazione meccanica open/closed
Immagini raccolte























Nota sulla qualità dei dati
X ha fornito 0 elementi utilizzabili su 40 perché le query erano irrilevanti rispetto al tema; anche Reddit, con 12 elementi, e Bluesky, con circa 12 post ottenuti tramite account personali a causa del blocco dell’API di ricerca, non hanno raggiunto l’obiettivo di circa 20 elementi. Pinterest si basa su dati pre-raccolti senza tag di genere, mentre per YouTube non è stato possibile ottenere visualizzazioni né iscritti.