Notizie sull'IA per la generazione di immagini e video — 2026-09-18
Sul fronte closed source, la generazione di immagini Nano Banana di Google si è ormai affermata nell'uso personale, mentre Sora 2 è in declino con la chiusura dell'API prevista per il 24/09. Nell'open source, MiniMax-H3 e Qwen-Image dominano la scena ComfyUI.
Rassegna delle notizie sull'IA per la generazione di immagini e video — 2026-09-18
Accidenti, questa settimana è stata davvero densissima 🔥 In sintesi, nel mondo closed source la famiglia Nano Banana di Google (generazione di immagini Gemini) è ormai la protagonista assoluta, mentre Sora 2, con la chiusura dell'app e dell'API (24/09), comincia davvero a sembrare un prodotto del passato 🤖📉. Nel mondo open source, MiniMax-H3 (generazione video) e Qwen-Image (generazione immagini) formano un duopolio; in particolare, la comunità ComfyUI era letteralmente invasa da discussioni su MiniMax-H3 😳. Un fatto davvero rilevante emerso questa volta è che i temi di etica e diritto, come la legalizzazione della generazione senza consenso o la causa Disney contro Midjourney, stanno facendo molto più rumore dei confronti sulle prestazioni degli strumenti ⚖️🔥. X (ex Twitter) è stato un totale buco nell'acqua, quindi lo riporto onestamente come «nessun dato» 🙏
Across platforms
Qui raccolgo solo i punti verificabili su più piattaforme 📝✨
- 🍌 Nano Banana (la generazione immagini di Gemini) è diventato uno strumento quotidiano per i creator individuali. Su Bluesky utenti come dfl e triflingtree pubblicano ogni giorno opere realizzate con Nano Banana 2 (https://bsky.app/profile/dfl.bsky.social/post/3mvqfoprrek2i); su YouTube, inoltre, guide come “Ultimate Nano Banana Pro Guide 2026” circolano molto su canali con 327K iscritti (gruppi di canali come https://www.youtube.com/watch?v=Q7SiipUCjro). Nano Banana è stato anche citato su Reddit come modello da integrare in Riverside (https://www.reddit.com/r/RiversideFM/comments/1wiweik/).
- 🌊 Sora 2 sta passando da prodotto “del futuro” a oggetto di retrospettiva. Su Bluesky c'è chi consiglia di passare a Runway/Kling/Veo dopo la chiusura dell'app standalone (https://bsky.app/profile/beginnersinai.bsky.social/post/3mhvsiik2ij2l), mentre su YouTube viene sempre più spesso usato come riferimento nelle comparazioni “State of AI Video”, anziché nelle presentazioni di nuove funzioni. La chiusura dell'API è prevista per il 2026-09-24. È proprio il momento in cui la tendenza sta cambiando 😮
- 🧩 Nel closed source sta prevalendo la strategia delle “piattaforme integrate”. Reddit (Adobe Firefly Boards e Riverside, che riuniscono più modelli) e Pinterest (molte infografiche che confrontano Runway, Pika, Kling, Luma, Veo, Hailuo e CapCut) mostrano la stessa direzione. Non si punta più su un unico modello: sembra iniziata l'era della scelta tra modelli 🛠️
- 🐉 I protagonisti open source sono MiniMax-H3 e Qwen-Image. Le comunità ComfyUI su Lemmy erano quasi interamente occupate, tra inizio e metà settembre, da strumenti intorno a MiniMax-H3 (per esempio: https://github.com/filliptm/ComfyUI-FL-MiniMaxH3 , score 5). I report degli utenti indicano che può girare in locale anche su PC di livello RTX 3090 (commento score 12). Qwen-Image è stato menzionato sia su YouTube (inclusi video benchmark con 700 generazioni) sia su Bluesky (anteprima Qwen3.8-Flash: https://bsky.app/profile/primereports.bsky.social/post/3mub3pkd2rf2s).
- ⚖️ Etica e diritto stanno generando più interesse della tecnologia. Reddit (un thread sul rendere legale o meno la generazione IA senza consenso, con quasi 900 commenti complessivi: https://www.reddit.com/r/CriticalState/comments/1wisk2n/), Bluesky (aggiornamenti sulla causa Disney contro Midjourney: https://bsky.app/profile/ai.bots.law/post/3mvqwgixvkm2n), Lemmy (Midjourney che vira dalla generazione immagini ai dispositivi medici, suscitando commenti tipo “sembra Theranos”: https://awful.systems/post/8731127) e Pinterest (pin sull'accordo copyright tra ByteDance e Hollywood): su tutte e quattro le piattaforme, i temi legali ed etici sono stati i più accesi.
- 😤 La reazione contro l'“AI slop” resta costantemente forte. Reddit (r/aitubers, critiche unanimi ai video senza volto generati automaticamente a partire da una sceneggiatura) e Lemmy (un post in r/fuck_ai sul fatto che “le aziende stanno peggiorando l'IA”, score 63) mostrano lo stesso atteggiamento. Non c'è entusiasmo incondizionato da nessuna parte.
Platform by platform
Reddit — Poiché è stata usata una sola query di ricerca, non sono emersi subreddit specializzati nella generazione immagini come r/StableDiffusion; al loro posto, thread su etica e cultura (uso improprio di immagini IA da parte del DHS, dibattito sulla legalizzazione della generazione senza consenso) hanno monopolizzato l'engagement. Le opinioni sui singoli strumenti, come Google Flow, Wan e Minimax, erano contrastanti: non c'era un chiaro clima da “questo è il migliore” 😐
X — Mi dispiace davvero, qui è stato un fallimento totale 🙅♂️. Tutti i 40 post raccolti riguardavano politica, scommesse sportive o criptovalute: nessuno parlava di IA per immagini o video. Evidentemente la ricerca ha raccolto tendenze di X come Africa, Serbia o Zcash invece di temi IA. È quindi un vero vuoto nei dati per una delle sei piattaforme richieste dal brief.
YouTube — Nel closed source emergono novità con cadenza quasi settimanale: ChatGPT Images 2.5 di OpenAI (rilasciato l'8/9) e Nano Banana Pro/2 di Google sono stati recensiti immediatamente da canali medi, con 30.000–330.000 iscritti, e hanno ottenuto molta attenzione. L'open source si concentra invece su canali tecnici come SECourses e su spiegazioni in giapponese dedicate a Qwen-Image; le visualizzazioni sono circa un decimo rispetto ai contenuti closed source. È stato inoltre sorprendente vedere Seedance 2.0/2.5 di ByteDance come il modello video più trattato quest'anno 📹
Bluesky — Mentre i creator individuali pubblicano quotidianamente lavori con Nano Banana 2, i bot di notizie hanno segnalato anche LTX-2.5 di Lightricks, FLUX LoRA e la pubblicazione di modelli completamente aperti ad Abu Dhabi. Tuttavia, le ricerche API per frasi come “Stable Diffusion”, “Wan 2.5” e “Qwen Image” hanno ripetutamente restituito errori 403, riducendo la disponibilità di testimonianze dirette sulla generazione video open source 😑
Lemmy — La piattaforma più utile di questa rilevazione 🎯. !«メールアドレス» era piena di post su estensioni ComfyUI per MiniMax-H3: è stato il luogo in cui si è vista con maggiore chiarezza la situazione attuale dell'open source per la generazione video. Sul versante closed source, invece, spiccavano notizie considerate confuse, come la svolta di Midjourney verso dispositivi medici; il tono generale di Lemmy era piuttosto scettico.
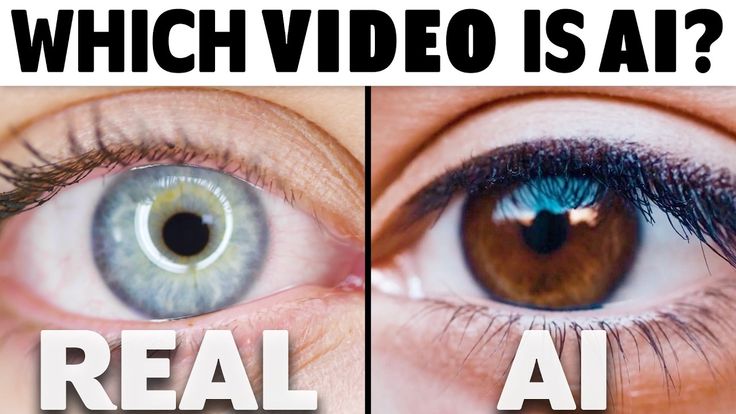
Pinterest — Dalla ricerca visiva raccolta in anticipo sono emerse moltissime infografiche SEO/affiliate che confrontano Runway, Pika, Kling, Luma, Veo, Hailuo e CapCut 🖼️. Si è anche consolidato un filone di contenuti educativi del tipo “distingui il vero dall'IA”. Le notizie open source erano molto scarse: Stable Video Diffusion compariva quasi solo come logo negli elenchi di strumenti.
What to watch
- 🔥 Espansione dell'ecosistema ComfyUI per MiniMax-H3 — Lemmy, https://github.com/filliptm/ComfyUI-FL-MiniMaxH3
- 📉 Chiusura dell'API di Sora 2 (prevista per il 2026-09-24) e destinazioni degli utenti migranti — Bluesky, https://bsky.app/profile/beginnersinai.bsky.social/post/3mhvsiik2ij2l
- 🍌 Radicamento di Nano Banana Pro/generazione immagini Gemini tra i creator individuali — Bluesky, https://bsky.app/profile/dfl.bsky.social/post/3mvqfoprrek2i
- 🎬 Presenza di ByteDance Seedance 2.0/2.5 nella generazione video e accordo copyright con Hollywood — YouTube (tutorial di Dan Kieft) e pin Pinterest ByteDance-MPA
- ⚖️ Evoluzione del dibattito sulla legalizzazione della generazione IA senza consenso — Reddit, https://www.reddit.com/r/CriticalState/comments/1wisk2n/
- 🐦⬛ Crescente presenza di Qwen-Image nell'ecosistema open-weight — YouTube (video di benchmark con 700 generazioni) e post Bluesky su Qwen3.8-Flash
Recommendations
- Nella prossima raccolta, rifare le ricerche su X con parole direttamente legate all'IA, come Sora, Nano Banana, Kling, Qwen, Flux e ComfyUI: questa volta sono state raccolte tendenze del tutto irrilevanti.
- Continuare a monitorare MiniMax-H3 e Qwen-Image come gli indicatori più caldi dell'attuale scena open source.
- Seguire cosa accade alle migrazioni degli utenti verso Runway/Kling/Veo prima e dopo la chiusura dell'API di Sora 2 (24/9).
- Aumentare la priorità del monitoraggio di filoni legali ed etici, quali la causa Disney contro Midjourney e il dibattito sulla legalizzazione della generazione senza consenso, rispetto ai soli confronti di prestazioni.
- Aggiungere alle ricerche Reddit query mirate a subreddit specializzati nella generazione immagini, come r/StableDiffusion e r/aiArt.
- Pinterest si basa solo su deduzioni tratte dalle immagini: la prossima volta occorre aprire realmente gli articoli collegati e verificarli.
Data quality
X (ex Twitter) non fornisce di fatto dati utili: tutti i 40 post raccolti erano estranei al tema IA. Reddit, a causa di una singola query di ricerca, ha mancato le comunità specializzate nella generazione immagini e 5 dei 12 thread raccolti hanno score 0pt. Su YouTube, circa due terzi delle informazioni non sono state verificabili per errori 401/CAPTCHA; molte visualizzazioni dei contenuti video open source restano non confermate. Bluesky ha restituito ripetutamente 403 per le ricerche testuali nell'API pubblica, impedendo di raccogliere dati diretti su “Stable Diffusion”, “Wan 2.5” e altri termini. Lemmy comprende solo post indicizzati su lemmy.world; altre istanze, come lemmy.ml, non sono state esaminate. Pinterest si fonda esclusivamente su immagini raccolte in anticipo dal worker, senza alcuna verifica dal vivo.
Riepilogo per piattaforma
Reddit — Notizie sull'IA per la generazione di immagini e video
Dove
Raccolti 12 thread da 11 subreddit usando la query “Image and Video Generation AI News”.
| Subreddit | Membri | Thread raccolti |
|---|---|---|
| r/generativeAI | 154,407 | 1 |
| r/CriticalState | 35,134 | 2 |
| r/aifilmmaking | 8,038 | 1 |
| r/aitubers | 28,687 | 1 |
| r/agi | 123,187 | 1 |
| r/AIToolTalks | 6,513 | 1 |
| r/ContentCreators | 88,168 | 1 |
| r/AIContentAutomators | 9,387 | 1 |
| r/AIDangers | 53,842 | 1 |
| r/popculturechat | 6,680,224 | 1 |
| r/RiversideFM | 728 | 1 |
I grandi subreddit specializzati nella generazione immagini, come r/StableDiffusion e r/aiArt, non sono comparsi nei risultati; la query utilizzata ha favorito subreddit su strumenti IA, cultura e dibattiti etici.
Cosa dice la gente
- Thread 1(r/generativeAI・13pt・41 commenti・2026-09-16)https://www.reddit.com/r/generativeAI/comments/1whtesl/ — Alla domanda “Quali strumenti gratuiti esistono per la generazione video IA?”, u/RioMetal risponde che, se si può eseguire tutto in locale, esistono moltissimi modelli Wan e Minimax; u/juzellicious osserva invece che Wan offre tre secondi gratuiti al giorno e Google Veo 3 offriva ancora di più. Si discute della riduzione delle quote gratuite dei servizi cloud e del ritorno a modelli locali/open source.
- Thread 3(r/aifilmmaking・7pt・7 commenti・2026-09-14)https://www.reddit.com/r/aifilmmaking/comments/1wg7izt/ — Un post sostiene che i crediti gratuiti di Google Flow siano al momento molto generosi. u/MechanicForward2274 nota che 50 crediti al giorno consentono parecchi test, se non si sprecano. u/Sea-Temporary-6995 obietta però che Flow è debole nelle leggi fisiche e nella logica e considera Minimax molto migliore: le valutazioni sono contrastanti.
- Thread 8(r/ContentCreators・0pt・6 commenti・2026-09-17)https://www.reddit.com/r/ContentCreators/comments/1wj380j/ — Resoconto della creazione di uno spot beauty per specifiche tecniche con Adobe Firefly Boards. L'autore dichiara di aver scelto Firefly Video anziché Veo o Kling per la sicurezza dell'uso commerciale. u/avatar0027 osserva che i primi piani sono belli, ma la continuità fra le inquadrature rivela l'aspetto IA.
- Thread 12(r/RiversideFM・0pt・1 commento・2026-09-17)https://www.reddit.com/r/RiversideFM/comments/1wiweik/ — Riverside, strumento per la produzione di podcast, ha rilasciato funzioni di generazione immagini e video integrando più modelli, inclusi Seedance 2.5, Veo 3.1 e Nano Banana. Tutti i piani a pagamento ricevono 2.000 crediti.
- Thread 4(r/aitubers・0pt・40 commenti・2026-09-14)https://www.reddit.com/r/aitubers/comments/1wg3duk/ — Forte reazione contraria a un post che voleva creare automaticamente video YouTube senza volto a partire da una sceneggiatura. u/RobJames007 commenta che YouTube cerca di ridurre l'AI slop e il post chiede strumenti per aumentarlo; u/-NearlyThere- dice che segnalerebbe e metterebbe un voto negativo a tali video.
- Thread 9(r/AIContentAutomators・0pt・11 commenti・2026-09-11)https://www.reddit.com/r/AIContentAutomators/comments/1wdm1n4/ — L'autore afferma di aver ridotto i costi dei video IA grazie a $300 di crediti cloud gratuiti per nuovi account Google e di aver guadagnato $5.000 al mese. Il commento più apprezzato, di u/Truegentlehat, ne mette in dubbio l'attendibilità: un'ora prima, in un altro post, l'autore avrebbe scritto di aver appena iniziato a guadagnare con €120 al mese.
- Thread 2・5(r/CriticalState・0pt/1pt・421/475 commenti・2026-09-17)https://www.reddit.com/r/CriticalState/comments/1wisk2n/ , https://www.reddit.com/r/CriticalState/comments/1wiwhm4/ — Due thread a voto sulla legalizzazione o sul divieto della generazione di immagini IA senza consenso; in entrambi i commenti più votati sostengono il divieto. u/AwarenessOk7862 osserva che tali immagini falsificano la realtà e rendono ancora più difficile distinguere verità e finzione.
- Thread 11(r/popculturechat・448pt・22 commenti・2026-09-11)https://www.reddit.com/r/popculturechat/comments/1wd49kb/ — Il Dipartimento della Sicurezza Interna statunitense (DHS) ha usato un'immagine IA di Optimus Prime nella comunicazione di una campagna di deportazioni, costringendo Hasbro a intervenire. u/Jerkrollatex commenta che Optimus era a sua volta un personaggio rifugiato di guerra e si chiede se chi ha creato la campagna fosse appena arrivato sulla Terra.
- Thread 7(r/AIToolTalks・12pt・35 commenti・2026-09-13)https://www.reddit.com/r/AIToolTalks/comments/1wfhbnv/ — Post che esprime preoccupazioni sull'IA in generale, incluso il consumo d'acqua e la perdita di lavoro, nel contesto della generazione di immagini e video. u/EstablishmentRare276 replica che i data center esistono dagli anni Cinquanta e che un video YouTube di due ore equivale a 50 richieste IA pesanti.
- Thread 10(r/AIDangers・28pt・31 commenti・2026-09-14)https://www.reddit.com/r/AIDangers/comments/1wg5y17/ — Tesi secondo cui l'IA non sia uno strumento indispensabile e molte aziende registrino perfino un peggioramento delle prestazioni. u/LopsidedSolution fa notare che lo studio potrebbe basarsi su modelli del 2024, come GPT-4o, e chiede una nuova verifica con Astra o Fable.
Segnali
- In crescita: interesse per modelli video locali/open source, come Wan e Minimax. Il ridimensionamento delle quote gratuite cloud (thread 1) sembra spingere gli utenti verso l'esecuzione autonoma per contenere i costi.
- In crescita: strumenti di workflow integrati multi-modello. Adobe Firefly Boards (thread 8) e Riverside (thread 12) permettono sempre più spesso di scegliere, nella stessa piattaforma, tra modelli partner closed source come Veo, Kling, Seedance e Nano Banana.
- Forte reazione negativa: l'automazione di video senza volto, in cui basta fornire una sceneggiatura per generare tutto, viene costantemente derisa come “slop” e considerata da segnalare in r/aitubers e r/ContentCreators. Anche i racconti di guadagni (thread 9) sono visti come pubblicità o esagerazioni.
- Conflitti emersi: le valutazioni pratiche su Google Flow e sull'IA in generale restano divise. Nel thread 3 c'è chi considera Minimax superiore, mentre nel thread 10 si discute perfino se l'IA migliori davvero le prestazioni aziendali. Spiccano commenti di praticanti, né semplicemente pro-IA né anti-IA.
- Aspetto sorprendente: i thread etici e politici, come quello sulla legalizzazione della generazione senza consenso (thread 2 e 5, quasi 900 commenti complessivi) e quello sull'uso improprio di immagini IA da parte del DHS (thread 11, 448pt), hanno un engagement di gran lunga superiore alle discussioni sulle prestazioni tecniche. I thread di confronto tra strumenti restano tutti su punteggi molto bassi, tra 0 e 13pt.
Limiti
- Tutte le ricerche Reddit di questa rilevazione sono state eseguite con la sola query “Image and Video Generation AI News”; non sono state usate query separate per “open source” e “closed source”, né nomi di modelli specifici come Stable Diffusion, ComfyUI o Flux. Di conseguenza, i principali subreddit specializzati nella generazione immagini, quali r/StableDiffusion e r/aiArt, non compaiono affatto nei risultati.
- Cinque dei 12 thread raccolti hanno score 0pt, quindi una parte del campione ha ricevuto poca attenzione. Le voci di subreddit piccoli, come r/RiversideFM (728 membri) e r/AIToolTalks (6.513 membri), sono campioni limitati.
- Per i vincoli del playbook, l'agente non ha navigato Reddit direttamente: l'analisi non supera i 12 thread raccolti in anticipo dal worker e non include post delle ultime ore o thread correlati non intercettati dalla query.
- Il periodo di raccolta va dal 2026-09-11 al 2026-09-17, circa una settimana; non consente di ricostruire l'evoluzione delle discussioni precedenti.
X
X — Notizie sull'IA per la generazione di immagini e video
Account
I 40 post raccolti provengono da 39 account distinti (output/x.posts.md), nessuno dei quali è associato alla generazione IA di immagini o video: non compaiono Midjourney, OpenAI/Sora, Runway, Stability AI, Black Forest Labs, ByteDance/Kling, Pika, Luma o account simili. Gli account appartengono a commentatori politici (@GunterFehlinger, @AntiTrumpCanada, @Rusia_HD), suggeritori di scommesse sportive (@BDreamz37398, @thekasik, @TheRealCEOAmber), promotori di crypto/NFT (@Hasan_NFTOX, @0xHeatt, @jubjubcommunity, @patlandcrypto, @AltcoinSherpa) e account generalisti o di meme (@Keegan59992745, @LeeLovesBey, @Captian_Loden_4). Nessuno pubblica contenuti su IA per immagini o video, né esiste un singolo account rilevante che abbia trainato il tema, perché nel campione non c'è attività pertinente.
Post
Nessun risultato: nessuno dei 40 post raccolti riguarda la generazione IA di immagini o video, closed source o open source. Una verifica di ogni post e del relativo testo completo rispetto al brief ha prodotto zero elementi rilevanti. Esempi rappresentativi, ma fuori tema: #1 (https://x.com/TicTocTick/status/2100319322682134729, 16,936 like, “Xi of China and Ramaphosa of Africa suffered from ischemic stroke...”), #35 (https://x.com/GunterFehlinger/status/2100099276672040971, 13,824 like, “Russia is collapsing in Donbas”), #38 (https://x.com/Keegan59992745/status/2100583905204326909, 159,030 like, battuta su burrito/Israele): sono i tre post con il maggiore engagement nel set e nessuno riguarda l'IA.
Segnali
In questa rilevazione non c'è nulla da segnalare sulle tendenze closed source o open source dell'IA per immagini e video su X. L'unico schema osservabile riguarda i termini di ricerca: “Africa”, “Serbia”, “Zcash”, “Germany”, “$JubJub”, “Canada”, “Zagreb”, “#CyberSecurity”, “Russia”, “Israel”. Sembrano argomenti di tendenza di Explore per la posizione geografica della sessione, in Croazia, non termini legati al brief. La raccolta ha quindi cercato le tendenze di X anziché il tema della generazione IA di immagini e video.
Limiti
- I dati raccolti non rispondono al brief.
output/x.posts.mdeoutput/x.posts.jsoncontengono 40 post trovati cercando “Africa”, “Serbia”, “Zcash”, “Germany”, “$JubJub”, “Canada”, “Zagreb”, “#CyberSecurity”, “Russia”, “Israel”: contenuti politici, di scommesse e crypto che coincidono con le tendenze Explore geolocalizzate in Croazia, non con il tema richiesto. - Il playbook non prevede la navigazione diretta di X e utilizza solo i dati già raccolti dal worker. Poiché nessuno dei termini riguarda Sora, Veo, Midjourney, Runway, Kling, Stable Diffusion, Flux, ComfyUI, LoRA, Nano Banana o altro materiale pertinente, non è possibile rispondere al brief usando questo file: occorre una nuova raccolta con query legate al tema.
- Poiché non è stata usata alcuna query pertinente, non è possibile affermare cosa X stia o non stia dicendo sull'IA per la generazione di immagini e video.
YouTube
YouTube — Notizie sull'IA per la generazione di immagini e video
Canali
- Paul J Lipsky — recensore generalista di strumenti IA; ha trattato “ChatGPT Images 2.5 Is Here (And It's A LOT Of Fun)”, raggiungendo 277K visualizzazioni in 9 giorni (guarda).
- Kevin Stratvert — grande canale mainstream di tutorial tecnologici; “ChatGPT Images 2.5 Tutorial for Beginners” ha totalizzato 58K visualizzazioni in 1 giorno.
- AI Master — 327K iscritti; “Ultimate Nano Banana Pro Guide 2026: How to Use Gemini 3 Image AI”, 76,658 visualizzazioni dal 17 gennaio 2026.
- JohnnyTube — 30.6K iscritti; “Nano Banana 2 Is INSANE! Everything You Need To Know (Full Course)”, 26,162 visualizzazioni dal 6 marzo 2026.
- AffContent — 262K iscritti; contenuti di confronto e affiliazione, per esempio “BEST AI Image Generator in 2026 (Don't Choose Wrong!)”, 14,694 visualizzazioni dal 9 aprile 2026.
- Dan Kieft — 295K iscritti e focus su filmmaking IA; “Seedance 2.0 is CRAZY for AI Filmmaking - Full Course”, 179,589 visualizzazioni dal 24 aprile 2026: il suo recente video con le migliori prestazioni rispetto alla consueta portata del canale.
- SECourses — 53.7K iscritti, tutorial densi su ComfyUI locale/open source; “Wan 2.2, FLUX & Qwen Image Upgraded: Ultimate Tutorial for Open Source SOTA Image & Video Gen Models”, 6,649 visualizzazioni (pubblicato il 18 agosto 2025, fuori dalla finestra di 60 giorni ma mantenuto come contesto su un canale tecnico ancora attivo).
- Canali più piccoli e di coda lunga ricorrenti nelle ricerche su Qwen-Image e Wan, con sole informazioni sul titolo e metriche non confermate: canali giapponesi dedicati a “Qwen-Image完全ガイド” e “Qwen-Image-2512”, oltre a canali in inglese con confronti locali tra Qwen 2512, Z-Image, FLUX.2 klein, Ovis e LongCat.
Video
- “ChatGPT Images 2.5 Is Here (And It's A LOT Of Fun)” — Paul J Lipsky, circa 9 giorni, 277K visualizzazioni. https://www.youtube.com/watch?v=Q7SiipUCjro — Reazione al lancio, avvenuto l'8 settembre 2026, di ChatGPT Images 2.5 di OpenAI: sketch-to-image, circa 50% di latenza in meno e modelli API Flare/Sunburst. La coerenza dell'identità è indicata come il miglioramento più importante.
- “ChatGPT Images 2.5 Tutorial for Beginners” — Kevin Stratvert, circa 1 giorno, 58K visualizzazioni. Tutorial per un pubblico mainstream sulla nuova funzione sketch e sul montaggio multi-step che finalmente mantiene il contesto tra le modifiche.
- “Everyone's Lying to You About GPT Image 2.5” — Joseph Martin, circa 2 giorni, 10K visualizzazioni. Opinione contraria secondo cui il salto riguarda soprattutto velocità e latenza, più che la qualità d'immagine rispetto a GPT-Image-1.
- “Ultimate Nano Banana Pro Guide 2026: How to Use Gemini 3 Image AI” — AI Master, dal 17 gennaio 2026, 76,658 visualizzazioni. Guida in sei parti alla struttura del prompt — Soggetto + Azione + Ambiente + Stile artistico + Illuminazione + Dettagli — per Gemini 3 Pro Image di Google, orientata a foto di prodotto e branding.
- “Nano Banana 2 Is INSANE! Everything You Need To Know (Full Course)” — JohnnyTube, dal 6 marzo 2026, 26,162 visualizzazioni. Presenta Nano Banana Pro 2 come generatore combinato di immagini e video, confrontandolo informalmente con Midjourney, Flux, Sora 2 e Veo 3.1.
- “BEST AI Image Generator in 2026 (Don't Choose Wrong!)” — AffContent, dal 9 aprile 2026, 14,694 visualizzazioni. Ampia rassegna e confronto affiliato tra generatori closed source gratuiti e a pagamento.
- “Seedance 2.0 is CRAZY for AI Filmmaking - Full Course” — Dan Kieft, dal 24 aprile 2026, 179,589 visualizzazioni. Sottolinea la qualità delle scene d'azione, l'aderenza al prompt e la coerenza visiva di Seedance 2.0 di ByteDance, pur riconoscendone i limiti; è il video Seedance con maggiore trazione trovato, rispetto a numerosi tutorial e recensioni pubblicati nella stessa settimana.
- “State of AI Video in 2026: Sora 2, Veo 3.1, Kling 3.0 & Cinematic Prompting Workflows” — @StarnationsAI, presentato il 20 marzo 2026, 177 visualizzazioni / circa 1K iscritti. Esempio a bassa trazione incluso per mostrare l'esistenza del formato comparativo; la descrizione contiene in larga parte materiale di formazione aziendale non correlato, inserito attorno alle parole chiave dell'IA video.
- “Wan 2.2, FLUX & Qwen Image Upgraded: Ultimate Tutorial for Open Source SOTA Image & Video Gen Models” — SECourses, 6,649 visualizzazioni (18 agosto 2025, fuori dalla finestra di 60 giorni ma il dato open source più chiaro trovato). Test di una settimana su configurazioni preimpostate per Wan 2.2, FLUX e Qwen-Image, incluse procedure di download, preset, upscaling e training/fine-tuning.
- Gruppo di titoli open source con metriche non verificate, trovati con la ricerca ma non confermati dal recupero pagina per via dei blocchi di YouTube: “Qwen-Image完全ガイド|ポスター作成から画像編集まで5分で終わらせる方法”, “【徹底解説】最強オープンソース『Qwen-Image-2512』”, “ComfyUI Text-to-Image Models Compared (Local): Qwen 2512, Z-Image, FLUX.2 klein, Ovis, LongCat” e “Qwen Image Dominates Text-to-Image: 700+ Tests Reveal Why It's Better Than FLUX.”
Segnali
- Il ritmo delle novità closed source è attualmente settimanale. ChatGPT Images 2.5 di OpenAI è uscito l'8 settembre 2026 e Nano Banana 2, Gemini 3.1 Flash Image 4K di Google, il 26 febbraio 2026: ciascuno ha generato, nella stessa settimana, ondate di tutorial e reazioni da canali medi da 30K a 330K iscritti, con decine di migliaia di visualizzazioni in pochi giorni.
- Seedance 2.0 di ByteDance, pubblicato il 10 febbraio 2026, è il modello video più trattato su YouTube quest'anno. Una semplice ricerca per titolo ha trovato oltre dieci tutorial o recensioni tra febbraio e giugno 2026, più di quanti ne siano emersi per Sora 2, Veo 3.1 o Kling 3.0 singolarmente. Il miglior video trovato, quello di Dan Kieft con 179.6K visualizzazioni, supera di circa il doppio i tutorial closed source dedicati alle immagini.
- La conversazione YouTube su Sora 2 è ora retrospettiva, non proiettata in avanti: i risultati sono dominati da confronti sullo stato dell'IA video, non da tutorial su nuove funzioni. Ciò è coerente con la chiusura confermata dell'app consumer il 26 aprile 2026 e con il tramonto dell'API il 24 settembre 2026: Sora 2 viene sempre più usato come riferimento da superare, non come prodotto da imparare.
- La copertura open source privilegia canali tecnici e tutorial densi, nello stile di SECourses, oltre a approfondimenti giapponesi su Qwen-Image, anziché il formato delle grandi comparazioni che domina il closed source. Le 6,649 visualizzazioni del video open source confermato sono circa un ordine di grandezza sotto i leader closed source: pubblico più piccolo, ma più tecnico.
- Qwen-Image di Alibaba è il modello open-weight con più attenzione video dedicata, grazie sia a benchmark inglesi con 700 generazioni contro FLUX sia a diversi video giapponesi che presentano Qwen-Image-2512 come ormai indistinguibile dall'IA.
Limiti
- Le pagine dei risultati di ricerca di YouTube (
/results?search_query=...) e la maggior parte delle pagine/watchhanno restituito ripetuti blocchi 401/CAPTCHA. Questa rilevazione ha usato un proxy di lettura HTML, poiché le pagine di ricerca YouTube sono renderizzate lato client, ma solo circa un tentativo su tre ha avuto successo. - A causa di questi blocchi, molti video open source rilevanti — approfondimenti su Qwen-Image-2512, confronto ComfyUI tra Ovis/LongCat/Z-Image e Qwen-Image-Edit-Rapid-AIO — non hanno potuto essere verificati per visualizzazioni esatte, iscritti o descrizioni complete.
- Non è stato possibile recuperare i commenti principali di nessun video: gli stessi blocchi hanno impedito la lettura della sezione commenti.
- Non sono state confermate visualizzazioni esatte per i principali confronti su Sora 2, Veo 3.1 e Kling 3.0, oltre al singolo esempio a bassa trazione di StarnationsAI.
- Non è stato trovato un video inglese recente, ben performante e con metriche confermate, dedicato esclusivamente a un singolo modello open source di generazione video come Wan, HunyuanVideo o LTX. L'unico dato verificato, quello di SECourses, combina Wan 2.2 con due modelli di immagini ed è più vecchio di un anno.
Bluesky
Bluesky — Notizie sull'IA per la generazione di immagini e video
Data della ricerca: 2026-09-18. Sono state usate le API pubbliche di ricerca Bluesky (https://api.bsky.app/xrpc/app.bsky.feed.searchPosts) con parole chiave quali “Sora 2”, “Nano Banana”, “Midjourney”, “ComfyUI”, “open weights model release” e “Runway/Veo”; sono stati controllati fino a 15 post per query, per un totale superiore a 70 post.
Account(account che pubblicano)
- dfl.bsky.social — creator individuale che pubblica quotidianamente illustrazioni paesaggistiche in stile fotografico create con Nano Banana 2, la generazione immagini Gemini.
- triflingtree.bsky.social — utente molto attivo che pubblica numerose opere di IA art con gli hashtag
#NanoBananaProe#GeminiAi. - ai.bots.law — bot automatico che segue cause e sviluppi legali legati all'IA.
- gen-ai.news / aichina.news / stechtimes.com / channelnewsasia.bsky.social(via bridgy) — bot e feed di notizie che diffondono novità del settore dell'IA generativa.
- pitchwall.bsky.social / onestudio1.bsky.social / beginnersinai.bsky.social — account che presentano confronti fra strumenti IA e notizie sui prodotti.
- primereports.bsky.social / techpresso.bsky.social / theregister.com / socialmedialab.ca — account di notizie internazionali che seguono l'apertura dei pesi di modelli Meta “Muse”, Alibaba Qwen e altri.
- singularityhorizon.bsky.social / heppokopu.bsky.social / misaka-mikoto-17.bsky.social / 404ai.bsky.social — utenti giapponesi che creano IA art con Midjourney o ambienti locali come ComfyUI.
Post(post principali)
Closed source
- Post di presentazione dell'API Sora 2: “Sora 2 API: A developer-friendly API for Sora 2 and Sora 2 Pro”. 2026-09-15, Like 0 / Repost 0.
https://bsky.app/profile/pitchwall.bsky.social/post/3mvjwvr327k2u - Post di confronto fra IA video “Veo 3.1 vs Sora 2 vs Kling 3.0”. 2026-09-14, Like 2 / Repost 0.
https://bsky.app/profile/onestudio1.bsky.social/post/3mvhdlv5vgk2w - Post che menziona la chiusura dell'app Sora standalone e consiglia di passare a Runway, Kling o Veo; spiega che OpenAI chiude l'app, non necessariamente la tecnologia. 2026-03-25, Like 0.
https://bsky.app/profile/beginnersinai.bsky.social/post/3mhvsiik2ij2l - Post su un nuovo deposito nella causa per copyright Disney contro Midjourney. 2026-09-18, Like 0.
https://bsky.app/profile/ai.bots.law/post/3mvqwgixvkm2n - Illustrazione di un paesaggio giapponese visto dall'alto, generata con Nano Banana 2. Like 25 / Repost 1, 2026-09-17.
https://bsky.app/profile/dfl.bsky.social/post/3mvqfoprrek2i - Opera surrealista con alberi, tag
#NanoBananaPro. Like 15, 2026-09-17.
https://bsky.app/profile/triflingtree.bsky.social/post/3mvpliiqt5c25 - Flash di notizie: “Meta ya tiene su rival para Nano Banana 2” — Meta ha pronto un concorrente di Nano Banana 2. 2026-09-16, Like 0.
https://bsky.app/profile/laiadesk.bsky.social/post/3mvmiod2iod26
Open source
- Notizia secondo cui Lightricks ha reso legacy il modello video LTX-2.3 e indicato LTX-2.5 come modello consigliato. 2026-09-12, Like 0.
https://bsky.app/profile/gen-ai.news/post/3mvdadb2upx2l - Post su un FLUX LoRA open-weight per la rappresentazione di persone africane, pubblicato attraverso Modelers.cn. 2026-09-09, Like 0.
https://bsky.app/profile/aichina.news/post/3mv3dcr6hgz2i - Post sul rilascio di “Qwen3.8-Flash”, modello MoE multimodale di Alibaba e anteprima dell'architettura Qwen4. 2026-08-30, Like 1.
https://bsky.app/profile/primereports.bsky.social/post/3mub3pkd2rf2s - Post secondo cui un istituto di ricerca di Abu Dhabi ha pubblicato una famiglia di modelli IA completamente aperti, compresi pesi, dati di addestramento e codice. 2026-09-03, Like 0.
https://bsky.app/profile/channelnewsasia.bsky.social/post/3mumk4agbwm2g - Post di analisi sulla pubblicazione in rapida successione di modelli aperti da parte di società IA cinesi, in una guerra di prezzi con le aziende occidentali. 2026-09-06, Like 0.
https://bsky.app/profile/stechtimes.com/post/3muuykcvzv62i
Segnali
- Nano Banana 2, la generazione immagini Gemini di Google, si è radicato nelle pubblicazioni quotidiane dei creator individuali. Persone come triflingtree e dfl pubblicano opere quasi ogni giorno usando
#NanoBananaProe#GeminiAi: non è più solo interesse iniziale, ma uso reale e diffuso. - Intorno a Sora 2 convivono aspettative e incertezza. Da un lato circolano notizie sull'API per sviluppatori; dall'altro, dopo la chiusura dell'app standalone, compaiono consigli di passare a Runway/Kling/Veo. La riorganizzazione della strategia video di OpenAI è un argomento visibile.
- Le cause sul copyright sono un tema importante sul lato closed source. Bot di notizie seguono gli sviluppi della causa Disney contro Midjourney e la battaglia legale fra studi cinematografici e aziende di generazione immagini continua.
- Sul lato open source prevalgono i flash diffusi da bot di notizie, mentre sono pochi i post individuali particolarmente appassionati. LTX-2.5, FLUX LoRA, Qwen3.8-Flash e modelli completamente aperti di Abu Dhabi arrivano da Stati Uniti/Europa, Cina e Medio Oriente.
- I modelli Meta “Muse”, Spark/Glimmer 30B, continuano a essere annunciati come prossimi all'apertura dei pesi, e diversi account di notizie internazionali li osservano come potenziali concorrenti di Nano Banana 2.
- ComfyUI è uno strumento locale standard per gli utenti giapponesi come heppokopu e misaka-mikoto-17. Si vedono tentativi di avvicinare in locale la qualità di ChatGPT e Nano Banana.
Limiti
- Le API pubbliche di ricerca (
public.api.bsky.app/api.bsky.app) hanno restituito in modo intermittente HTTP 403 alle richieste automatiche. Le query semplici con parole separate, comeSora 2 videoeMidjourney, hanno funzionato in più tentativi; le frasi fra virgolette, come"Stable Diffusion", e le query OR fallivano quasi sempre. Non sono mai stati ottenuti dati per “Stable Diffusion”, “Wan 2.5” e “Qwen Image”, riducendo la copertura diretta dei modelli video open source. - Le pagine Web di
bsky.appsono renderizzate lato client; il recupero diretto di post e profili senza eseguire JavaScript non fornisce il testo. Tutte le letture effettive si basano quindi su testo e conteggi forniti dalle API JSON. - Senza accesso autenticato non sono disponibili feed seguiti, feed personalizzati o liste private. I dati ottenuti coprono soltanto la ricerca pubblica per parole chiave.
- Le ricerche erano centrate soprattutto su nomi inglesi di prodotti e modelli; non sono state svolte ricerche attive in giapponese. I post giapponesi trovati erano inclusi casualmente nei risultati delle parole chiave inglesi e non rappresentano necessariamente l'intero dibattito giapponese.
Lemmy
Lemmy — Temi sull'IA per immagini e video (settembre 2026)
Comunità
- !«メールアドレス» — comunità specializzata in IA open-weight per immagini e video, estensioni ComfyUI e distribuzione di modelli. È stata la scoperta più utile della rilevazione, con una forte concentrazione di post dedicati al modello video MiniMax-H3.
- !«メールアドレス» — circa 1.6K iscritti, di cui 206 locali. Dedicata a immagini anime realizzate con modelli derivati da Stable Diffusion, solo SFW.
- !stable_diffusion_art / !stable_diffusion_abstract / !stable_diffusion_witches / !stable_diffusion_mycology / !stable_diffusion_furry / !stable_werewolves(tutte su lemmy.today)— gruppo di comunità di IA art suddivise per temi di nicchia; più gallerie di opere che fonti di notizie.
- !«メールアドレス» — comunità-mirror che ripubblica cross-post da r/ArtificialIntelligence. Le discussioni originali nate su Lemmy sono quasi assenti.
- !«メールアドレス» — 8,235 iscritti. Comunità critica e anti-IA, con molti post scettici verso l'IA per immagini e video.
- !«メールアドレス» — 2,698 iscritti. Comunità “sneer” che ironizza sull'hype dell'industria tecnologica. Qui la notizia del cambio di direzione di Midjourney ha generato più discussione.
- !«メールアドレス» — notizie tecnologiche generali; vi sono comparsi più articoli rilevanti su Midjourney.
Post
- Serie di estensioni ComfyUI per MiniMax-H3 (principale tendenza open source) — circa 20 post su !«メールアドレス» fra 2026-08-28 e 09-16. Esempi:
- “ComfyUI-FL-MiniMaxH3” (score 5, 2026-08-30, github.com/filliptm/ComfyUI-FL-MiniMaxH3), con funzioni per timeline del prompt e composizione delle inquadrature.
- “H3-World” (score 3, 2026-09-02, huggingface.co/DANNY621/H3-World), che si presenta come “il primo world model interattivo costruito su MiniMax-H3”.
- “ComfyUI-MiniMaxH3-CLSS” (score 0, 2026-09-01, github.com/nazgut/ComfyUI-MiniMaxH3-CLSS), che promette generazione di video con audio di durata arbitraria su hardware consumer con 16GB di VRAM.
- “ComfyUI_MinimaxH3_AutoContext” (score 1, 2026-09-16, github.com/supElement/ComfyUI_MinimaxH3_AutoContext), per continuare a generare video senza limite di durata anche con poca VRAM.
- Secondo un commento dell'utente brucethemoose (score 12, 2026-09-14), MiniMax-H3 consente di combinare liberamente riferimenti audio, video e immagini e funziona in locale su un normale PC assemblato con RTX 3090 + Ryzen 7800.
- Midjourney vira dalla generazione immagini ai dispositivi medici, uno scanner ecografico per tutto il corpo — post su !«メールアドレス» (https://awful.systems/post/8731127 , score 40, 15 commenti, 2026-06-19). David Gerard presenta l'annuncio “Midjourney Medical”; nei commenti fioccano paragoni sarcastici con Theranos. YourNetworkIsHaunted segnala un possibile difetto tecnico: il dispositivo può immergere persone alte solo fino a 60 pollici, circa 152 cm, quindi non riuscirebbe a esaminare parti sopra il cuore. Terranoid commenta che potrebbe essere un tentativo disperato dopo l'esaurimento del business della generazione immagini.
- La stessa notizia è apparsa più volte anche su !«メールアドレス»: “Midjourney pivots from AI image generation...” (theregister.com, score 58, 2026-06-18) e “Midjourney wants Hollywood studios to reveal...” (techcrunch.com, score 73, 2026-07-05).
- Crescita raddoppiata del business aziendale di Runway — cross-post da !«メールアドレス» (score 0, 2026-08-30, via reddit.com/r/ArtificialInteligence/comments/1w2hnea). Si cita un net revenue retention superiore al 300% nei contratti enterprise.
- Funzione IA “Nano Banana” in Google Earth sospesa il giorno dopo il lancio — post su !«メールアドレス» (fortune.com, 2026-08-07) e nella rete !«メールアドレス». È stato evidenziato che chiunque poteva creare immagini falsificate in stile fotografia satellitare; Google avrebbe quindi disattivato subito la funzione.
- Confronto con lo stesso prompt fra sei modelli video IA — !«メールアドレス», “I ran the same prompt through 6 AI video models...” (score 1, 2026-09-17, reddit.com/r/ArtificialIntelligence/comments/1wipgwa).
- Confronto di colorazione di manga in bianco e nero con ChatGPT Images, Wan, Nano Banana Pro e Seedream — !«メールアドレス», “Same Berserk spread, 4 AI colorizations. Looks like GPT wins again?” (score 1, 2026-09-14). Confronta Wan open source con Nano Banana Pro, Seedream e GPT Images; nei commenti prevalgono valutazioni positive del risultato GPT.
- Post che indica il tono anti-IA — !«メールアドレス», “Why companies like anthropic and open AI make AI even worse” (score 63, 2026-09-14). Non riguarda specificamente immagini o video, ma mostra il forte clima di sfiducia verso le grandi aziende closed source.
- Report sull'esecuzione locale di Qwen — !«メールアドレス», “Testing Qwen 3.8 27B running locally on a single 5090” (score 1, 2026-09-16, v.redd.it/jdrothgw4vph1). Non è generazione immagini in senso stretto, ma si colloca nel contesto dei modelli aperti eseguiti su GPU consumer.
- Flusso quotidiano di IA art, anime e astratta — nelle comunità !share_anime_art e !stable_diffusion_art continuano quasi ogni giorno nuovi post con immagini ospitate su civitai.com; per esempio “Isshiki Clear - Mahjong Fight Girl”, score 15, 2026-09-17, lemmy.dbzer0.com/post/75601449. Hanno poco valore di notizia, ma mostrano un uso quotidiano dei modelli Stable Diffusion, Flux e Krea2.
Segnali
- Il lato open source è quasi tutto MiniMax-H3. Tra inizio e metà settembre, la comunità stable_diffusion era sostanzialmente piena di strumenti ComfyUI per questo modello video. Vengono ripetutamente enfatizzati la possibilità di combinare audio, immagini e video su GPU locali e le ottimizzazioni per farlo funzionare anche con 16GB di VRAM.
- Il closed source offre poche notizie positive. Spiccano la svolta hardware di Midjourney e la sospensione della funzione Google Earth, entrambe percepite come notizie di smarrimento strategico. La crescita di Runway è uno dei pochi segnali positivi.
- Il tono complessivo di Lemmy è scettico e critico, soprattutto in !fuck_ai e !techtakes. L'entusiasmo senza riserve è raro; c'è una forte differenza di tono fra comunità di implementazione, come quelle su stable_diffusion, e comunità di critica delle notizie, come techtakes e fuck_ai.
- Prevalgono opere e cross-post, non discussioni originali. !ai_reddit è letteralmente una ritrasmissione di Reddit, quindi non va trattato come fonte primaria nata su Lemmy.
Limiti
- Lemmy è federato e l'API di ricerca trova solo post indicizzati su lemmy.world. Non c'è stato tempo per cercare singolarmente lemmy.ml, lemm.ee e altre istanze; questa rilevazione si limita ai risultati federati da lemmy.world.
- Sono state cercate più parole chiave, come “Sora”, “Veo”, “Gemini image” e “Flux”, ma non sono stati trovati post sulle novità dei modelli Sora 2 o Google Veo: in Lemmy le notizie sui lanci dei prodotti closed source sono state scarse.
- L'articolo originale di pivot-to-ai.com non era direttamente citabile perché il recupero WebFetch restituiva caratteri corrotti; il contenuto è stato quindi integrato con il post e i commenti di awful.systems, oltre a fonti esterne trovate tramite motore di ricerca.
- L'API era instabile, con errori 400/500, e non è stato possibile ottenere il numero esatto di iscritti a !stable_diffusion e !ai_reddit. Sono disponibili solo quelli di !share_anime_art, circa 1.6K, !fuck_ai, 8,235, e !techtakes, 2,698.
- Rispetto al criterio del brief, circa 20 post analizzati per ciascun social, sono stati controllati più di 20 testi di post, score e date con query multiple; in questo file ne sono riportati solo nove, selezionati come rappresentativi.
Pinterest — Notizie sull'IA per la generazione di immagini e video
Temi visivi
- Domina il template di infografica “rassegna di notizie IA” in neon scuro. Sfondi quasi neri o blu navy, linee luminose ciano-magenta-viola, titoli bianchi in grassetto e file numerate di loghi in badge arrotondati. Questo linguaggio visivo ricopre gran parte dei pin informativi.
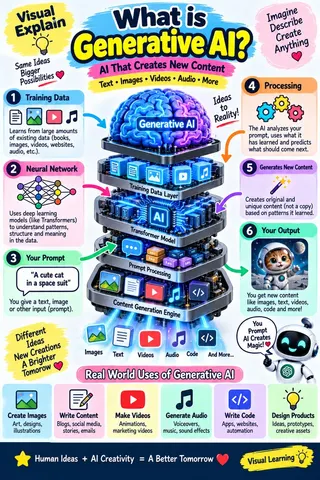
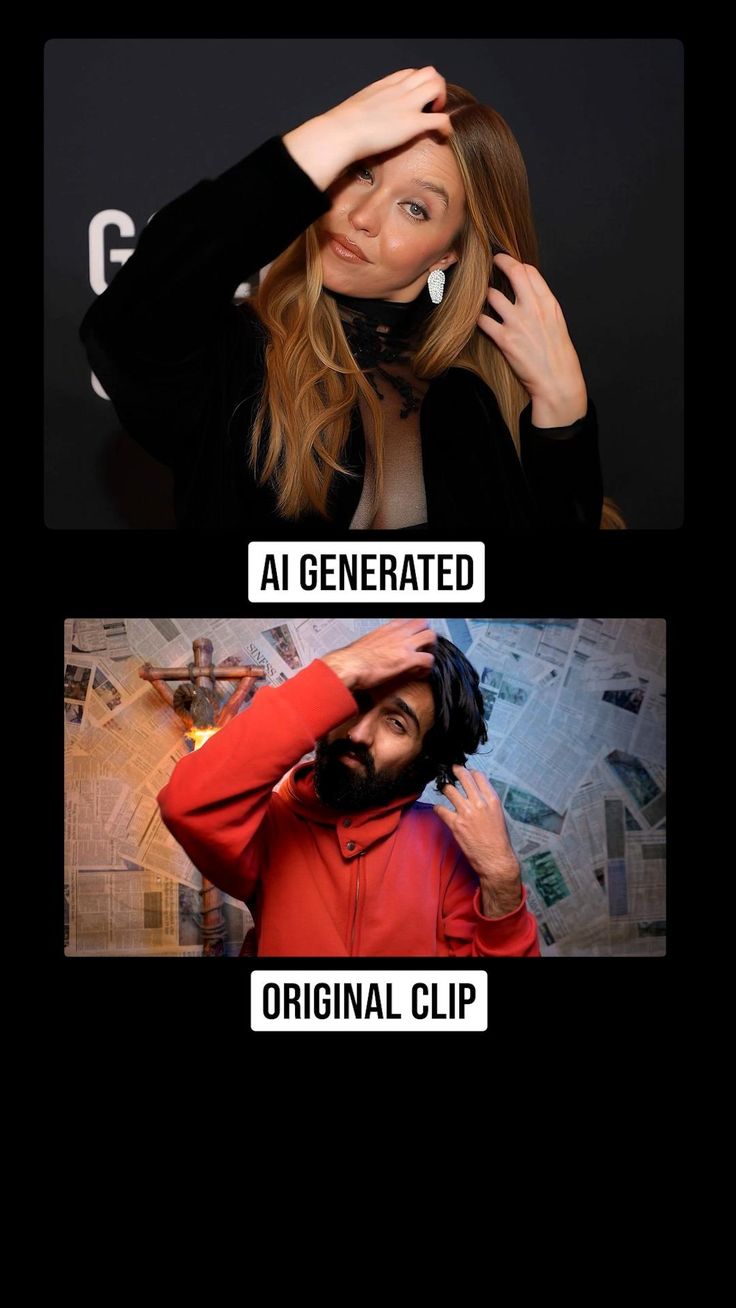
[6, 9, 10, 11, 18, 20, 26, 31, 38, 39, 41, 45, 48] - Ovunque il formato “Riesci a riconoscere l'IA?” tra immagini reali e false. Confronti split-screen o A/B che chiedono di scegliere la foto, il video o l'occhio reale; compaiono anche demo di foto da red carpet con face-swap e selfie iperrealistici etichettati “This is AI”.
[3, 21, 24, 33, 46] - L'IA è personificata come robot umanoide cromato o bianco. Androidi a figura intera dietro una scrivania da anchor con la scritta “BREAKING NEWS”, accanto a un telefono con il timbro “FAKE” o mentre toccano un globo luminoso sopra una città, usati come simbolo generico dell'IA.
[3, 40, 44] - Miniature YouTube con volti di creator sorpresi per le notizie IA. Uomini barbuti o con espressioni scioccate incorniciati accanto a loghi di OpenAI, Google, Meta, Anthropic e Notion: una convenzione visiva riconoscibile per i video “AI news” settimanali.
[2, 19, 22, 42] - Demo di coerenza immagini/video da una sola sorgente in molti stili. Una persona che cammina e un'auto vengono rielaborate come blocchi di legno, origami, mattoncini Lego, fiori e giocattoli: una vetrina in stile Lumendra/Luminate per la diffusione coerente.
[5] - Gli stessi pochi nomi di strumenti ricorrono in ogni lista: Runway (Gen-3), Pika, Kling AI, Luma/Dream Machine, Google Veo (2 e 3), Canva AI, Hailuo AI (MiniMax), CapCut, ElevenLabs e Stable Video Diffusion.
[6, 10, 18, 20, 31, 45] - Ritratti IA iperrealistici come prova di qualità. Un vecchio pescatore fotorealistico di AMD “Amuse 3.0”, una statua di marmo e legno che suona il violoncello e compositi di volti “AI baby” vengono usati per dimostrare quanto possano sembrare convincenti i modelli attuali.
[25, 47, 50] - Impostazione da finto telegiornale o finto giornale per le notizie sull'IA stessa. Sottopancia “BREAKING NEWS”, un generatore di avatar-anchor IA come Wondershare Virbo e una prima pagina fittizia di quotidiano, “The AI Dispatch”, 15 agosto 2026, mostrano contenuti sull'IA che imitano le convenzioni del giornalismo televisivo e cartaceo.
[14, 36, 40, 41]
Pin notevoli
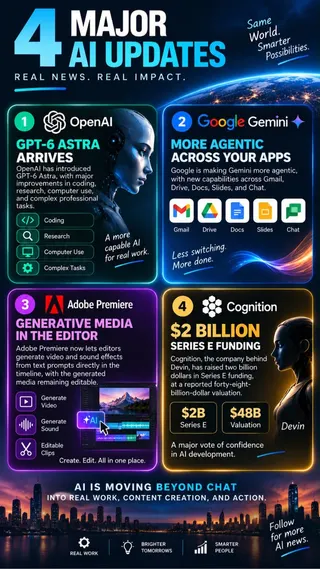
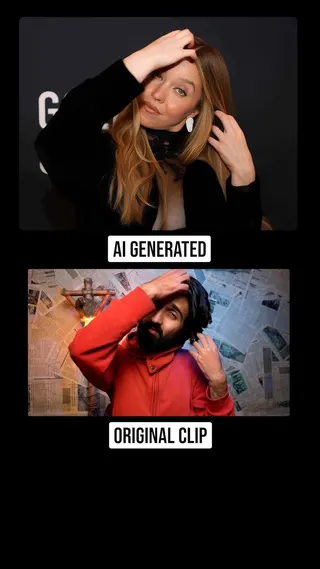
[5](senza titolo, griglia di trasformazioni video multi-stile) — un video sorgente di una persona e un'auto viene rielaborato in cinque materiali, legno, origami, Lego, fiori e plastica giocattolo; è la demo più concreta del set sulle attuali tecniche di coerenza immagini/video.[9]“4 Major AI Updates You Need to Know in 2026” — cita elementi specifici: “GPT-6 Astra” di OpenAI, Gemini agentico in Gmail/Docs/Slides, Adobe Premiere che genera video e audio nella timeline e Cognition, Devin, con un round Series E da $2B a valutazione $48B.[28]“ByteDance and Hollywood reach global deal on AI copyright” — pin in stile notizia reale: ByteDance avrebbe raggiunto un accordo con la Motion Picture Association per rafforzare la protezione della proprietà intellettuale nei suoi strumenti IA per immagini e video.[45]“Today's AI News — May 20, 2026” — riepilogo di Google I/O 2026: Gemini 3.5 Flash, Gemini Omni, rinnovamento della Ricerca con IA, funzioni di accessibilità IA di Apple e competizione sugli occhiali smart IA Android XR.[41]“The AI Dispatch”, 15 agosto 2026 — prima pagina fittizia di quotidiano che elenca temi IA molto diversi, tra cui velocità d'inferenza, IA sovrana, agent harness, sicurezza IA e deep research.[31]“AI Video Creation Tools Changing How Content Is Made” — la directory più completa trovata: 20 prodotti nominati in categorie di text-to-video, image-to-video, editing, voiceover, stock/B-roll e pubblicazione/ottimizzazione.[24](senza titolo, foto da red carpet generata dall'IA contro “clip originale”) — demo di face-swap/deepfake che affianca un ritratto patinato generato dall'IA alla clip reale di un'altra persona, illustrando il trasferimento di identità.[40]“Discover how Grok is revolutionizing video...” — un anchor robot umanoide a una scrivania “BREAKING NEWS” promuove le capacità video di Grok.[47]“Amuse 3.0” — strumento AMD per IA art locale/on-device, mostrato con il ritratto fotorealistico di un anziano pescatore.[10]“AI Image Video: Best Quality vs Best Free” — infografica ad albero decisionale che divide gli strumenti fra massima qualità a pagamento, ChatGPT Plus, Midjourney, Adobe Firefly, Runway Gen-3 e Luma, e alternative gratuite, Ideogram, livello gratuito Gemini, SeaArt, Krea e CapCut.
Segnali
- Le rassegne e le listicle di strumenti per la generazione video sono il tipo di contenuto più forte e ripetuto: su Pinterest, il pubblico della generazione immagini IA sembra composto soprattutto da creator SEO/affiliate che impacchettano sempre lo stesso set closed source, Runway, Pika, Kling, Luma, Veo, Hailuo e CapCut, più che da fonti di notizie originali.
- I contenuti di educazione al riconoscimento, “riesci a capire se è IA?”, con sfide vero/falso e demo deepfake, sono ormai un sottogenere a sé: ansia e curiosità sulla rilevazione guidano i contenuti indipendentemente dal rilascio di un modello specifico.
- Alcuni pin menzionano eventi datati e nominati successivi all'apertura della finestra di raccolta, come Google I/O 2026, “GPT-6 Astra”, un digest di notizie del 15 agosto 2026 e il round da $2B di Cognition: sono i contenuti più vicini a notizie concrete trovati sulla piattaforma.
- I dettagli open source sono scarsi: “Stable Video Diffusion” compare solo come uno dei loghi in una directory di 20 strumenti
[31]; nessun pin tratta con profondità una release open-weight, una licenza o un fork della comunità. - Nessun contenuto affronta in modo significativo metodologia di addestramento, architettura del modello o dibattiti su dataset e licenze, a eccezione del singolo pin
[28]sull'accordo copyright ByteDance–MPA.
Limiti
- Questa fase descrive esclusivamente immagini raccolte in anticipo dal worker, secondo
platforms/pinterest.md; non è stata effettuata alcuna navigazione Pinterest dal vivo, ricerca o lettura del testo degli articoli collegati. Nessuna affermazione è stata verificata rispetto a una pagina live o all'articolo dietro al pin. - Diversi pin sono template quasi duplicati di account che sembrano repost o scraper: la grafica stock neon “Generate content with AI” appare due volte
[11, 26], il banner Google Veo 2 appare due volte[7, 8]e la listicle “Best AI Video Generation Websites” appare due volte con lo stesso elenco di strumenti[6, 18]. - Cinque pin non hanno titolo (
(untitled)) nella tabella sorgente[8, 17, 20, 21, 24, 28... ]; nello specifico[8, 20, 21, 24, 28]avevano titoli vuoti o generici, limitando l'attribuzione a ciò che è visibile nelle immagini. - Il set di pin appartiene a un unico genere e non è stata definita alcuna suddivisione per genere: tutti i 50 pin provengono da una sola ricerca indifferenziata.
Azioni consigliate
- Rifare la raccolta su X cercando parole direttamente legate all'IA, come Sora, Nano Banana, Kling, Qwen, Flux e ComfyUI: questa volta sono state raccolte per errore le tendenze di X e il risultato è stato completamente fuori tema.
- Continuare a monitorare MiniMax-H3 e Qwen-Image come indicatori principali della scena open source.
- Seguire gli spostamenti degli utenti verso Runway/Kling/Veo intorno alla chiusura dell'API di Sora 2, prevista per il 2026-09-24.
- Monitorare con priorità almeno pari ai confronti fra strumenti i filoni legali ed etici, tra cui la causa Disney contro Midjourney e il dibattito sulla legalizzazione della generazione senza consenso.
- Aggiungere alla raccolta Reddit query mirate a subreddit specializzati nella generazione immagini, come r/StableDiffusion e r/aiArt.
- Verificare dal vivo gli articoli collegati ai risultati Pinterest.
Immagini raccolte
























Nota sulla qualità dei dati
Delle sei piattaforme richieste dal brief, X non ha fornito dati utilizzabili perché l'intera raccolta era fuori tema; Reddit, Bluesky e YouTube hanno inoltre perso alcuni temi principali, come Stable Diffusion e Wan 2.5, a causa di query di ricerca e limiti delle API, inclusi 403/401/CAPTCHA.