Notizie sull’IA per la generazione di immagini e video — 2026-09-14
Sora 2 di OpenAI terminerà completamente, API comprese, il 24 settembre 2026. Mentre il video generativo closed-source converge su quattro leader — Veo 3.1, Seedance 2.5, Kling 3.0 e Runway Gen-4.5 — l’open source è guidato dai player cinesi (Alibaba/Tencent/DeepSeek/Zhipu) e dalla famiglia LTX-2 di Lightricks.
Riepilogo delle notizie sull’IA per la generazione di immagini e video — 2026-09-14
Ciao! Questa volta ho passato a tutta velocità sei social — Reddit, X, YouTube, Bluesky, Lemmy e Pinterest — per raccogliere le ultime notizie sull’IA per immagini e video, sia closed-source sia open source 🔥🔥 In sintesi, il fronte closed-source si è rapidamente consolidato attorno a quattro nomi — Veo 3.1, Seedance 2.5, Kling 3.0 e Runway Gen-4.5 — dopo l’uscita di scena di fatto di Sora di OpenAI. Sul fronte open source, i player cinesi (Alibaba, Tencent, DeepSeek e Zhipu) stanno davvero prendendo il comando, mentre la famiglia LTX-2 di Lightricks sta ricevendo un entusiasmo tale da essere definita il “Santo Graal del video open source” 📈 Però, su X le parole chiave di ricerca erano configurate male e questa volta i risultati sono stati quasi completamente fuori tema; anche Lemmy ha dato un esito particolare: sviluppo attivo, ma discussioni praticamente inesistenti. Lo segnalo con trasparenza 😅
Across platforms 🌐
- L’open source cinese è ormai protagonista assoluto: Qwen-Image/Qwen-Image-Edit e Wan (Alibaba), Hunyuan (Tencent), la famiglia DeepSeek-V4 e GLM-5.3-Flash vengono citati diffusamente su YouTube, Bluesky, Lemmy e Reddit. Il quadro “open source = Cina” sembra ormai quasi consolidato 🇨🇳
- Seedance 2.5 (ByteDance) è il nome più caldo nel mondo closed-source: è molto discusso su Reddit (dibattito su quando usare Wan o Seedance), compare spesso nei confronti video su YouTube ed è presente nelle immagini pubblicitarie più appariscenti su Pinterest. Alcuni notano però che costa circa tre volte Wan 💸
- Il flusso “crea prima l’immagine, poi trasformala in video” è ormai la norma: più thread Reddit trattano questo workflow ibrido come scontato; anche le demo Pinterest di trasformazione delle texture — legno, origami e così via — si inseriscono nella stessa direzione 🎬
- La generazione simultanea in un solo passaggio di audio e video è una tendenza condivisa: Veo 3.1 e Seedance 2.5 nel closed-source, Wan 3.0 e LTX-2 nell’open source: tutti stanno rendendo predefinita la generazione con audio incluso, non soltanto immagini in movimento 🎧
- L’ansia del “forse è IA?” emerge ovunque: Reddit (r/isthisAI), Pinterest (barre di rilevamento dei falsi e confronti Human vs Machine) e Lemmy (reazioni fredde all’IA generativa in generale) mostrano che l’affidabilità dei contenuti generati è ormai un tema stabile 🕵️
- Anche stanchezza e sfiducia dell’utenza generale verso l’IA sono temi ricorrenti: comunità anti-IA su Lemmy, diffidenza Reddit verso gli abbonamenti “illimitati”, articoli Pinterest su copyright e regolamentazione: si percepisce il passaggio dalla fase “si può creare” alla fase “come dobbiamo gestirla” ⚖️
Platform by platform 📱
Reddit — Analizzati 12 thread in 8 subreddit. Il più vivace è stato r/generativeAI, con discussioni concrete sui modelli video locali e non censurati (MiniMax H3, LTX-2.3, famiglia Wan) e sul posizionamento di Seedance 2.5. Inoltre, un thread di r/GetNoted — non specializzato in IA — ha ottenuto 5.026 punti, il massimo assoluto del set: segnale evidente che l’IA generativa è ormai consumata non solo come argomento specialistico, ma come carburante per notizie e polemiche 🔥
X — I 40 post raccolti e le 10 parole chiave di ricerca (“Lando”, “LMEOW”, “Dario” e così via) erano del tutto scollegati dal tema. I post su IA per immagini e video sono stati letteralmente zero 😱 L’unico contenuto vagamente vicino all’IA era un saggio di Dario Amodei sul ritmo dello sviluppo dell’IA, diventato virale con oltre 67 milioni di visualizzazioni, ma non riguardava i media generativi. Sembra un errore di configurazione della raccolta, non un reale silenzio di X.
YouTube — È stata la piattaforma con la maggiore densità informativa. In primo piano, la notizia scioccante che Sora 2 terminerà completamente, API comprese, il 24/09/2026 — l’app era già stata chiusa ad aprile — e la convergenza verso i quattro leader closed-source Veo/Seedance/Kling/Runway. La serie Nano Banana si sta consolidando come modello d’immagine de facto; sul fronte open source, LTX-2 viene celebrato come “Holy Grail”. Le visualizzazioni, però, erano quasi impossibili da ottenere per via dei vincoli JavaScript 📵
Bluesky — Un bot che pubblica automaticamente le tendenze di Hugging Face è diventato di fatto la principale fonte: Qwen, DeepSeek, GLM e LTX-2.5 entrano in tendenza quasi ogni giorno. Le realtà closed-source come Stability AI e Midjourney si concentrano soprattutto su partnership enterprise e piccoli aggiornamenti, senza grandi lanci di modelli in questo periodo. L’API di ricerca ha restituito 403, un limite importante 🔒
Lemmy — La conclusione è: “non è una festa”. Le comunità !stable_diffusion sono dominate da bot che ripubblicano automaticamente Hugging Face e GitHub, con quasi zero commenti. Al contrario, nelle comunità generaliste come !asklemmy e !fuck_ai spiccano opinioni negative sull’IA generativa, dalle critiche all’addestramento senza consenso alla frustrazione per la “AI slop”. Nessun aggiornamento recente e rilevante su singoli modelli come Sora 2 o Veo 3.
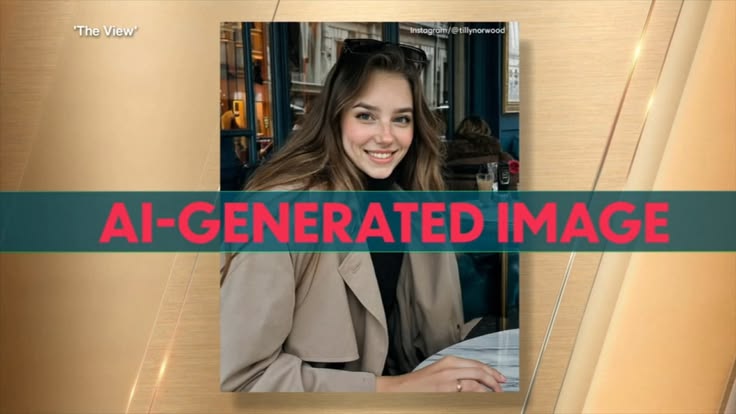
Pinterest — Analizzati 50 pin raccolti in precedenza. I visual promozionali dei grandi player closed-source — Google Veo, ByteDance Seedance e ShengShu Vidu — sono al centro della scena. Sono emerse anche più notizie su regolamentazione e impatto sociale, come la controversia sull’attrice IA “Tilly Norwood” e l’accordo sul copyright fra ByteDance e MPA. L’open source è poco visibile, spesso relegato a una riga dentro liste di strumenti.
What to watch 👀
- Se Wan 3.0 verrà pubblicato con pesi completamente aperti (Apache 2.0) — YouTube: https://www.youtube.com/watch?v=3BFDcO2Ysu4(al momento è solo una beta pubblica; il rilascio dei pesi non è confermato)
- Se LTX-2 riuscirà a mantenere il ruolo di principale candidato nel video open source — YouTube: https://www.youtube.com/watch?v=27UAb_Tlv4E
- Per quanti giorni consecutivi LTX-2.5 manterrà il primo posto nelle tendenze Hugging Face — Bluesky: https://bsky.app/profile/huggingfacetrends.bsky.social/post/3mvfrl5gc5z2l
- Quanto la funzione “riferimenti” di Seedance 2.5 renderà realmente utilizzabile la coerenza dei personaggi — Reddit: https://www.reddit.com/r/AI_Short_Films/comments/1wf97v7/
- Come si concluderà il dibattito sull’uso differenziato di Wan (open) e Seedance (più vicino al closed) — Reddit: https://www.reddit.com/r/generativeAI/comments/1wchdv0/
- Come la controversia sull’attrice IA “Tilly Norwood” influenzerà pratiche di settore e regolamentazione — Pinterest: https://www.pinterest.com/pin/4607675129179333696/
Recommendations 💡
- Valutare e confrontare i workflow video assumendo una struttura in due passaggi: “definire il personaggio con un modello d’immagine → animarlo con un’IA video”.
- Per le proof of concept di video open source, dare priorità alle famiglie LTX-2 e Wan, continuando a monitorare l’annuncio di licenza di Wan 3.0.
- Per il video closed-source, confrontare costi e prestazioni dei quattro leader Seedance 2.5, Veo 3.1, Kling 3.0 e Runway Gen-4.5, includendo le differenze di prezzo — Seedance costa circa tre volte tanto.
- Prima di sottoscrivere servizi closed-source che promettono “illimitato”, verificare sempre i limiti reali di generazione e i tempi di attesa.
- Creare regole operative interne per i rischi legali dei contenuti generati, concentrandosi sulla responsabilità nelle fasi di distribuzione e condivisione più che sulla sola generazione.
- Nella prossima raccolta X, sostituire le parole chiave con termini relativi all’IA per immagini e video, come nomi di modelli e laboratori.
Data quality 🔍
- X:le 40 pubblicazioni raccolte e le parole chiave erano fuori tema; post pertinenti: zero. A causa del mismatch di configurazione, il volume reale della conversazione su X non può essere valutato da questi dati.
- Lemmy:non esiste una comunità attiva specializzata in IA per immagini e video; i post indipendenti di qualità — esclusi ripubblicazioni automatiche e post senza commenti — non hanno raggiunto l’obiettivo di 20 elementi.
- Reddit:solo 12 thread in 8 subreddit, quindi anche qui l’obiettivo di 20 elementi non è stato raggiunto. La profondità dei contenuti era comunque sufficiente.
- Bluesky:l’API di ricerca full-text non era utilizzabile per errore 403; la raccolta alternativa tramite ricerca degli account introduce una distorsione del campione.
- YouTube:a causa del rendering JavaScript, visualizzazioni e iscritti sono stati quasi impossibili da ottenere; l’analisi si limita a titoli e riassunti nei risultati di ricerca. Sono stati comunque raccolti circa 19 video, quasi l’obiettivo.
- Pinterest:analizzati 50 pin raccolti dal worker, raggiungendo l’obiettivo quantitativo. Mancava però una classificazione per generi, quindi non è stato possibile confrontare ripartizioni tematiche.
Riepilogo per piattaforma
Reddit — Notizie sull’IA per la generazione di immagini e video
Where 🗺️
I 12 thread raccolti questa volta provengono da 8 subreddit! Ecco la ripartizione👇
| Subreddit | Membri | Thread raccolti |
|---|---|---|
| r/generativeAI | 152,914 | 4 |
| r/isthisAI | 411,226 | 1 |
| r/artificial | 1,337,681 | 1 |
| r/GetNoted | 298,881 | 1 |
| r/AItips101 | 57,843 | 1 |
| r/Seedance_AI | 20,909 | 1 |
| r/AI_Short_Films | 7,965 | 1 |
| r/aivideomaking | 6,928 | 2 |
Il subreddit più coinvolto è stato r/generativeAI (4 thread). È interessante anche vedere contenuti legati alla generazione di immagini e video arrivare in subreddit non strettamente specialistici, come r/artificial, quello di verifica r/isthisAI e quello più leggero r/GetNoted.
What people say 🗣️
-
① Un post-rankings sugli strumenti non censurati per immagini/video sta ottenendo attenzione(thread 1, r/AItips101, 176pt・121 commenti・2026-09-07)→ Promuove WildOwl.ai come numero uno perché consente l’accesso, senza abbonamento fisso e con crediti, a “oltre 35 modelli (Qwen, Flux, Seedream, Wan, Kling, Seedance, Veo, GPT Image)”. Nei commenti, u/reliablemicrophone84 lo elogia: “WildOwl really does solve that exact problem... Ive wasted so many credits elsewhere on frustrating filters”. Va comunque ricordato che thread di questo tipo hanno una forte componente promozionale 🚩
-
② Discussione seria sui modelli video locali e non censurati(thread 8, r/generativeAI, 86pt・56 commenti・2026-09-10)→ Vengono citati MiniMax H3, distribuito localmente su Hugging Face, LTX-2.3 / LTX-2.3Eros10 e le versioni da Wan 2.2 a 3.0. Secondo u/farkryzer24, “Wan can draw explicit actions and anatomy correctly while Seedance is not as good at that, but Seedance is better at cinematic and fluid motion... Seedance has a higher price, can be around 3x Wan per second”: un’interessante divisione d’uso tra Wan aperto e Seedance più chiuso ⚖️
-
③ Insoddisfazione verso servizi video che promettono “1080p illimitato”(thread 4, r/generativeAI, 1pt・13 commenti・2026-09-07)→ Si parla di Artlist.io (€550/anno) e dei piani alti di Runway ($76–95/mese). u/ai_art_is_art taglia corto: “Unlimited is a lie. You put $550 in, you get $200 out and you have to wait 24 hours between generations”. È evidente la sfiducia verso l’etichetta “illimitato” dei servizi closed-source 💸
-
④ Il confine fra video generato e ripresa reale è sempre più difficile da distinguere(thread 7, r/isthisAI, 0pt・31 commenti・2026-09-09)→ Da anomalie come una collana che scompare e ricompare si deduce che sia IA. u/BouncingSphinx osserva: “It also happens to be 15 seconds long, which is apparently the current limit of AI video”; la durata limitata dei video IA è diventata un indizio per riconoscerli 👀
-
⑤ Un thread virale su immagini IA usate per alimentare polemiche ottiene il maggior numero di reazioni(thread 11, r/GetNoted, 5,026pt・373 commenti・2026-09-10)→ Un’immagine generata su X, simile a un calendario con testo deformato, è diventata fonte di disinformazione e polemiche. Pur non essendo un subreddit dedicato all’IA, r/GetNoted è di gran lunga il più reattivo della raccolta: esempio emblematico di come i contenuti generati vengano consumati come combustibile politico, non solo come notizia 🔥
-
⑥ Thread che svela come vengono realizzati i video virali(thread 6, r/generativeAI, 0pt・31 commenti・2026-09-10)→ u/lagbit_original spiega: “Easy Use you preferable image model for creating the character, Seedance 2.5 and a single prompt and the right references. Then add some music and a few cuts here in there in an editing software”. In altre parole: personaggio creato con un modello d’immagine, Seedance 2.5 con prompt e riferimenti, poi montaggio in un editor. È il workflow ibrido dominante 🎬
-
⑦ Per i video IA lunghi, partire da immagini è la mossa standard(thread 12, r/AI_Short_Films, 4pt・9 commenti・2026-09-13)→ u/sharktank123456: “You really want to go image based - you are rolling the dice with a really expensive model if you are doing text to video... let the images provide the fidelity”. Viene anche menzionata la nuova funzione di riferimenti di Seedance 2.5 per rendere più coerenti i personaggi. Sul lato open source, u/VERSATILCORDOBA promuove un’app open source compatibile con Ollama, ComfyUI e provider remoti 🛠️
-
⑧ Frustrazione per il blocco di personaggi protetti da copyright nei modelli closed-source(thread 9, r/generativeAI, 2pt・3 commenti・2026-09-08)→ Grok blocca personaggi Disney; u/frighten suggerisce PixelForge per iOS, senza restrizioni integrate. I player closed-source più grandi applicano maggiori vincoli IP e una parte della domanda fluisce verso strumenti di nicchia 🏰
-
⑨ Chi vuole creare video lunghi gratis incontra il muro dell’hardware(thread 2, r/aivideomaking, 16pt・39 commenti・2026-09-07)→ u/NewLifeWares: “45 seconds is reaching data center level requirements of hardware. At best you might find a free 5 second generator... expect to spend hours generating until you get the right results, then stitching together a few 5-10 seconds videos”. Il divario tra aspettative gratuite/a basso hardware e realtà della generazione video è enorme 😅
-
⑩ Dibattito sulla zona grigia legale dei video IA con celebrità(thread 5, r/Seedance_AI, 0pt・22 commenti・2026-09-07)→ u/Jean_velvet: “Recent court cases put it in the responsibility of the user. If you've made any harmful content involving real people then I suggest you don't share it. It's the distribution and sharing that's the potential crime”. Nei commenti è largamente condivisa l’idea che il rischio principale sia nella condivisione e diffusione, più che nella generazione in sé ⚖️
Signals 📡
- Clima in ascesa:i modelli video locali/open source e non censurati — MiniMax H3, LTX-2.3 e famiglia Wan — emergono esplicitamente nel thread 8; è già normale parlare di uso differenziato rispetto a modelli come Seedance 2.5. Il workflow “prima l’immagine, poi il video” del thread 12 è quasi trattato come conoscenza comune.
- Freddi / criticati:gli abbonamenti closed-source che promettono “illimitato” vengono descritti nel thread 4 come quasi ingannevoli. Anche il desiderio di creare video lunghi gratuitamente su hardware debole viene realisticamente giudicato irrealizzabile con la tecnologia attuale.
- Divergenze:nel thread 8 Wan e Seedance sono valutati per punti di forza opposti — Wan per azioni esplicite e accuratezza anatomica, Seedance per fluidità cinematografica — mentre Seedance costa circa tre volte tanto.
- Elemento sorprendente:il thread di r/GetNoted, non specializzato in IA, ha raggiunto 5.026 punti, il massimo di tutto il set. Le notizie su IA per immagini/video sembrano avere maggiore capacità di diffusione nel contesto di notizie generali e polemiche che nei subreddit specialistici.
- Osservazione sottile:la brevità dei video IA è ormai di per sé un indizio per identificarli: un vincolo tecnico che, ironicamente, aiuta a smascherarli.
Limits ⚠️
- È stata usata una sola parola chiave, “Image and Video Generation AI News”, producendo 12 thread in 8 subreddit. Non è stato raggiunto il riferimento di circa 20 elementi per social.
- Il brief richiede almeno 10 insight rispettivamente per closed source e open source, ma dai soli dati Reddit non è possibile separare nettamente 10 elementi per categoria: molti thread citano entrambi i mondi o trattano argomenti generali. Questo report Reddit organizza ciò che viene detto su Reddit; la classificazione in due assi è prevista nel report integrato con le altre piattaforme.
- Il thread 11 di GetNoted e il thread 10 di r/artificial riguardano più l’impatto sociale dei contenuti IA che la generazione di immagini/video in senso stretto. Sono inclusi come contesto, non come notizie strettamente su strumenti o modelli.
- Reddit non era consultabile direttamente; non sono stati letti thread oltre a quelli già raccolti in
output/reddit.threads.md/.json. È quindi possibile che altri temi, come annunci formali di nuovi modelli, fossero presenti su Reddit ma non inclusi qui.
X
X — Notizie sull’IA per la generazione di immagini e video
Accounts
La raccolta ha estratto 40 post da 34 account cercando dieci termini:
“Lando”, “LMEOW”, “Slack”, “Company OS”, “Ireland”, “Dario”, “China”, “#bb28”,
“Source”, “solbiscuit” (vedi output/x.posts.md riga 3). Nessuno di questi termini
nomina un modello, laboratorio o prodotto di generazione di immagini/video e, dopo
la lettura di tutti e 40 i post, nessun account parla realmente di IA per immagini o video. Il gruppo più vicino consiste in sei post sul ritmo/sicurezza dell’IA di frontiera, guidati da un account con un singolo enorme post:
- @DarioAmodei (Dario Amodei, CEO di Anthropic) — un post, ma il più grande dell’intera raccolta: 84.569 like, 25.720 repost, 9.488 risposte e circa 67.000.000 visualizzazioni (#23). È un account da singolo mega-post per questo dataset, non un autore ricorrente.
- @BrianRoemmele (Brian Roemmele) — tre post, tutti reazioni al saggio di Amodei, con coinvolgimento piccolo-medio (658, 739, 325 like) — commentatore ricorrente più che autore di un singolo grande successo (#24, #25, #26).
- @ctgptlb (AGIラボ, account giapponese di notizie IA) — un post che riassume lo stesso saggio per un pubblico giapponese: 1.341 like e circa 672.000 visualizzazioni (#22).
- @BenjaminPDixon, @TheJakeChristie, @akshay_pachaar — un post ciascuno su sentiment relativo alla regolamentazione IA e metodi di valutazione LLM (#21, #28, #35): account di IA generale, non di immagini/video.
Gli altri 28 account parlano di Formula 1 (Lando Norris), di un token crypto chiamato $LMEOW, di Slack contro Discord contro LINE WORKS per chat aziendale giapponese, di politica di devoluzione nel Regno Unito, Big Brother 28 (#bb28), un rapporto OSINT sul lancio di missili iraniani e un token chiamato “solbiscuit”: tutti temi estranei al brief.
Posts
Nessun post della raccolta riguarda IA per immagini o video, closed-source o open source. Il materiale più vicino, relativo al ritmo dello sviluppo degli LLM di frontiera anziché ai media generativi, è:
- #23 @DarioAmodei, 2026-09-12, 84.569 like / 25.720 repost / 9.488 risposte / ~67.000.000 visualizzazioni —
https://x.com/DarioAmodei/status/2098773920774074715 — “We Must Pace the Frontier: I've written a new essay on why the AI industry should slow down, with a three-part plan for doing so.” Riguarda velocità di sviluppo dell’IA e valutazioni di sicurezza di terze parti, non modelli di media generativi. - #22 @ctgptlb, 2026-09-12, 1.341 like / ~672.000 visualizzazioni —
https://x.com/ctgptlb/status/2098917214741254175 — riepilogo giapponese secondo cui “Sam, Elon e Dario hanno insolitamente convergito sulla necessità di rallentare lo sviluppo dell’IA”. - #24 @BrianRoemmele, 2026-09-12, 658 like / ~94.000 visualizzazioni —
https://x.com/BrianRoemmele/status/2098802245462827491 — “CHINA IS NOT 'PACING'. I have seen the next models they are releasing as well as the folded GPU chips they will release.” Reazione scettica al saggio di Amodei. - #28 @TheJakeChristie, 2026-09-13, 8.456 like / ~199.000 visualizzazioni —
https://x.com/TheJakeChristie/status/2098947959698124820 — meme che liquida “altrimenti vincerà la Cina” come diversivo dalla regolamentazione dell’IA. - #35 @akshay_pachaar, 2026-09-12, 776 like / ~73.000 visualizzazioni —
https://x.com/akshay_pachaar/status/2098675498742395373 — “11 LLM eval methods AI engineers must know”, thread tecnico sui metodi di valutazione degli LLM in generale, non sui modelli immagini/video.
Nessuno menziona un modello di diffusione, un generatore video, un rilascio closed-source o un progetto open source per immagini/video. Sono inclusi soltanto perché rappresentano l’unico materiale vagamente connesso all’IA restituito dalla ricerca.
Signals
- Nessuna crescita sul tema effettivo. Su 40 post e 10 termini di ricerca, zero post discutono generazione di immagini, generazione video, modelli di diffusione o prodotti generativi closed/open nominati.
- Ciò che la raccolta ha mostrato, se lo si considera anche solo vagamente pertinente alle notizie IA, è un’ondata del 12/09/2026 attorno al saggio “Pace the Frontier” di Dario Amodei: discorso su sicurezza e regolamentazione dell’IA generale, non sui media generativi. Ha prodotto di gran lunga il maggior post della raccolta (~67M visualizzazioni contro ~672k del successivo).
- Sorpresa: le parole chiave — Lando, LMEOW, Company OS, #bb28, solbiscuit e così via — non corrispondono affatto al tema del brief. Sembrano termini ereditati da una ricerca diversa. È probabilmente un mismatch di configurazione, non l’assenza di conversazioni su X: con ogni probabilità X ospita discussioni attive su modelli, confronti e showcase di IA per immagini/video che questa ricerca non ha interrogato.
Limits
- I termini usati per questa raccolta non corrispondono al brief. Il brief richiede notizie su IA closed-source e open source per immagini/video; i dieci termini cercati non includono nomi di modelli, laboratori o prodotti di media generativi. Questo file non può quindi riportare i circa 20 post pertinenti richiesti, perché nel materiale sorgente non ce ne sono.
- Non sono stati cercati termini specifici della generazione immagini/video — nomi di modelli, laboratori, “text-to-video”, “diffusion”, progetti open source — quindi non è possibile affermare cosa dica X sul tema effettivo basandosi su questi dati.
- Anche la tabella delle tendenze della pagina Explore (
output/x.posts.mdrighe 13–24) è estranea al brief e geolocalizzata al luogo da cui la sessione ha raggiunto X — prevalentemente “Trending in Croatia”, oltre a due tendenze globali Sport/Politica — nessuna delle dieci riguarda l’IA. - Questo file riporta in modo trasparente il materiale più vicino disponibile invece di inventare risultati su IA per immagini/video che non compaiono nella fonte.
YouTube
YouTube — Riepilogo delle notizie sull’IA per immagini e video 🔥
Dopo aver cercato moltissimo su YouTube informazioni sull’IA per generazione di immagini e video, sia closed-source sia open source, ecco i risultati! Il settore si sta muovendo così velocemente che è difficile stare al passo 😂🍌
Channels
Canali che trattano davvero questo tema👇
- Matt Wolfe(Future Tools / @mreflow) — storico canale di notizie IA con oltre 900.000 iscritti. Pubblica riepiloghi settimanali degli annunci del settore. https://www.youtube.com/@mreflow
- Wes Roth(@WesRoth) — circa 320.000 iscritti. Approfondimenti su OpenAI, DeepMind e movimenti del settore, con circa quattro video a settimana. https://www.youtube.com/@WesRoth
- Theoretically Media(Tim) — canale di un filmmaker attivo che testa seriamente strumenti video generativi, da Runway e Seedance a LTX-2 open source. https://www.youtube.com/channel/UC9Ryt3XOGYBoAJVsBHNGDzA
- SECourses(Furkan Gözükara) — canale da 30.000–50.000 iscritti, molto forte nei tutorial per esecuzione locale di Stable Diffusion, FLUX e Qwen. https://www.youtube.com/@SECourses
- Canale ufficiale Google DeepMind — pubblica demo ufficiali di Nano Banana Pro (Gemini 3 Pro Image) e altri prodotti.
- Altri canali piccoli e medi dedicati alla ricerca IA e alle recensioni di strumenti producono molti contenuti su entrambi i fronti; in diversi casi il nome del canale non era identificabile dal solo titolo del video → vedi Limits.
Videos
Closed-source
- 「Google Flow NEW Update Just Changed AI Video and Image Creation Quick Review – AI News 2026」 — canale sconosciuto (notizie IA)/2026年2月28日/https://www.youtube.com/watch?v=SnRd9nn_644 — recensione dell’aggiornamento di Google Flow, lo strumento integrato con Veo, per immagini e video.
- 「Nano Banana Pro: Hands-on with the World's Most Powerful Image Model」 — 2025年11月25日/https://www.youtube.com/watch?v=hk6gwiZmSWA — prova pratica di Nano Banana Pro (Gemini 3 Pro Image), forte in rendering del testo e infografiche.
- 「Nano Banana 2 Is Incredible! (Gemini's New AI Image Model)」 — 2026年2月26日/https://www.youtube.com/watch?v=_oiBHvwTtGs — presentazione di Nano Banana 2, accessibile tramite Higgsfield.
- 「Gemini's New Image Model is a Game-Changer! Here's Nano Banana!」 — 2025年8月26日/https://www.youtube.com/watch?v=wXYQEaWM-rw — spiegazione dell’impatto iniziale di Nano Banana (Gemini 2.5 Flash Image).
- 「Grok's New FREE AI Video Generator Is INSANE」 & 「Grok Imagine Video 1.5 vs Seedance 2.0 | Full AI Video Test」 — 2026年6-7月/https://www.youtube.com/watch?v=lrCjbL51dbk 、https://www.youtube.com/watch?v=5mFkZiRTVu4 — confronto approfondito tra Grok Imagine 1.5 di xAI e Seedance 2.0.
- Raccolte di confronti video su più canali — proliferano contenuti Veo 3.1 vs Sora 2 e Seedance 2.0 vs Kling 3.0 vs Runway Gen-4.5. Veo 3.1 si differenzia per 4K e audio nativo; Sora 2 per il realismo della simulazione fisica.
- Video esplicativi sulla generazione video Adobe Firefly — prima metà del 2026 fino a luglio/Adobe ha introdotto un “assistente IA agentico” e un ambiente multimodello che incorpora Kling 3.0, Ray3.14, Runway Gen-4.5, Sora 2, Veo 3.1 e altri.
⚠️Notizia scioccante:Sora di OpenAI termina! Gli sviluppatori sono stati avvisati il 24 marzo 2026 → app e web sono terminati il 26 aprile → anche l’API di Sora 2 finirà completamente il 24 settembre 2026 (dieci giorni dopo la pubblicazione di questo report). Si parla di 1 milione di dollari di costi operativi al giorno contro ricavi totali di soli 2,2 milioni; OpenAI dovrebbe spostare le risorse verso coding ed enterprise. È una notizia davvero importante.
Open source
- 「Qwen-Image-Edit-2511 is now open source」 — 2026年1月4日/https://www.youtube.com/watch?v=UWy9Y1Ebjr4 — l’ultima versione di Qwen-Image-Edit di Alibaba diventa open source.
- 「Qwen Image Edit Review — Free Open-Source Alternative to Nano Banana」 — https://www.youtube.com/watch?v=Ur3udfFJ2QQ — presentato come alternativa gratuita open source a Nano Banana.
- 「Qwen Image-2512 First Test – The BEST Open Source Image Model!」 — 2025年12月31日/https://www.youtube.com/watch?v=SBaK616nP6Q
- 「Run Qwen Image Edit (2509) LOCALLY」 — 2025年10月1日/https://www.youtube.com/watch?v=ET1g_3Z_c0k — tutorial per l’esecuzione locale.
- 「Tencent's Hunyuan Image to Video AI Avatar: FREE & Open-source!」 — https://www.youtube.com/watch?v=n4M3c81F1Jk — modello open source Tencent per creare video-avatar da una singola foto e audio.
- 「Image 2 Video Open Source Breakthroughs! Hunyuan and LTX .9.5」 — https://www.youtube.com/watch?v=HIFyz0BQfck
- 「Wan 22 FLUX and Qwen Image Upgraded Ultimate Tutorial for Open Source SOTA Image and Video Gen Models」(SECourses関連)— https://www.youtube.com/watch?v=3BFDcO2Ysu4 — tutorial riepilogativo su Wan2.2, FLUX, FLUX Krea e Qwen Image, tutti aggiornati.
- 「LTX-2 Explained & Showcased: The Open-Source AI Video Model」 — https://www.youtube.com/watch?v=qdIcpORz1Mw
- 「The "Holy Grail" of Open Source AI Video is Here (LTX-2)」 — https://www.youtube.com/watch?v=27UAb_Tlv4E — LTX-2 di Lightricks, con 4K nativo, 50 fps e sincronizzazione audio, viene definito il “Santo Graal dell’open source”.
- 「LTX-2 Released opensource!」 — https://www.youtube.com/watch?v=wXv4qhS4Oc0
- 「Open Source AI Video BOMBSHELL From LTX & Minimax 2.3 Preview!」 — https://www.youtube.com/watch?v=N0XpMe94ENU
- 「NVIDIA'S $5,000 GPU?! + LTX-2 Open Source Video AI is HERE!」 — https://www.youtube.com/watch?v=XXRZOCz0Tzs — anche NVIDIA promuove LTX-2 con ottimizzazioni ComfyUI.
Informazioni su Wan 3.0:il 6 agosto 2026 Alibaba ha pubblicato la beta pubblica di Wan 3.0, con 30 secondi, 1080p, generazione simultanea dell’audio e supporto a input documentali. Tuttavia viene offerto soprattutto tramite Runway e API; diversamente dalla strada dei pesi completamente aperti Apache 2.0 seguita fino a Wan 2.2, va ancora verificato se i pesi siano stati pubblicati. Anche diversi video YouTube discutono se diventerà open source.
Signals
- 😱 Il fronte closed-source è una partita a sedie musicali:con l’uscita di fatto di Sora — app chiusa ad aprile e API a fine settembre — il panorama converge rapidamente su Veo 3.1, Seedance 2.0/2.5, Kling 3.0 e Runway Gen-4.5. I confronti YouTube ruotano quasi tutti attorno a questi quattro.
- 🍌 La serie “Nano Banana” di Google è diventata meme e standard de facto per le immagini: Nano Banana → Nano Banana Pro → Nano Banana 2 viene aggiornata a ritmo rapidissimo, fino a diventare il punto di riferimento nei titoli “X vs Nano Banana”.
- 🇨🇳 L’open source è chiaramente guidato dalla Cina:Alibaba con Qwen-Image e Wan, Tencent con Hunyuan. Canali tecnici come SECourses pubblicano numerosi tutorial per farli girare localmente.
- 🎬 LTX-2 di Lightricks è considerato il candidato principale per il video open source:4K nativo, 50 fps e audio sincronizzato a livello commerciale, ma aperto. Più canali usano titoli enfatici come “Holy Grail” e “BOMBSHELL”.
- 🎧 La generazione audio simultanea è la tendenza comune:Seedance 2.5, Veo 3.1, Wan 3.0 e LTX-2 puntano tutti alla generazione in un solo passaggio di video e audio. L’era del solo video sembra finire.
- 💰 I modelli di business mostrano divergenze nette:il caso Sora suggerisce una difficile sostenibilità economica per il closed-source; Adobe punta sull’enterprise e sulla sicurezza commerciale. L’open source, con licenze come Apache 2.0, continua invece ad alimentare comunità e modifiche.
- 🖌️ L’editing delle immagini è più caldo della generazione pura:Qwen-Image-Edit e le funzioni di Nano Banana Pro indicano un aumento dei tutorial dedicati a modificare foto con linguaggio naturale, anziché creare tutto da zero.
Limits
- Le pagine dei risultati di ricerca e watch di YouTube sono renderizzate via JavaScript: anche con fetch diretto non esponevano elenco reale, visualizzazioni, iscritti o commenti. Si è quindi fatto affidamento su ricerca web
site:youtube.com, titoli, canali e date; le visualizzazioni non sono state verificate per quasi tutti i video. - Per alcuni video, il nome del canale non era identificabile dal solo snippet di ricerca; nella lista compaiono quindi canali “sconosciuti”.
- Non è stato possibile determinare con certezza, dalla sola informazione YouTube, se Wan 3.0 sarà rilasciato con pesi completamente aperti come Wan 2.2 sotto Apache 2.0. Occorrono aggiornamenti.
- Rispetto all’obiettivo di circa 20 post, sono stati raccolti circa 19 video/argomenti tra open e closed source: quasi l’obiettivo. I vincoli tecnici hanno però impedito di leggere direttamente descrizioni e commenti principali delle singole pagine.
Bluesky
Bluesky — Ultime notizie sull’IA per immagini e video
Accounts
- @huggingfacetrends.bsky.social(tendenze Hugging Face giornaliere)— bot che pubblica ogni giorno cinque repository di tendenza Hugging Face. È stato l’account più utile per seguire i nuovi modelli open source. https://bsky.app/profile/huggingfacetrends.bsky.social
- @stabilityai.bsky.social — account ufficiale Stability AI. Post in stile comunicato stampa su Stable Audio, integrazione Bedrock e accordi con etichette musicali. https://bsky.app/profile/stabilityai.bsky.social
- @midjourneyofficial.bsky.social — account ufficiale Midjourney; ha annunciato l’arrivo su Bluesky nell’agosto 2025. Pubblica poco. https://bsky.app/profile/midjourneyofficial.bsky.social
- @civitai-bot.bsky.social — bot che pubblicava aggiornamenti su LoRA e checkpoint Civitai. Sembra fermo dal maggio 2024. https://bsky.app/profile/civitai-bot.bsky.social
- @curieuxexplorer.bsky.social e altri creatori che si definiscono “Creator Partner (CCP/CPP)” — molte persone pubblicano opere con titoli di ambasciatori ufficiali per Runway, Kling AI, Luma, Pika, Hailuo, Vidu e Freepik. Sono soprattutto showcase e promozione, non notizie. https://bsky.app/profile/curieuxexplorer.bsky.social
- Handle con nomi di grandi aziende, come @blackforestlabs.bsky.social, @runwayml.bsky.social e @klingai.bsky.social, esistono ma hanno feed vuoti o non corrispondono ai soggetti nominati; non hanno fornito comunicazioni effettive.
Posts
- Lightricks/LTX-2.5, modello open di generazione video, resta primo nelle tendenze Hugging Face — dal 07/09 al 13/09 è apparso in post di tendenza per almeno cinque giorni consecutivi. Il riepilogo README appare fallito, ma appartiene alla serie di modelli video open Lightricks. 13/09, like 0 / repost 0. https://bsky.app/profile/huggingfacetrends.bsky.social/post/3mvfrl5gc5z2l
- Qwen/Qwen3.8-27B, modello visione-linguaggio open con supporto a comprensione di immagini e video, entra ripetutamente in tendenza — post il 06/09, 08/09, 10/09 e 12/09. Descritto come forte in coding, ricerca e task multi-step. 12/09, like 0 / repost 0. https://bsky.app/profile/huggingfacetrends.bsky.social/post/3mvd6mv6ac72l
- deepseek-ai/DeepSeek-V4.1-Flash, MoE multimodale compatibile con immagini — post il 10/09 e il 12/09; presenta contesto fino a un milione di token e compressione cache FP4. 12/09, like 0 / repost 0. https://bsky.app/profile/huggingfacetrends.bsky.social/post/3mvd6csnao42h
- deepseek-ai/DeepSeek-V4-Flash-Vision-Exp, modello sperimentale con capacità visive — post del 07/09. Mantiene le prestazioni testuali aggiungendo comprensione visiva e capacità da agente multimodale. like 0 / repost 0. https://bsky.app/profile/huggingfacetrends.bsky.social/post/3muwta6mwoi2g
- zai-org/GLM-5.3-Flash, primo modello nativamente multimodale della serie GLM-5 — post del 06/09. Descritto con 320B parametri totali e 18B effettivi, prestazioni superiori a GLM-5.2 a costo inferiore. https://bsky.app/profile/huggingfacetrends.bsky.social/post/3muu3pjpou62n
- Stability AI avvia Image Services su Amazon Bedrock — espansione enterprise sul lato closed-source: annunciati strumenti professionali di editing immagini su Bedrock. 2025-09-18, like 0 / repost 0. https://bsky.app/profile/stabilityai.bsky.social/post/3lz5eotkuvk2i
- Stability AI collabora con Universal Music Group e Warner Music Group — non riguarda direttamente immagini/video, ma segnala il tono delle iniziative commerciali di un grande player generativo. 2025-10-30 / 2025-11-19, like 1 / repost 0. https://bsky.app/profile/stabilityai.bsky.social/post/3m4fwolv4k22z
- Midjourney annuncia Style Explorer — funzione per esplorare stili con una logica simile alla pagina Explore di immagini e video. 2025-09-18, like 10 / repost 2. https://bsky.app/profile/midjourneyofficial.bsky.social/post/3lz5cskktzk2c
- Midjourney annuncia il proprio arrivo su Bluesky — primo post: “Siamo arrivati su Bluesky, suggeriteci creatori”. 2025-08-15, like 41 / repost 4, il post più reattivo dell’account. https://bsky.app/profile/midjourneyofficial.bsky.social/post/3lwi222j4sk2b
- Ultimi post del bot Civitai, maggio 2024 — notifiche su LoRA personali e modelli merge basati su SD1.5/Pony, quasi sempre con 0–3 like. Restano traccia della cultura grassroots open source, ma nell’ultimo anno il bot è silenzioso. https://bsky.app/profile/civitai-bot.bsky.social/post/3ks2nnatkqi24
Signals
- Su Bluesky, le fonti di notizie sull’IA per immagini/video sono sostanzialmente bot come huggingfacetrends e civitai-bot, oltre agli account ufficiali di comunicazione aziendale come Stability AI e Midjourney. Non emergono conversazioni in tempo reale o thread vivaci come su X e Reddit.
- Il centro dell’attenzione è l’aumento di modelli open che “comprendono” i contenuti — visione-linguaggio e multimodalità — con Qwen3.8-27B, DeepSeek-V4 e GLM-5.3-Flash, grandi modelli open cinesi che occupano le tendenze Hugging Face. LTX-2.5 è il modello più costantemente in tendenza per la generazione vera e propria di immagini/video.
- I player closed-source, Stability AI e Midjourney, pubblicano soprattutto partnership enterprise e piccoli aggiornamenti. Non sono stati osservati nuovi lanci di modelli spettacolari nel periodo.
- Esistono moltissimi account personali che si definiscono Creator/Community Partner di Midjourney, Runway, Kling, Luma e altri, fungendo da hub per esempi e promozione. I contenuti sono però soprattutto showcase, spesso datati, non notizie.
- Esistono più account vuoti o potenzialmente impersonatori con handle simili a quelli di aziende reali — runwayml.bsky.social, klingai.bsky.social, real-comfyui.bsky.social — quindi occorre cautela nel considerarli fonti ufficiali.
Limits
- Bluesky è una SPA renderizzata sul client: recuperare direttamente bsky.app non ha restituito corpo dei post, like o date, perché WebFetch non esegue JavaScript.
- L’API pubblica
public.api.bsky.app/xrpc/app.bsky.feed.searchPostsper la ricerca full-text ha restituito costantemente403 Forbiddene non è stata utilizzabile. Nello stesso dominio funzionavano getProfile, getAuthorFeed e searchActors: sembra bloccato soltanto l’endpoint di ricerca. - I mirror per embed, come fxbsky.app, reindirizzavano a bsky.app e non permettevano di recuperare i contenuti.
- A causa di tali vincoli, si è passati dal search full-text a un percorso alternativo “ricerca account → getAuthorFeed”. Sono stati controllati oltre 20 account/post, ma il campione è distorto verso gli account trovati e non descrive la conversazione complessiva di Bluesky.
- Gli handle apparentemente ufficiali di Runway, Black Forest Labs, Kling AI, ComfyUI e altri sono stati trovati, ma avevano feed vuoti; questa raccolta non contiene quindi fonti primarie Bluesky da tali aziende.
Lemmy
Lemmy — L’IA per immagini e video non è una “festa” su Lemmy
Communities
- !«メールアドレス»(consultabile tramite lemmy.world) — 5,71K iscritti, di cui 1,23K locali su lemmy.world. Descrizione: “Discuss matters related to our favourite AI Art generation technology”. https://lemmy.world/c/«メールアドレス»
- !«メールアドレス»(consultabile tramite lemmy.world) — 8,53K iscritti, di cui 2,34K locali. https://lemmy.world/c/«メールアドレス»
- !«メールアドレス» — errore HTTP 500 durante l’accesso; non è stato possibile verificarne i contenuti. https://lemmy.world/c/ai_art
- !«メールアドレス» — 88.016 iscritti. Non specializzato in IA per immagini/video, ma vi compaiono occasionalmente link di notizie.
- !«メールアドレス» — 8.208 iscritti. Comunità per chi rifiuta l’hype IA, soprattutto LLM/GPT venduti commercialmente; qui confluiscono anche reazioni negative all’IA per immagini/video.
- !«メールアドレス» — 41.395 iscritti. Non specializzata, ma ospita occasionalmente thread di opinioni sull’IA generativa.
Posts
- Il feed di !«メールアドレス» è un mirror di bot, con quasi zero conversazioni umane — ordinando sia per Nuovi sia per TopMonth, i 20 post recenti sono ripubblicazioni automatiche di modelli e strumenti GitHub/HuggingFace; commenti quasi sempre zero e punteggi circa 1–10. Esempi:
Lightricks/LTX-2.5-22b-IC-LoRA-Ingredients(2026-09-12, punteggio 3, 0 commenti, https://huggingface.co/Lightricks/LTX-2.5-22b-IC-LoRA-Ingredients),lightx2v/Minimax-h3-Turbo - 8 step 768p V1.0 LoRA released(2026-08-27, punteggio 6, 0 commenti, https://huggingface.co/lightx2v/Minimax-h3-Turbo),Viggle/Viggle-Animate(2026-09-05, punteggio 10, 0 commenti, https://huggingface.co/Viggle/Viggle-Animate). Lo sviluppo open source è attivo — LoRA/adapter MiniMax-H3, estensioni ComfyUI comeComfyUI-VDN-H3-24GB,ComfyUI-InpaintCanvas,ComfyUI-Tab-Sticky-Extention— ma la comunità non funziona come luogo di discussione. - 「Did you know?」(«メールアドレス», !«メールアドレス», fine agosto 2026 circa = 19 giorni prima al momento della raccolta) — punteggio 39 (vista federata: 55 up/16 down), 3 commenti. Davanti a un’immagine IA di curiosità, i commenti sono sarcastici: grammatica strana (“Have you know?”), “Artificial Intelligence meets Natural Stupidity”. L’unico commento pragmatico propone di usare l’IA per rifinire, non per ideare. https://lemmy.world/post/51117779
- 「What's your overall opinion on generative AI?」(LeftReddit2, !«メールアドレス», 10 giorni prima della raccolta) — 54 up/9 down, 49 commenti, il post con la discussione più vivace della ricerca. L’autore dice di essere passato dall’entusiasmo iniziale per ChatGPT/DALL-E allo scetticismo dal 2024. I commenti principali sono generalmente negativi: critiche all’addestramento non autorizzato, riferimento alla “psicosi da IA”, denuncia della perdita di lavoro per gli scrittori. https://lemmy.world/post/51505799
- 「Gen Z's AI backlash is getting louder」(«メールアドレス», World News, 4 mesi prima della raccolta) — 125 up/1 down, 5 commenti. Condivisione di un articolo sul contraccolpo generazionale contro l’IA; i commenti virano verso sarcasmo sui data center e conflitto di classe “il mondo contro l’1%”. https://lemmy.world/post/47211056
- 「Found a 3 year old SD install on my computer, so here is some vintage Dreamshaper 7」(«メールアドレス», !«メールアドレス», 2 mesi prima della raccolta) — punteggio 6, 0 commenti. Post nostalgico che mostra il silenzioso uso continuativo di Stable Diffusion da parte degli utenti open source di lunga data. https://lemmy.world/post/48977635
- 「Modern Tram - generated by Lumo (the proton ai)」(«メールアドレス», !«メールアドレス», 1 mese prima della raccolta) — punteggio 0, 6 commenti. Immagine generata con Lumo AI di Proton. Poco interesse per l’opera, ma discussione su come scegliere servizi IA, incluso il valore della privacy con Proton. https://lemmy.world/post/50175271
- 「It's like an album cover...」(«メールアドレス», !«メールアドレス», 1 mese prima della raccolta) — punteggio -8, 1 commento. Uno dei pochi post con punteggio negativo, simbolo di una reazione fredda verso l’arte generata dall’IA. https://lemmy.world/post/50411980
- Le ricerche dirette per Sora / Veo / Midjourney / Grok Imagine e altri modelli commerciali non hanno trovato post recenti indipendenti su lemmy.world — sono apparsi solo post vecchi su Sora, del 2023–2024, con articoli critici verso OpenAI, come https://lemmy.world/post/44721138, oppure risultati irrilevanti come una campagna non correlata “#BringSoraHome”. Non sono stati trovati riferimenti recenti a Sora2/Veo3/Nano Banana/Flux.2/Qwen Image/Wan 2.5/Seedream.
Signals
- Le comunità Lemmy relative alla generazione di immagini si dividono in “feed di sviluppo” e “spazi di espressione del sentimento anti-IA”. !«メールアドレス» è dominata da bot che rilanciano modelli, LoRA e nodi ComfyUI da HuggingFace/GitHub, quasi senza commenti.
- In !«メールアドレス», !«メールアドレス» e comunità di notizie, prevalgono opinioni negative sull’IA generativa: addestramento non autorizzato, impatto ambientale e “slop”, ovvero contenuti generati di bassa qualità.
- Comunità di meme importanti — !«メールアドレス», !«メールアドレス» e !«メールアドレス» — vietano esplicitamente i contenuti generati dall’IA nelle loro regole. Il rifiuto culturale è forte sull’intera piattaforma.
- Non sono state trovate notizie rapide o post popolari sui più recenti modelli commerciali, come Sora 2, Veo 3, gli ultimi Midjourney o Grok Imagine. Su Lemmy conta più la reazione sociale ed etica ai contenuti IA che il rilascio dei singoli modelli.
- Sul lato open source, MiniMax-H3, LTX e le estensioni ComfyUI mostrano sviluppo attivo, ma sotto forma di feed per sviluppatori e non come tema diffuso fra utenti generici.
Limits
- Lemmy è una piattaforma relativamente piccola e non è stata trovata una comunità attiva specializzata in IA per immagini/video. Non esistono abbastanza post indipendenti di qualità — escludendo i repost automatici e gli elementi senza commenti — per arrivare ai circa 20 richiesti.
- !«メールアドレス» ha restituito HTTP 500 e non è stato possibile esaminarlo.
- Le ricerche dirette su lemm.ee e lemmy.ml con query come image generation AI / video generation AI restituivano spesso risultati poco pertinenti, come articoli politici o recensioni di giochi: il ranking di rilevanza dell’API Lemmy è debole. Per evitare di gonfiare il conteggio, sono inclusi solo post effettivamente verificati.
- Non sono stati trovati riferimenti diretti ai modelli recenti del 2026 — Sora 2, Veo 3, Nano Banana, Flux.2, Qwen Image, Wan 2.5, Seedream — né tramite motore di ricerca né API. Questo è registrato come segnale che tali modelli non sono diventati argomento di discussione su Lemmy.
Pinterest — Notizie sull’IA per la generazione di immagini e video
Sono stati raccolti in totale 50 pin! Non c’era una classificazione per generi: erano tutti nel solo gruppo g01, quindi analizziamoli insieme📌
Visual themes 🎨
- Miniature del tipo “volto di uomo che urla + grande scritta AI NEWS + molti loghi aziendali” molto frequenti: il vortice di OpenAI, la G di Google, la finestra Windows di Microsoft, l’infinito di Meta, la balena DeepSeek e il logo Nvidia compaiono spesso. L’espressione è quasi sempre una sorpresa del tipo “davvero!?”
[5, 17, 24, 37, 44] - Infografiche “le migliori X IA video” prodotte in serie, con colori diversi: la sequenza Runway, Pika, Kling AI, Luma Dream Machine, Canva AI e Hailuo AI viene ripetuta quasi identica. CapCut, Synthesia, HeyGen e Descript vengono aggiunti nei ruoli di editing/avatar
[9, 10, 21, 29, 47] - Immagini stock di volti robotici/cyborg luminosi in blu e viola come copertine di pin prodotti in massa: vengono riutilizzate come immagini “genericamente IA”, spesso senza rapporto diretto con la notizia
[2, 36, 42, 49, 50, 45] - Visual di ansia e verifica sul problema “forse è IA”: timbri di falso, barre che indicano 97% di probabilità di fake e confronti “Human Journalism” vs “Machine-Generated Media” rendono visiva la preoccupazione per rilevamento e affidabilità
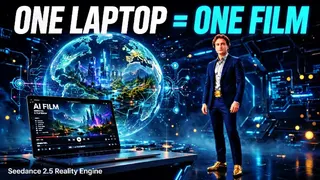
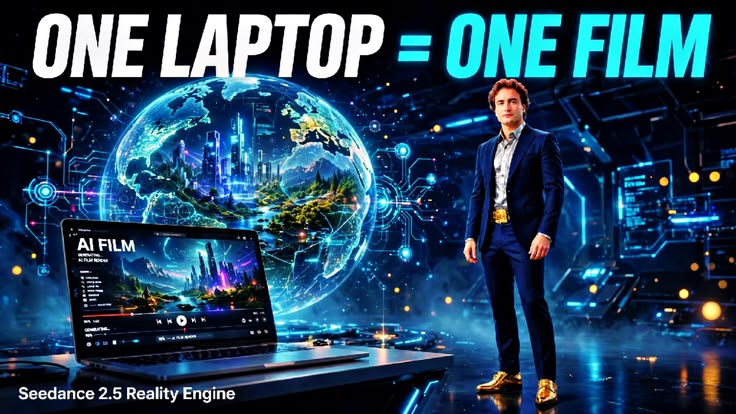
[4, 11, 40] - Gli still promozionali ufficiali dei grandi player closed-source — Google, ByteDance e ShengShu — condividono uno stile cinematografico coerente: Veo 2/3 mostra demo fotorealistiche come cani sott’acqua e fenicotteri; Seedance 2.5 presenta un uomo in completo dorato con il messaggio “un laptop, un film”; Vidu S1 punta su ragazze anime cyberpunk
[3, 6, 8, 13, 33, 48] - Alcuni grafici tecnici sono più sostanziosi: pipeline di modelli di diffusione — Text Embedding→64x64→1024x1024 — e cronologie dell’IA generativa, da ELIZA negli anni 1950 a GPT negli anni 2020
[31, 43] - Più mockup in stile giornale/rivista di notizie: disegni come “THE AI DISPATCH” e “Today's AI News”, pieni di parole chiave come Open Models, Sovereign AI e AI Agents
[32, 39]
Notable pins 📌
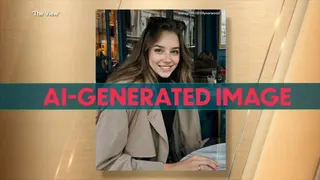
[1]Hollywood Reporter Interviews the First AI Actress… — screenshot di The View in cui un’immagine IA Instagram di “@tillynorwood” ha sopra un banner rosso “AI-GENERATED IMAGE”. È il pin più concreto per mostrare come la controversia sull’attrice IA Tilly Norwood sia arrivata alla televisione mainstream.[28]ByteDance and Hollywood reach global deal on AI copyright — screenshot di un articolo che riferisce un accordo fra ByteDance e Motion Picture Association per la protezione del copyright negli strumenti IA per immagini/video. Mostra il mutamento dei rapporti di forza fra grandi aziende closed-source e industria dei media tradizionali.[48]🐉 China Just Took AI Video Too Far|ByteDance Seedance 2.5 — promozione di Seedance 2.5 con un visual lussuoso maschile e la scritta “ONE LAPTOP = ONE FILM”. Titolo che cavalca la forza dei modelli closed-source cinesi.[33]Vidu S1 — The World's Most Advanced Model for Real-Time AI Interaction — modello in tempo reale di ShengShu Technology, azienda cinese. Il visual anime cyberpunk sembra puntare sulla coerenza dei personaggi.[13]Veo 3 Image-to-Video: Fast Generation & Native Audio via Gemini API — pin-annuncio secondo cui Veo 3 di Google supporta conversione immagine-video e generazione audio nativa tramite Gemini API.[31]OpenAI's Secret Image Generation Tool to Debut Soon — pin basato su voci su uno strumento immagini non annunciato di OpenAI. Il contenuto è superficiale, ma comunica aspettativa.[6]Demo di trasformazione “blocchi di legno”, “origami”, “Lego” e “fiori” — griglia di demo che trasforma in tempo reale lo stesso video di persona/auto in varie texture: legno, origami, blocchi colorati e fiori. È il caso più elaborato di showcase per IA video di trasferimento di stile.[40]AI IS CHANGING EVERYTHING — infografica con uno strumento di rilevamento audio IA che riporta “97% LIKELY AI GENERATED”. Visualizza la corsa fra generazione e rilevamento.[11]New York's Bold Gambit: Inside the Legislative… — grafico con Statua della Libertà e Campidoglio che contrappone “Human Journalism” e “Machine-Generated Media”, suggerendo mosse legislative contro le notizie generate dall’IA.[41]Nvidia #NEW AI Tools — fotografia di un relatore in giacca di pelle nera, simile a Jensen Huang. Spicca come notizia IA vista dal lato hardware/GPU.
Signals 📡
- La guerra dei modelli video closed-source è chiaramente protagonista:nuovi modelli di Google Veo 2/3, ByteDance Seedance 2.5 e ShengShu Vidu S1 si susseguono, mentre loghi aziendali — soprattutto OpenAI, Google, Nvidia e DeepSeek — diventano il volto delle miniature “AI News”.
- La preoccupazione per la credibilità del reale è ormai un tema stabile:barre di rilevamento fake, timbri di falso, confronti Human vs Machine e la controversia sull’attrice IA Tilly Norwood sono tutti argomenti normali anche su Pinterest.
- Copyright e regolamentazione iniziano a comparire come notizie:accordo ByteDance×MPA e iniziative legislative di New York mostrano un clima che passa dal “si può creare” al “come regolamentarlo”.
- Pinterest mantiene però una forte impronta SEO/affiliazione di raccolte e presentazioni di strumenti:la stessa lista Runway/Pika/Kling/Luma/Canva/Hailuo viene ripetuta, facendo apparire la piattaforma più orientata a liste evergreen da salvare che a notizie tempestive.
- L’open source ha una presenza assai ridotta:nomi come Stable Video Diffusion, Wan e HunyuanVideo appaiono soltanto come voci in liste di tool. Non ci sono pin di notizie indipendenti; la spiegazione tecnica della diffusione
[31]è quasi l’unico contenuto più rigoroso vicino alle tecnologie aperte.
Limits 🚧
- La raccolta Pinterest è stata effettuata in anticipo dal worker tramite browser headless; questa analisi non ha effettuato ricerche o navigazione diretta su Pinterest, secondo il playbook.
- Non era presente una divisione per generi: tutti i 50 elementi appartenevano al solo gruppo g01, perciò non è possibile confrontare ripartizioni per tema.
- Cinque pin avevano titolo “(untitled)” — fra
[3, 12, 18, 24, 28... ]gli effettivi erano ad esempio[3, 12, 18, 24, 32]— e parte del contesto è stata inferita dalle immagini. In particolare,[24]contiene pochi dettagli leggibili. - Molti pin sono immagini di affiliazione/blog “migliori X strumenti”; non sono state lette data di pubblicazione né articolo sorgente completo, e le interpretazioni derivano dal testo visibile nell’immagine.
- L’obiettivo complessivo di almeno 10 insight per closed-source e open source va soddisfatto sommando Reddit, X, YouTube, Bluesky e Lemmy. Pinterest mira soprattutto a capire quali visual stiano circolando, quindi non si sono verificati problemi particolari di link interrotti o caricamenti falliti.
Azioni consigliate
- Valutare e confrontare i workflow video assumendo una struttura in due passaggi: “definire il personaggio con un modello d’immagine → animarlo con un’IA video”.
- Per le proof of concept di video open source, dare priorità alle famiglie LTX-2 e Wan, continuando a monitorare l’annuncio di licenza di Wan 3.0.
- Per il video closed-source, confrontare costi e prestazioni dei quattro leader Seedance 2.5, Veo 3.1, Kling 3.0 e Runway Gen-4.5, includendo le differenze di prezzo — Seedance costa circa tre volte tanto.
- Prima di sottoscrivere servizi closed-source che promettono “illimitato”, verificare sempre i limiti reali di generazione e i tempi di attesa.
- Creare regole operative interne per i rischi legali dei contenuti generati, concentrandosi sulla responsabilità nelle fasi di distribuzione e condivisione più che sulla sola generazione.
- Nella prossima raccolta X, sostituire le parole chiave con termini relativi all’IA per immagini e video, come nomi di modelli e laboratori.
Immagini raccolte








Nota sulla qualità dei dati
Su X, le parole chiave di ricerca erano estranee al tema, quindi non sono stati trovati post sull’IA per immagini e video. Anche Lemmy non disponeva di comunità dedicate e attive sufficienti a raggiungere l’obiettivo di 20 elementi. Reddit, Bluesky, YouTube e Pinterest hanno fornito dati generalmente utili, seppur con alcune lacune tecniche, come l’errore 403 dell’API di ricerca Bluesky e i limiti di rendering JavaScript di YouTube.