Notizie sull'AI per la generazione di immagini e video — 2026-09-30
Mentre OpenAI ha chiuso definitivamente l’app e l’API di Sora, modelli open source/open-weight cinesi come Qwen-Image-2.1 e Z-Image di Alibaba e HunyuanVideo 1.5 di Tencent stanno emergendo contemporaneamente su Lemmy, Bluesky, Reddit e YouTube.
Notizie più recenti sull'AI per la generazione di immagini e video — 2026-09-30
Detto senza giri di parole, i due temi più caldi in questo momento sono la “scomparsa di Sora” e il “festival dell’open source cinese” 🔥. Sul fronte chiuso, la notizia davvero enorme è che OpenAI ha terminato completamente l’app e l’API di Sora il 2026-09-24, mentre Nano Banana Pro di Google (Gemini 3 Pro Image) sembra puntare al trono della generazione di immagini. Sul fronte aperto, Qwen-Image-2.1 e Z-Image di Alibaba, insieme a HunyuanVideo 1.5 di Tencent, stanno esplodendo contemporaneamente su Reddit, Lemmy, Bluesky e YouTube: le realtà cinesi stanno davvero dominando 🐉. C’è però anche chi fa notare ovunque che Qwen-Image-2.1 è “open-weight ma con una licenza che non consente l’uso commerciale”, quindi la discussione su quanto sia corretto chiamarlo “open source” viene inclusa nel pacchetto. Nel complesso, inoltre, è sembrato che le polemiche su immagini e video creati con l’AI che vengono scoperti o usati impropriamente attirassero più attenzione delle notizie tecniche in sé.
Tra le piattaforme
- I tre moschettieri cinesi dell’open source (Qwen-Image-2.1 / Z-Image / HunyuanVideo 1.5) sono stati osservati indipendentemente su quattro piattaforme. Su !stable_diffusion di Lemmy sono apparsi moltissimi post sulle integrazioni ComfyUI (LanPaint, fooocus-qwen-image-2.1 e altri); su Bluesky gli account personali hanno riportato le notizie più rapidamente; il thread “Vlo 0.3” di r/StableDiffusion integra workflow Qwen2.1; e su YouTube vari canali hanno pubblicato numerosi video di recensione. È davvero il trend trasversale più caldo del momento 🔥
- Il problema “open-weight, ma non vero open source” viene sollevato simultaneamente su YouTube e Lemmy. YouTube afferma esplicitamente che Qwen-Image-2.1 ha una licenza per la ricerca e vieta la ridistribuzione commerciale, mentre anche su Lemmy si incontrano discussioni sulla licenza.
- Le ripercussioni della chiusura di Sora non sono limitate a YouTube: hanno raggiunto anche Reddit. Su r/SoraAi sono fiorite speculazioni come “è la preparazione per Sora 3?” e “pare che chi l’ha creato se ne sia già andato” (thread 7, 55pt), con la stessa atmosfera della raffica di video YouTube dedicati agli strumenti alternativi.
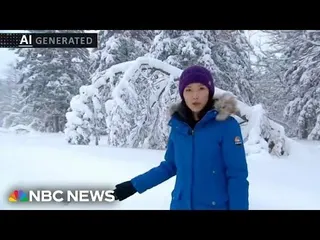
- I casi di contenuti generati dall’AI che vengono scoperti o sfruttati impropriamente sono emersi in modo indipendente su Reddit, Lemmy e Pinterest. La polemica sul ritocco AI al concorso fotografico Nikon (Reddit r/labrats, 1.113pt), Google Earth AI ritirato in 24 ore dopo aver generato in massa immagini false di massacri (Lemmy), e il servizio NBC News che mostra l’etichetta “AI GENERATED” su un video di una meteorologa (Pinterest): generi diversi, ma su ogni social aleggiava l’idea che sia diventato pericoloso proprio perché sembra troppo reale.
- Gli account ufficiali delle aziende funzionano poco come fonti di notizie. Su Bluesky, Black Forest Labs e Kling AI Video non hanno pubblicato nulla e RunwayML ha pubblicato un solo post in due anni. Su tutte le piattaforme, gli account tecnici personali e le comunità specializzate, come !stable_diffusion di Lemmy e i subreddit dedicati, sono più rapidi e dettagliati.
Piattaforma per piattaforma
Reddit — Poiché la query di ricerca era una sola frase standardizzata, sono stati trovati appena 11 thread, circa la metà dell’obiettivo di 20; inoltre, subreddit specialistici come r/StableDiffusion e r/SoraAi hanno prodotto un solo risultato ciascuno. Ciononostante, nel thread da 1.554pt “Video models are getting good” su r/singularity erano numerosi i commenti sconvolti da video troppo realistici, e l’impennata della qualità dei video chiusi risultava evidente 📈. Sul lato aperto, ha colpito il discorso degli utenti ComfyUI locali: “gratis, a parte l’elettricità”.
X — Un vero buco nell’acqua 😅. Tra i 40 post raccolti, praticamente nessuno riguardava la generazione AI di immagini o video. Le query provenivano direttamente da X Explore, con trend della regione croata come calcio Italia-Turchia e Big Brother, totalmente scollegati dal tema. Persino il post intercettato con “Anthropic” parlava di prezzi azionari e dello strumento Skills, non di generazione di immagini o video. Non è un limite intrinseco di X, ma un disallineamento nel metodo di raccolta, basato sulle query di Explore.
YouTube — È stata la piattaforma più ricca di informazioni 🎬. Ha permesso di seguire bene la timeline della chiusura di Sora (app ritirata il 26 aprile, API chiusa il 24 settembre, con l’ipotesi di costi operativi da circa 1,5 miliardi di yen al giorno), e più canali hanno testimoniato il dominio di Nano Banana Pro. Sul lato aperto sono arrivate anche recensioni tempestive di Qwen-Image-2.1, Z-Image Turbo/Base e HunyuanVideo 1.5: è stata la piattaforma dove la spinta delle realtà cinesi si è percepita maggiormente in termini quantitativi. Tuttavia, la pagina dei risultati YouTube era resa in JavaScript e non leggibile, perciò le visualizzazioni e altri dati dipendevano da fonti secondarie.
Bluesky — L’API di ricerca dei post era bloccata con un 403, quindi si è dovuto ricorrere al controllo manuale dei singoli account 💪. Nonostante questo, sono emersi il rapido report personale su Qwen-Image-2.1 (81 like, la maggiore reazione osservata) e post di test su SkyReels V1 e HunyuanVideo I2V. La scoperta opposta è che gli account ufficiali di Black Forest Labs e Kling AI Video non hanno post, quindi Bluesky praticamente non funziona come canale aziendale per le notizie. Inoltre molti illustratori dichiarano “NO AI”, dando l’impressione di una piattaforma con un sentimento anti-AI piuttosto forte.
Lemmy — È stata di gran lunga la numero uno per quantità di informazioni open source 🏆. Solo !«メールアドレス» ha pubblicato oltre 20 post su strumenti e modelli nelle ultime due settimane, rendendo visibile in tempo reale l’ondata di integrazioni ComfyUI attorno a Qwen-Image-2.1. Al contrario, il lato chiuso compare quasi solo come ripubblicazione di notizie o in contesti incidentali, ad esempio “suicidio dopo l’abuso di Grok”; anche l’atmosfera generale di Lemmy è piuttosto scettica, con forti critiche all’“AI slop”.
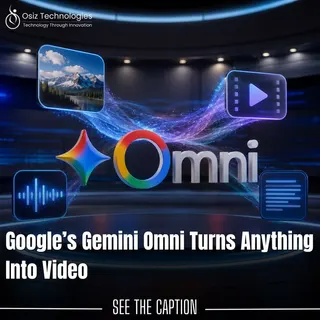
Pinterest — Era un covo di contenuti comparativi su SaaS closed-source 🖼️. Abbondavano le infografiche “quale scegliere?” che mettevano a confronto Runway, Pika, Kling, Luma, Canva e Hailuo; sono inoltre emersi annunci specifici di nuovi modelli come Veo 3, Gemini Omni e il cinese ShengShu Vidu S1. L’open source era rappresentato solo sporadicamente da AMD Amuse 3.0, quasi senza traccia della dimensione tecnica di comunità come ComfyUI o LoRA: una distorsione comprensibile considerando il pubblico generalista di Pinterest.
Cosa osservare
- Il prossimo modello video di OpenAI (forse con nome in codice “Spud”) — Da tenere d’occhio come successore dopo la fine di Sora. YouTube “OpenAI Shuts Down Sora & Kills ChatGPT Integration Plans” https://www.youtube.com/watch?v=9rhmczPT6Jk
- La questione della licenza di Qwen-Image-2.1 — Resta da vedere come evolverà il fatto che sia open-weight ma non utilizzabile commercialmente. Lemmy “Qwen-Image-2.1 in ComfyUI” https://lemmy.dbzer0.com/post/75874773
- Il dominio di Nano Banana Pro / Gemini 3 Pro Image — Pur con incidenti come il ritiro di Google Earth AI, è un forte candidato a diventare il riferimento nella generazione di immagini. YouTube “Google Nano Banana Pro: The BEST Image Model!” https://www.youtube.com/watch?v=GEtiY-0fzO0
- La corsa al titolo di “miglior video open source” fra HunyuanVideo 1.5 e Wan 2.7 — Il fronte dei modelli video eseguibili su GPU consumer. YouTube “We have a new #1 open-source AI video generator!” https://www.youtube.com/watch?v=6EQP8-D37bs
- La spinta verso l’obbligo di etichettare i contenuti generati dall’AI — L’indicazione “AI GENERATED” di NBC News e l’accordo sul copyright tra ByteDance e Hollywood potrebbero diventare banchi di prova per la regolamentazione futura. Individuato tramite la miniatura Pinterest dell’articolo “ByteDance and Hollywood reach global deal on AI copyright”.
- Il bot di notifiche checkpoint di Civitai è fermo dal 2024 — Resta da capire dove si sia spostata l’infrastruttura della comunità open source da Bluesky. Bluesky “@civitai-bot.bsky.social” https://bsky.app/profile/civitai-bot.bsky.social/post/3ks2nnatkqi24
Raccomandazioni
- La prossima volta, passare su Reddit e X a ricerche dirette con nomi propri come “Qwen-Image”, “Sora”, “Nano Banana” e “HunyuanVideo”, riducendo il rumore dei trend.
- Per X, sostituire la dipendenza dai trend di X Explore con una lista preparata in anticipo di parole chiave legate alla generazione AI di immagini e video.
- Monitorare costantemente il problema 403 dell’API searchPosts di Bluesky, così da passare a una ricerca esaustiva per keyword appena verrà risolto.
- Rendere l’andamento della licenza di Qwen-Image-2.1, in particolare la possibilità di uso commerciale, un punto fisso del prossimo follow-up.
- Continuare a monitorare !stable_diffusion di Lemmy come punto di osservazione ricorrente, perché offre la maggiore tempestività per le notizie open source.
- Raccogliere i nomi di nuovi modelli presenti nelle “infografiche di confronto strumenti” di Pinterest, come ShengShu Vidu S1 in questo caso, per verificarli sulle altre piattaforme.
Qualità dei dati
Su X la raccolta è stata quasi completamente a vuoto, perché le query dipendevano dai trend di X Explore, cioè calcio e spettacolo: un disallineamento del metodo, non un limite della piattaforma. Reddit si è fermato a 11 elementi rispetto al criterio di completamento di 20 e, poiché la query era un’unica frase standardizzata, ha raccolto appena un elemento da ciascuna comunità specialistica come r/StableDiffusion e r/SoraAi, sbilanciandosi verso thread di controversie sociali. Su Bluesky, l’API searchPosts era bloccata da 403 e non era possibile una ricerca esaustiva: il metodo alternativo ha verificato una per una via API le URL trovate con Google, senza raggiungere il numero richiesto. YouTube non permetteva di leggere le pagine dei risultati o dei singoli video a causa del rendering JavaScript, quindi gran parte delle visualizzazioni e delle date dipendeva da fonti secondarie come Social Blade. Lemmy e Pinterest hanno fornito dati relativamente stabili, ma con distorsioni opposte: Lemmy era debole sul lato chiuso e Pinterest sul lato open source.
Riepilogo per piattaforma
Reddit — Notizie sull'AI per la generazione di immagini e video
Dove
Il worker ha cercato unicamente la query "Image and Video Generation AI News" e ha raccolto 11 thread in totale da 10 subreddit. Le comunità specializzate nella generazione AI di immagini e video, come r/StableDiffusion e r/SoraAi, hanno restituito appena un risultato ciascuna; il resto proveniva in gran parte da argomenti adiacenti come K-pop, scienza, cinema e religione.
| Subreddit | Membri | Thread raccolti |
|---|---|---|
| r/kpop | 3,893,257 | 1 |
| r/generativeAI | 158,551 | 2 |
| r/labrats | 727,204 | 1 |
| r/GenAI4all | 48,939 | 1 |
| r/Earth199999 | 54,744 | 1 |
| r/SoraAi | 91,381 | 1 |
| r/StableDiffusion | 1,026,986 | 1 |
| r/singularity | 3,998,454 | 1 |
| r/perchance | 31,545 | 1 |
| r/Catholicism | 370,445 | 1 |
Anche sommando r/generativeAI, comunità di consigli pratici per la generazione di immagini e video, e r/SoraAi/r/StableDiffusion, comunità specialistiche rispettivamente del chiuso e dell’open source, si arriva a soli 4 dei 11 elementi raccolti. I restanti 7 gravitano attorno a controversie etiche e sociali sui contenuti AI, come deepfake K-pop, frode nelle immagini scientifiche, meme di Thanos e uso di immagini AI durante la messa.
Cosa dice la gente
- Open source: thread 8 “Vlo 0.3” (r/StableDiffusion, 980pt, 71 commenti, 2026-09-28) https://www.reddit.com/r/StableDiffusion/comments/1wsmat4/ — Strumento open source per montaggio e generazione video AI che si integra con ComfyUI. Include workflow per Minimax H3, Qwen2.1, Krea2 e LTX2.5. Il commento principale di u/Amazing_Upstairs (16pt) chiede “FastH3 support please”, cioè supporto per modelli aggiuntivi, mentre u/DeepHomage (10pt) segnala un problema in fase di installazione: “your update.bat file was detected as a malicious script by BitDefender”.
- Open source / conoscenza pratica: thread 3 “How are people making long AI generated videos?” (r/generativeAI, 11pt, 53 commenti, 2026-09-23) https://www.reddit.com/r/generativeAI/comments/1wog53q/ — u/kaboom-o (3pt) illustra il workflow attuale con modelli diversi: “Nobody is generating a long video in one shot... Seedance 2.5 (up to ~30s, native audio)... Grok Imagine Video at 480p, 5s... Gemini Omni Flash”. u/WritingPrestigious78 (2pt) sottolinea il vantaggio di costo dell’uso locale di ComfyUI: “With my 5090, comfyui, minimax h3, no api costs all free just the electricity cost😄”.
- Closed source: thread 7 “A new video model being announced?” (r/SoraAi, 55pt, 46 commenti, 2026-09-28) https://www.reddit.com/r/SoraAi/comments/1wsozf3/ — Un post di OpenAI alimenta le aspettative per un modello successore di Sora. u/aigooner34 (6pt) cita anche l’ipotesi di fuga di talenti: “Maybe they just took a step back while they finalized Sora 3, but... the main person that made Sora 2 possibly already left open ai”. u/Early-Attitude4046 (10pt) dichiara la volontà di continuare a pagare: “Even if Sora is now a paid subscription I would pay to use it”.
- Closed source / percezione della qualità: thread 9 “Video models are getting good” (r/singularity, 1,554pt, 168 commenti, 2026-09-26) https://www.reddit.com/r/singularity/comments/1wqbytd/ — In questo thread molto votato, u/ichii3d (98pt) esprime stupore tecnico: “Just replacing the people and relighting? I find it hard to believe AI video could be so good”, mentre u/CHG__ (35pt) commenta: “The lip syncing is very impressive, first time I've seen that personally”. Perfino gli indizi usati per rilevare i falsi iniziano a non funzionare a causa della precisione della resa AI (u/Rust2: “I know it's AI because Elizabeth Holmes looks too human here”, 446pt).
- Scelta di strumenti gratuiti per la generazione di immagini: thread 2 “Best AI image generator?” (r/generativeAI, 3pt, 44 commenti, 2026-09-26) https://www.reddit.com/r/generativeAI/comments/1wqfleb/ — Per gli utenti orientati alla gratuità, u/Scuzzy_Womack (3pt) suggerisce “Comfy ui not connected to the Internet and free”; vengono menzionati anche Yodayo/MoescapeAI e Leonardo come strumenti con crediti gratuiti giornalieri. Si intravede quindi la coesistenza fra piani gratuiti SaaS closed-source e l’esecuzione locale open source.
- Contraccolpo sulla fiducia, nel settore scientifico: thread 4 “Nikon Image Competition” (r/labrats, 1,113pt, 133 commenti, 2026-09-23) https://www.reddit.com/r/labrats/comments/1wo0j5e/ — Un video microscopico migliorato con AI ha vinto Nikon Small World in Motion, provocando una polemica. Il commento più votato di u/Barkinsons (631pt) afferma: “AI tools have no place in scientific microscopy images because we have the obligation to reproduce our images as truthfully as possible”. u/holydiver18 (55pt) critica duramente la spiegazione dell’autore: “Author's explanation is pissing on all of our legs and telling us it's raining”.
- Evoluzione della regolamentazione sui deepfake: thread 1 “SM Entertainment Announces Strict Legal Action” (r/kpop, 723pt, 52 commenti, 2026-09-28) https://www.reddit.com/r/kpop/comments/1wsdr6d/ — L’agenzia annuncia azioni legali contro immagini AI dannose. u/themichaelfalk (138pt) scrive: “a Korean article explicitly mentions rumors about AI-generated images showing her as pregnant”. Anche su Reddit il rafforzamento della risposta delle agenzie è accolto positivamente, come nel commento di u/llamacana “glad sm is taking action” (166pt).
- Resistenza culturale, nel contesto religioso: thread 11 “AI Generated Images at Mass” (r/Catholicism, 48pt, 89 commenti, 2026-09-28) https://www.reddit.com/r/Catholicism/comments/1wskb30/ — Reazioni di rifiuto verso una diocesi che mostra immagini AI su schermi LED durante la messa. u/JacquesdeVee (47pt) commenta: “Looking at those pictures while listening to the readings is creating false images in us instead of God speaking to us through His Word”. L’autore del post, artista, rivela di aver offerto gratuitamente opere create da esseri umani, ma di essere stato respinto.
- Contenuti generativi trasformati in meme: thread 6 “I hate AI-Generated images of Thanos” (r/Earth199999, 829pt, 44 commenti, 2026-09-25) https://www.reddit.com/r/Earth199999/comments/1wqaxgh/ — L’autore critica l’impatto ambientale, in particolare il consumo idrico, dei contenuti generativi: “It feels so insensitive... to waste more water on this dude”, raccogliendo forte consenso con 829pt.
- Delusione e aspettative eccessive sulla generazione video: thread 10 “AI Video Generator” (r/perchance, 0pt, 13 commenti, 2026-09-23) https://www.reddit.com/r/perchance/comments/1woin1z/ — u/SSFx93 (7pt) offre una visione disincantata: “Good realistic (high quality), no limit, and free do not come together. Especially with video ai generation.” Nel thread 5 “Just a reminder, these were the AI videos going viral in 2024” (r/GenAI4all, 199pt, 67 commenti, 2026-09-24) https://www.reddit.com/r/GenAI4all/comments/1wou5vb/ , u/MinosAristos assume invece una posizione opposta: “That video is absolute cinema. Using the 'weaknesses' of synthetic media as a strength”.
Segnali
- In crescita: l’arrivo dei modelli video closed-source a un livello “indistinguibile dal live action” (thread 9, r/singularity 1.554pt), insieme a stupore e prudenza. Rimane costante anche l’attenzione per un successore di Sora (thread 7).
- In crescita, lato open source: l’accumulo di conoscenza pratica sulla gestione locale e a basso costo centrata su ComfyUI (thread 3 e 8). Come mostra “no api costs all free just the electricity cost”, il vantaggio comparativo sui costi raccoglie consenso.
- Sminuito o contestato: la reazione contro l’uso non autorizzato e la falsa rappresentazione dei contenuti generati dall’AI emerge in più ambiti: immagini scientifiche (thread 4), rito religioso (thread 11), ritratto di celebrità (thread 1), critica in forma di meme (consumo idrico nel thread 6). A prescindere dal genere, sembra emergere una correlazione inversa: più aumenta la credibilità apparente, più forte diventa la reazione su affidabilità ed etica.
- Elemento inatteso: la query ha attirato soprattutto thread nei contesti d’uso e abuso, più che sulla tecnologia generativa stessa, come deepfake K-pop, scorrettezza Nikon, immagini AI alla messa e meme di Thanos. Suggerisce che l’argomento “notizie sull’AI per immagini/video” venga raccontato più attraverso le frizioni sociali che attraverso la presentazione di strumenti.
- Contrasto di opinioni: i thread 9 e 5 trattano entrambi il miglioramento della qualità dei video AI, ma il primo reagisce con un allarme misto a stupore per quanto siano inquietantemente reali, mentre il secondo con puro apprezzamento per un’esperienza cinematografica. Lo stesso avanzamento qualitativo viene recepito in modo diverso a seconda del contesto: timore dei falsi contro espressione creativa.
Limiti
- Il criterio di completamento chiedeva l’analisi di circa 20 post per ogni social, ma Reddit ha raccolto solo 11 thread, circa metà dell’obiettivo. Query aggiuntive, ad esempio “Sora 2”, “Stable Diffusion”, “Qwen image” o “Nier open source video model”, avrebbero potuto aumentare il campione, ma in questa fase il worker si è limitato a leggere i file già raccolti e non ha svolto ulteriori ricerche.
- Poiché la query era la sola frase standardizzata
"Image and Video Generation AI News", non sono state eseguite ricerche con i nomi concreti di strumenti e modelli closed-source/open-source; di conseguenza, le comunità direttamente legate al tema, come r/StableDiffusion e r/SoraAi, hanno fornito un solo elemento ciascuna. - Circa 7 degli 11 elementi raccolti, inclusi thread 1, 4, 6, parte del 9 e 11, riguardano più controversie etiche e sociali che l’evoluzione tecnica della generazione AI. Con i soli dati Reddit è quindi difficile soddisfare il requisito del brief di almeno 10 osservazioni ciascuno per le evoluzioni closed-source e open-source. È necessaria l’integrazione dalle altre piattaforme.
X
X — Notizie sull'AI per la generazione di immagini e video
Account
I 40 post raccolti provengono da 35 account e praticamente nessuno di questi parla di AI per la generazione di immagini o video. Due meritano di essere separati, perché sono gli unici a sfiorare il tema:
- @tetumemo(テツメモ|AI図解×検証|Newsletter) — un singolo post (327 like,
28 repost, ~48.000 visualizzazioni), l’unico account dell’intero set realmente focalizzato sull’AI. Pubblica in giapponese sullo strumento interno “Skills” di Anthropic, non sulla generazione di immagini o video.
https://x.com/tetumemo/status/2104689964315447445 - @PalantirHotline e @zephyr_z9 — un post ciascuno, entrambi reazioni ad Anthropic come azienda (speculazioni su IPO e prezzi), non a prodotti o rilasci per la generazione di immagini/video.
Tutti gli altri account, 33 su 35, alimentano trend completamente scollegati: reazioni al calcio Italia-Turchia (@Luxboii, @CHUUFFINO, @UTDbrims, @tchato18), Spagna-Croazia (@rkaydee_, @BlackKyle5, @wohwki, @Am_NORBERT, @ChivicEmpire21, @Bpassuwanile1, @ivana_croatian), fandom di Big Brother 28 (@BBTeamNorth, @syphafan, @TAYXBURROW, @paige_lilith), WWE Raw (@reigns_era — 3 post, 7.267 like complessivi — @greatness_1316), meme contro Taylor Swift/Tayflop (@outztheslammer — 2 post — @TayloVis, @s0mbr3nd3r), e gossip di Formula 1 su Lando Norris (@Polvodehadasm, @lnfourss — 2 post — @oIliebearman). Nessuno parla di AI, generazione di immagini o generazione video; si tratta di reazioni isolate a risultati sportivi e pettegolezzi sulle celebrità, non di voci ricorrenti sul settore.
Post
Non posso fornire 5–12 risultati sulla generazione AI di immagini/video da questa raccolta, perché la raccolta non li contiene. I casi più vicini sono:
- @tetumemo (327 like, 28 repost, ~48.000 visualizzazioni, 2026-09-28) — l’unico post effettivamente legato all’AI nel set, ma riguarda strumenti testuali/HTML e non immagini: “Anthropicのチームが社内で大人気のSkillsELI5」ですが、5歳児でもわかるレベルで図解中心にHTML形式で解説してってSkills” (il team di Anthropic ha un popolare Skill interno “ELI5”, che spiega in HTML e con diagrammi a un livello comprensibile anche a un bambino di cinque anni). Non menziona Claude che genera immagini o video; parla di output HTML esplicativi.
https://x.com/tetumemo/status/2104689964315447445 · trovato cercando “Anthropic” - @PalantirHotline (447 like, 31 repost, ~49.000 visualizzazioni, 2026-09-29) — pura speculazione sul mercato azionario, non notizie di prodotto: “$PLTR Anthropic considering to IPO at $2T only means that Palantir is worth at least $20T”.
https://x.com/PalantirHotline/status/2104744865468989486 · trovato cercando “Anthropic” - @zephyr_z9 (1.480 like, 36 repost, ~115.000 visualizzazioni, 2026-09-28) — reazione di una riga senza contesto prodotto: “Are they planning to price out everyone from the market”. Letto insieme al post sull’IPO, sembra una discussione generale su prezzi e mercato di Anthropic, non su modelli di immagini o video.
https://x.com/zephyr_z9/status/2104717396900745337 · trovato cercando “Anthropic” - @xilo2991 (172 like, 51 repost, ~12.000 visualizzazioni, 2026-09-29) — è emerso nella ricerca “Anthropic”, ma il collector non ha acquisito il testo del post; oltre alla sua esistenza non c’è quindi nulla da riportare.
https://x.com/xilo2991/status/2104912748794589515 · trovato cercando “Anthropic”
Questo è l’intero set di post anche solo vagamente correlati all’AI. Tutti gli altri 36 dei 40 sono calcio, WWE, Big Brother 28, meme su Taylor Swift o Formula 1, e nessuno tocca la generazione AI open-source o closed-source di immagini o video.
Segnali
- Nessun tema in crescita. In questa raccolta non emerge alcun segnale riconoscibile sull’AI di generazione immagini/video, open source o closed source: nessuna menzione di Midjourney, Sora, Veo, Runway, Kling, Stable Diffusion, Flux, HunyuanVideo, Wan o strumenti e rilasci comparabili.
- Ciò che sorprende non è un trend, ma un dato sulla raccolta: tutte le query di questa esecuzione (
Italy,Spain,Jubjub,Holy,#bb28,Roman,Tayflop,Anthropic,#Croatia,Lando) sono nomi di trend presi direttamente dalla pagina Explore di X (vedi la tabella catturata dal worker, geolocalizzata in Croazia), non termini legati al brief di ricerca. Solo una delle dieci query, “Anthropic”, ha una connessione con l’AI, ma ha restituito chiacchiere su finanza/prezzi aziendali e un post su strumenti non correlati, non contenuti sulla generazione di immagini o video. - Cosa viene sminuito: non applicabile; non è presente alcun dibattito pertinente da caratterizzare come emergente o trascurato.
Limiti
- Le query che hanno guidato la raccolta non riguardavano il tema di ricerca. Tutti e dieci i termini cercati (
Italy,Spain,Jubjub,Holy,#bb28,Roman,Tayflop,Anthropic,#Croatia,Lando) erano trend di X Explore per la sessione, elencati inoutput/x.posts.mdsotto “What X says is happening”, e geolocalizzati in Croazia. Solo “Anthropic” ha una qualche attinenza con l’AI, e non ha fatto emergere contenuti sulla generazione di immagini/video. - Non è stata eseguita alcuna ricerca con termini specifici della generazione di immagini/video, come “Sora”, “Midjourney”, “Stable Diffusion”, “Veo”, “Runway”, “Kling”, “Flux”, “text-to-video”, “text-to-image” o nomi di modelli open-weight; pertanto questo file non può riportare notizie di X sul tema richiesto, né per il closed source né per l’open source.
- Dei 40 post raccolti, solo 4 citano “Anthropic”, e nessuno riguarda la generazione di immagini o video; gli altri 36 sono trend sportivi o d’intrattenimento non correlati.
- Non sono state raccolte immagini per questa fase della piattaforma (
images/x/non esiste), quindi non ci sono materiali visivi da confrontare. - Non ho esplorato X personalmente secondo il playbook: la sessione headless autenticata del worker è l’unico percorso ai dati X per questa fase. Questo riepilogo è strettamente limitato a
output/x.posts.mdeoutput/x.posts.json, e quei dati non coprono il tema del brief.
YouTube
YouTube — Notizie sull'AI per la generazione di immagini e video
Canali
- Matt Wolfe (@mreflow, ~925K iscritti) — canale di notizie AI quotidiane; è il consiglio più citato nei risultati di ricerca per chi chiede quali YouTuber seguire su questo tema, anche se in questa ricerca non è emerso uno specifico video di settembre su modelli di immagini/video.
- TheAIGRID (@TheAiGrid, ~370K iscritti, 61,3M visualizzazioni totali, ~540K visualizzazioni negli ultimi 30 giorni secondo Social Blade) — canale di notizie AI quotidiane, con frequente copertura sia di release frontier chiuse, come Sora e Nano Banana Pro, sia di release open-weight.
- Theoretically Media (@TheoreticallyMedia) — specialista dell’open source e della generazione locale (“Tim”); compare ripetutamente nella copertura di Z-Image, Wan e HunyuanVideo, ed è un canale che i motori di ricerca associano direttamente a questo settore, anche se in questa raccolta non sono emersi dati di visualizzazione per i singoli video.
- Nerdy Rodent e Sebastian Kamph — canali tutorial su ComfyUI e AI locale, che trattano con continuità installazioni di nuovi modelli open-weight per immagini e video, fra cui HunyuanVideo, Qwen-Image e Flux.
- Un grande gruppo di canali AI in formato comparativo, con titoli come “The BEST AI Video Generator 2026!”, mette ripetutamente a confronto Sora 2, Veo 3.1, Runway, Kling e Grok Imagine. Sembrano canali SEO di affiliazione o tutorial, più che voci ricorrenti uniche, ma dominano il volume dei risultati sulle soluzioni chiuse.
Video
- “OpenAI Just Killed Sora” — canale non confermato nello snippet di ricerca, 2026-03-24. Riporta l’annuncio di OpenAI dello stesso giorno: interruzione dell’app Sora e dell’API Sora-2 per reindirizzare la capacità GPU verso un nuovo modello interno.
https://www.youtube.com/watch?v=PKKN5be_my0 - “BREAKING: Sora 2 is SHUTTING DOWN… So I Tested the Best Alternatives” — 2026-03-27. Presenta la chiusura come un evento in corso e prova Kling, Runway e Veo come sostituti per gli utenti Sora rimasti senza servizio.
https://www.youtube.com/watch?v=Zf9979o8RGk - “OpenAI Shuts Down Sora & Kills ChatGPT Integration Plans | What Happened?” — 2026-03-26. Sostiene che la chiusura, con app ritirata il 26 aprile e API terminata il 24 settembre 2026, sia stata causata da costi operativi riportati di circa $15M al giorno e dalla carenza di chip, non da una scarsa qualità del modello.
https://www.youtube.com/watch?v=9rhmczPT6Jk - “The Ultimate Guide to AI Video Generation (Sora 2, Runway 4.5, Veo 3.1, Nano Banana Pro)” — recente caricamento del 2026. Una panoramica unica che considera Sora 2, Runway 4.5, Veo 3.1 e Nano Banana Pro di Google come l’attuale frontiera closed-source, nonostante la chiusura dell’API Sora nello stesso mese.
https://www.youtube.com/watch?v=Kib8UcDiNJA - “Google Nano Banana Pro: The BEST Image Model!” e video affini (“NANO Banana Pro is FINALLY Here!”, “Google won image generation (it's not even close) — NANO BANANA PRO BREAKDOWN”) — gruppo di upload dal 2025-11-21 in avanti. La tesi ricorrente è che Nano Banana Pro, costruito su Gemini 3 Pro Image, eccella nella resa del testo, nelle infografiche e nell’output 4K, ed è la risposta closed-source di Google al lavoro di immagini associato a Midjourney e Sora.
https://www.youtube.com/watch?v=GEtiY-0fzO0 · https://www.youtube.com/watch?v=UV9GqinedQ8 - “Runway 4.5 vs Veo 3.1 vs Sora 2 — Full AI Video Generator Comparison” — 2025-12-23. Colloca Runway 4.5 davanti a Veo 3.1 nel controllo della camera e Sora 2 davanti per realismo puro, prima della successiva chiusura di Sora.
https://www.youtube.com/watch?v=Rm_Ok-MHZfA - “Qwen-Image-2.1 Is INSANE… Just 7B Parameters?!” — 2026-09-20, lo stesso giorno del rilascio. Sostiene che il modello open-weight da 7B di Alibaba possa ora modificare immagini, preservare l’identità di soggetti e prodotti in un massimo di 10 immagini di riferimento e generare ritagli trasparenti; segnala però che la licenza è solo per ricerca e dunque non è veramente open source.
https://www.youtube.com/watch?v=3qGl0wiv2G0 - “Qwen Image 2512 Just Dropped – I Had to Test It Immediately vs Nanobanana Pro (12 Tests)” — fine 2025/2026. Esegue un confronto in 12 test tra Qwen Image 2512 open-weight e Nano Banana Pro chiuso di Google, sostenendo che il divario qualitativo fra aperto e chiuso si sia quasi annullato.
https://www.youtube.com/watch?v=_TGz5xB6i8w - “Z-Image Turbo Released - Fast Distilled Image Model” e “Z-Image Base Released – AI That Nails Hands, Textures & Human Emotions!” — il laboratorio Tongyi-MAI di Alibaba ha rilasciato Z-Image Turbo il 2025-11-26, con inferenza in meno di un secondo e 8 passaggi; secondo il testo della descrizione era numero 1 open-source e numero 8 assoluto nella Artificial Analysis Text-to-Image Leaderboard. È seguito poi un checkpoint “Base” completo. Entrambi hanno generato video tutorial/installazione su canali in stile Nerdy Rodent e Theoretically Media.
https://www.youtube.com/watch?v=3mT7KnotPqk · https://www.youtube.com/watch?v=s7ppsl_LbzI - “HunyuanVideo 1.5: Open Source Video Generation (Instruction Following & Physics)” e “Tencent HunyuanVideo 1.5 has been officially open-sourced!” — modello video aperto di Tencent da 8,3B parametri, presentato come eseguibile su GPU consumer; vari canali hanno subito prodotto confronti con Wan 2.2/2.5/2.7.
https://www.youtube.com/watch?v=4HTBZg5Zhqc · https://www.youtube.com/watch?v=MJShdc8tkkA - “AI Video Models Are Getting Out of Control! (WAN 2.5, Kling 2.5, Wanimate)” — sostiene che la cadenza dei rilasci di modelli video aperti, come Wan, e chiusi, come Kling, sia diventata troppo rapida per poter seguire ogni prodotto singolarmente; usa la funzione di animazione dei personaggi “Wanimate” di Wan come nuova capacità principale.
https://www.youtube.com/watch?v=vFXe3uXb75k - “We have a new #1 open-source AI video generator!” — incorona un nuovo leader, nel contesto dei confronti fra HunyuanVideo 1.5 e Wan 2.7, nella classifica open-source dei video AI in rapido movimento.
https://www.youtube.com/watch?v=6EQP8-D37bs
Segnali
- La storia closed-source dominante del momento non è un nuovo modello, ma OpenAI che ne chiude uno. L’app Sora e l’API Sora-2, inclusi sora-2, sora-2-pro e gli snapshot datati, sono state chiuse completamente il 2026-09-24, sei giorni prima di questa ricerca, dopo che OpenAI aveva annunciato la decisione il 2026-03-24. Diversi video interpretano la scelta come un reindirizzamento della capacità GPU verso un modello interno di prossima generazione, con il nome in codice riportato “Spud”, e lontano da un prodotto che secondo alcune fonti costava circa $15M al giorno. È un segnale closed-source più grande di qualunque singolo rilascio trovato in questa ricerca.
- Nano Banana Pro di Google, Gemini 3 Pro Image, è il leader closed-source per volume di video. Attorno a esso si concentrano molti più video che intorno a qualunque singolo rilascio di immagini Midjourney o Runway; i canali lo chiamano ripetutamente il migliore della categoria per il rendering del testo e per le immagini in stile infografica.
- I modelli open-weight per immagini stanno riducendo rapidamente il divario con quelli chiusi, ma la licenza rende ambiguo il termine “open source”. Qwen-Image-2.1, 7B parametri e rilasciato il 2026-09-20, viene definito nella stessa copertura “open weights, not open source”: licenza solo per ricerca e nessuna ridistribuzione commerciale, un limite che più video segnalano pur elogiandone le capacità.
- I laboratori cinesi, Tongyi-MAI/Qwen di Alibaba e Hunyuan di Tencent, sono al momento i publisher open source più attivi sia per immagini sia per video, con Z-Image Turbo/Base, Qwen-Image-2.1/2512 e HunyuanVideo 1.5 tutti emersi negli ultimi circa quattro mesi e immediatamente confrontati fra loro e con modelli chiusi.
- I contenuti comparativi sui modelli video, “Sora vs Veo vs Runway vs Kling vs Wan”, sono diventati un genere a sé, prodotto con una frequenza quasi settimanale dai canali di confronto strumenti. Sono utili per capire quali nomi siano più presenti, ma meno per misurare la rilevanza di una singola notizia.
Limiti
- Le pagine dei risultati di ricerca YouTube (
youtube.com/results?search_query=…) sono renderizzate in JavaScript e il page fetcher di questa ricerca ha restituito solo elementi di navigazione e footer. Visualizzazioni esatte, orari di caricamento e iscritti non potevano essere letti direttamente su YouTube per la maggior parte dei video. Tutte le cifre su visualizzazioni/iscritti/date provengono da snippet WebSearch e fonti secondarie collegate, come Social Blade, vidiq e riepiloghi di blog, non dall’apertura diretta dei video YouTube; i numeri sono dunque approssimativi e riferiti agli aggiornamenti di tali fonti. - Le pagine dei singoli video (
youtube.com/watch?v=…) hanno incontrato lo stesso ostacolo di rendering JavaScript: titoli recuperabili, ma in genere non visualizzazioni, nomi esatti dei canali e descrizioni. Per questo varie voci riportano titolo e data, ma non canale o numero di visualizzazioni. - Non è stato trovato un upload di settembre 2026 confermato e datato di Matt Wolfe sul tema, nonostante il canale fosse il più consigliato nei risultati di ricerca; è incluso nella sezione Canali per reputazione, non per un video recente verificato.
- Non è stato tentato alcun confronto con Bluesky, Lemmy o Pinterest: i dati YouTube sono stati raccolti in modo indipendente, secondo il playbook.
- La copertura è sbilanciata verso canali tutorial/comparativi, poiché dominano il ranking YouTube per queste keyword; potrebbero essere sottorappresentati creatori più piccoli o in lingue non inglesi. Sono emersi un video francese su Z-Image e uno giapponese su Qwen-Image, ma non sono stati analizzati in profondità.
Bluesky
Bluesky — Notizie sull'AI per la generazione di immagini e video
Nota sul metodo di ricerca
L’API di ricerca dei post public.api.bsky.app/xrpc/app.bsky.feed.searchPosts indicata dal playbook ha restituito costantemente 403 Forbidden in questa sessione; anche la pagina di ricerca web bsky.app/search?q=... era renderizzata in JavaScript e non permetteva di recuperare contenuti (dettagli in ## Limits). Come alternativa, sono stati identificati con app.bsky.actor.searchActors, non bloccato, account potenzialmente rilevanti per il tema; poi sono stati verificati uno per uno i contenuti reali mediante app.bsky.feed.getAuthorFeed, per l’elenco dei post di un account, e app.bsky.feed.getPostThread, per testo, data, like e repost di un post singolo. Tutti i post seguenti sono indicati con URL esistenti.
Account
- @testingcatalog.com(🚨 AI News | TestingCatalog)— bot di notizie rapide sull’AI in generale. Pubblica alcuni post al giorno e gli argomenti di generazione immagini/video compaiono solo occasionalmente. https://bsky.app/profile/testingcatalog.com
- @genainews.bsky.social(Gen AI News)— anche questo un bot di notizie AI generali. Sono stati controllati gli ultimi 30 post del feed, senza trovare alcun post su generazione AI di immagini/video: prevalgono agenti, LLM e notizie aziendali.
- @sungkim.bsky.social(Sung Kim)— account personale che segue i rilasci di modelli open-weight. Il post sul rilascio di Qwen-Image-2.1 ha ottenuto 81 like e 10 repost, la risposta più forte tra quelle verificate. https://bsky.app/profile/sungkim.bsky.social
- @compvis.bsky.social(CompVis, LMU Munich)— account del gruppo di ricerca autore del paper originario di Stable Diffusion. I post recenti non annunciano modelli specifici, ma presentano ricerca generale su modelli di diffusione e GAN. https://bsky.app/profile/compvis.bsky.social
- @stabilityai.bsky.social(Stability AI ufficiale)— l’unico grande account aziendale attivo nell’area chiusa/aperta. Tuttavia, nell’ultimo anno quasi tutti i post riguardano la generazione audio, Stable Audio 2.5, e partnership con Universal Music e Warner Music; non emergono nuovi annunci per immagini/video. https://bsky.app/profile/stabilityai.bsky.social
- @civitai-bot.bsky.social(bot di aggiornamento CivitaiCheckPoint)— bot che notificava automaticamente aggiornamenti di modelli/LoRA open source. L’ultimo post però è datato 9 maggio 2024 e il servizio è fermo da oltre un anno.
- @dahara1.bsky.social / @luok.ai — account personali di sperimentazione e verifica. Pubblicano report d’uso per modelli video open source come HunyuanVideo e SkyReels V1.
- @trashcanroxanne.bsky.social(TrashCanRoxanne)— autrice AI che partecipa ai “Creator Partner Program” di Runway/Hailuo/Freepik/Kling e altri. Pubblica costantemente test di nuove funzioni e partecipazioni a festival di cortometraggi AI.
- @blackforestlabs.bsky.social(Black Forest Labs ufficiale), @klingaivideo.bsky.social(Kling AI Video ufficiale), @runwayml.bsky.social(RunwayML ufficiale)— tutti e tre hanno account Bluesky, ma Black Forest Labs e Kling AI Video non hanno post, e RunwayML ne ha solo uno dell’ottobre 2024. Bluesky praticamente non funziona come canale di annunci ufficiali per le aziende di AI immagini/video.
- Le ricerche degli account relativi a Stable Diffusion e Civitai hanno mostrato soprattutto post personali di AI art, in gran parte contenuti NSFW o furry, più che notizie.
- Al contrario, sono apparsi molti illustratori, fra cui
fuzichoco.bsky.social,jametc.bsky.social,devinellekurtz.bsky.socialeartbutmakeitsports.bsky.social, che dichiarano nel profilo “NO AI” o vietano l’addestramento AI, segnalando l’esistenza di una comunità anti-AI peculiare di Bluesky.
Post
-
Nano Banana 2.1 (closed source) — @testingcatalog.com, 2026-09-27, 1 like e 0 repost. “New Google Flow build now points to Nano Banana 2.1”. Riporta che, all’interno di Google Flow, la denominazione del modello di immagini è cambiata da Nano Banana 2.5 a Nano Banana 2.1, ipotizzando un piccolo aggiornamento iterativo.
https://bsky.app/profile/testingcatalog.com/post/3mwiz3uw7nl2e -
Pubblicazione open-weight di Qwen-Image-2.1 (open source) — @sungkim.bsky.social, 2026-09-20, 81 like e 10 repost, la risposta più grande fra i post verificati. Riporta che Alibaba ha reso disponibile open-weight un modello leggero da 7B che integra generazione e modifica. In post successivi presenta la generazione diretta di livelli RGBA, fino a 10 immagini di riferimento, supporto panorama/prova virtuale e link a GitHub/ModelScope/Hugging Face. Nei commenti continuano domande tecniche sul deployment locale con LM Studio e sul supporto ComfyUI.
https://bsky.app/profile/sungkim.bsky.social/post/3mvxr2bj2ck2r -
Stable Audio 2.5 di Stability AI e partnership con Universal Music, un segnale indiretto di cambio di direzione rispetto a immagini/video — @stabilityai.bsky.social, 2025-10-30, 1 like e 0 repost. “Today we announced a strategic alliance with Universal Music Group to co-develop professional AI music creation tools”. Le comunicazioni recenti di Stability AI su Bluesky sono incentrate sulle partnership per modelli audio, senza nuovi annunci di modelli per immagini/video.
https://bsky.app/profile/stabilityai.bsky.social/post/3m4fwolv4k22z -
Test della funzione first/last frame di Kling 2.1 (closed source) — @trashcanroxanne.bsky.social, 2025-08-25, 4 like e 0 repost. “Testing out the new Kling 2.1 — first and last frame feature in Freepik”. Un post dal punto di vista di chi sperimenta la nuova funzione di Kling AI tramite Freepik.
https://bsky.app/profile/trashcanroxanne.bsky.social/post/3lxas5x3uf22s -
SkyReels V1 (open source) — @luok.ai, 2025-02-18, 3 like e 1 repost. “SkyReels V1 is the first open-source human-centric video foundation model. By fine-tuning HunyuanVideo on over 10 million high-quality film and television clips, it captures 33 facial expressions and over 400 natural movement combinations”. Presentazione di un modello open source per video umani basato su HunyuanVideo.
https://bsky.app/profile/luok.ai/post/3lihm6qiuyk27 -
Beta test HunyuanVideo I2V (open source) — @dahara1.bsky.social, 2025-03-06, 0 like e 0 repost. Riferisce di aver partecipato al beta test dell’AI di generazione video HunyuanVideo e di aver potuto creare video da una sola immagine, riportando in un thread i risultati di test su un video anime in lip-sync.
https://bsky.app/profile/dahara1.bsky.social/post/3ljozva2gcs27 -
Fermo del bot di aggiornamento CivitaiCheckPoint, segnale di stallo dell’infrastruttura della comunità open source — @civitai-bot.bsky.social, ultimo post 2024-05-09, con piccoli post sotto i 3 like. Pubblicava ogni ora notifiche di aggiornamento LoRA/checkpoint, per esempio “✨Carrot Caramel Batake updated✨ baseModel: SD 1.5”, ma ha smesso dopo il 9 maggio 2024.
https://bsky.app/profile/civitai-bot.bsky.social/post/3ks2nnatkqi24 -
Decentralized Diffusion Models (ricerca open source) — @compvis.bsky.social, gruppo autore originario di Stable Diffusion, 2025-01-10, 20 like e 2 repost. “Decentralized Diffusion Models, a way to train diffusion models on decentralized compute with no communication between nodes”. È la presentazione di un paper sul training distribuito, non il rilascio di un modello specifico.
https://bsky.app/profile/compvis.bsky.social/post/3lfexk45ek227 -
Silenzio sostanziale dell’account ufficiale RunwayML, segnale dell’assenza di comunicazione aziendale sul closed source — @runwayml.bsky.social, unico post del 2024-10-24, 386 like e 24 repost. Il contenuto però è una descrizione paesaggistica non legata al prodotto: “Let's put a blanket down & watch the day fade away”; da allora non è stato pubblicato altro.
https://bsky.app/profile/runwayml.bsky.social/post/3l7bzv5idqg2t -
Diffusion models for image and video generation | ML in PL 2025, annuncio di una presentazione da parte di un ricercatore Google DeepMind — @sedielem.bsky.social, Sander Dieleman, ricercatore Imagen/Veo, 2026-03-16, 17 like e 6 repost. Annuncia una conferenza che spiega in profondità l’addestramento di modelli per immagini e video, senza presentare un prodotto specifico.
https://bsky.app/profile/sedielem.bsky.social/post/3mh7g2dv4nc25
Segnali
- L’assenza degli account ufficiali è la scoperta più importante. Black Forest Labs, sviluppatore di Flux, non ha post; Kling AI Video non ha post; RunwayML ne ha uno solo in due anni. I principali attori dell’AI per immagini/video quasi non usano Bluesky per gli annunci rapidi. A Bluesky manca la cultura di comunicazione diretta degli annunci tramite CEO o account ufficiali che esiste su X e Reddit.
- Stability AI è attiva, ma l’attenzione è passata all’audio. I post fra settembre e novembre 2025 sono centrati su Stable Audio 2.5 e partnership con Universal Music Group e Warner Music Group; nello stesso periodo non si vedono annunci di nuovi modelli per immagini della linea Stable Diffusion.
- I report pratici sull’open source provengono da account personali, non aziendali. Qwen-Image-2.1 (@sungkim.bsky.social), SkyReels V1 (@luok.ai) e la verifica HunyuanVideo I2V (@dahara1.bsky.social) sono tutti resoconti primari di account tecnici personali, spesso più rapidi e dettagliati degli annunci ufficiali.
- Il bot checkpoint di Civitai è fermo dal maggio 2024, e Bluesky potrebbe già non essere più un’infrastruttura di notifica per la condivisione di LoRA e modelli open source. È possibile, ma non verificato, che la comunità sia migrata su Discord o sulla piattaforma Civitai stessa.
- La generazione video closed-source, Runway, Hailuo, Kling, Luma e Pika, viene raccontata da gruppi di account influencer che partecipano a Creator Partner Program. Account come @trashcanroxanne, @aziz4ai, @azed-ai, @uncanny-harry e @koldohuici pubblicano test di funzioni e partecipazioni a festival di cortometraggi AI come ambassador di vari strumenti; la comunicazione è più da comunità di creatori che da notizia tecnica.
- I contenuti NSFW/furry dominano i risultati di ricerca degli account legati a Stable Diffusion e Civitai. Nell’ecosistema Bluesky dell’open source per immagini, la maggioranza sembra essere AI art personale, spesso per adulti, più che notizie tecnologiche.
- Sono numerosi gli illustratori che dichiarano “NO AI”, fra cui @fuzichoco.bsky.social, @jametc.bsky.social, @devinellekurtz.bsky.social e @artbutmakeitsports.bsky.social. L’opposizione all’AI generativa e il rifiuto dell’addestramento AI sono normalizzati nelle descrizioni dei profili; rispetto a X e Reddit, il sentimento anti-AI dei creatori appare particolarmente esplicito su Bluesky.
Limiti
- L’API di ricerca dei post
app.bsky.feed.searchPostsha restituito costantemente 403 Forbidden. Il playbook indicava un accesso possibile senza login, ma da questo ambiente query semplici comeq=stable diffusioneq=catshanno ricevuto 403. Nello stesso ambiente funzionavanoapp.bsky.actor.searchActors,app.bsky.feed.getAuthorFeedeapp.bsky.feed.getPostThread, quindi sembra limitata soltanto l’API di ricerca. Potrebbe trattarsi di autenticazione diventata obbligatoria o di limiti di rate, ma non è stato verificato. - La pagina web
bsky.app/search?q=...era renderizzata in JavaScript, quindi l’HTML acquisito non includeva il contenuto dei post. Anche le pagine individualibsky.app/profile/.../post/...non rendevano il testo; i contenuti erano verificabili soltanto via API getPostThread. - A causa di questi limiti, non è stato possibile raccogliere post in modo esaustivo tramite ricerca per keyword; è stato necessario verificare una per una via API le URL di bsky.app trovate con Google. Di conseguenza, non è stato possibile svolgere la ricerca ampia per più keyword prevista dal playbook: i post raccolti non sono esaustivi e si limitano a quelli trovati casualmente.
- Il criterio di completamento di circa 20 post analizzati non è stato raggiunto con questa procedura alternativa. Sono stati trovati 10 post rilevanti e una dozzina circa di account/segnali utili. In casi come Blackforest Labs e Kling AI Video, gli account ufficiali avevano zero post, e continuare a scavare lungo lo stesso percorso non avrebbe prodotto nuove fonti primarie.
- Un articolo trovato via Google,
en.yasue.org/report/image-and-video-generation-ai-news-2026-09-10, sembra probabilmente un precedente report AI generativo della stessa serie; non è stato trattato come fonte primaria né citato.
Lemmy
Lemmy — Argomenti sull'AI per immagini e video (incentrati sull'open source, lato closed-source più debole)
Comunità
- !«メールアドレス» — 5,71K iscritti. Comunità di gran lunga più attiva per AI di immagini/video. Nodi ComfyUI e repository GitHub di nuovi modelli scorrono quasi ogni giorno; qui si concentra quasi tutta l’evoluzione open source.
- !ai_reddit@(istanze multiple, inoltrato da lemmy.world e altre) — comunità che ripubblica su Lemmy post Reddit relativi all’AI generativa. A volte compaiono esempi di lavori closed-source, come Runway e GPT.
- !«メールアドレス» — bloccata da Anubis, il sistema anti-bot, quindi non interamente consultabile. Dalle poche voci emerse via ricerca, l’attività sembra scarsa e alcuni post hanno persino punteggi negativi.
- !«メールアドレス» / !«メールアドレス» / !«メールアドレス» — comunità critiche verso l’AI generativa e l’AI art. Più che notizie, sono popolate da post emotivi, ma qui tendono a concentrarsi i casi di abuso dell’AI closed-source.
- !«メールアドレス» — comunità tecnologica generale. Vi compaiono occasionalmente notizie aziendali, come Midjourney, ma non è una comunità specialistica.
Post
Open source (da !«メールアドレス», ultime 1–2 settimane)
- LanPaint — inpainting di alta qualità utilizzabile con qualunque modello SD senza training, compatibile con ComfyUI. Punteggio 7, 2026-09-29. https://lemmy.dbzer0.com/post/76205128
- PxTicks/vlo — editor video AI gratuito, locale e open source. Punteggio 4, 2026-09-29. https://lemmy.dbzer0.com/post/76205126
- SatoDive/Minimax-H3-Latent-Continuation — generazione continua di video lunghi e multi-shot senza interruzioni, basata su MiniMax H3. Punteggio 3, 2026-09-29. https://lemmy.dbzer0.com/post/76205130
- Qwen-Image-2.1 in ComfyUI — integrazione ComfyUI del modello open-weight per generazione e modifica immagini Qwen-Image-2.1. Punteggio 13, il più alto del thread, attorno al 2026-09-22. https://lemmy.dbzer0.com/post/75874773
- ogoun/fooocus-qwen-image-2.1 / Kijai/QwenImage_experimental / PrunaAI/Pruna-Qwen-Image-2.1 — sono stati pubblicati simultaneamente WebUI, integrazioni ControlNet e LoRA di accelerazione attorno a Qwen-Image-2.1. 2026-09-26–27. https://lemmy.dbzer0.com/post/76110120
- SupraLabs/Supra2-IMG — modello compatto text-to-image con appena 100 milioni di parametri. Punteggio 7, attorno al 2026-09-22. https://lemmy.dbzer0.com/post/75874769
- Nuova interfaccia di The AI Horde — AI Horde, rete distribuita e gratuita di generazione di immagini AI, ha rinnovato frontend, backend e documentazione. Punteggio 8, attorno al 2026-09-19. https://lemmy.dbzer0.com/post/75736717
- Cierpliwy/krea2-inpaint-edit・lvladikov/Krea2-Turbo-Distill-2step-LoRA — LoRA per modifica inpainting della famiglia Krea-2 e LoRA di distillazione rapida in due passaggi. 2026-09-16–17. https://lemmy.dbzer0.com/post/76065378
- Post di arte astratta con SDXL locale + LoRA — opera astratta rifinita in GIMP/Inkscape dopo aver eseguito SDXL 1.0 in locale e addestrato una LoRA personalizzata. Punteggio 4, 2026-09-18. https://lemmy.today/post/60272629
Closed source (sporadici, tramite altre comunità)
- Midjourney chiede a Hollywood di divulgare l’uso dell’AI — secondo le notizie, Midjourney chiede agli studi di Hollywood dettagli sull’uso dell’AI. !technology, 2026-07-05. https://techcrunch.com/2026/07/04/midjourney-wants-hollywood-studios-to-reveal-the-details-of-their-ai-usage/
- Google Earth AI, con integrazione Nano Banana, ritirato in 24 ore — il giorno dopo aver integrato in Google Earth una funzione di generazione immagini Nano Banana, Google ha fermato la funzione perché gli utenti generavano in massa immagini inventate, come false foto satellitari di massacri e disastri. Nei commenti è emersa anche la proposta tecnica di distinguere le immagini satellitari autentiche tramite firma crittografica. Tramite !ai_reddit, 2026-08-07. https://fortune.com/2026/08/07/google-quietly-discontinues-its-earth-ai-feature/
- Pubblicità aziendale AI realizzata in sei ore con Runway — post che descrive un concept pubblicitario di 40 secondi in stile Nike, realizzato con Runway Gen-4 e altri strumenti senza troupe o modelli. !ai_reddit, punteggio 1, 2026-09-26. https://v.redd.it/awqo4jp13yrh1
- Suicidio dopo la generazione di 7.000 immagini sessuali della figliastra con Grok — discusso su !fuck_ai come grave caso di abuso di AI closed-source. 2026-07-09. https://lemmy.dbzer0.com/post/71983645
- Stanford ammette l’uso di AI per la “trasformazione razziale” delle foto di studenti — !nottheonion, 2026-09-23. https://san.com/cc/stanford-university-admits-ai-was-used-to-race-swap-student-photo/
Segnali
- Il dibattito di Lemmy sull’AI generativa è quasi interamente open source. Solo !«メールアドレス» ha oltre 20 post di repository e strumenti nelle ultime due settimane; l’ecosistema attorno a Qwen-Image-2.1, modello open-weight legato ad Alibaba, e MiniMax H3 per i video, con nodi ComfyUI, LoRA e WebUI, è il trend più evidente. Emergono anche modelli leggeri come Krea e SupraLabs.
- Gli argomenti closed-source, Midjourney, Sora, Veo, Grok e Google Nano Banana, su Lemmy compaiono quasi esclusivamente come ripubblicazioni di articoli o in casi di abuso e polemica. Non come tutorial o condivisione di opere, bensì in contesti di critica aziendale, regolamentazione e cronaca.
- Il clima della comunità è nel complesso scettico fino a ostile verso l’AI. Esistono più comunità anti-AI art come !fuck_ai e ricorre spesso il termine “AI slop”, contenuti AI prodotti in massa e di bassa qualità. Anche nei post di opere, il sospetto che siano AI può produrre punteggi negativi, come -8 e -6.
- La corrispondenza delle keyword nell’API di ricerca è alquanto instabile. Ricerche di nomi propri come “Flux” o “Veo 3” producono molto rumore, confondendo ad esempio il nome di un’app alternativa a Discord. Osservare direttamente !stable_diffusion si è rivelato più affidabile.
Limiti
- Il numero di utenti e post attivi su Lemmy è molto inferiore rispetto a Reddit e altre piattaforme; più che un luogo di “notizie recenti”, assomiglia a una bacheca di condivisione repository per una comunità di sviluppatori. Gli sviluppi closed-source, come annunci di modelli o recensioni comparative, sono quasi impossibili da raccogliere con Lemmy da solo.
- !«メールアドレス» è stata bloccata da Anubis, il sistema anti-bot, e non è stato possibile visualizzare direttamente la comunità. Sono disponibili solo frammenti dai risultati di ricerca.
- I punteggi, cioè gli upvote, sono in generale molto bassi, spesso a una sola cifra; quasi non esistono post definibili “virali” su Lemmy. Occorre cautela nell’interpretare i valori numerici, dato il piccolo campione della comunità.
- Rispetto al criterio di analisi di 20 post, sul lato open source sono stati verificati oltre 20 elementi in una sola comunità, !stable_diffusion; sul lato closed-source, però, perfino attraversando più keyword e comunità si è arrivati appena a una decina di elementi. Questo riflette una reale distorsione tematica di Lemmy a favore dell’open source, non una carenza di completezza nella ricerca.
Pinterest — Notizie sull'AI per la generazione di immagini e video
È stata usata una sola query, senza categorizzazione di genere, e sono stati raccolti 50 pin. Tutti sono stati verificati come immagini. Più che le tipiche immagini estetiche di Pinterest, il board era popolato soprattutto da miniature promozionali di strumenti AI, infografiche di confronto e miniature di video “AI NEWS” in stile YouTube: un insieme più vicino a blog tecnologici e affiliazioni.
Temi visivi
- Robot umanoidi bianco-azzurri con occhi luminosi sono il volto dominante dell’insieme. Ricorrono robot in giacca, in stile “presentatore di notizie AI” [1, 22, 29, 31, 47], e loghi “AI” a circuito fluttuanti sul palmo di una mano [9, 46, 50], che visualizzano direttamente l’idea che l’AI sostituisca il lavoro umano.
- Texture da circuito blu notte con neon ciano/magenta/viola dominano gli sfondi [4, 8, 14, 16, 32, 45]. Quasi tutti i post ripetono la stessa palette, suggerendo che le miniature dei blog AI siano diventate un template standardizzato.
- Infografiche di confronto e classifica degli strumenti sono frequenti, con loghi disposti per confrontare “gratuito vs a pagamento” o “6 migliori siti di generazione video AI” [3, 9]. Sono affollate di loghi di servizi chiusi come Runway, Pika, Kling AI, Luma AI, Canva AI, Hailuo AI, ChatGPT/Midjourney/Adobe Firefly/Ideogram/SeaArt/Playground/Krea/CapCut.
- Spicca il genere che mette in scena il dubbio “reale vs generato dall’AI”, con lenti d’ingrandimento, timbri “FAKE”, confronti laterali “Human or AI?” e percentuali di rilevamento AI al 97% [1, 26, 27]. L’interesse per l’autenticità è molto forte anche sul piano visivo.
- Si ripete il motivo dell’AI che conquista l’informazione [5, 34, 37, 39, 44]. In un effettivo filmato NBC News compare una clip in stile meteorologa con l’etichetta “AI GENERATED” in alto a sinistra [44], un caso particolare come esempio concreto di produzione informativa.
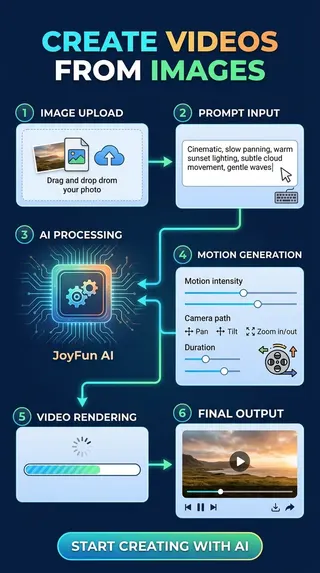
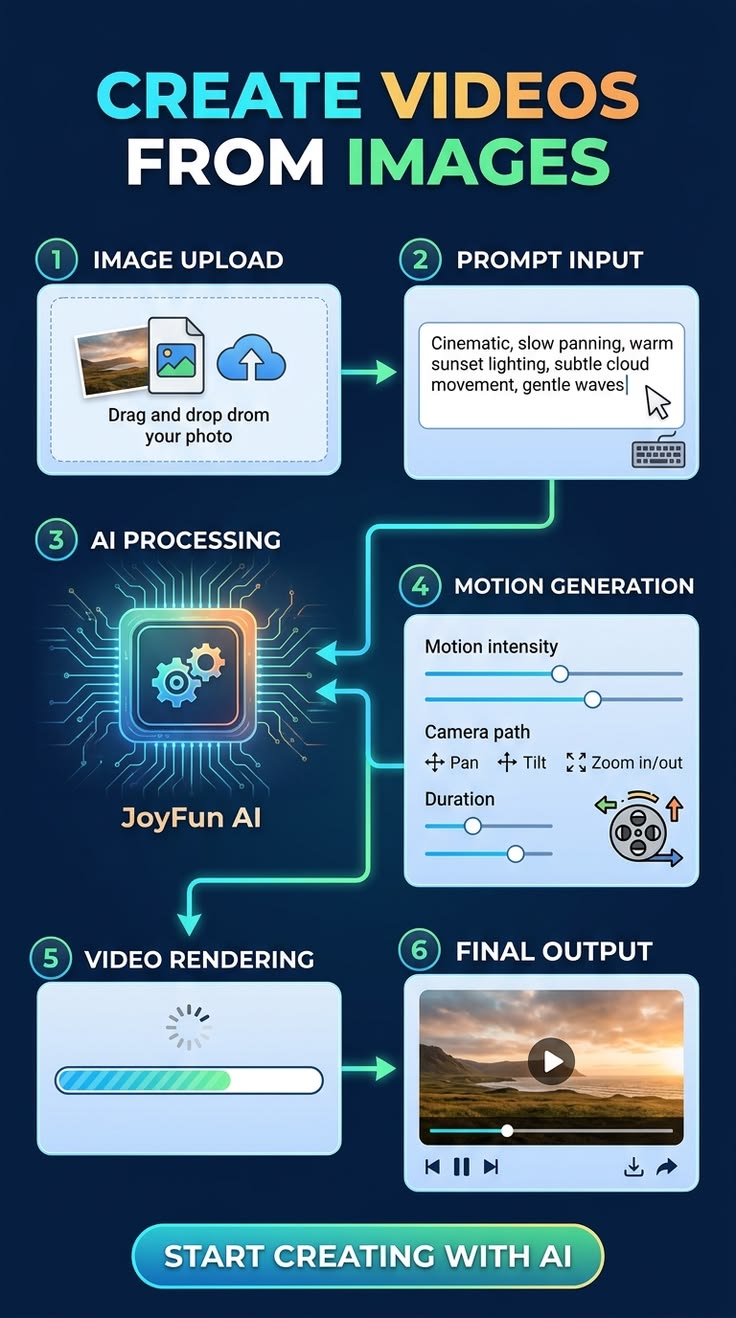
- Più infografiche verticali di spiegazione procedurale, con passaggi da 1 a 6, mostrano il flusso per trasformare immagini in video [6, 24]. Input del prompt → elaborazione AI → rendering → esportazione è diventato il workflow convenzionale.
- Ritratti di persone fotorealistici senza difetti evidenti, primi piani di anziani, composizioni scultura+violoncello e giovani eroi, sono usati come immagini di esempio per la promozione del brand [12, 15, 49], con l’obiettivo di esibire la qualità fotorealistica della generazione di immagini.
- Più immagini di annuncio prodotto con loghi aziendali, come Google Veo 2 / VideoFX [16, 33], Gemini Omni [21], Vidu S1 di ShengShu [48] e Amuse 3.0 di AMD [49], forniscono annunci specifici di nuovi modelli e sono più informative delle immagini AI generiche.
Pin notevoli
- [2] Meta Muse Spark AI Model 2026 — miniatura di un articolo esplicativo su Meta Muse, che promuove una “superintelligenza personale”. Donna con visore, casa, auto e VR composti insieme per sottolineare il filone dell’assistente personale universale.
- [3] 6+ Best AI Video Generation Websites — infografica che confronta Runway/Pika/Kling AI/Luma AI/Canva AI/Hailuo AI. Rende visibile la differenziazione per uso, come cinema, social o principianti.
- [9] AI Image Video: Best Quality vs Best Free — diagramma decisionale che divide per utilizzo gli strumenti a pagamento, ChatGPT Plus, Gemini Advanced, Midjourney, Adobe Firefly, Recraft, Runway Gen-3, Luma, Pika Pro, Kaiber e Synthesia, e quelli gratuiti, Ideogram, Gemini Free, SeaArt, Playground, Krea, Canva, CapCut, Pika Free e Runway Free.
- [15] ByteDance and Hollywood reach global deal on AI copyright — screenshot di un articolo che riferisce di un accordo globale tra ByteDance e la Motion Picture Association per la protezione del copyright negli strumenti AI di generazione immagini/video. Una notizia concreta sull’andamento normativo per il closed source.
- [16] Veo 3 Image-to-Video: Fast Generation & Native Audio via Gemini API — spiegazione del modello più recente della famiglia Google Veo.
- [21] Google's Gemini Omni Turns Anything Into Video — presentazione della nuova funzione Gemini Omni, che trasforma insieme immagini, audio e testo in video.
- [31] Discover how Grok is revolutionizing video... — pin sul possibile ingresso di Grok di xAI nel settore video.
- [44] AI news videos blur line between real and fake reports — clip reale NBC News di una finta meteorologa con l’etichetta “AI GENERATED”. Un esempio di come i principali media stiano cominciando a implementare etichette di divulgazione per i contenuti generati dall’AI.
- [48] ShengShu Technology Unveils Vidu S1 — visual di annuncio di Vidu S1, modello video cinese che dichiara “generazione interattiva in tempo reale”.
- [49] 'Amuse 3.0' — AMD-powered AI art creation tool — annuncio della nuova versione dello strumento di creazione artistica AI che funziona su GPU AMD, uno dei pochi esempi concreti orientati all’esecuzione locale/aperta.
Segnali
- La presenza del closed source è schiacciante: ricorrono ripetutamente loghi e nomi di prodotti commerciali SaaS, tra Google (Veo/Gemini/Omni), Meta (Muse), OpenAI (logo ChatGPT/DALL-E), Runway, Pika, Luma, Kling, Canva, Hailuo, ShengShu (Vidu) e xAI (Grok). Pinterest è dominato da contenuti con intento di acquisto dedicati a chi valuta “quale strumento scegliere”.
- Open source e self-hosting sono poco presenti: Stable Diffusion compare in un solo elemento, [28], e solo nel titolo, con un’immagine di persona AI generica; Amuse 3.0 di AMD [49] è l’unico esempio locale rilevante. Non compaiono per nulla ComfyUI, LoRA o la condivisione di checkpoint: in linea con il pubblico generalista e di marketing di Pinterest, i temi tecnici della catena open-source non emergono.
- Forte interesse per l’autenticità dei contenuti generati dall’AI: timbri FAKE, confronti Human or AI? e percentuali di rilevamento compaiono ripetutamente. Insieme al caso NBC News [44], suggeriscono che etichettatura e affidabilità dei contenuti AI siano ormai temi anche per il pubblico dei consumatori.
- Prevalgono contenuti SEO di confronto e how-to: più che dettagli tecnici sui nuovi modelli, i pin spiegano “quale scegliere” e “come usarlo”, facendo di Pinterest un hub di supporto alle decisioni più che di notizie in tempo reale.
- Uniformazione dei template visivi: sfondi blu notte, circuiti al neon e robot bianchi si ripetono in quasi tutti i pin, mostrando visivamente la standardizzazione e produzione in serie delle miniature dei blog AI.
Limiti
- L’elenco dei pin non aveva categorie di genere, con
genrevuoto per tutti gli elementi; sono stati consultati soltanto i 50 risultati della query singola “Image and Video Generation AI News”. In base al playbook, sono state lette solo le immagini già raccolte e Pinterest stesso non è stato esplorato. - Molte immagini sono miniature di blog o infografiche; il testo degli articoli di destinazione non è stato letto. Le fonti sono unicamente il testo visibile nelle immagini e i titoli/URL in
pinterest.pins.md. - I pin che supportano concretamente le evoluzioni open source sono pochi, con una menzione di Stability AI e una di AMD Amuse; Pinterest, da solo, non offre sufficiente profondità sul tema open source. Si tratta di una distorsione strutturale della piattaforma di ricerca visiva per consumatori, non di una lacuna di raccolta.
Azioni raccomandate
- La prossima volta, passare su Reddit e X a ricerche dirette con nomi propri, come Qwen-Image, Sora, Nano Banana e HunyuanVideo, per ridurre il rumore causato dai trend.
- Sostituire le query per X dipendenti da X Explore con una lista preparata di parole chiave legate all’AI per la generazione di immagini/video.
- Monitorare costantemente il problema 403 dell’API searchPosts di Bluesky e passare a una ricerca esaustiva per keyword non appena verrà risolto.
- Trasformare l’andamento della licenza di Qwen-Image-2.1, in particolare l’ammissibilità dell’uso commerciale, in un controllo fisso per il prossimo follow-up.
- Continuare a monitorare la comunità !stable_diffusion di Lemmy come punto di osservazione per le notizie open source, perché offre la maggiore tempestività.
Immagini raccolte


































Nota sulla qualità dei dati
Su X sono stati raccolti pochissimi post relativi alla generazione AI di immagini/video, perché le query dipendevano dai trend di X Explore, cioè calcio e intrattenimento; Reddit si è fermato a 11 elementi contro il criterio di completamento di 20 ed era sbilanciato verso thread di controversie sociali. Su Bluesky, l’API searchPosts era bloccata da 403, impedendo una ricerca esaustiva; su YouTube, pagine dei risultati e dei video erano renderizzate in JavaScript e dati come le visualizzazioni dipendevano da fonti secondarie.