Notizie sull'IA per la generazione di immagini e video — 2026-09-28
OpenAI ha chiuso Sora (app + API) il 24 settembre 2026, avviando una riorganizzazione tra i protagonisti chiusi del video; nel frattempo, Qwen-Image-2.1 da 7B e Minimax H3 sono stati confermati indipendentemente come i migliori modelli aperti su quattro piattaforme.
OpenAI ha chiuso Sora (sia l'app sia l'API) il 24 settembre 2026, avviando una riorganizzazione tra i protagonisti chiusi del video; nel frattempo, Qwen-Image-2.1 da 7B di Alibaba e Minimax H3 sono stati confermati indipendentemente come i migliori modelli aperti su quattro piattaforme.
Riepilogo delle notizie sull'IA per la generazione di immagini e video — 2026-09-28
Ehi, grazie dell'attesa! Questa settimana il mondo dell'IA per immagini e video è stato davvero movimentato, quindi ecco il rapporto 🔥🔥 La notizia più grande è che OpenAI ha tagliato Sora (sia app sia API) il 24 settembre 2026: sembra il momento in cui la domanda «ma il video generativo è davvero redditizio?» è finalmente emersa in pubblico. Sul fronte open source, invece, Qwen-Image-2.1 di Alibaba (appena 7B parametri ma già vicino ai grandi modelli chiusi 🐉) e Minimax H3 hanno conquistato completamente il centro della scena, e l'entusiasmo della comunità è forse persino maggiore qui. Non tutti i social, però, hanno lo stesso clima: negli spazi tecnici (r/StableDiffusion, la comunità stable_diffusion di Lemmy e gli utenti ComfyUI su YouTube) si discute con passione di confronti concreti fra strumenti; negli spazi più generalisti (i grandi subreddit e Pinterest), invece, è diventata virale soprattutto la diffidenza del tipo «queste immagini AI non sono troppo manipolate?». Questa è una delle scoperte più rilevanti del giro di questa settimana 🙌 Inoltre, X è stato sorprendentemente un buco nell'acqua questa volta (spiegheremo il perché più avanti).
Tra le piattaforme
Osservazioni sul fronte closed source (in tutto 13 📸)
- OpenAI ha terminato completamente Sora (app + API per sviluppatori) il 24 settembre 2026. Si parla di un ritiro piuttosto urgente — Bluesky https://bsky.app/profile/edzitron.com/post/3mhtesqgwxk2k
- L'ipotesi più accreditata sulla ragione della chiusura è che l'economia unitaria della generazione video fosse troppo sfavorevole — Bluesky https://bsky.app/profile/richargh.de/post/3mhur4qo3vc2x
- Ci sono anche notizie secondo cui Wan 3.0 di Alibaba avrebbe superato Sora nelle classifiche dei modelli video — YouTube https://www.youtube.com/watch?v=5Hb429VYNUU
- È arrivato GPT Image 2.5, con le due modalità Flare (velocità) e Sunburst (dettaglio), latenza dimezzata e migliore fedeltà alle immagini di riferimento — YouTube https://www.youtube.com/watch?v=QOfLgJ3TCrQ
- Midjourney ha introdotto l'anteprima live degli stili nell'alpha e continua ad aggiornarsi mensilmente, da V8 a V8.1 a V8.2 — Bluesky https://gen-ai.news/stories/edit-updates-thumbnail-previews-and-more-20d5ed / YouTube https://www.youtube.com/watch?v=dvfH5HzCARY
- Adobe ha integrato Photoshop, Lightroom, Firefly e Acrobat per l'uso diretto dalle chat di Gemini/Claude — Bluesky https://gen-ai.news/stories/adobe-expands-its-ai-integrations-to-gemini-plus-further-powers-up-with-claude-6737b7
- Adobe ha completato l'acquisizione di Topaz Labs e integrerà rapidamente le sue tecnologie di upscaling AI in Firefly/Photoshop — Bluesky https://gen-ai.news/stories/adobe-s-acquisition-of-topaz-labs-is-complete-as-double-down-on-ai-enhancements--3c3f96
- OpenAI ha acquistato la startup di elaborazione fotografica Glass Imaging per 300 milioni di dollari, puntando alla pipeline dalla ripresa alla generazione — Bluesky https://gen-ai.news/stories/openai-reportedly-buys-photo-processing-company-glass-imaging-for-300-million-e004d2
- “Dramagic” di ByteDance è una pipeline completa che genera con l'AI il 95% dei corti drammatici cinesi senza troupe umana — Bluesky https://gen-ai.news/stories/bytedance-launches-dramagic-a-full-pipeline-ai-platform-for-producing-short-dram-20f217
- Runway sta sviluppando i modelli del mondo in tempo reale GWM-1/GWM-2, capaci di comprendere continuativamente l'ambiente invece di generare soltanto clip — Bluesky https://gen-ai.news/stories/runway-s-worldprompt-and-the-engineering-of-real-time-worlds-80e2b7
- Veo3 (attraverso Gemini API) supporta la generazione rapida immagine→video con audio nativo; anche Pinterest è pieno di materiale promozionale prodotto così — Pinterest https://www.pinterest.com/pin/871728071631063018/
- È circolato anche un confronto diretto e serrato fra Kling 3.0, Grok Imagine, Runway Gen-4.5 e Veo 3.1 — YouTube https://www.youtube.com/watch?v=x5fMQvhKP60
- Il pubblico generalista tende a trattare immagini e video AI closed source come scandali: rabbia per foto immobiliari AI troppo ritoccate (27.008 pt) — Reddit https://www.reddit.com/r/mildlyinfuriating/comments/1wmja6n/ , un CEO licenziato per un'immagine AI (594 pt) — Reddit https://www.reddit.com/r/WhitePeopleTwitter/comments/1wq3juw/ , e forte sostegno a una legge sulle filigrane AI obbligatorie (13.925 commenti) — Reddit https://www.reddit.com/r/CriticalState/comments/1wmktek/
Osservazioni sul fronte open source (altre 12 🛠️)
- Alibaba ha pubblicato Qwen-Image-2.1, un leggero modello open weight da 7B: generazione e modifica unificate, livelli trasparenti e fino a dieci immagini di riferimento — Bluesky https://bsky.app/profile/sungkim.bsky.social/post/3mvxr2bj2ck2r 、Lemmy https://lemmy.dbzer0.com/post/75874773 、YouTube https://www.youtube.com/watch?v=3qGl0wiv2G0
- Si sostiene persino che Qwen-Image-2.1 superi in alcuni compiti il grande modello chiuso di Google “Nano Banana 2.0” — YouTube https://www.youtube.com/watch?v=fwHS0ubmI7I
- Tra gli utenti di r/StableDiffusion, Krea 2 ha sostituito Z-Image Turbo come protagonista — Reddit https://www.reddit.com/r/StableDiffusion/comments/1wpr4uf/
- Su Lemmy stanno arrivando rapidamente LoRA di accelerazione per Krea2 (Turbo-Distill, inpaint-edit) — Lemmy https://lemmy.dbzer0.com (comunità stable_diffusion)
- Per la generazione video, Minimax H3 è diventato il campo principale del fronte aperto; strumenti circostanti come AutoContext, UI per il controllo della camera 3D, nodi per il montaggio in timeline e LoRA TaoMate-H3 aumentano di settimana in settimana — Lemmy https://lemmy.dbzer0.com/post/75586069
- SenseNova-U1.5 è stato pubblicato con licenza Apache-2.0 ed è già integrato in ComfyUI — Reddit r/StableDiffusion (thread 11)
- LTX-2.5 è arrivato come rapido modello video open weight e compete in velocità con MiniMax H3 e Seedance 2.5 — YouTube https://www.youtube.com/watch?v=qVGpyw-F-rw
- Wan 3.0 è al momento solo API/beta pubblica e non è ancora disponibile come open weight (la vecchia linea Wan2.x è aperta); Alibaba mantiene una strategia su entrambi i fronti — YouTube https://www.youtube.com/watch?v=fHK7oYrokZY
- SupraLabs/Supra2-IMG, un leggerissimo modello text-to-image da appena 100 milioni di parametri, fa parlare di sé per una qualità allo stato dell'arte rispetto alle dimensioni — Lemmy https://lemmy.dbzer0.com/post/75874769
- È arrivato well9472/Nanosaur2-670M, un modello DiT specializzato in illustrazioni addestrato con appena 600 dollari — Lemmy https://lemmy.dbzer0.com/post/76110122
- AI Horde (servizio distribuito e gratuito di generazione immagini) è stato completamente rinnovato con una nuova UI e un nuovo backend — Lemmy https://lemmy.dbzer0.com/post/75736717
- “Amuse 3.0” di Stability AI, uno strumento di generazione immagini da eseguire localmente sostenuto da AMD, è stato presentato anche su Pinterest — Pinterest https://www.pinterest.com/pin/4601060441986715264/
Qwen-Image-2.1 e Minimax H3 sono arrivati indipendentemente alla stessa conclusione — i migliori modelli aperti del momento — su quattro piattaforme: Reddit, Lemmy, Bluesky e YouTube. È una conferma davvero molto affidabile 🙆
Piattaforma per piattaforma
Reddit: una singola query ha trovato solo 12 thread, ma di ottima qualità. Nelle discussioni tecniche di r/StableDiffusion, Krea 2, Qwen-Image 2.1 e Minimax H3 sono stati citati esplicitamente come vincitori più recenti; nei grandi subreddit generalisti come r/mildlyinfuriating e r/CriticalState, invece, le polemiche su contenuti «gonfiati dall'AI» o «bugie dell'AI» hanno ottenuto una viralità enormemente superiore (da migliaia a oltre diecimila punti). Il thread tecnico migliore è arrivato a 13 pt, mentre i sospetti di scorrettezza al Nikon Small World hanno ottenuto 1.104 pt: questa differenza di temperatura rappresenta bene la diversa ricezione di open e closed source.
X: questa volta è stato quasi totalmente un fallimento per il tema 😅 La sessione risultava geolocalizzata in Croazia; poiché sono stati cercati direttamente i termini di tendenza di Explore (criptovalute, spam di concorsi, fandom F1, dispute storiche ex-jugoslave, foto turistiche e Taylor Swift), fra 40 post non ce n'era neppure uno contenente “AI”, “generazione immagini” o “generazione video”. L'obiettivo numerico (20 post) è stato raggiunto, ma la pertinenza tematica è stata dello 0%.
YouTube: undici video di recensione coprono le principali uscite, fra cui GPT Image 2.5, Qwen-Image-2.1, LTX-2.5 e Wan 3.0. Per l'open source prevalgono video di configurazione ComfyUI che verificano quanto velocemente i modelli girino sulla propria GPU; sul versante closed source si è stabilito un formato di osservazione periodica, come gli aggiornamenti mensili di Midjourney. Tuttavia, per molti video non è stato possibile ottenere visualizzazioni e nomi dei canali, quindi non si è potuta misurare la dimensione effettiva dell'attenzione.
Bluesky: l'account automatico di notizie gen-ai.news è stato il fulcro delle fonti in questa raccolta, con una forte densità di notizie closed source: Runway, Adobe, Midjourney, OpenAI, Meta e ByteDance annunciano quasi qualcosa ogni giorno. Il post sulla chiusura di Sora (3.571 like) è stato il maggior picco di attenzione su questa piattaforma. Sul fronte open source, a parte Qwen-Image-2.1 (82 like), sono emersi soprattutto post vecchi della prima metà del 2025; quasi nessun post individuale recente su Wan/LTX è stato trovato.
Lemmy: !«メールアドレス» è l'unico vero hub, un flusso quasi quotidiano di novità sugli strumenti ComfyUI per Qwen-Image-2.1 e Minimax H3, simile a una raccolta di nuovi link GitHub/HuggingFace. Non esistono comunità dedicate al closed source; le notizie arrivano isolate in comunità generiche come technology, nottheonion e dcstudios, soprattutto come polemiche (manipolazioni razziali di Stanford, false immagini satellitari da Google Earth e pubblicità Meta per app nudify).
Pinterest: è uno spazio visivo senza metriche di engagement disponibili. Nei 50 pin raccolti, miniature con loghi di Veo3, Kling AI, Luma Dream Machine e Gemini Omni — prodotti closed source — dominano quasi completamente; è stata trovata una sola immagine relativa all'open source (Stability AI), e praticamente nulla incentrato su ComfyUI, LoRA o modelli OSS cinesi. Le infografiche su come distinguere un'immagine AI da una reale costituiscono inoltre un genere autonomo, caratteristico di Pinterest.
Cosa osservare
- Diffusione dell'implementazione ComfyUI di Qwen-Image-2.1 — Lemmy https://lemmy.dbzer0.com/post/75874773
- Velocità di crescita degli strumenti attorno a Minimax H3 (AutoContext, LoRA TaoMate-H3) — Lemmy https://lemmy.dbzer0.com/post/75586069
- Equilibri del video generativo dopo Sora (consolidamento verso Veo/Kling/Grok/Runway/Seedance) — Bluesky https://bsky.app/profile/edzitron.com/post/3mhtesqgwxk2k
- Ampliamento del sostegno a una legge sulle filigrane AI obbligatorie — Reddit https://www.reddit.com/r/CriticalState/comments/1wmktek/
- Se Krea 2 riuscirà a sottrarre definitivamente il ruolo da protagonista a Z-Image Turbo — Reddit https://www.reddit.com/r/StableDiffusion/comments/1wpr4uf/
- Se Wan 3.0 verrà pubblicato come open weight o continuerà sulla strada closed source — YouTube https://www.youtube.com/watch?v=fHK7oYrokZY
Raccomandazioni
- Controllare ogni settimana l'ecosistema ComfyUI attorno a Qwen-Image-2.1 e Minimax H3, perché più piattaforme li hanno confermati indipendentemente come i migliori modelli aperti del momento.
- Nella prossima raccolta su X, abbandonare la dipendenza dai trend regionali e cercare direttamente keyword in inglese e giapponese, come “image generation AI”, “Stable Diffusion” e “Midjourney”.
- Seguire prezzi e competizione sulle funzionalità dei protagonisti closed source del video dopo Sora (Veo, Kling, Grok, Runway e Seedance), in un mercato in fase di riduzione e riorganizzazione.
- Poiché Pinterest non fornisce un indicatore della grandezza del dibattito (salvataggi o like), usarlo più come riferimento per capire quale linguaggio visivo sia attualmente in uso che come misuratore di tendenze.
- Continuare a monitorare la sfiducia verso i contenuti generati dall'AI comune a Reddit, Lemmy e Pinterest, perché è direttamente collegata al clima normativo sulle filigrane obbligatorie.
- Nella nuova raccolta Reddit, usare query specifiche per “open source” e “closed source”, così da aumentare il numero di risultati fino al criterio di completamento di 20 analisi per piattaforma.
Qualità dei dati
X è stato un fallimento sostanziale di raccolta: un errore di geolocalizzazione e ricerche basate sui trend hanno prodotto 0 post pertinenti su 40. L'API di ricerca ufficiale di Bluesky ha restituito 403, concentrando la raccolta sugli articoli di un solo account, gen-ai.news. Pinterest non includeva metriche di engagement (salvataggi e like), perciò non era possibile misurarne la popolarità; per YouTube non era possibile ottenere molte visualizzazioni e nomi dei canali. Le informazioni open source di Lemmy sono concentrate di fatto in una comunità e in uno o due autori; anche Reddit, con una sola query, si è fermato a 12 thread, sotto il criterio di 20.
Riepilogo per piattaforma
Reddit — Notizie sull'IA per la generazione di immagini e video
Dove
Sono stati raccolti 12 thread da 9 subreddit, tutti emersi da una sola ricerca: "Image and Video Generation AI News".
| Subreddit | Membri | Thread raccolti |
|---|---|---|
| r/generativeAI | 157,870 | 3 |
| r/labrats | 726,970 | 2 |
| r/WhitePeopleTwitter | 3,145,768 | 1 |
| r/mildlyinfuriating | 12,600,570 | 1 |
| r/CriticalState | 43,691 | 1 |
| r/aivideomaking | 7,949 | 1 |
| r/ChaiUnofficial | 30,105 | 1 |
| r/StableDiffusion | 1,026,206 | 1 |
| r/AmItheAsshole | 24,612,930 | 1 |
r/generativeAI è l'unico hub ricorrente per discussioni sulle raccomandazioni di strumenti. Tutti gli altri sono presenze isolate — per lo più enormi subreddit generalisti (r/mildlyinfuriating, r/AmItheAsshole, r/WhitePeopleTwitter) che reagiscono a contenuti generati dall'AI invece di discutere della tecnologia, più r/labrats, che porta avanti un singolo scandalo in due thread.
Cosa dicono le persone
- Thread 1 (r/generativeAI, 10 punti, 2026-09-23) — Sulla realizzazione di video AI in formato lungo: u/kaboom-o descrive l'attuale pipeline reale — "Gli script diventano una lista di inquadrature, poi una pila di clip da 5–15 secondi, poi un montaggio... Per le clip che devono mantenere un volto più a lungo, Seedance 2.5 (fino a ~30 secondi, audio nativo)... Bozze di movimento economiche... Grok Imagine Video a 480p, 5 secondi. Per il fotorealismo: Gemini Omni Flash." — https://www.reddit.com/r/generativeAI/comments/1wog53q/
- Thread 1 — u/AlfieSchmalfie mostra il costo reale di un lavoro finito: "Ho appena completato un video di 12 minuti. 148 inquadrature... 8 settimane di montaggio. Budget di circa 1.000 AUD, esclusi gli abbonamenti a Runway ed ElevenLabs... Ne è valsa la pena."
- Thread 2 e 4 (r/labrats, 1.104 pt / 134 commenti e 419 pt / 90 commenti, 2026-09-23/24) — Un video microscopico generato dall'AI ha vinto il Nikon Small World in Motion; Nikon ha ammesso che l'AI era stata usata per “migliorarlo” e colorarlo falsamente. u/Barkinsons (630 voti positivi): "Gli strumenti AI non hanno posto nelle immagini di microscopia scientifica, perché abbiamo l'obbligo di riprodurre le immagini nel modo più fedele possibile alla verità." L'autore ha poi ammesso che è stata usata un'“AI non supervisionata per segmentare ed etichettare” strutture mai verificate come reali; u/Feline_Diabetes (301): "È assolutamente fuorviante... le immagini dovrebbero essere più o meno reali — elaborate, certo, ma non rendering AI." — https://www.reddit.com/r/labrats/comments/1wo0j5e/ and https://www.reddit.com/r/labrats/comments/1woxdhk/
- Thread 3 (r/generativeAI, 3 punti, 2026-09-26) — A chi cerca generazione gratuita di immagini vengono suggerite opzioni locali/gratuite: u/Scuzzy_Womack raccomanda "Comfy ui non connesso a Internet e gratuito", mentre altri suggeriscono Yodayo/MoescapeAI e Leonardo per i loro crediti gratuiti giornalieri. — https://www.reddit.com/r/generativeAI/comments/1wqfleb/
- Thread 5 (r/generativeAI, 5 punti, 2026-09-22) — Sui generatori video, u/sharktank123456 segnala un cambio di piattaforma: "Dream Machine non è più disponibile per i nuovi abbonati, ma Luma Agents sì... una piattaforma completa con tutti i principali modelli." u/jmbirn indica gli aggregatori (Magnific AI, Fal, Krea) come modo pratico per provare molti modelli con un solo account. — https://www.reddit.com/r/generativeAI/comments/1wngj3w/
- Thread 6 (r/WhitePeopleTwitter, 594 punti, 2026-09-25) — Il CEO di una credit union è stato licenziato per un'immagine AI “Lake America sweaters”; il commento più votato (u/samanime, 298): "Se più idioti come questo subissero conseguenze simili, ce ne sarebbero molti meno in giro." — https://www.reddit.com/r/WhitePeopleTwitter/comments/1wq3juw/
- Thread 7 (r/mildlyinfuriating, 27.008 punti, 723 commenti, 2026-09-21) — Frustrazione per foto immobiliari “messe in scena” dall'AI: "Voglio solo vedere la casa com'è ora, senza dover analizzare cosa sia reale e cosa no... l'AI può perfino rimuovere i radiatori, quindi non potresti mai arredarla davvero come mostrato." Il commento principale (u/slothboy, 5.794 pt) osserva che il bagno aggiunto dall'AI sarebbe "un progetto da cinque cifre" da costruire davvero. — https://www.reddit.com/r/mildlyinfuriating/comments/1wmja6n/
- Thread 8 (r/CriticalState, 1.314 punti, 13.925 commenti, 2026-09-21) — Una proposta di legge in stile sondaggio per la filigranatura obbligatoria di tutte le immagini/testi generati dall'AI sta ottenendo enorme engagement; i commenti principali sono voti di una riga, “Sì ✅”, che citano i rischi di disinformazione e la protezione dalle truffe agli anziani (u/Middle_Juggernaut298: "Per via degli anziani truffati o cose del genere"). — https://www.reddit.com/r/CriticalState/comments/1wmktek/
- Thread 9 (r/aivideomaking, 13 punti, 2026-09-23) — Sulla generazione di prompt per video AI, u/3DisMzAnoMalEE: "Dopo qualche centinaio di prompt e l'ottimizzazione di gate, cfg e soprattutto prompt negativi, Grok è stato di gran lunga il migliore... sia SFW sia NSFW, è difficile batterlo." — https://www.reddit.com/r/aivideomaking/comments/1wo38ww/
- Thread 11 (r/StableDiffusion, 1 punto, 2026-09-25) — La panoramica open source più tecnica della raccolta: il consenso è che il settore sia passato da Z-Image Turbo a Krea 2 per text-to-image ("Al posto di z image ora c'è kre2... Krea2 fa tutto quello che z image poteva fare, ma meglio" — u/Sirmckhalifa5566), Qwen-Image 2.1 per il montaggio e Minimax H3 alla guida del video; u/Cultural-Broccoli-41 segnala SenseNova-U1.5 come valida alternativa con licenza Apache-2.0 già collegata a ComfyUI. — https://www.reddit.com/r/StableDiffusion/comments/1wpr4uf/
- Thread 10 (r/ChaiUnofficial, 5 punti, 2026-09-21) — Gli utenti paganti (“ultra”) non sono soddisfatti di un generatore immagini/video aggiunto alla piattaforma: u/ConsistentWolf2076: "La generazione di immagini e video avrebbe dovuto essere gratuita. E immagini e video non sono nemmeno così belli. Posso disegnare meglio di quanto riesca a generare immagini lol." — https://www.reddit.com/r/ChaiUnofficial/comments/1wlxxa3/
Segnali
- In crescita: il rapido ricambio di nomi/versioni è seguito informalmente dagli utenti esperti — Z-Image Turbo è stato soppiantato da Krea 2 e Minimax H3 viene nominato ripetutamente come il migliore video attuale (thread 1, 9 e 11), con quasi nessun dissenso tecnico. La licenza Apache-2.0 e il supporto nativo di ComfyUI per SenseNova-U1.5 (thread 11) sono l'unico dato chiaramente open source a suscitare entusiasmo autentico.
- In crescita: le piattaforme aggregatrici/multi-modello (Luma Agents, OneOver, Magnific AI/Fal/Krea) vengono consigliate al posto degli abbonamenti a un singolo modello, perché gli utenti cambiano modello nel corso dei progetti (thread 1 e 5).
- Respinto / contraccolpo: al di fuori dei subreddit concentrati sugli strumenti, ogni presenza di immagini AI in un contesto reale è letta come scandalo, non come innovazione — una vittoria in una gara scientifica (labrats, due thread, 1.104 + 419 punti), un CEO licenziato (594 punti), frode nelle foto immobiliari (27.008 punti) e un sondaggio virale su una legge sulle filigrane (13.925 commenti). I subreddit tecnici trattano gli stessi strumenti con neutralità; quelli generalisti li trattano come un problema di fiducia.
- Sorprendente: i due thread Nikon Small World hanno generato molta più attenzione e carica morale (1.104 e 419 punti, 134 e 90 commenti) di qualsiasi thread su “qual è il modello migliore”: il miglior thread di strumenti in generativeAI/StableDiffusion si è fermato a 13 punti. Su Reddit, oggi, “un video AI ha fatto qualcosa di disonesto” attira più di “un video AI fa qualcosa di nuovo”.
- Disaccordo: nel thread 4, alcuni commentatori definiscono frode qualsiasi uso dell'AI nell'imaging scientifico ("Chiunque alteri il blot reale è un truffatore" — autore del post), mentre altri (u/thezfisher, 44 pt) sostengono che l'elaborazione delle immagini è sempre stata manipolata e che questo sia solo un problema di visibilità: "nessuna immagine è davvero affidabile oggigiorno, a meno che non mostrino le regolazioni LUT."
Limiti
- Su Reddit è stato cercato un solo termine — "Image and Video Generation AI News" — che ha restituito 12 thread, sotto i circa 20 richiesti dai criteri di completamento; non sono state eseguite ricerche separate per le prospettive “open source” e “closed source”, quindi questa raccolta probabilmente sottostima le discussioni dedicate ai rilasci di modelli (per esempio, un solo thread da r/StableDiffusion e nessuno da r/MachineLearning, r/midjourney, r/OpenAI o r/aivideo).
- Il thread tecnico più pertinente (r/StableDiffusion, thread 11) aveva solo 1 voto positivo e 20 commenti: buon contenuto, ma suggerisce che la query abbia trovato più viralità basata su controversie che discussioni nelle sedi della comunità tecnica.
- Nessun thread del set cita direttamente un rilascio closed source, un cambio di prezzo o un annuncio aziendale (per esempio Midjourney, Sora, Veo o Runway): il segnale closed source qui è indiretto, proveniente dalle menzioni di strumenti all'interno di thread di raccomandazioni anziché da notizie dedicate.
- Non è possibile verificare indipendentemente questi numeri né consultare nuovamente Reddit: questo file è costruito interamente da
output/reddit.threads.md, perché Reddit rifiuta WebFetch e blocca direttamente le pagine dei risultati di ricerca.
X
X — Notizie sull'IA per la generazione di immagini e video
Account
Fra i 40 post e 39 account raccolti questa volta, non è stato trovato nemmeno un account che pubblichi principalmente su IA per la generazione di immagini o video, né closed source né open source. Volendo classificare gli argomenti:
- Criptovalute (token $ADA/$SONG): @Nadalina04 (2 post, 25 like), @SintoAndrej, @EAjdarovic — post promozionali della comunità Cardano.
- Raffica di spam per concorsi e giveaway: @CSharp66427821, @dwayne_lepley, @DustinThel46652, @Jordan95133426 — più account pubblicano in modo bot-like lo stesso testo, “Quad Goals by @Fanatics”, con hashtag differenti (quasi nessun like).
- Cultura gaming/gamer: @hotdropfps (concorso PC, 287 like), @Maki_D_Luffy, @Indie_RetroNEWS.
- Fandom F1 (Lando Norris): @ckno_ff, @4unclelala, @landoxeneize, @alukelipse — tutti con centinaia o migliaia di like, con conflitti e difese tra fan di Norris.
- Storia politica dell'ex Jugoslavia/Balcani (incluse tensioni etniche): @TwiceDeadd (2.282 like, l'engagement più alto), @mctogs, @vbspurs, @axeljarcor, @OssoKuka, @walsh_kirk91371, @jeffreybacic, @vragan95 — post polemici sulle tensioni storiche tra Serbia e Croazia. In genere un post per account; la grande diffusione deriva soprattutto da un singolo post di @TwiceDeadd.
- Fotografie paesaggistiche italiane: @prjipata (collezione moda Tod's), @PrettyCitiesX, @worldparadiseX (3.930 like), @naturalbeautyi7 (2.666 like) — foto di splendide destinazioni turistiche.
- Taylor Swift: @_daddydisco (67.235 like, circa 1,2 milioni di visualizzazioni e principale picco della raccolta), @psychocrzzzy, @wandasattorney, @TSUpdating — record di vendita del nuovo album e argomenti legati ai VMA.
Post
Nessuno dei 40 post menzionava IA per immagini o video. Per riferimento, ecco i post con maggiore engagement, tutti fuori tema.
- @_daddydisco (67.235 like, 4.941 repost, 191 risposte, circa 1,2 milioni di visualizzazioni, 2026-09-26)https://x.com/_daddydisco/status/2103642992342860157 — Poesia metaforica sul “volto che si trasforma in argilla”. È stato il maggiore picco virale dell'intera raccolta, ma non ha relazione con l'AI.
- @wandasattorney (6.842 like, circa 138.000 visualizzazioni, 2026-09-28)https://x.com/wandasattorney/status/2104362546107191455 — argomento VMAs: “LISA winning best pop over Taylor Swift…”.
- @TwiceDeadd (2.282 like, 295 repost, 55 risposte, circa 35.000 visualizzazioni, 2026-09-27)https://x.com/TwiceDeadd/status/2104209913228771333 — il tema politico balcanico “we gotta try yugoslavia again” ha avuto grande diffusione.
- @worldparadiseX (3.930 like, circa 91.000 visualizzazioni, 2026-09-26)https://x.com/worldparadiseX/status/2103775750486986847 — foto paesaggistica del Passo Giau, in Italia.
- @psychocrzzzy (2.995 like, circa 60.000 visualizzazioni, 2026-09-27)https://x.com/psychocrzzzy/status/2104213800610152704 — argomento sul record Spotify di una nuova canzone di Taylor Swift.
Nessuno di questi è collegato agli sviluppi dell'IA closed source/open source per immagini e video, quali annunci di nuovi modelli, aggiornamenti di strumenti o discussioni comparative.
Segnali
- La query usata questa volta era fuori tema: i termini cercati (“$SONG”, “#chance”, “#sweepstakes”, “#giveaways”, “#gaming”, “Lando”, “Yugoslavia”, “Croats”, “Italy”, “Taylor”) non sono collegati all'IA per immagini/video e sembrano essere stati presi direttamente dalle tendenze mostrate da X Explore per una sessione con impostazione regionale croata. Di conseguenza, gli argomenti raccolti si sono concentrati in cinque filoni — criptovalute, spam di concorsi, fandom F1, controversie storiche balcaniche, foto turistiche e Taylor Swift — senza alcuna traccia di notizie AI.
- In 40 post, nessuno conteneva keyword quali “AI”, “generazione immagini”, “generazione video”, “Midjourney”, “Stable Diffusion” o “Sora”.
- Non esiste nemmeno un caso a cui sia possibile associare l'AI per semplice suggestione; è opportuno evitare collegamenti forzati.
Limiti
- Explore di X (la lista dei trend) è geolocalizzato in Croazia in base all'origine della connessione della sessione. Le posizioni 1–4, 8 e 10 erano etichettate “Trending in Croatia”, la 5 “Gaming”, la 6 “Motorsport”, la 7 “Politics” e la 9 “Sports”: sono tutte tendenze locali, non mondiali e certamente non del settore AI.
- I dieci termini effettivamente cercati ($SONG, #chance, #sweepstakes, #giveaways, #gaming, Lando, Yugoslavia, Croats, Italy, Taylor) sembrano essere le tendenze di Explore utilizzate direttamente dal worker come query, ma non hanno alcuna relazione con il tema della generazione AI di immagini e video. Non è stata quindi fatta una nuova raccolta con query pertinenti quali “image generation AI”, “video generation AI”, “Stable Diffusion”, “Midjourney” o “Sora”.
- Il criterio di completamento, “analizzare circa 20 post”, è stato raggiunto per quantità (40), ma dato che i post pertinenti sono zero, i requisiti di almeno dieci osservazioni su closed source e dieci su open source non possono essere soddisfatti con i dati di X.
- Oltre ai file già raccolti (
output/x.posts.md,output/x.posts.json), non esisteva un mezzo per accedere ulteriormente a X (in questa fase il worker poteva solo leggere dati pre-raccolti), quindi non era possibile ripetere la raccolta con query pertinenti.
YouTube
YouTube — Notizie sull'IA per la generazione di immagini e video (closed source vs open source)
Canali
L'attribuzione ai canali è stata difficile in questa raccolta (vedere Limiti): le pagine YouTube /watch e /results esponevano a WebFetch solo contenuti statici di piè di pagina, quindi molti nomi dei canali sotto provengono dagli snippet di WebSearch anziché dalla pagina stessa.
- Woollyfern — gestisce una serie ricorrente mensile “Midjourney Update” che copre ogni aumento di versione (V8, V8.1, V8.2) nel 2026.
- Diversi canali tutorial/confronto coprono, uscita per uscita, lo stack open source ComfyUI (Qwen-Image, LTX, Wan), ma i nomi individuali dei canali non si sono potuti confermare dai soli snippet di ricerca — titoli e link restano comunque reali e tracciabili (vedere Video).
- Canali generici di “riepilogo settimanale delle notizie AI” (per esempio il creatore di “Exciting AI Updates Weekly”) pubblicano digest che toccano sia le uscite closed sia open source nel campo immagini/video.
Video
-
GPT Image 2.5 Review: What Changed and How to Actually Use It
— canale “Aristotto” — pubblicato poco dopo l'8 settembre 2026 —
https://www.youtube.com/watch?v=QOfLgJ3TCrQ
Sostiene che le due modalità di GPT Image 2.5 (Flare per velocità e Sunburst per dettaglio) migliorino in modo significativo la fedeltà alle immagini di riferimento e l'affidabilità delle modifiche multi-turno rispetto a GPT Image 2.0, con latenza inferiore di circa il 50%. -
GPT Image 2.5 Is Here — Everything You NEED to Know
— canale non identificato — pubblicato intorno al 22 settembre 2026 (secondo lo snippet, “6 days ago”) — https://www.youtube.com/watch?v=20vo5nW9yXI
Illustra le novità da GPT Image 2.0 a 2.5, incluso l'output nativo PNG/WebP con sfondo trasparente. -
Qwen-Image-2.1 Is INSANE… Just 7B Parameters?!
— canale non identificato — pubblicato circa il 22–24 settembre 2026 (Qwen-Image-2.1 è uscito il 21 settembre 2026 secondo MarkTechPost) —
https://www.youtube.com/watch?v=3qGl0wiv2G0
Sostiene che l'open weight Qwen-Image-2.1 da 7B di Alibaba renda molto oltre le sue dimensioni, avvicinandosi a modelli chiusi molto più grandi. -
A 7B Model That Beats Nano Banana 2.0? Master Qwen Image 2.1: Native
2K, RGBA & 10-Image Workflows
— canale non identificato — pubblicato circa il 23 settembre 2026 —
https://www.youtube.com/watch?v=fwHS0ubmI7I
Afferma che Qwen-Image-2.1 superi il Nano Banana 2.0 di Google in diversi compiti pur funzionando in locale, e mostra output nativo 2K, trasparenza RGBA e modifica con dieci immagini di riferimento. -
LTX-2.5 Is Here: The Fastest Open AI Video Model Yet?
— canale non identificato — 16 agosto 2026 —
https://www.youtube.com/watch?v=qVGpyw-F-rw
Anteprima del modello open weight LTX-2.5 di Lightricks, posizionato contro MiniMax H3 e Seedance 2.5 sul terreno della velocità di generazione. -
LTX-2.5 Open Weights Running In ComfyUI With - Is this Better?
— canale non identificato — 12 agosto 2026 —
https://www.youtube.com/watch?v=XAhuGRCI2tM
Configurazione e test locale in ComfyUI di LTX-2.5 il giorno dopo il rilascio open weight, chiedendosi se superi la precedente base LTX-2. -
I Tested WAN 3.0 With 5 INSANE AI Video Challenges
— canale non identificato — 20 agosto 2026 —
https://www.youtube.com/watch?v=5Hb429VYNUU
Sottopone Wan 3.0 di Alibaba (beta pubblica, clip da 30 secondi) a test impegnativi e lo confronta con Seedance; osserva che Wan 3.0 è attualmente solo API/beta, anziché open weight come le versioni Wan precedenti. -
Alibaba Wan 3.0 Made a 30 Second App Commercial for $1.27
— canale non identificato — 24 agosto 2026 —
https://www.youtube.com/watch?v=fHK7oYrokZY
Dimostrazione di costo/qualità di Wan 3.0 subito dopo il suo arrivo su OpenRouter, presentato come alternativa economica ai generatori video closed source. -
Midjourney Update | July 2026: V8.2 is HERE! Personalization, NIJI
Style Creator, and More!
— canale Woollyfern — pubblicato nel luglio 2026 —
https://www.youtube.com/watch?v=dvfH5HzCARY
Esamina la personalizzazione e il creatore di stile NIJI in V8.2; parte di una cadenza mensile che segue la roadmap closed source di Midjourney (V8 → V8.1 → V8.2, da febbraio a luglio 2026). -
Kling 3.0 vs Grok Imagine vs Runway Gen-4.5 vs Veo 3.1: The Ultimate
AI Video Comparison
— canale non identificato — circa 10 marzo 2026 (più vecchio della finestra di 60 giorni, mantenuto perché è il video più chiaro che mette direttamente a confronto quattro modelli video closed source) —
https://www.youtube.com/watch?v=x5fMQvhKP60
Classifica i quattro generatori video closed source per qualità cinematografica, lip-sync e coerenza multi-inquadratura. -
Exciting AI Updates Weekly — September 25, 2026
— creatore “Lev Selector” — 25 settembre 2026 —
https://www.youtube.com/watch?v=iyZHPCNd8jI
Riepilogo settimanale di AI generale che include uscite per immagini/video (GPT Image 2.5, Qwen-Image-2.1) insieme a notizie AI più ampie.
Segnali
- I modelli open weight stanno colmando rapidamente il divario, e lo dichiarano apertamente. Diversi titoli di video in questa raccolta presentano esplicitamente Qwen-Image-2.1 da 7B di Alibaba come capace di battere o eguagliare il molto più grande Nano Banana 2.0 di Google (#3, #4): la narrativa “piccolo modello aperto batte grande modello chiuso” è ormai un gancio ricorrente, non un caso isolato.
- Il video open source corre sulla velocità locale, non solo sulla qualità. LTX-2.5 (#5, #6) e la linea Wan (#7, #8) vengono trattati soprattutto con video di configurazione/benchmark ComfyUI, non con trailer patinati: il pubblico vuole sapere quanto bene girino sulla propria GPU.
- Il video closed source si sta consolidando. OpenAI chiude l'intera API Sora 2 il 24 settembre 2026 (confermato dall'help center di OpenAI e da varie testate, anche se questa raccolta non ha trovato una reazione YouTube dedicata — vedere Limiti), mentre Wan 3.0 di Alibaba avrebbe superato Sora nelle classifiche mondiali dei modelli video più o meno nello stesso periodo (VentureBeat). La corsa closed source si restringe a Veo/Kling/Grok/Runway/Seedance.
- I leader closed source dell'immagine rilasciano con una cadenza mensile o di piccoli aggiornamenti. V8 → V8.1 → V8.2 di Midjourney (#9) e GPT Image 2.0 → 2.5 di OpenAI (#1, #2) mostrano aggiornamenti puntuali e frequenti anziché grandi salti di versione; i canali di copertura si sono adattati con formati ricorrenti di aggiornamento mensile.
- Wan 3.0 è un segnale parziale, non una netta vittoria open source — è attualmente solo API/beta pubblica (#7, #8), a differenza della linea open weight Wan 2.x, e suggerisce che Alibaba stia mantenendo un approccio ibrido fra distribuzione aperta e chiusa.
Limiti
- Non è stato possibile recuperare visualizzazioni e iscritti. WebFetch sia su
youtube.com/watch?v=...sia suyoutube.com/results?search_query=...ha restituito soltanto il contenuto statico legale/piè di pagina di YouTube — le metriche sono nei dati JS-renderizzatiytInitialData, mai presenti nel contenuto ricevuto. Anche gli snippet WebSearch non riportavano tali dati. Ogni dato su “visualizzazioni”/“iscritti” è stato quindi omesso anziché stimato. - Diversi nomi di canali non sono stati confermati. Quando gli snippet WebSearch non identificavano un creatore, le voci sopra riportano “canale non identificato” anziché fare supposizioni.
- Nessun video YouTube dedicato è emerso in reazione alla chiusura dell'API Sora 2 (confermata per il 24 settembre 2026 da fonti non YouTube) nonostante varie ricerche mirate; viene citata nei Segnali come contesto ma non conteggiata come dato YouTube.
- La copertura di ricerca si è basata sugli snippet Google indicizzati di YouTube, anziché sull'interfaccia di ricerca YouTube in tempo reale, dato che l'interfaccia non era recuperabile; questo probabilmente sottorappresenta upload molto recenti degli ultimi giorni non ancora completamente indicizzati da Google.
Bluesky
Bluesky — Ultimi sviluppi dell'IA per la generazione di immagini e video
Account
- gen-ai.news(@gen-ai.news)— account che pubblica automaticamente notizie dell'industria dell'AI generativa. Fra il 18 e il 27 settembre 2026 ha pubblicato riassunti di articoli sull'AI per immagini/video a un ritmo di uno-tre al giorno; la maggior parte delle “notizie recenti” trovate in questa fase viene da qui.
- sungkim.bsky.social(@sungkim.bsky.social)— analista aziendale che segue AI/ML/analisi dei dati. Ha 8.690 follower e pubblica spesso notizie rapide di rilasci open weight.
- edzitron.com(@edzitron.com)— account legato a una newsletter noto per la critica all'industria tech. Il post su Sora ha ottenuto grande diffusione (vedere sotto).
- richargh.de(@richargh.de)— ha pubblicato una propria analisi della chiusura di Sora dal punto di vista dell'economia unitaria.
- luok.ai(@luok.ai)、adinayakup.bsky.social(@adinayakup.bsky.social)— autori che presentano informazioni tecniche su modelli video open source (linea SkyReels).
- dahara1.bsky.social(@dahara1.bsky.social)— utente che condivide in giapponese esperienze di beta test dell'AI generativa.
Post
Sviluppi sul fronte closed source
- OpenAI chiude Sora — @edzitron.com, 2026-03-24, 👍3.571 🔁984 💬99. Citando WSJ e The Information, commenta che “chiuderà l'accesso non solo all'app ma anche all'API per sviluppatori: una mossa piuttosto urgente”. Il maggiore picco virale su questo tema in Bluesky.
- La chiusura di Sora vista come fallimento dell'economia unitaria — @richargh.de, 2026-03-25, 👍2 🔁0. Analisi: “Probabilmente hanno capito che l'economia unitaria della generazione video era troppo sfavorevole. Forse non sono riusciti a convertire gli utenti gratuiti in paganti”.
- La chiusura dell'API Sora è stata eseguita il 2026-09-24 (confermata attraverso articoli di gen-ai.news e risultati di ricerca; non è stato trovato un post di Sora stesso. Fonte: Wikipedia: Sora per verificare la data).
- GWM 2 di Runway — gen-ai.news, 2026-09-27. Un modello del mondo che “continua a comprendere l'ambiente” invece di generare clip.
- Runway sviluppa stream video in tempo reale con GWM-1 — gen-ai.news, 2026-09-20. Presentato come tecnologia con applicazioni anche in robotica e guida autonoma.
- L'alpha di Midjourney aggiunge l'anteprima live degli stili — gen-ai.news, 2026-09-27 (con precedenti modifiche nell'articolo del 25 settembre). Ora è possibile verificare l'aspetto di uno stile prima di generare.
- La suite creativa Adobe viene integrata in Gemini/Claude — gen-ai.news, 2026-09-26. Photoshop, Lightroom, Firefly e Acrobat diventano direttamente utilizzabili da un'interfaccia chat.
- Adobe completa l'acquisizione di Topaz Labs — gen-ai.news, 2026-09-25. Prevede una rapida integrazione della tecnologia di upscaling AI in Firefly/Photoshop; il brand Topaz sarà mantenuto per il momento.
- OpenAI acquista Glass Imaging per 300 milioni di dollari — gen-ai.news, 2026-09-19. Startup di elaborazione immagini per fotocamere mobili; l'analisi la interpreta come una mossa per coprire l'intera pipeline dell'immagine, dalla generazione allo scatto.
- Dramagic di ByteDance genera con l'AI il 95% dei corti drammatici cinesi — gen-ai.news, 2026-09-22. Presentata come pipeline che completa dalla sceneggiatura al video senza troupe umana.
- Il comitato di sorveglianza Meta ordina la rimozione di video deepfake — gen-ai.news, 2026-09-19. Richiede inoltre a Meta di rafforzare le politiche di rilevamento e rimozione.
Sviluppi sul fronte open source
- Alibaba pubblica Qwen-Image-2.1 come open weight — @sungkim.bsky.social, 2026-09-20, 👍82 🔁10 💬4. Lo presenta come “architettura leggera da 7B che unifica generazione e modifica e accelera in modo significativo l'inferenza multi-immagine”.
- Spiegazione dettagliata dello stesso modello — gen-ai.news, 2026-09-20. “Modello open weight per immagini da 7B, eseguibile su GPU consumer, con supporto a livelli trasparenti e fino a dieci immagini di riferimento simultanee; sostiene prestazioni di benchmark pari ai grandi modelli chiusi”.
- SkyReels V1, primo modello fondativo video open source specializzato nelle persone — @luok.ai, 2025-02-18, 👍3 🔁1. Descrive il fine-tuning di HunyuanVideo su oltre dieci milioni di clip, con capacità dichiarata di catturare 33 espressioni e oltre 400 movimenti.
- SkyReels-A2, framework per generazione video controllabile da testo + immagini — @adinayakup.bsky.social, 2025-04-04, 👍3 🔁2. Presentato come framework aperto di Skywork e KunLun.
- Esperienza di beta test con HunyuanVideo (in giapponese) — @dahara1.bsky.social, 2025-03-06. Riporta che è diventato possibile generare video con audio da una singola immagine (I2V) e condivide risultati di lip-sync in stile anime.
Segnali
- Nella seconda metà di settembre, il fronte closed source presenta una forte densità di notizie: Runway, Adobe, Midjourney, OpenAI, Meta, ByteDance e Pinterest hanno presentato quasi ogni giorno annunci, acquisizioni o cambi di direzione nei dieci giorni dal 18 al 27 settembre 2026, e gli account di notizie AI su Bluesky hanno seguito questo ritmo.
- Il clima è “la generazione video non è redditizia”: la chiusura di Sora (3.571 like) viene trattata come un chiaro punto di svolta; valutazioni come quella di richargh.de, secondo cui l'economia unitaria è cattiva, stanno diventando una percezione condivisa dalla comunità.
- L'open source per immagini è dominato dalla presenza di Alibaba Qwen: Qwen-Image-2.1 è stato trattato lo stesso giorno sia da un account individuale (sungkim.bsky.social) sia da un account di notizie (gen-ai.news); gli 82 like costituiscono la maggior risposta verificata per un post individuale in questa fase. Il fulcro è l'affermazione “leggero 7B ma comparabile a grandi modelli chiusi”.
- I post individuali sul video open source sono scarsi e anche vecchi: i post su SkyReels e HunyuanVideo risalgono alla prima metà del 2025; nelle ricerche Bluesky non sono stati trovati post individuali significativi su Wan 2.7, LTX-2.3 o FLUX.2 a settembre 2026.
- Esiste una forma di autocorrezione sull'accuratezza delle notizie del settore: il 23 settembre 2026 gen-ai.news ha dichiarato che “GPT-6” e “Astra” non esistono e che non avrebbe potuto scrivere un post perché l'articolo includeva nomi di prodotti inventati. Tuttavia, in un suo post del 21 settembre 2026, lo stesso account affermava che Higgsfield AI aggiungeva funzioni rapidamente con GPT-4o e il framework “Astra” di OpenAI. È molto probabile che una delle due affermazioni sia errata; è più sicuro non adottare senza riserve le affermazioni su Astra.
Limiti
- L'API di ricerca ufficiale di Bluesky (
app.bsky.feed.searchPosts) ha restituito costantemente 403 Forbidden in questa sessione, rendendo impossibile un'indagine esaustiva per keyword. In alternativa, post e account sono stati scoperti con ricerche web (site:bsky.app) e verificati direttamente per testo, data e like tramiteapp.bsky.feed.getPostThread/app.bsky.feed.getAuthorFeed(API pubbliche senza autenticazione). - Le pagine dei post di
bsky.app(renderizzate in JS) non permettevano a WebFetch di ottenere testo o metriche, ma solo l'handle dell'autore. Tutte le metriche provengono esclusivamente dalle API indicate sopra. - Non sono stati trovati post individuali significativi su Bluesky per modelli open source immagini/video che probabilmente sono discussi a settembre 2026, fra cui FLUX.2, Wan 2.7, LTX-2.3 e workflow ComfyUI. Sono stati controllati direttamente i feed di handle come fluxkontext.bsky.social, wagahai-ai.bsky.social e aoi68k.bsky.social, ma tutti si fermavano alla prima metà del 2025 e non riflettevano argomenti recenti.
- A fronte del criterio di completamento di “analizzare circa 20 post”, i post di cui testo e metriche sono stati effettivamente confermati sono 16 (11 closed source, 5 open source). La raccolta è concentrata su gen-ai.news e risulta debole come discussione organica di molteplici utenti individuali.
- Sono stati trovati più account della comunità giapponese (tag AI illustrazioni e AI video), ma il loro contenuto era vecchio (2024–2025) o limitato a pubblicazioni artistiche generiche senza valore di notizia; non è stato quindi adottato come conoscenza aggiornata pertinente al tema.
Lemmy
Lemmy — Ultimi sviluppi dell'IA per la generazione di immagini e video
Comunità
- !«メールアドレス» — 5.714 membri. È l'unico vero hub di Lemmy per l'AI open weight di immagini e video. Quasi ogni giorno vengono pubblicati link a GitHub/HuggingFace, in forma di feed di notizie rapide.
- !«メールアドレス»(mirror di sh.itjust.works)— circa 5.180 membri. Comunità su LLM locali in generale, dove compaiono talvolta argomenti di generazione immagini; nel periodo raccolto non sono stati trovati nuovi post su immagini/video.
- !«メールアドレス» — 1.662 membri. Esiste, ma l'attività recente è risultata pressoché assente.
- !fuck_ai(su lemmy.world / lemmy.dbzer0.com / lemmy.zip / discuss.online / lemmy.blahaj.zone e altre istanze)— è vivace rispetto alle dimensioni (da decine a oltre 800 like per post) e tratta reazioni ostili all'AI in generale, ma solo pochi post sono specifici per AI di immagini/video.
- !«メールアドレス»(e mirror su altre istanze)— comunità tecnologica generalista dove singole notizie closed source su immagini/video arrivano sporadicamente. Non è stata trovata una comunità specializzata.
- !«メールアドレス» / !«メールアドレス»、!«メールアドレス»、!«メールアドレス» — esempi di comunità gaming o specifiche di un brand in cui arrivano singole notizie sui contenuti generati dall'AI.
Post
Fronte open source(da !«メールアドレス»)
- Qwen-Image-2.1 in ComfyUI: Open-Weight Image Generation and Editing, Now with Transparency — punteggio 14, 2026-09-22. Il modello open weight Qwen-Image-2.1 di Alibaba è stato integrato in ComfyUI e supporta output con trasparenza (canale alpha). https://lemmy.dbzer0.com/post/75874773
- SupraLabs/Supra2-IMG — punteggio 8, 2026-09-22. Modello text-to-image ultraleggero da 100 milioni di parametri, addestrato soltanto su dati sintetici. Presentato come dotato di qualità all'avanguardia per le dimensioni. https://lemmy.dbzer0.com/post/75874769
- AI Horde: nuova interfaccia, nuovo frontend, nuovo backend e documentazione di un rinnovamento completo — punteggio 9, 2026-09-19. Aggiornamento del servizio distribuito e gratuito di generazione immagini sviluppato dallo stesso amministratore dell'istanza Lemmy, db0. https://lemmy.dbzer0.com/post/75736717
- well9472/Nanosaur2-670M(con supporto ComfyUI) — punteggio 4, 2026-09-27. Modello DiT text-to-image da 670 milioni di parametri, specializzato in illustrazioni, addestrato per appena 600 dollari. https://lemmy.dbzer0.com/post/76110122
- Concentrazione di strumenti per MiniMax H3 — dal 13 al 26 settembre 2026 sono stati pubblicati in sequenza oltre cinque strumenti: “AutoContext” per superare i limiti di memoria nei video lunghi, UI per controllo della camera 3D, nodi di editing in timeline e LoRA di accelerazione a tre passaggi (TaoMate-H3), con punteggi da 1 a 6. Questo suggerisce che MiniMax H3 sia il principale terreno di sviluppo video attuale per la comunità. Esempio: https://lemmy.dbzer0.com/post/75586069
- LoRA e strumenti di accelerazione per Krea 2 — “Krea2-Turbo-Distill-2step-LoRA” (denoising 4,2 volte più rapido, punteggio 2, 2026-09-16) e “krea2-inpaint-edit” (LoRA per modifica con maschere, punteggio -1, 2026-09-26). Krea2 si sta stabilendo come obiettivo per LoRA realizzati direttamente dalla comunità.
Fronte closed source(sparso in comunità generaliste)
- Midjourney chiede agli studi cinematografici di Hollywood di rivelare l'effettivo uso dell'AI — !«メールアドレス», 2026-07-05. https://lemmy.today/post/56011946
- Stanford ammette di avere usato foto di studenti per modifiche AI che “cambiano razza” — !«メールアドレス», punteggio 3, 2026-09-23. https://lemmy.world/post/52274704
- La nuova funzione AI di Google Earth permette a chiunque di creare false immagini satellitari — !«メールアドレス», 2026-08-04. https://sh.itjust.works/post/64574916
- DC rimuove da YouTube un video dietro le quinte dopo la scoperta dell'uso di concept art generata dall'AI — !«メールアドレス», punteggio 5, 2026-08-13. https://lemmy.today/post/58316222
- Una pubblicità Meta promuove app nudify rivolte a immagini di adolescenti reali come “l'AI che gli uomini usano davvero” — !«メールアドレス», 2026-09-08. https://lemmy.dbzer0.com/post/75191260
- EA collabora con l'azienda che ha sviluppato Stable Diffusion (Stability AI) per creare giochi con l'AI — !«メールアドレス», punteggio 2, 2025-10-25. https://mander.xyz/post/40602787
- Post meme che deride “OpenAI chiude Sora, il modello AI per generare video-spazzatura” — !«メールアドレス», punteggio 0, 2026-03-25. È nel contesto sarcastico della notizia reale della chiusura dell'API Sora. https://lemmus.org/post/21091066
Segnali
- Il fronte open source è fortemente concentrato: quasi tutti i post di sviluppo trovati arrivano da una sola comunità, !«メールアドレス», e quasi da un solo autore (Even_Adder), più l'amministratore dell'istanza db0. Quasi tutti i post hanno zero commenti: è più simile a una raccolta di nuovi link GitHub/HuggingFace che a uno spazio di discussione.
- L'attuale centro di gravità dello sviluppo è Qwen-Image-2.1 per le immagini e MiniMax H3 per il video: gran parte dei post di strumenti delle ultime due settimane riguarda adattatori, LoRA e nodi ComfyUI per questi due modelli. Anche Reddit (
output/reddit.md) nomina esplicitamente gli stessi due come migliori del momento, fornendo una conferma trasversale fra piattaforme. - Gli argomenti closed source arrivano solo attraverso “polemiche ed etica”, non come notizie di funzionalità: i post su Midjourney, Google, Meta e DC riferiscono di violazioni di diritti, deepfake, impersonificazione e falsificazione, non di annunci di nuove funzioni. Lemmy non sembra avere una comunità dedicata a seguire nuovi modelli tecnici come Sora, Veo, Kling o Grok Imagine.
- !fuck_ai non è specializzato in AI per immagini/video malgrado le dimensioni: i singoli post raggiungono da decine a oltre 800 like, ma l'attenzione è rivolta soprattutto a comportamenti problematici degli agenti LLM testuali (“Claude Code ha eliminato 48.000 file in 103 secondi”, “l'agente OpenAI ha modificato siti governativi”); la generazione immagini/video è minoritaria.
- Le ricerche dirette sui principali prodotti closed source hanno dato quasi sempre risultati vuoti: cercando “Kling AI”, “Veo 3”, “Adobe Firefly”, “Nano Banana” e “Grok Imagine” si sono ottenuti soprattutto risultati non correlati; post o discussioni dedicate a questi prodotti sono pressoché assenti su Lemmy.
Limiti
- La funzione di ricerca Lemmy (API di lemmy.world e ricerca web interna) è poco precisa e restituisce numerosi post irrilevanti rispetto alle keyword (per esempio, cercando “Kling AI” appaiono thread sulle tariffe ferroviarie tedesche). Perciò “nessun risultato di ricerca” non equivale necessariamente a “nessuna discussione”.
- La fonte di informazioni open source dipende di fatto da una sola comunità e da uno o due account; le comunità simili su altre istanze (lemmy.ml, lemm.ee e altre) hanno pochi iscritti e attività quasi assente.
- Sul fronte closed source non esiste un aggregatore dedicato: la raccolta ha dovuto mettere insieme post isolati da comunità generiche come technology, nottheonion, games, dcstudios e googlepixel. La copertura è bassa.
- Durante l'indagine sono stati aperti oltre 40 post tramite elenco comunità e risultati di ricerca (20 nuovi post della comunità stable_diffusion più molti risultati), soddisfacendo numericamente il criterio di circa 20; tuttavia, solo pochissimi avevano discussioni nei commenti davvero attive, e la maggioranza ne aveva quasi zero.
- Lemmy è nel complesso piccolo per numero di utenti e post e, rispetto a Reddit, X e Bluesky, offre poca profondità come luogo per seguire le “ultime notizie” sulla generazione AI di immagini e video.
Pinterest — Notizie sull'IA per la generazione di immagini e video
Delle 50 pin raccolte (pinterest.pins.md、manifest.json), sono state aperte e controllate direttamente 26 immagini. La raccolta usa una singola query non categorizzata: "Image and Video Generation AI News".
Temi visivi
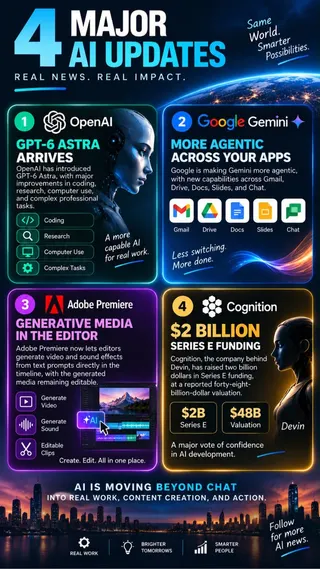
- Domina l'estetica “AI” di sfondo nero con neon blu/viola: mani e volti robotici con effetto glow, circuiti luminosi e tipografia con logo
AIricorrono continuamente. Questo tono e stile copre quasi tutto l'insieme [1, 7, 8, 20, 37, 38, 40]. - Robot umanoidi bianchi (dalla superficie liscia, con occhi o giunture luminose blu) sono molto usati come icona antropomorfizzata dell'AI [8, 20, 37, 38, 40]. Queste illustrazioni in stile stock sono nettamente più comuni di screenshot delle interfacce dei prodotti reali.
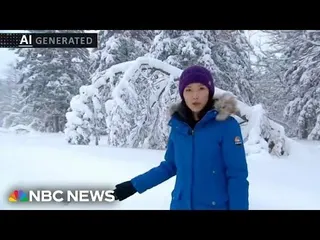
- Le composizioni di avviso/confronto “questo è generato dall'AI” costituiscono un grande genere: timbri di rilevamento fake, immagini divise Human/AI e screenshot di video con presentatori in stile telegiornale generati dall'AI. Sono molto presenti contenuti su come riconoscerli e sulla diffidenza [3, 32, 39, 42, 43, 44, 45, 48].
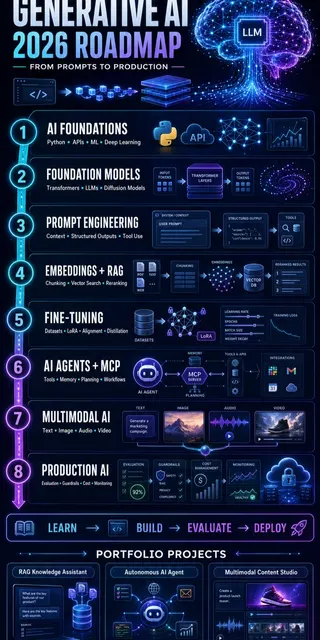
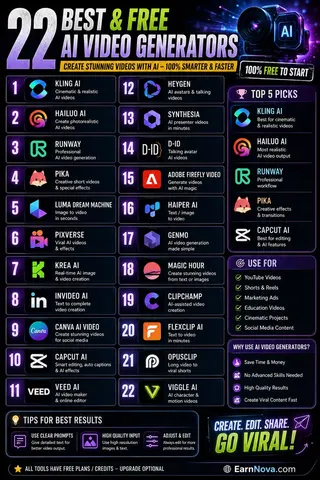
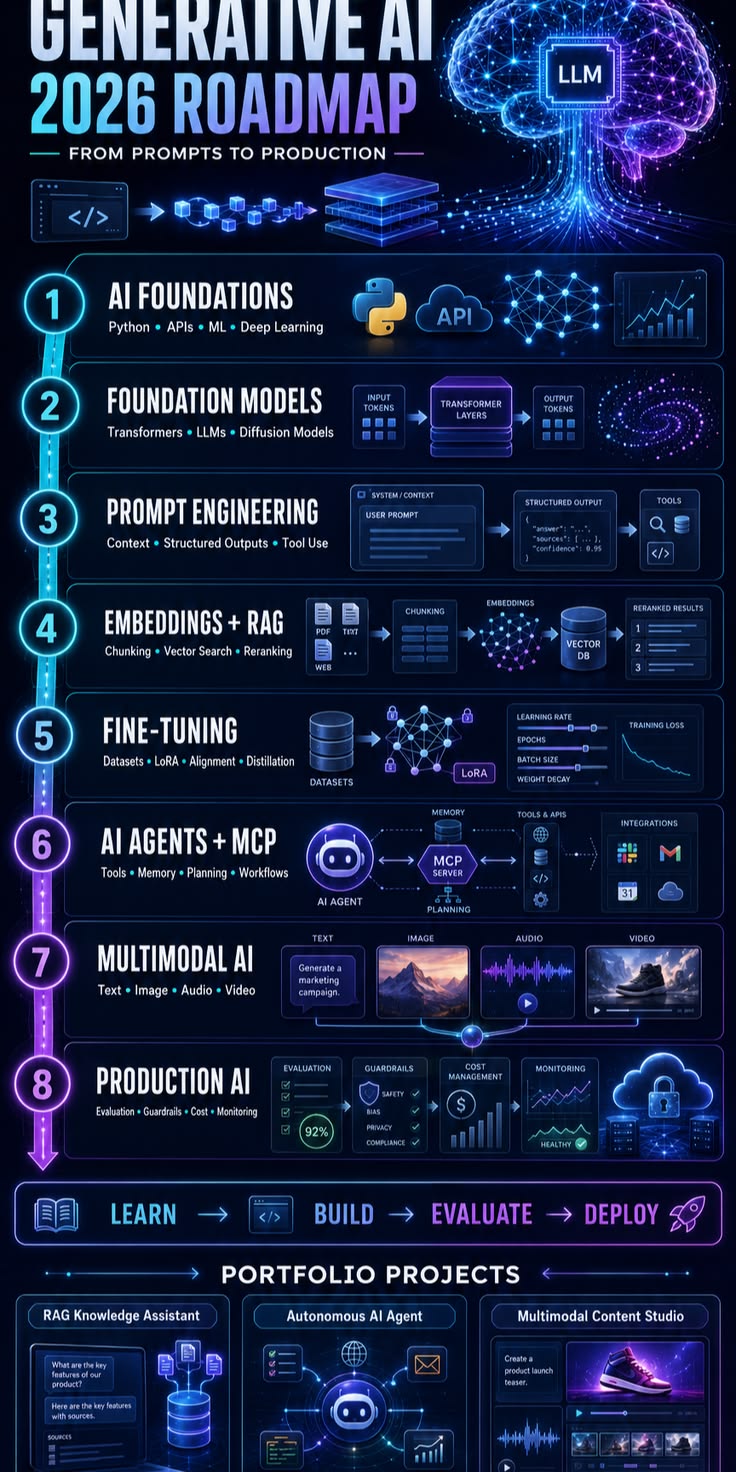
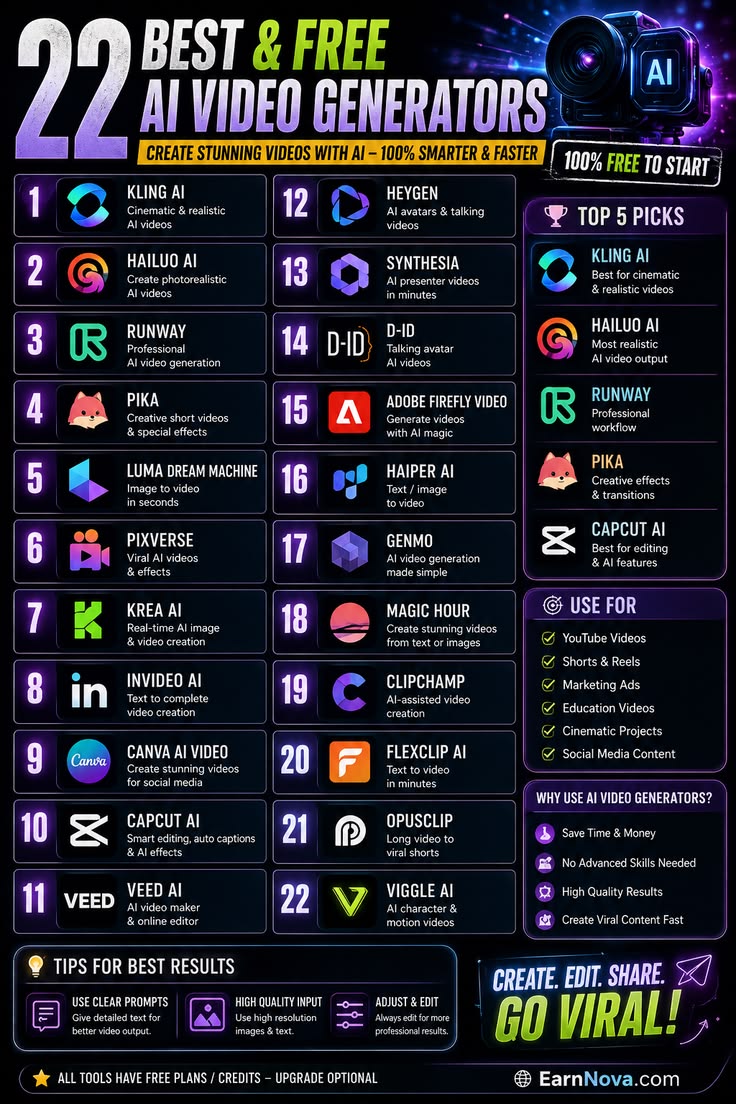
- Infografiche di confronto/ranking degli strumenti (UI a lista verticale): molte guide alla scelta mostrano loghi di più strumenti, come “Best Quality vs Best Free” e “22 Best & Free AI Video Generators” [7, 47]. Anche le roadmap dei percorsi di apprendimento [34] appartengono allo stesso filone.
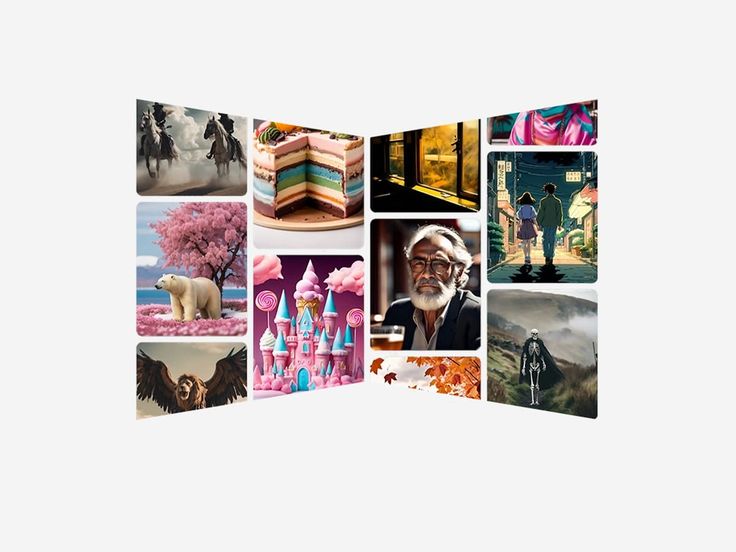
- Miniature con loghi o nomi dei grandi marchi closed source in primo piano: Google Gemini/Omni, Veo3, Kling AI, Luma Dream Machine e il logo OpenAI sono collocati in posizioni evidenti [1, 9, 13, 19, 31, 33, 47]. Al contrario, immagini incentrate su open source (Stable Diffusion, ComfyUI, LoRA) quasi non compaiono; l'unica di Stability AI [49] è un collage promozionale, non una schermata di workflow reale.
- Demo “trasforma una singola fonte in più stili”: una griglia di confronto trasforma la stessa foto di una persona in blocchi di legno, origami, LEGO e fiori, fungendo da dimostrazione visiva della capacità espressiva dell'AI di modifica immagini [2].
- Primi piani di occhi e il motivo “indistinguibile dal reale”: un occhio in primo piano di Luma Dream Machine [33] e messe in scena macro di confronti AI/umano [43] sottolineano visivamente il realismo.
- Combinazioni di loghi aziendali reali o documenti amministrativi per dare un tono di notizia: foto dell'insegna Google [28], immagini in stile documento relative alla legislazione dello Stato di New York [18] e numerose grafiche da “notizie riassuntive” con foto stock e testo sovrapposto.
Pin notevoli
- [1] "AI News: Anthropic Leak Shows Us The Future of AI..." — La tipica composizione da miniatura YouTube: “espressione sorpresa + loghi Big Tech (OpenAI/Google/Microsoft)”. È il template stesso dei video di notizie AI.
- [2] "Google announces ultra-high quality video..."(in realtà una griglia demo di trasformazione immagini)— Confronto in sequenza della trasformazione da un video sorgente in effetti simili a sculture in legno, origami, LEGO e composizioni floreali. Un esempio rappresentativo della capacità espressiva dell'AI per il montaggio immagini.
- [9] "Veo 3 Image-to-Video: Fast Generation & Native Audio via Gemini API" — Promuove generazione video rapida e audio nativo con Veo3 attraverso Gemini API. Materiale promozionale per funzionalità recenti closed source.
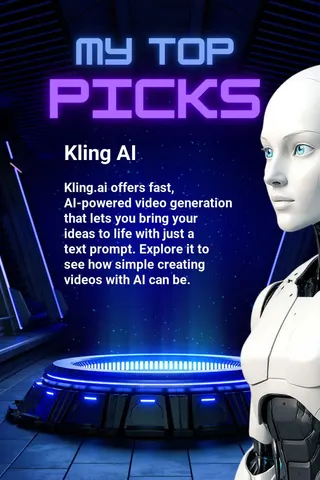
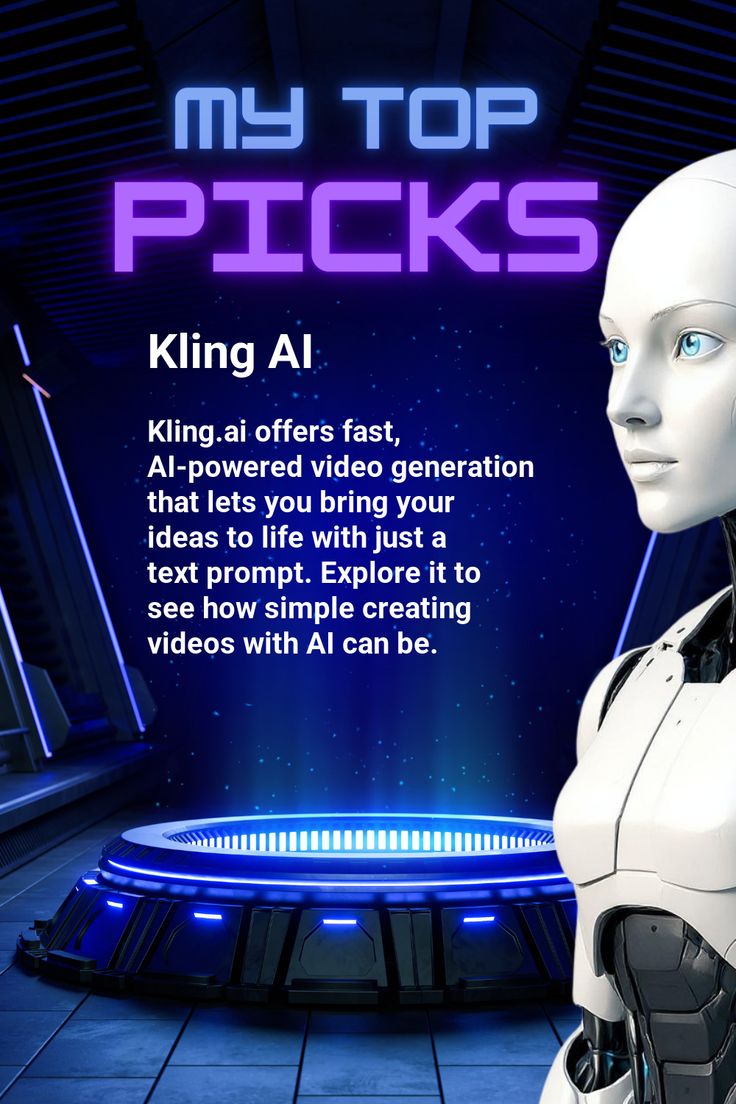
- [13] "Kling.ai AI-Powered Text-to-Video Generation" — Pin verticale in stile “My Top Picks” che raccomanda Kling AI. Indica l'alta riconoscibilità di questo strumento video closed source cinese.
- [19] "Google's Gemini Omni Turns Anything Into Video" — Immagine di branding che condensa l'integrazione multimodale (immagine, audio e testo → video) in una sola icona.
- [31] "'Amuse 3.0', an AI art creation tool that includes..." — Ritratto fotorealistico per uno strumento locale di generazione artistica AI sostenuto da AMD. Uno dei pochi esempi che promuove la generazione on-device.
- [32] "AI news videos blur line between real and fake reports" — Fotogramma di un reporter AI in stile notiziario NBC con filigrana “AI GENERATED”. Simboleggia le preoccupazioni per l'abuso dell'AI generativa nelle notizie.
- [44] "AI News Anchors & Creator-Led Coverage Take Over U.S. Media!" — Illustrazione composita dall'alto di una redazione che presenta l'ascesa di anchor AI e copertura guidata dai creatori.
- [47] "22 Best & Free AI Video Generators in 2026" — Infografica che classifica 22 strumenti, fra cui Kling, Hailuo, Runway, Pika e Luma. È un esempio tipico di contenuto per scegliere strumenti, con enfasi sui livelli gratuiti.
- [49] "Stability AI's Stable Diffusion Maker Can Now Build AI Generative Video" — Collage relativo a Stability AI (ambiente da ufficio, schermata di codice ed esempio di ritratto generato). È uno dei pochi esempi open source trovati, ma non mostra UI concrete o nomi di modelli specifici.
Segnali
- Pinterest oggi è quasi monocromatico: video generativo closed source. Veo3/Gemini Omni, Kling AI, Luma Dream Machine e Runway ricorrono con loghi nei pin. Anche le infografiche comparative [7, 47] elencano quasi esclusivamente strumenti SaaS closed source; l'asse “gratuito/aperto” può apparire, ma non nel senso di “open source e autogestito”.
- La diffidenza verso i contenuti generati dall'AI e il bisogno di riconoscerli sono una domanda forte e specifica di Pinterest. Rilevamento dei falsi, abuso nelle notizie e confronti “Human or AI?” sono un genere autonomo, diverso dalle discussioni tecniche di Reddit e dei siti di notizie. Su Pinterest vengono consumati come infografiche divulgative.
- Gli argomenti specifici dell'open source (ComfyUI, LoRA, modelli OSS cinesi come Wan/HunyuanVideo e dibattiti sulle licenze) sono quasi completamente assenti. È stato trovato solo un elemento legato a Stability AI, senza schermate concrete di workflow o creazioni della comunità.
- Le metriche di engagement (salvataggi e like) non sono incluse nei dati raccolti, quindi non è possibile stabilire dalla sola immagine quali pin siano realmente popolari.
Limiti
- Sono state aperte e controllate direttamente solo 26 immagini su 50; per le restanti 24 è stato consultato soltanto l'elenco dei titoli in
pinterest.pins.md. - La raccolta Pinterest è stata eseguita in anticipo dal worker; non è stata svolta una navigazione o regolazione autonoma delle query. I risultati provengono da una singola query inglese e non è stato possibile ripetere le ricerche in giapponese o filtrate per “open source” e “closed source”.
- Sono state raccolte soltanto immagini statiche; malgrado il tema della generazione video AI, non si è potuto osservare il risultato generato in movimento e le conclusioni restano inferenze basate su miniature e materiale promozionale.
- I dati non contengono salvataggi, commenti o altre metriche di engagement, quindi non è possibile valutare popolarità o diffusione.
Azioni consigliate
- Controllare ogni settimana l'ecosistema ComfyUI attorno a Qwen-Image-2.1 e Minimax H3.
- Ripetere la raccolta su X evitando i trend regionali e usando keyword direttamente collegate alla generazione AI di immagini e video.
- Seguire la riorganizzazione dei protagonisti video closed source (Veo, Kling, Grok, Runway e Seedance) dopo la chiusura di Sora.
- Usare Pinterest come riferimento sul linguaggio visivo, non come misura della popolarità, perché non fornisce metriche di interesse.
- Continuare a monitorare la diffusione della diffidenza verso contenuti generati dall'AI e il dibattito sulle filigrane obbligatorie.
- Nella nuova raccolta Reddit, usare query specifiche per open source/closed source per avvicinarsi al criterio di completamento di 20 thread.
Immagini raccolte






























Nota sulla qualità dei dati
Su X, un errore di geolocalizzazione e ricerche basate sui trend hanno portato a 0 post pertinenti; su Bluesky l'API di ricerca ha restituito 403 e ha concentrato la raccolta sugli articoli di un solo account; Pinterest non dispone di metriche di engagement; per YouTube non è stato possibile ottenere le visualizzazioni; le informazioni open source su Lemmy sono di fatto concentrate in una sola comunità; Reddit si è fermato a 12 thread, sotto il criterio di completamento di 20.